
Prezzi API LLM 2026: token più cari, capacità a un costo 50x minore
Indice
- Come sono cambiati i prezzi di listino delle API LLM nell’ultimo anno?
- Come sono cambiati i prezzi dei modelli di Anthropic, OpenAI, Google e DeepSeek in due anni?
- I modelli sono diventati più costosi o solo più capaci?
- Come sono cambiati i prezzi nelle singole fasce?
- Come si differenziano le strategie di prezzo dei singoli laboratori?
- Come si confronta la strategia di prezzo di DeepSeek?
- Come si confrontano i quattro laboratori?
- Come si sono mossi i prezzi nelle singole categorie?
- Quanto costa oggi un dato livello di capacità?
- Perché i prezzi si sono mossi così?
- Perché il prezzo per token non coincide con il costo per task?
- Come sono cambiati i prezzi della cache rispetto all’input?
- Come usare questi dati?
- Domande frequenti
- Altri articoli
Tra ottobre 2025 e ottobre 2026, i prezzi di listino per token delle API LLM sono aumentati in 10 fasce di modelli su 14. Nello stesso periodo, però, il modello più economico in grado di raggiungere un dato livello di capacità è diventato molto meno caro per token: da 17 a 50 volte per i livelli dell’indice da 20 a 40, e 2.5 volte per il livello 50. Per fascia intendiamo una linea di prodotti di un fornitore, come Claude Opus o Gemini Flash. La capacità è il punteggio del modello nell’Artificial Analysis Intelligence Index, un indice indipendente che combina più benchmark su una scala da 0 a 100 (il modello migliore oggi arriva a 57.6). I prezzi sono combinati: dollari per milione di token, con tre token di input per ogni token di output. Le due tendenze coesistono perché ogni nuovo modello di una fascia è più capace di quello che sostituisce.
TL;DR
- Da ottobre 2025 a ottobre 2026, i prezzi di listino dell’input sono saliti in 10 fasce su 14; le 3 in cui sono scesi sono tutte di Anthropic.
- Da aprile a ottobre 2026, il modello più economico con 40 punti nell’indice Artificial Analysis è passato da $10 a $0.20 per milione di token combinati.
- Da ottobre 2024 Anthropic ha tagliato i prezzi di tutte e tre le fasce (Opus da $15 / $75 a $4 / $20), Google li ha aumentati in tutte e tre e OpenAI li ha aumentati solo nella fascia intermedia.
- Il divario tra i prezzi di input dei modelli di punta a pesi chiusi si è ridotto da 12x a 2x; il prezzo mediano dei modelli di punta a pesi aperti è raddoppiato.
Come sono cambiati i prezzi di listino delle API LLM nell’ultimo anno?
Nella maggior parte delle fasce, il costo per token è più alto di un anno fa. Abbiamo confrontato il modello presente in ogni fascia il 15 ottobre 2025 con quello presente il 15 ottobre 2026:
| Fascia | Modello a ottobre 2025, $ per milione di token (input / output) | Modello a ottobre 2026, $ per milione di token (input / output) | Prezzo input, 2026 rispetto al 2025 |
|---|---|---|---|
| OpenAI di punta | GPT-5, $1.25 / $10 | GPT-6.1 Sol, $2 / $10 | 1.6x |
| OpenAI intermedio | GPT-5 mini, $0.25 / $2 | GPT-5.6 Terra, $2 / $12 | 8x |
| OpenAI piccolo | GPT-5 nano, $0.05 / $0.40 | GPT-6 Luna, $0.10 / $0.50 | 2x |
| Claude Opus | Opus 4.1, $15 / $75 | Opus 5.5, $4 / $20 | 0.27x |
| Claude Sonnet | Sonnet 4.5, $3 / $15 | Sonnet 5.5, $2 / $10 | 0.67x |
| Claude Haiku | Haiku 4.5, $1 / $5 | Haiku 5.5, $0.10 / $0.50 | 0.1x |
| Gemini Pro | Gemini 2.5 Pro, $1.25 / $10 | Gemini 4 Argon, $2 / $10 | 1.6x |
| Gemini Flash | Gemini 2.5 Flash, $0.30 / $2.50 | Gemini 3.8 Flash, $0.75 / $3.75 | 2.5x |
| Gemini Flash-Lite | Gemini 2.5 Flash-Lite, $0.10 / $0.40 | Gemini 3.5 Flash-Lite, $0.30 / $2.50 | 3x |
| DeepSeek economico | V3.2-Exp, $0.28 / $0.42 | V4.1 Flash, $0.30 / $1.20 nelle ore di punta | 1.07x |
| Zhipu GLM di punta | GLM-4.6, $0.60 / $2.20 | GLM-5.3, $1.40 / $4.40 | 2.3x |
| Moonshot Kimi di punta | Kimi K2, $0.60 / $2.50 | Kimi K3, $3 / $15 | 5x |
| Alibaba Qwen Max | Qwen3-Max, $1.20 / $6 | Qwen3.8 Max, $2 / $6 | 1.67x |
| MiniMax | M2 (dal 23 ottobre), $0.30 / $1.20 | M3, $0.30 / $1.20 | 1x |
Alcuni prezzi sono soggetti a condizioni: Argon e Gemini 3.8 Flash hanno prezzi di lancio che raddoppiano rispettivamente il 1 dicembre e il 1 gennaio; Haiku 5.5 costa $0.50 / $2.50 oltre 100,000 token nel prompt; la riga DeepSeek usa la tariffa di punta, applicata durante l’orario lavorativo di Pechino (fuori punta costa la metà, meno del prezzo combinato di V3.2-Exp). Il conteggio di 10 fasce su 14 resta uguale anche usando il prezzo combinato anziché quello di input. I prezzi di Kimi K2 e Qwen3-Max provengono da rilevazioni di terzi.
Come sono cambiati i prezzi dei modelli di Anthropic, OpenAI, Google e DeepSeek in due anni?
Nell’arco di due anni Anthropic ha ridotto i prezzi di listino in tutte e tre le sue fasce. I prezzi del modello di punta e di quello piccolo di OpenAI hanno chiuso vicino ai livelli iniziali, mentre quello della fascia intermedia è salito di 17x. Google ha aumentato i prezzi in ogni fascia. Il modello economico di DeepSeek è arrivato a costare circa 3x nelle ore di punta, mentre il prezzo della lettura dalla cache è sceso al 2% di quello dell’input. Il grafico e le tabelle qui sotto ripercorrono l’andamento dei tre maggiori laboratori che sviluppano modelli a pesi chiusi a partire da ottobre 2024, seguendo per ciascuno il modello di punta, quello intermedio e quello piccolo disponibili in ogni momento. DeepSeek vende uno o due modelli anziché offrire tre fasce, quindi viene trattato in una sottosezione dedicata; una tabella finale confronta tutti e quattro i laboratori.
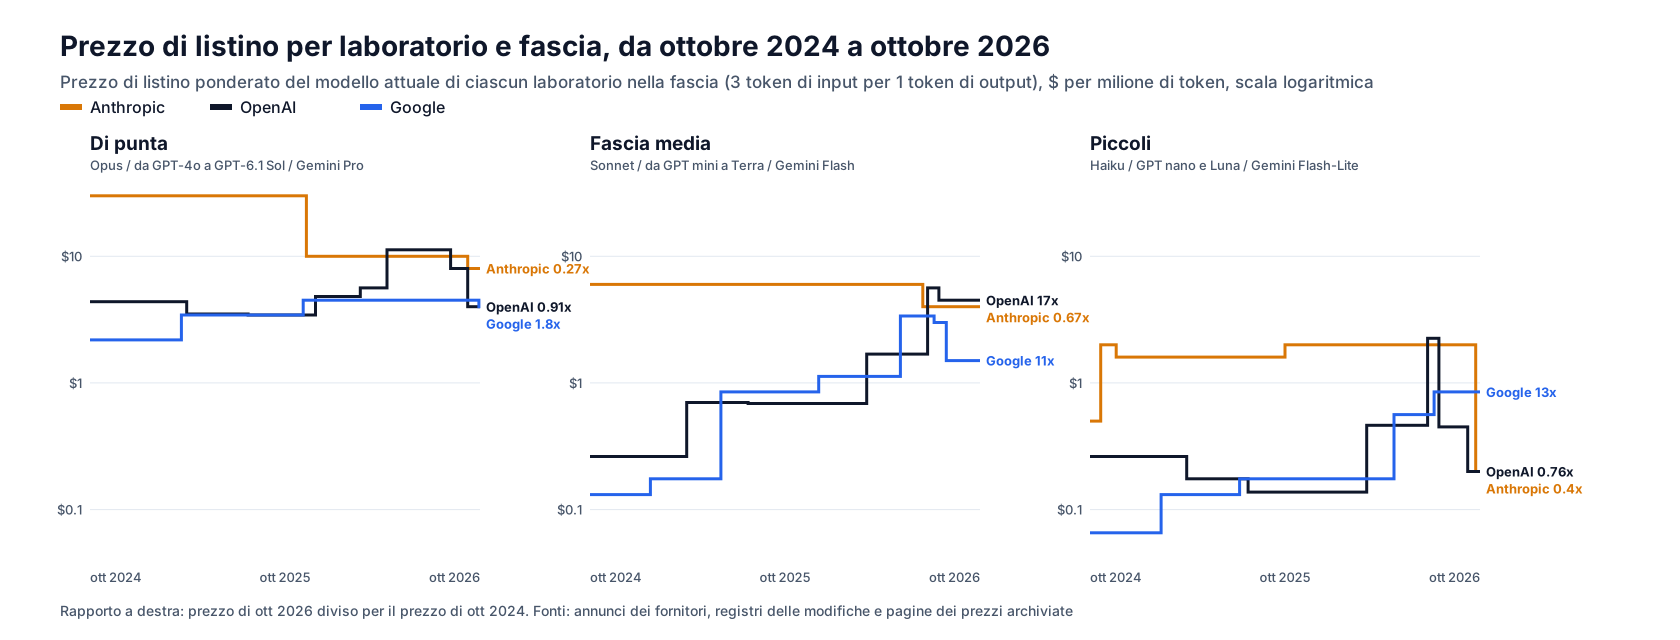
| Fascia | Anthropic | OpenAI | |
|---|---|---|---|
| Di punta | Da Claude 3 Opus $15 / $75 a Opus 5.5 $4 / $20: 0.27x | Da GPT-4o $2.50 / $10 a GPT-6.1 Sol $2 / $10: 0.91x | Da Gemini 1.5 Pro $1.25 / $5 a Gemini 4 Argon $2 / $10: 1.8x |
| Intermedia | Da Claude 3.5 Sonnet $3 / $15 a Sonnet 5.5 $2 / $10: 0.67x | Da GPT-4o mini $0.15 / $0.60 a GPT-5.6 Terra $2 / $12: 17x | Da Gemini 1.5 Flash $0.075 / $0.30 a Gemini 3.8 Flash $0.75 / $3.75: 11x |
| Piccola | Da Claude 3 Haiku $0.25 / $1.25 a Haiku 5.5 $0.10 / $0.50: 0.4x | Da GPT-4o mini a GPT-6 Luna $0.10 / $0.50: 0.76x | Da Gemini 1.5 Flash-8B $0.0375 / $0.15 a Gemini 3.5 Flash-Lite $0.30 / $2.50: 13x |
I prezzi si riferiscono al 15 ottobre di ciascun anno e il rapporto confronta i prezzi combinati. GPT-4o mini è il modello di partenza in entrambe le righe delle fasce inferiori di OpenAI, perché OpenAI non aveva un modello piccolo distinto fino all’arrivo di GPT-4.1 nano ad aprile 2025.
I modelli sono diventati più costosi o solo più capaci?
I modelli sono perlopiù diventati più capaci. Da ottobre 2025 a ottobre 2026, il punteggio nell’indice del modello corrente di ciascuna fascia è aumentato da 1.9 a 3.3 volte. Il prezzo per punto dell’indice (prezzo combinato diviso per il punteggio nell’indice; un valore inferiore a 1x indica che la stessa capacità costa meno) è sceso in sette fasce su nove. L’indice assegna punteggi ai modelli meno recenti solo a partire da metà 2025, quindi questo confronto copre il secondo anno:
| Laboratorio e fascia | Indice, da ottobre 2025 a ottobre 2026 | Prezzo combinato | Prezzo per punto dell’indice |
|---|---|---|---|
| Anthropic di punta | da 22.8 a 57.6 | da $30.00 a $8.00 | 0.11x |
| Anthropic intermedio | da 19.3 a 35.9 (impostazione predefinita) | da $6.00 a $4.00 | 0.36x |
| Anthropic piccolo | da 16.9 a 43.4 | da $2.00 a $0.20 | 0.04x |
| OpenAI di punta | da 23.0 a 51.8 | da $3.44 a $4.00 | 0.52x |
| OpenAI intermedio | da 16.8 a 42.1 | da $0.69 a $4.50 | 2.6x |
| OpenAI piccolo | da 13.0 a 38.1 | da $0.14 a $0.20 | 0.50x |
| Google di punta | da 16.1 a 52.6 | da $3.44 a $4.00 | 0.36x |
| Google intermedio | da 13.1 a 40.9 | da $0.85 a $1.50 | 0.57x |
| Google piccolo | da 8.5 a 22.2 | da $0.18 a $0.85 | 1.9x |
I modelli sono quelli della prima tabella. I punteggi si riferiscono all’impostazione di ragionamento più alta di ciascun modello (l’opzione della richiesta che permette al modello di ragionare più a lungo prima di rispondere); per Sonnet si usa l’impostazione predefinita, l’unica valutata per le versioni meno recenti, e i punteggi di ottobre 2025 dei modelli meno recenti sono stime di Artificial Analysis. Il prezzo per punto è salito solo dove un laboratorio ha aumentato il prezzo di un modello più di quanto ne abbia migliorato le capacità.
Come sono cambiati i prezzi nelle singole fasce?
I prezzi della fascia di punta si sono avvicinati, quelli della fascia intermedia sono aumentati e nella fascia piccola si sono separati. A ottobre 2024 il prezzo di input più alto della fascia di punta era 12 volte quello più basso (Claude 3 Opus a $15, Gemini 1.5 Pro a $1.25); a ottobre 2025 il rapporto era ancora di 12 volte. Oggi è di 2 volte. Nel frattempo, il modello di punta di OpenAI era salito a $5 / $30 con GPT-5.5 ad aprile 2026, per poi scendere a $2 / $10. I modelli intermedi oggi superano i punteggi dei modelli di punta di un anno prima, e OpenAI e Google ne hanno fissato i prezzi di conseguenza. Il divario tra i prezzi di input della fascia intermedia si è quindi ridotto da 40x a 2.7x, e il taglio di Sonnet lo ha ristretto ulteriormente. Nella fascia piccola, OpenAI e Anthropic si sono entrambe assestate a $0.10 / $0.50, mentre Gemini 3.5 Flash-Lite di Google costa quanto costava Gemini 2.5 Flash a metà 2025.
Come si differenziano le strategie di prezzo dei singoli laboratori?
Anthropic ha mantenuto i prezzi invariati per lunghi periodi, riducendoli a più riprese. OpenAI li ha rivisti spesso, motivando ogni variazione con miglioramenti di capacità o efficienza. Google li ha aumentati a ogni generazione, annunciando i rincari in anticipo. Nessuna delle tre ha citato un concorrente come motivo di una variazione di prezzo, nemmeno quando Opus 5.5, GPT-6 Sol e GPT-6 Luna sono usciti lo stesso giorno.
Anthropic: prezzi fissi, poi tagli a ogni nuova versione. Sonnet è rimasto a $3 / $15 da marzo 2024 fino a Sonnet 4.6 nel 2026, e Opus a $15 / $75 fino a quando Opus 4.5 ha portato il prezzo a $5 / $25 nel novembre 2025, «rendendo le capacità di livello Opus accessibili a un numero ancora maggiore di utenti» (Anthropic). I tagli successivi sono arrivati con nuovi modelli: Opus 5.5 «richiede meno risorse di calcolo per l’inferenza rispetto a Opus 5, e il prezzo ne tiene conto» (Anthropic), mentre il prezzo di lancio di Sonnet 5, $2 / $10, è diventato quello standard ad agosto. Gli aumenti hanno riguardato la linea Haiku: Claude 3.5 Haiku è stato lanciato a $1 / $5 nel novembre 2024 «per riflettere l’aumento delle sue capacità», per poi scendere a $0.80 / $4 un mese dopo (TechCrunch), e Haiku 4.5 è tornato a $1 / $5 nell’ottobre 2025.
OpenAI: frequenti revisioni dei prezzi, motivate da capacità o efficienza. Gli aumenti sono stati accompagnati da dichiarazioni sulle capacità: GPT-5.2 aveva un «prezzo per token più alto di GPT‑5.1 perché è un modello più capace» (OpenAI). I tagli sono stati motivati con la riduzione dei costi di inferenza: il prezzo di o3 è sceso dell’80% a giugno 2025 perché «abbiamo ottimizzato lo stack di inferenza che esegue o3» (OpenAIDevs), mentre GPT-6 Sol e Luna sono usciti con prezzi di input dimezzati rispetto ai predecessori perché «i miglioramenti nella cache e nell’inferenza ci permettono di eseguire questi modelli a costi inferiori» (OpenAI). I prezzi di lancio sono durati poco: tutti e tre i modelli GPT-5.6, usciti a luglio, costavano meno entro sei settimane. Reuters ha collegato il taglio di agosto su GPT-5.6 Sol alla «crescente concorrenza di Anthropic e dei modelli AI cinesi»; OpenAI ha citato l’efficienza.
Google: prezzi in salita e aumenti programmati. Google era inizialmente il laboratorio più economico in ogni fascia e ha alzato i prezzi con quasi ogni generazione, di solito senza spiegarne il motivo. L’eccezione è stata Gemini 2.5 Flash, il cui prezzo di input è raddoppiato a giugno 2025 con «un adeguamento specifico che riflette l’eccezionale valore di Flash» (Google). Da agosto Google lancia i modelli a prezzi promozionali con un aumento già programmato: Gemini 3.7 Flash e 3.8 Flash a $0.75 / $3.75 fino al 31 dicembre, poi a $1.50 / $7.50, e Argon a $2 / $10 fino al 30 novembre, poi a $4 / $20. Google non ha spiegato il motivo, ma a luglio Sundar Pichai ha dichiarato agli investitori che «continuiamo ad avere vincoli di capacità» (Alphabet).
Come si confronta la strategia di prezzo di DeepSeek?
DeepSeek ha tagliato i prezzi quando una nuova architettura ha ridotto i costi di inferenza e li ha aumentati quando la domanda ha superato la capacità delle sue GPU. L’efficienza determinava quindi il prezzo minimo sostenibile, mentre la capacità di calcolo disponibile determinava il prezzo applicato in ogni momento. Gran parte di questo meccanismo passa dalla cache: quando un prompt inizia con un testo che il fornitore ha già elaborato, può riutilizzare lo stato intermedio memorizzato (la KV cache) invece di ricalcolarlo e fatturare quei token di input come lettura dalla cache, a una tariffa inferiore.
| Data | Variazione | Lettura dalla cache / input non in cache / output, $ per milione di token |
|---|---|---|
| Agosto 2024 | Debutta la cache dei prompt su disco (DeepSeek V2, poi V2.5) | $0.014 / $0.14 / $0.28 |
| Febbraio 2025 | V3 a prezzo pieno dopo la promozione di lancio; dal 26 febbraio sconto notturno del 50% su V3 e del 75% su R1, il suo modello di ragionamento | $0.07 / $0.27 / $1.10 |
| 5 settembre 2025 | Prezzo unico per le modalità con e senza ragionamento di V3.1; termina lo sconto notturno | $0.07 / $0.56 / $1.68 |
| 29 settembre 2025 | V3.2-Exp, prezzi più che dimezzati | $0.028 / $0.28 / $0.42 |
| Aprile 2026 | Esce V4 Flash; due giorni dopo il prezzo di lettura dalla cache scende a un decimo di quello di lancio | $0.0028 / $0.14 / $0.28 |
| 17 agosto 2026 | Introdotte le tariffe di punta; fuori punta si paga la metà | $0.014 / $0.44 / $1.32 nelle ore di punta |
| 10 settembre 2026 | V4.1 Flash sostituisce V4 Flash | $0.006 / $0.30 / $1.20 nelle ore di punta |
I prezzi si riferiscono al modello più economico di DeepSeek a ciascuna data. Le ore di punta sono dalle 09:00 alle 12:00 e dalle 14:00 alle 18:00, ora di Pechino, nei giorni lavorativi.
Efficienza. Nei suoi annunci, DeepSeek collega tre tagli di prezzo a interventi sull’architettura. Nel 2024, la cache su disco si basava su MLA, il sistema di attenzione compressa di DeepSeek, che riduceva la cache KV abbastanza da poterla conservare su dischi economici (DeepSeek). Il taglio di settembre 2025 è arrivato con DeepSeek Sparse Attention, che applica l’attenzione a un sottoinsieme dei token precedenti; l’annuncio in cinese lo attribuisce al costo di inferenza nettamente inferiore del nuovo modello (DeepSeek). La cache KV di V4.1 Flash richiede «1/4 della HBM» (la memoria della GPU) e «1/8 dello spazio su SSD» rispetto al predecessore, e DeepSeek ha sottolineato che «gli addebiti per le letture dalla cache spesso rappresentano una quota rilevante dei costi degli agenti» (DeepSeek). Oggi una lettura dalla cache costa il 2% del prezzo di input, contro il 10% nel 2024 e il 2.5%-10% applicato oggi dai laboratori statunitensi. I dati operativi dell’unica giornata pubblicata da DeepSeek, a marzo 2025, mostrano che il 56.3% dei token di input veniva letto dalla cache su disco, con un margine teorico del 545% a $2 per GPU-ora e ricavi effettivi «nettamente inferiori» (DeepSeek).
Capacità. La stessa panoramica riporta che DeepSeek destina di notte i nodi di inferenza alla ricerca e all’addestramento: sono le ore di basso carico a cui si applicava lo sconto notturno del 2025. Gli aumenti sono arrivati quando la capacità scarseggiava: a settembre 2025 l’unificazione delle modalità di V3.1 ha eliminato quello sconto e raddoppiato il prezzo dell’input non in cache del modello senza ragionamento, da $0.27 a $0.56, senza spiegazioni (DeepSeek); ad agosto 2026 l’introduzione delle tariffe di punta ha triplicato il prezzo di input di V4 Flash nelle ore di maggiore domanda per «allocare le risorse in modo più ragionevole» (nostra traduzione dell’annuncio in cinese, DeepSeek). Anche fuori punta, V4.1 Flash costa più di quanto costasse V4 Flash prima di agosto. Per punto dell’indice, però, il suo costo è pari a 0.70x nelle ore di punta e a 0.35x fuori punta rispetto a quello di V3.2-Exp un anno prima (39.5 punti contro una stima di 16.6).
Come si confrontano i quattro laboratori?
| Anthropic | OpenAI | DeepSeek | ||
|---|---|---|---|---|
| Andamento in due anni | In calo in tutte e tre le fasce | Modelli di punta e piccoli in lieve calo (0.91x, 0.76x), fascia intermedia in aumento di 17x | In aumento in tutte e tre le fasce | Modello economico: prezzo aumentato di 3x nelle ore di punta, di 1.5x fuori punta |
| Frequenza delle variazioni di prezzo | Raramente: stesso prezzo per diverse versioni, poi una variazione netta | Spesso: nuovi prezzi con quasi ogni versione, tagli nel giro di poche settimane | A ogni generazione, più aumenti programmati | Spesso: nuovi prezzi con quasi ogni versione, più promozioni e tariffe per fascia oraria |
| Prezzi di lancio | Un prezzo promozionale (Sonnet 5), poi reso permanente | Tagliati poco dopo il lancio (famiglia GPT-5.6) | Promozionali, con aumento già annunciato | Promozioni di lancio (V3, V4 Pro); quella di V4 Pro è diventata permanente |
| Motivo dichiarato per gli aumenti | Intelligenza (Claude 3.5 Haiku) | Capacità (GPT-5.2) | Valore offerto, una volta (2.5 Flash); di solito nessuno | Allocazione delle risorse (tariffe di punta) |
| Motivo dichiarato per i tagli | Accessibilità, poi minori costi di erogazione | Maggiore efficienza dell’inferenza e della cache | Nessuno dichiarato; prezzi promozionali anziché tagli | Minori costi di erogazione grazie alla nuova architettura |
| Modello economico, ottobre 2026 | $0.10 / $0.50 | $0.10 / $0.50 | $0.30 / $2.50 | $0.30 / $1.20 nelle ore di punta, metà fuori punta |
I prezzi hanno seguito il posizionamento scelto da ciascun laboratorio, non un listino fisso per fascia: un modello che raggiungeva punteggi da modello di punta veniva venduto a un prezzo vicino a quello dei modelli di punta, mentre un laboratorio che riusciva a erogare un modello a costi inferiori ne abbassava il prezzo.
Come si sono mossi i prezzi nelle singole categorie?
I prezzi dei modelli di punta a pesi chiusi si sono avvicinati, quelli dei modelli di punta a pesi aperti sono aumentati e la fascia economica ha chiuso in calo dopo un picco a metà anno. I modelli attuali di ciascun laboratorio rientrano in quattro categorie:
- SOTA fascia alta: SOTA (state of the art, stato dell’arte) comprende i principali laboratori che sviluppano modelli a pesi chiusi. Questa fascia include il modello più costoso di ciascuno. È una fascia di prezzo: Opus 5.5, un modello di punta, supera nel punteggio tutti e tre i modelli di fascia alta. Quando il modello di fascia alta di un laboratorio è anche il suo modello di punta, compare in entrambe le categorie (oggi è il caso di Gemini 4 Argon).
- SOTA di punta: il principale modello generalista di ogni laboratorio che sviluppa modelli a pesi chiusi.
- Di punta a pesi aperti: il modello principale di cinque laboratori, i cui pesi possono essere scaricati e ospitati da chiunque.
- Economici / Flash: la linea a basso costo di ogni laboratorio, denominata a partire dai modelli Flash di Google.
Il grafico mostra, su scala logaritmica, il prezzo combinato mediano tra i laboratori per ogni categoria come linea e l’intervallo dal più economico al più costoso come banda. Il divario riportato nella tabella confronta solo i prezzi di input.
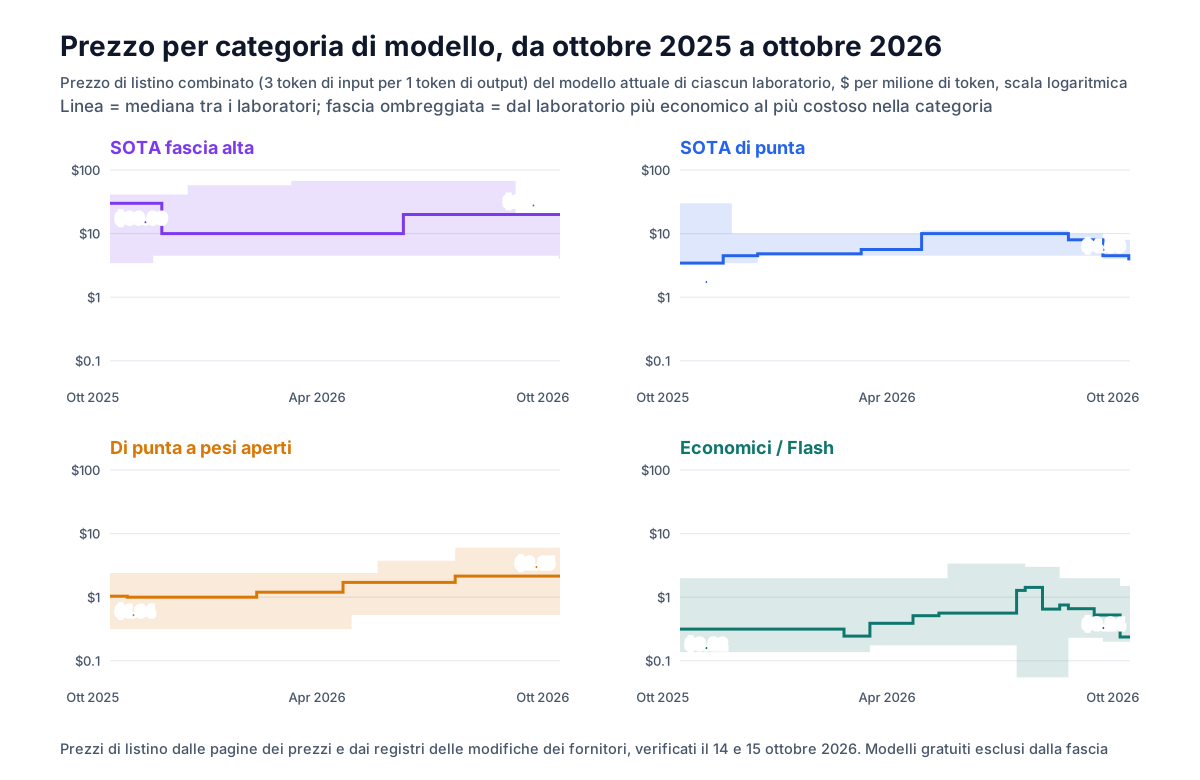
| Categoria | Modelli al 15 ottobre 2026 | Prezzo combinato mediano, ottobre 2025 | Prezzo combinato mediano, ottobre 2026 | Divario input (massimo ÷ minimo), ottobre 2025 | Divario input, ottobre 2026 |
|---|---|---|---|---|---|
| SOTA fascia alta | Claude Fable 5.1, GPT-6 Astra, Gemini 4 Argon | $30.00 | $20.00 | 12x | 5x |
| SOTA di punta | Claude Opus 5.5, GPT-6.1 Sol, Gemini 4 Argon | $3.44 | $4.00 | 12x | 2x |
| Di punta a pesi aperti | GLM-5.3, Kimi K3, Qwen3.8 Max, DeepSeek V4 Pro, MiniMax M3 | $1.04 | $2.15 | 4.3x | 10x |
| Economici / Flash | Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite, DeepSeek V4.1 Flash, GLM-5.3 Flash, Qwen3.8 Flash | $0.32 | $0.24 | 20x | 7.5x |
- SOTA fascia alta: i modelli pro di OpenAI sono passati da GPT-5 Pro a $15 / $120 a GPT-5.4 Pro a $30 / $180. Poi GPT-6 Astra ha riportato il prezzo della linea a $10 / $50, lo stesso di Claude Fable 5.1. Per ora Google offre Argon a $2 / $10: il divario attuale di 5x dipende interamente da questo.
- Di punta a pesi aperti: il prezzo mediano dell’input è più che raddoppiato, da $0.60 a $1.40, e i prezzi si sono allontanati: Kimi K3, a $3 / $15, costa più di Claude Sonnet 5.5, mentre MiniMax M3 è rimasto a $0.30 / $1.20 nell’arco di cinque versioni. Il prezzo mediano dell’output dei modelli a pesi aperti è passato dal 24% al 44% della mediana dei modelli di punta a pesi chiusi. Per DeepSeek V4 Pro viene usato il prezzo delle ore di punta.
- Economici / Flash: la mediana è salita a $0.56 tra maggio e luglio, con il lancio di modelli economici come Gemini 3.1 Flash-Lite e Qwen3.6 Flash a $0.25 / $1.50. È scesa soprattutto a ottobre, quando Haiku 5.5 ha eguagliato il prezzo di GPT-6 Luna a $0.10 / $0.50.
GPT-5.6 Terra è escluso dalla categoria economica perché costa quanto un modello di punta. I dati coprono otto laboratori; non includono xAI e Mistral.
Quanto costa oggi un dato livello di capacità?
Il modello più economico per ciascun livello dell’indice costa da 2.5 a 50 volte meno per token e da 8 a 19 volte meno per task, dove sono disponibili dati per task a entrambi gli estremi del confronto. Il costo per task è quello riportato da Artificial Analysis per eseguire un task del suo indice ai prezzi di listino, usando il numero effettivo di token di ciascun modello. Per ogni giorno abbiamo selezionato il modello corrente più economico con almeno 20, 30, 40 o 50 punti nella versione 4.3.2 dell’indice, usando per ciascuno l’impostazione di ragionamento più alta.
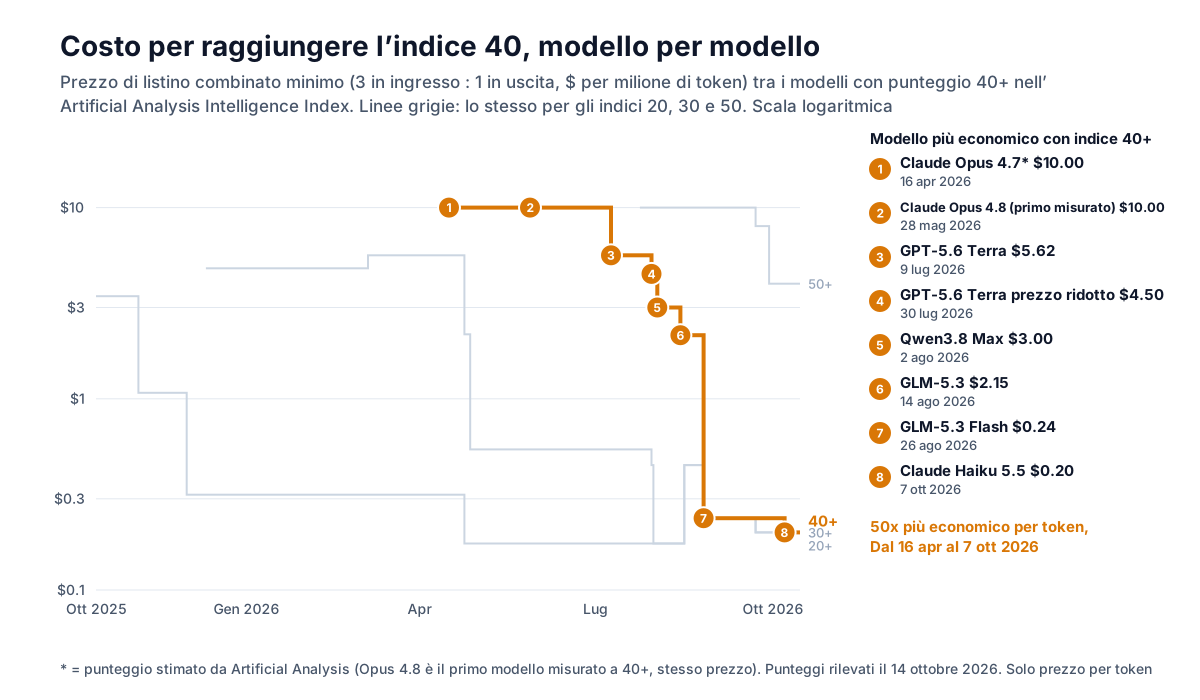
| Livello dell’indice | Modello più economico al primo raggiungimento del livello tra ottobre 2025 e ottobre 2026, $ combinati per milione di token | Più economico oggi | Riduzione del costo per token | Riduzione del costo per task |
|---|---|---|---|---|
| 20 | Inizio del periodo, ottobre 2025: GPT-5*, $3.44 | Claude Haiku 5.5 o GPT-6 Luna, $0.20 | 17x | non pubblicato per GPT-5 |
| 30 | Dicembre 2025: GPT-5.2*, $4.81 | Claude Haiku 5.5 o GPT-6 Luna, $0.20 | 24x | non pubblicato per GPT-5.2 |
| 40 | Aprile 2026: Claude Opus 4.7*, $10 | Claude Haiku 5.5, $0.20 | 50x | 19x, da Opus 4.8 (il primo con dati per task) a $4.08 a Haiku 5.5 a $0.21 |
| 50 | Luglio 2026: Claude Opus 5, $10 | GPT-6.1 Sol o Gemini 4 Argon, $4 | 2.5x | 8.1x, da Opus 5 a $5.86 a GPT-6.1 Sol a $0.72 |
* Punteggio stimato da Artificial Analysis, non misurato. Il primo modello con un punteggio misurato al livello 40, Opus 4.8 a maggio, aveva lo stesso prezzo di listino di $10.
Il prezzo minimo non è sceso in modo costante: da fine aprile a metà agosto, il livello 20 costava $0.175 con DeepSeek V4 Flash, meno degli attuali $0.20.
I modelli con i punteggi più alti non sono diventati economici. Un anno fa i primi due erano GPT-5 e Opus 4.1, con punteggi stimati di 23.0 e 22.8 e prezzi combinati di $3.44 e $30. Oggi il modello migliore è Claude Opus 5.5, con 57.6 punti a un prezzo combinato di $8. I forti cali riguardano livelli che solo pochi mesi prima erano raggiungibili esclusivamente dal modello migliore.
Perché i prezzi si sono mossi così?
Oltre alle dichiarazioni dei laboratori sui propri prezzi, tre sviluppi del mercato coincidono con queste variazioni e spingono in direzioni diverse. Si sovrappongono nel tempo, quindi i dati non permettono di separarne gli effetti.
Domanda e capacità di inferenza. Quando la domanda supera la capacità delle GPU disponibili per rispondere alle richieste, un fornitore può limitare l’uso o far pagare di più nelle ore di punta. OpenRouter, un marketplace che instrada richieste API verso numerosi servizi di hosting dei modelli, è passato da circa 5 mila miliardi di token a settimana ad aprile 2025 a oltre 20 mila miliardi ad aprile 2026, mentre la programmazione è passata da circa l’11% del traffico a più della metà (Wing VC). Anthropic ha rimosso i limiti delle ore di punta sugli abbonamenti Claude dopo aver ottenuto l’accesso al data center Colossus 1 di xAI il 6 maggio. Nello stesso periodo, tra le variazioni dei prezzi delle API figurano GPT-5.5 a $5 / $30 ad aprile, gli aumenti programmati da Google, che ha dichiarato di avere una «capacità insufficiente a soddisfare la domanda», e le tariffe di punta di DeepSeek.
Concorrenza e prezzo minimo. La quota dei modelli cinesi a pesi aperti sui token di OpenRouter è salita da circa il 2% a fine 2024 a circa il 61% entro maggio 2026 (Wing VC), anche se il traffico diretto, come quello di ChatGPT, è molto superiore a quello del router. A giugno il Wall Street Journal ha riportato che OpenAI stava valutando tagli ai prezzi in vista di quelli attesi da Anthropic (Decrypt); entrambe hanno poi lanciato modelli più economici il 22 settembre. Il prezzo minimo, cioè il prezzo più basso per un dato livello di capacità, è stato quello di DeepSeek V4 Flash da fine aprile fino all’aumento di DeepSeek ad agosto, poi è passato a Claude Haiku 5.5 e GPT-6 Luna.
Ricavi dei laboratori dei modelli a pesi aperti. I pesi aperti permettono a qualsiasi servizio di hosting di vendere lo stesso modello. Dopo il rilascio di GLM-5.3 Flash da parte di Zhipu, la quota della sua API sul traffico OpenRouter di quel modello è scesa dall’88% al 22% in tre settimane. Epoch AI, un gruppo di ricerca sull’AI, stima che DeepSeek riceva circa l’8% della spesa su OpenRouter per i modelli DeepSeek (Huxiu tramite Weijin Research). Questi dati sono successivi a gran parte degli aumenti dei modelli a pesi aperti: sono quindi compatibili con gli aumenti, ma non li spiegano. I servizi di hosting non hanno offerto grandi sconti sui modelli di punta più recenti: il 16 ottobre il prezzo del laboratorio era quello più comune per GLM-5.3 (15 servizi su 44) e Kimi K3 (7 su 25). Dei 15 servizi che offrivano Kimi K3 a un prezzo inferiore, 12 usavano pesi quantizzati a 4 bit, una versione compressa le cui risposte possono differire da quelle dell’originale.
Perché il prezzo per token non coincide con il costo per task?
Due modelli con lo stesso prezzo di listino possono avere costi per task che differiscono di diverse volte. La causa principale sono i token di ragionamento: i passaggi intermedi nascosti che il modello scrive prima di rispondere, fatturati come output. Artificial Analysis pubblica il costo medio di ogni modello per task dell’indice ai prezzi di listino.
| Coppia | Prezzo di listino, $ per milione di token (input / output) | Costo medio per task dell’indice |
|---|---|---|
| Claude Haiku 5.5 vs GPT-6 Luna | entrambi $0.10 / $0.50 | $0.21 vs $0.07 |
| Gemini 4 Argon vs GPT-6.1 Sol | entrambi $2 / $10 | $1.99 vs $0.72 |
| Qwen3.8 Max vs GPT-6.1 Sol | $2 / $6 vs $2 / $10 | $5.41 vs $0.72 |
Qwen3.8 Max ha il prezzo di output più basso della coppia, ma costa 7.5 volte di più per task. Nel nostro test, il costo per risposta corretta di Argon è risultato pari a 3.1 volte quello di GPT-6.1 Sol (Costo API di Gemini 4 Argon). Per confrontare i modelli sul proprio traffico, calcola il costo di un lotto di richieste reali in base ai token di ogni risposta (i token di ragionamento sono fatturati come output), dividi il totale per il numero di risposte accettabili e confronta i modelli in base al costo per risposta così ottenuto.
Come sono cambiati i prezzi della cache rispetto all’input?
Le letture dalla cache (i cache hit descritti nella sezione su DeepSeek) sono diventate più economiche rispetto all’input per i modelli di punta e di fascia alta dei laboratori che sviluppano modelli a pesi chiusi, mentre le scritture in cache sono diventate più costose presso due fornitori. La tabella riporta la tariffa di lettura dalla cache di ciascun modello come percentuale del suo prezzo di input.
| Categoria | Lettura cache ÷ input, ottobre 2025: mediana (intervallo) | Ottobre 2026: mediana (intervallo) | Minimo e massimo oggi |
|---|---|---|---|
| SOTA fascia alta | 10% (tutti i modelli) | 5% (dal 2.5% al 10%) | Claude Fable 5.1 2.5%, GPT-6 Astra 10% |
| SOTA di punta | 10% (tutti i modelli) | 5% (tutti i modelli) | Claude Opus 5.5, GPT-6.1 Sol e Gemini 4 Argon tutti al 5% |
| Di punta a pesi aperti | 18% (dal 10% al 25%) | 12.5% (dal 3.3% al 20%) | DeepSeek V4 Pro 3.3%, MiniMax M3 20% |
| Economici / Flash | 10% (tutti i modelli) | 10% (dal 2% al 20%) | DeepSeek V4.1 Flash 2%, GLM-5.3 Flash 20% |
I modelli di punta a pesi chiusi hanno dimezzato la tariffa di lettura dalla cache nell’arco di tre settimane: Opus 5.5 il 22 settembre, GPT-6.1 Sol il 29 settembre e Argon il 13 ottobre. I laboratori dei modelli a pesi aperti applicano una percentuale più alta, con l’eccezione di DeepSeek. Il 3.3% di V4 Pro deriva però da un prezzo di input più alto, non da una lettura dalla cache più economica. MiniMax è passato dal 10% al 20% con M2.7 a marzo. I modelli che non indicavano un prezzo per la cache sono esclusi.
Le condizioni di scrittura in cache, cioè della richiesta che memorizza per la prima volta un prefisso, sono cambiate presso due fornitori. OpenAI ha iniziato a fatturarle con GPT-5.6 a luglio: 1.25 volte il prezzo di input per la cache predefinita di 30 minuti e, dal 20 ottobre, 2.5 volte per quella di 12 ore. Kimi K3 continua a fatturare la scrittura predefinita di 5 minuti al prezzo di input, come Kimi K2, ma ha aggiunto una cache opzionale di 1 ora a 2 volte il prezzo di input. Anthropic continua ad applicare 1.25 volte il prezzo di input per una cache di 5 minuti e 2 volte per una di 1 ora; Google, DeepSeek e Zhipu continuano a non applicare costi aggiuntivi. La guida ai costi di scrittura della cache spiega quando una scrittura conviene.
Come usare questi dati?
Definisci il budget in base alla capacità e al costo per task, non al nome della fascia, e prova di nuovo i modelli piccoli.
| Carico di lavoro | Cosa verificare | Candidati e numeri |
|---|---|---|
| Estrazione, classificazione e instradamento ad alto volume | Se un modello piccolo del 2026 soddisfa i requisiti di qualità | Claude Haiku 5.5 ottiene 43.4 punti e GPT-6 Luna 38.1 a $0.10 / $0.50; un anno fa nessun modello nei dati superava 23 |
| Agenti e ragionamento lungo | Costo per task completato | GPT-6.1 Sol $0.72 per task dell’indice, Gemini 4 Argon $1.99 con lo stesso prezzo di listino |
| Attività che richiedono le massime capacità | Se serve il livello 50 o il massimo disponibile | Il livello 50 costa $4 combinati con GPT-6.1 Sol, o con Argon fino al 1 dicembre; Claude Opus 5.5, con 57.6 punti, costa $8 |
| Budget basato sul prezzo di lancio | Per quanto tempo resterà in vigore il prezzo | I prezzi promozionali di Google hanno aumenti già programmati (Argon il 1 dicembre, Gemini 3.8 Flash il 1 gennaio); OpenAI ha tagliato tutti e tre i prezzi di lancio di GPT-5.6 entro sei settimane; Anthropic ha mantenuto i prezzi tra una versione e l’altra e li ha ridotti con i nuovi modelli |
| Job batch su DeepSeek | Se il lavoro può essere eseguito fuori dalle ore di punta | DeepSeek V4.1 Flash costa la metà fuori dall’orario lavorativo di Pechino: $0.15 / $0.60 contro $0.30 / $1.20 |
| Modelli di punta a pesi aperti per risparmiare | I prezzi dei servizi di hosting e la precisione dei pesi del modello specifico | 12 dei 15 servizi di hosting che offrono Kimi K3 a un prezzo inferiore a quello di Moonshot usano pesi quantizzati a 4 bit |
Domande frequenti
I prezzi delle API LLM stanno scendendo nel 2026? I prezzi per token delle API LLM sono perlopiù aumentati: tra ottobre 2025 e ottobre 2026, il prezzo di listino dell’input è salito in 10 delle 14 fasce di modelli confrontate. A parità di capacità, invece, i prezzi sono diminuiti: il modello più economico con 40 punti nell’Artificial Analysis Intelligence Index costava $10 per milione di token combinati ad aprile 2026 e $0.20 a ottobre (Claude Haiku 5.5). Da maggio a ottobre, il costo per task è sceso di 19 volte.
Quale laboratorio di AI ha tagliato di più i prezzi delle API? Anthropic ha applicato i tagli maggiori: nei due anni fino a ottobre 2026 ha abbassato i prezzi di listino in tutte e tre le sue fasce, con Claude Opus 5.5 a $4 / $20 contro i $15 / $75 di Claude 3 Opus e Claude Haiku 5.5 a $0.10 / $0.50. Google ha aumentato i prezzi in tutte e tre le fasce. Per OpenAI, i prezzi combinati del modello di punta e di quello piccolo si sono mantenuti entro il 25% dei valori di ottobre 2024, mentre quello della fascia intermedia è salito di 17 volte.
Altri articoli
- Costo API di Gemini 4 Argon: stesso prezzo di listino di GPT-6.1 Sol, costo per risposta corretta pari a 3.1x
- Fasce di prezzo per contesti lunghi: le soglie di lunghezza del prompt a cui ogni fornitore aumenta il prezzo
- Quanto costa scrivere nella cache dei prompt: prezzi di scrittura e lettura per fornitore
- Costo di Claude Haiku 5.5: la soglia di prezzo a 100,000 token, misurata
- Costo di Kimi K3: un modello di punta a pesi aperti al prezzo di un modello a pesi chiusi