
Gemini 4 Argon: prezzo di GPT-6.1 Sol, costo per risposta 3x
Indice
- Quanto costa Gemini 4 Argon?
- Con quali modelli OpenAI e Claude compete Gemini 4 Argon?
- Come si confronta il costo per risposta di Argon con GPT-6.1 Sol, GPT-6 Astra e Opus 5.5?
- Cosa fa ciascun livello di ragionamento?
- Cosa smette di funzionare passando a Gemini 4 Argon?
- Quale livello di ragionamento usare per ogni carico di lavoro?
- Domande frequenti
- Altri articoli
Gemini 4 Argon costa quanto GPT-6.1 Sol: $2 per milione di token in input e $10 per milione di token in output. Sul nostro set di 13 problemi di ragionamento, però, il costo per risposta corretta è stato 3.1x più alto ($0.0063 contro $0.0020, calcolato dividendo la spesa totale per le risposte corrette). A parità di risultato, 38 chiamate corrette su 39, ha generato 3.3x i token in output. Il rapporto si inverte rispetto ai modelli di fascia alta con cui Google lo confronta: Argon è costato 0.76x Claude Opus 5.5 e 0.6x GPT-6 Astra, ma il suo prezzo raddoppia il 1 dicembre. Il parametro principale per controllare i costi è thinking_level: stabilisce quanto a lungo gemini-4-argon ragiona prima di rispondere (low, medium come default, high). I token di ragionamento si pagano come output anche quando non compaiono nella risposta. Abbiamo misurato tutti e tre i livelli due giorni dopo il lancio dell’API, eseguendo nello stesso giorno anche i test sui modelli di confronto e su Gemini 3.1 Pro.
TL;DR
- Gemini 4 Argon costa $2/$10 per milione di token fino al 30 novembre 2026, poi $4/$20.
- Google confronta Argon con GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5; Argon è primo in 13 delle 19 righe pubblicate.
- A
medium, il costo per risposta corretta è stato $0.0063 per Argon, $0.0020 per GPT-6.1 Sol e $0.0083 per Opus 5.5; con i prezzi di dicembre Argon arriva a $0.0125. - A
low, Argon non ha riportato ragionamento e ha risposto correttamente a 1 chiamata su 15 nei cinque problemi più difficili, contro 14 su 15 amedium.
Quanto costa Gemini 4 Argon?
Il prezzo dell’API di Gemini 4 Argon raddoppia il 1 dicembre 2026. La pagina dei prezzi di Google indica una tariffa valida fino al 30 novembre e il prezzo di listino successivo, senza un piano gratuito. L’input in cache è testo che il server ha già ricevuto in una richiesta precedente, per esempio un system prompt ripetuto, e costa il 5% della tariffa di input. I prezzi sono in dollari per milione di token:
| Fascia | Input | Output (ragionamento incluso) | Input in cache |
|---|---|---|---|
| Standard, fino al 30 novembre | $2.00 | $10.00 | $0.10 |
| Standard, dal 1 dicembre | $4.00 | $20.00 | $0.20 |
| Batch e Flex, fino al 30 novembre | $1.00 | $5.00 | $0.05 |
| Priority, fino al 30 novembre | $3.60 | $18.00 | $0.18 |
Anche dopo il 1 dicembre, Batch (richieste inviate come job, risultati entro poche ore) e Flex (capacità best-effort) restano a metà della tariffa standard, mentre Priority (capacità riservata) resta a 1.8x. Rispetto a Gemini 3.1 Pro, il precedente modello di punta di Google a $2/$12, cambiano tre cose:
- Nessun sovrapprezzo per il contesto lungo. Gemini 3.1 Pro passa a $4/$18 quando il prompt supera 200K token; Argon mantiene $2/$10 fino alla sua finestra di contesto di 1,048,576 token, il massimo che una richiesta può contenere tra input, ragionamento e risposta. Ai prezzi di listino, il nostro prompt da 709K token è costato $1.42 su Argon e $2.84 su 3.1 Pro.
- Solo cache implicita. La cache esplicita, per cui si creava un oggetto cache e se ne pagava lo storage, non è più disponibile. I prefissi ripetuti dei prompt vengono messi in cache automaticamente e fatturati alla tariffa dell’input in cache.
- Per superare 64K token in output serve un’altra modalità. Una richiesta normale restituisce al massimo 65,536 token in output. Per risposte più lunghe serve la modalità di esecuzione in background di Google, in cui il server continua a generare in blocchi da 64K fino a 1M token.
Con quali modelli OpenAI e Claude compete Gemini 4 Argon?
Per capacità, Google confronta Gemini 4 Argon con il modello di punta di ciascun laboratorio: GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. Per prezzo si colloca una fascia sotto: $2/$10 come GPT-6.1 Sol fino al 30 novembre, poi $4/$20 come Opus 5.5 dal 1 dicembre. GPT-6 Astra e Fable 5.1 hanno un prezzo di listino di $10/$50.
L’indice di intelligenza di Artificial Analysis combina benchmark su agenti, programmazione, conoscenze e scienza eseguiti direttamente da Artificial Analysis. Riporta anche quanto costa eseguire un problema dell’indice con ciascun modello. Argon è allo stesso livello di GPT-6 Astra e Fable 5.1, mentre Opus 5.5 è avanti di quattro-cinque punti:
| Modello | Prezzo di listino, $ per milione di token | Nella tabella dei benchmark di Google | Punteggio nell’indice (all’impostazione massima del fornitore) | Costo per problema dell’indice |
|---|---|---|---|---|
| Gemini 4 Argon | 2/10, poi 4/20 | Modello valutato | 52.6 | $1.99 |
| GPT-6 Astra | 10/50 | Sì | 52.7 | $3.26 |
| Claude Fable 5.1 | 10/50 | Sì | 53.4 | $7.63 |
| Claude Opus 5.5 | 4/20 | Sì | 57.6 | $5.98 |
| GPT-6.1 Sol | 2/10 | No | 51.8 | $0.72 |
La tabella di Google, tratta dalla scheda del modello Argon, contiene 19 righe. Argon è primo in 13 e a pari merito in una; GPT-6 Astra è primo in tre e Opus 5.5 in due. Qui sotto riportiamo dieci delle 19 righe: quelle con i divari più ampi, nel lavoro intellettuale e nel contesto lungo, e tutte e cinque quelle in cui Argon perde, relative a programmazione su più ore, lavoro da terminale e uso del desktop. I punteggi sono percentuali: più alti sono, meglio è.
| Benchmark | Cosa misura | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|---|
| Vals Index | Indice composito di Vals AI sul lavoro intellettuale | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey Legal Agent | Attività legali svolte dal modello dall’inizio alla fine | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | Risoluzione di issue in repository reali | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | Attività di sviluppo e ottimizzazione che durano ore | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | Attività in un terminale Linux | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | Addestramento di un modello su una GPU in 10 ore | 45.3% | 44.3% | 40.2% | 49.3% |
| Terminal-Bench Science 0.1 | Calcolo scientifico da terminale | 57.6% | 68.1% | 52.6% | 63.3% |
| RiemannBench | Problemi matematici di livello di ricerca | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks, da 256K a 1M | Navigazione lungo gli archi di un grafo in un contesto lungo | 84.2% | 71.8% | 65.0% | 66.8% |
| OSWorld 2.0, offline | Uso del computer desktop | 69.2% | 72.6% | non riportato | non riportato |
Questa tabella riporta le dichiarazioni di Google, non un confronto controllato. Secondo la nota metodologica di Google, Argon è stato eseguito al livello massimo di ragionamento. La maggior parte dei risultati dei concorrenti proviene dai report di valutazione dei rispettivi fornitori o da classifiche pubbliche, con il livello di ragionamento massimo o il migliore disponibile. Google ha prodotto diversi punteggi di Argon (DeepSWE, entrambe le righe Terminal-Bench, OSWorld) con il proprio test harness, il codice che esegue e valuta le attività, mentre i risultati dei concorrenti provengono da altre fonti. Su Terminal-Bench Science, per Argon il programma di valutazione aveva a disposizione sei volte più tempo.
Come si confronta il costo per risposta di Argon con GPT-6.1 Sol, GPT-6 Astra e Opus 5.5?
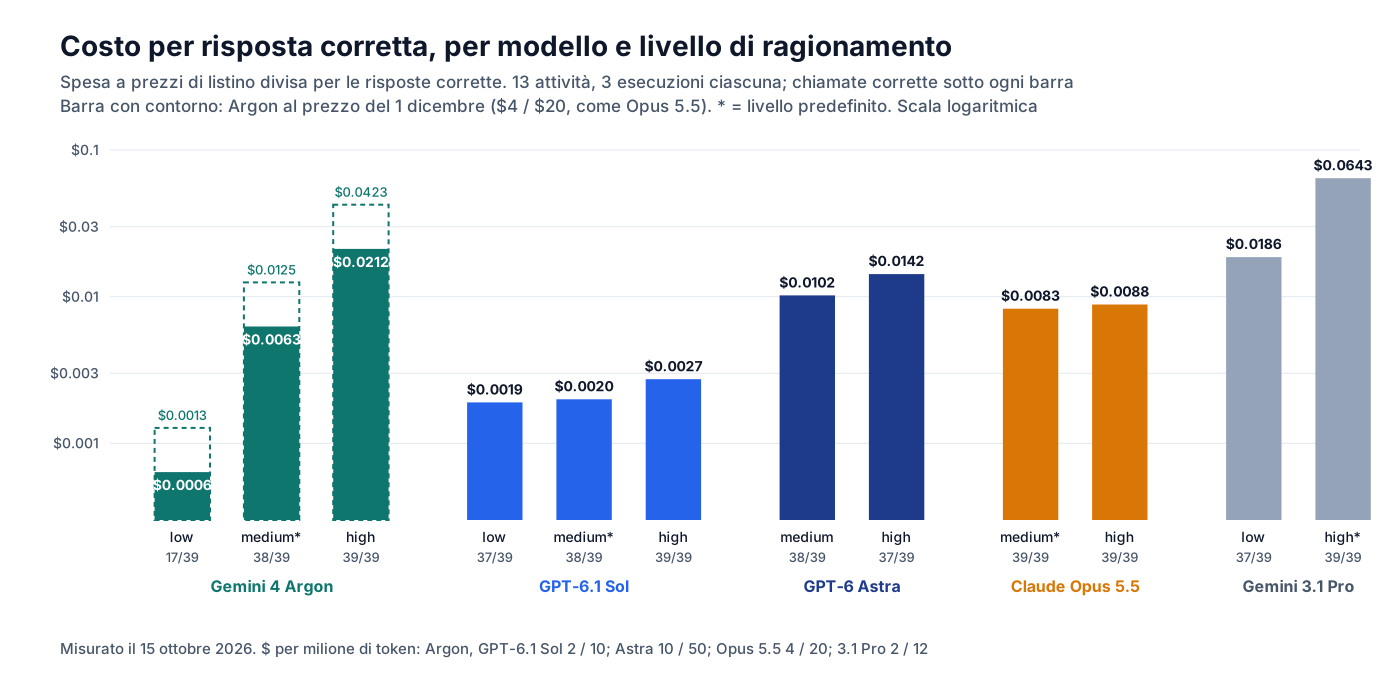
A parità di prezzo per token, Gemini 4 Argon è costato 3.1x GPT-6.1 Sol per risposta corretta a medium, il livello predefinito di entrambi, e 7.7x a high. A medium entrambi hanno ottenuto 38/39. Rispetto ai modelli di punta, per ora costa meno: 0.6x il costo per risposta corretta di GPT-6 Astra e 0.76x quello di Claude Opus 5.5.
Abbiamo eseguito 13 problemi di ragionamento con risposte verificate da un breve programma, ripetendo ciascuno tre volte: ogni combinazione di modello e livello qui sotto comprende quindi 39 chiamate. Una chiamata è corretta se l’intero restituito come risposta finale coincide con quello atteso. Gli otto problemi più semplici: sommare i numeri primi minori di 60, contare le occorrenze della cifra 7 da 1 a 500, un orario ferroviario, 7 elevato a 222 modulo 1000, una regola applicata 40 volte di seguito, numeri di quattro cifre non nulle e distinte divisibili per 11, percorsi su una griglia con una cella bloccata e modi per comporre 47 centesimi. I cinque più difficili, che chiamiamo set difficile: la stessa regola applicata 200 volte, il resto di 13 elevato a 1001 diviso per 10007, una griglia 8x8 con tre celle bloccate, la scelta degli oggetti tra 10 disponibili entro un limite di peso e 187 centesimi con cinque tipi di moneta.
Per ogni modello abbiamo usato il formato di richiesta che supporta il relativo controllo del ragionamento: per Argon e Gemini 3.1 Pro il vecchio formato chat di OpenAI, ripreso da molti provider, in cui il parametro è reasoning_effort; per i modelli GPT il più recente formato Responses di OpenAI; per Opus 5.5 il formato nativo di Anthropic, con output_config.effort. Abbiamo usato i livelli medium e high di ciascun fornitore, più low dove disponibile.
| Modello e livello | Chiamate corrette (su 24 semplici / su 15 difficili) | Mediana dei token in output (ragionamento incluso) | Costo per risposta corretta | Al prezzo di Argon di dicembre |
|---|---|---|---|---|
Argon low | 16/24, 1/15 | 7 | $0.0006 | $0.0013 |
Argon medium (predefinito) | 24/24, 14/15 | 383 | $0.0063 | $0.0125 |
Argon high | 24/24, 15/15 | 1,455 | $0.0212 | $0.0423 |
GPT-6.1 Sol low | 24/24, 13/15 | 90 | $0.0019 | |
GPT-6.1 Sol medium (predefinito) | 24/24, 14/15 | 81 | $0.0020 | |
GPT-6.1 Sol high | 24/24, 15/15 | 192 | $0.0027 | |
GPT-6 Astra medium (predefinito) | 24/24, 14/15 | 90 | $0.0102 | |
GPT-6 Astra high | 24/24, 13/15 | 134 | $0.0142 | |
Claude Opus 5.5 medium (predefinito) | 24/24, 15/15 | 188 | $0.0083 | |
Claude Opus 5.5 high | 24/24, 15/15 | 223 | $0.0088 | |
Gemini 3.1 Pro low | 24/24, 13/15 | 1,091 | $0.0186 | |
Gemini 3.1 Pro high (predefinito) | 24/24, 15/15 | 3,272 | $0.0643 |
Il divario con GPT-6.1 Sol dipende dalla lunghezza dell’output. Nelle 39 chiamate a medium, Argon ha generato in totale 22,980 token in output e GPT-6.1 Sol 7,032. Sul singolo problema più difficile, 13 elevato a 1001 modulo 10007, la mediana di Argon è stata 1,523 token a medium e 6,108 a high; quella di GPT-6.1 Sol 524 e 901. I risultati sul set difficile sono stati identici: 14/15 ciascuno a medium e 15/15 ciascuno a high. Dal 1 dicembre il divario a medium raddoppia a 6.3x, perché il prezzo di Argon raddoppia e quello di GPT-6.1 Sol no.
A dicembre cambia anche il confronto con Opus 5.5. Entrambi avranno un prezzo di listino di $4/$20, e sul nostro set Opus 5.5 ha generato meno token (15,414 contro i 22,980 di Argon a medium) rispondendo correttamente a tutte le 39 chiamate. Al prezzo di dicembre Argon costa $0.0125 per risposta corretta contro $0.0083 di Opus 5.5, cioè 1.5x; rispetto a GPT-6 Astra passa da 0.6x a 1.2x. Con 15 chiamate sul set difficile per livello, nessuna differenza di punteggio tra Argon, Opus 5.5 e GPT-6 Astra è statisticamente distinguibile (queste coppie sono state verificate separatamente dal gruppo di confronti corretto nella sezione successiva). I costi per problema di Artificial Analysis ordinano i modelli allo stesso modo: GPT-6.1 Sol $0.72 al livello massimo, Argon $1.99 a high e al prezzo attuale, GPT-6 Astra $3.26, Opus 5.5 $5.98.
Rispetto a Gemini 3.1 Pro, il modello che sostituisce, Argon costa circa 10x meno per risposta corretta usando il livello predefinito di ciascuno: $0.0063 contro $0.0643. Parte del divario dipende dal prezzo, perché 3.1 Pro costa $12 per milione di token in output anziché $10. A parità di prezzo il divario è 8.6x, dovuto alla mediana di 3,272 token in output per chiamata di 3.1 Pro contro i 383 di Argon. Dopo il 1 dicembre Argon resta 5.1x più economico su questo set. Abbiamo anche verificato quanti token impiegano i due modelli per ammettere di non conoscere un fatto inventato: interrogati su cinque entità fittizie (il prezzo delle azioni di un’azienda, un istituto di ricerca, uno statuto comunale, una lega metallica e un premio), entrambi hanno rifiutato di rispondere a tutte e cinque, con una mediana di 146 token in output per Argon e 1,014 per 3.1 Pro.
Cosa fa ciascun livello di ragionamento?
Su Gemini 4 Argon, low ha di fatto disattivato il ragionamento. Google documenta tre livelli e descrive low come quello che usa il “minor numero di token”, aggiungendo che “la qualità può calare sui problemi difficili”. In tutte le 39 chiamate a low, Argon non ha riportato token di ragionamento e il suo intero output, che su questo percorso include anche l’eventuale ragionamento, è stato di 5-11 token. Un secondo percorso API che inoltra le richieste ai server di Google ha riportato esplicitamente 0 token di ragionamento in tutte e quattro le chiamate a low inviate. Il livello low di Gemini 3.1 Pro, invece, ha comunque generato una mediana di 1,091 token in output, quasi tutti di ragionamento.
Senza ragionamento, Argon ha continuato a risolvere i problemi a un solo passaggio, ma ha fallito quelli che richiedono passaggi intermedi:
- Ancora corretti a
low: somma dei primi, conteggio della cifra, orario, griglia con una cella bloccata e 47 centesimi (15 chiamate su 15). - Errati a
low: regola a 40 passaggi (0/3), conteggio dei numeri di quattro cifre (0/3), 7 elevato a 222 (1/3) e 14 chiamate su 15 nel set difficile.
Il calo si conferma quando ogni compito viene conteggiato una sola volta, il che è importante perché tre esecuzioni dello stesso compito non sono indipendenti: medium ha battuto low in 8 dei 13 compiti e non ha perso in nessuno (test dei segni, p = 0.008, una probabilità inferiore all’1% che un divario così ampio sia casuale). Sul solo set difficile, low non ha risolto nessuno dei cinque compiti in almeno due esecuzioni su tre e medium li ha risolti tutti e cinque (test esatto di Fisher, p = 0.008; 0.047 dopo la correzione di Holm per i sei confronti eseguiti). Trattate low come una modalità senza ragionamento per ricerche puntuali e conversioni di formato. All’estremo opposto, high è costato 3.4x medium per risposta corretta e ha risolto una chiamata in più su 15 nel set difficile: con questo campione non si può distinguere la differenza dal caso.
Il livello predefinito si adatta al prompt. Su prompt semplici inviati senza specificare un livello, Argon, che usa medium come default, ha spesso impiegato zero token di ragionamento. Gemini 3.1 Pro, che usa high, ha invece ragionato su tutti. Con il tool calling il modello chiede al vostro codice di eseguire una funzione e voi gli restituite il risultato:
| Tipo di prompt (mediana di 3 esecuzioni) | Token di ragionamento di Argon | Token di ragionamento di Gemini 3.1 Pro |
|---|---|---|
| Ricerca con risposta di una parola | 0 | 145 |
| Estrazione JSON | 0 | 353 |
| Output con schema JSON rigido | 0 | 309 |
| Problema testuale a due passaggi | 41 | 137 |
| Catena aritmetica a cinque passaggi | 68 | 373 |
| Ciclo di tool calling, primo turno (scelta del tool) | 0 (31 token in output) | 173 |
| Ciclo di tool calling, secondo turno (uso del risultato) | 0 (32 token in output) | 67 |
Entrambi i modelli hanno risposto correttamente a tutti i prompt e chiamato i tool giusti. Nell’API nativa di Google il livello si imposta in generation_config e il conteggio dei token di ragionamento viene restituito in usage:
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Compute 13 raised to the power 1001, modulo 10007. Reply with a single integer.",
    generation_config={"thinking_level": "medium", "max_output_tokens": 32768},
)
print(interaction.output_text)
print("thinking tokens:", interaction.usage.total_thought_tokens)  # billed at the output rate
print("output tokens:", interaction.usage.total_output_tokens)
Nel formato chat compatibile con OpenAI usato per le misurazioni, il gateway mappa reasoning_effort sugli stessi tre livelli e restituisce il conteggio in usage.completion_tokens_details.reasoning_tokens.
Cosa smette di funzionare passando a Gemini 4 Argon?
I prompt che terminano con un turno assistant precompilato ora falliscono con HTTP 400, la cache esplicita non è più disponibile e i parametri di casualità (temperature, top_p, top_k) vengono ignorati. Precompilare significa iniziare voi stessi la risposta del modello, per esempio con una parentesi graffa aperta per forzare il JSON. La maggior parte di questi cambiamenti compare nella checklist di migrazione di Google; non ci sono invece l’errore di precompilazione, l’overhead del prompt e il comportamento quando si supera la finestra:
| Cambiamento | Documentazione di Google | Cosa abbiamo misurato |
|---|---|---|
| Turno assistant precompilato | Non indicato | HTTP 400 su Gemini 4 Argon: “Le richieste che terminano con un turno del modello non sono supportate”; Gemini 3.1 Pro lo accetta |
Cache esplicita (cachedContents) | Rimossa | Non testata; la cache implicita ha funzionato |
| Cache implicita | Sconto del 95%, prompt da 4,096+ token | Ripetendo un prompt da 6,935 token dopo 4 secondi, 4,881 token sono stati serviti dalla cache a $0.10 per milione; anche un prompt da 3,006 token ha ottenuto 952 token in cache |
temperature, top_p, top_k | Ignorati | Accettati con HTTP 200 (nessun errore) |
| Overhead fisso del prompt | Non indicato | Circa 30 token in input in più per richiesta rispetto a Gemini 3.1 Pro, a parità di testo; un secondo percorso API verso Google riporta lo stesso conteggio |
| Prompt oltre la finestra di 1M | Non indicato | HTTP 400 con indicazione del limite, nessun troncamento silenzioso |
max_output_tokens | Aumentare a 32,768 o più | La risposta più lunga di Argon è stata di 6,391 token a high, quella di Gemini 3.1 Pro di 21,362 |
Per risolvere l’errore di precompilazione, spostate l’istruzione nel prompt. L’overhead aggiunge $0.00006 per richiesta al prezzo attuale ed è costante: 27 token extra su un prompt di una riga e 31 su un documento da 709K token rispetto a Gemini 3.1 Pro. Il tokenizer, il componente che suddivide il testo in token, non è quindi cambiato. Quel prompt da 709K token conteneva 60,000 elementi numerati e, alla fine, una domanda sull’elemento 42; Argon ha accettato la richiesta e risposto 529, il valore inserito per il test.
Quale livello di ragionamento usare per ogni carico di lavoro?
Partite da medium, non usate mai low per attività a più passaggi e prevedete nel budget i prezzi di dicembre.
| Carico di lavoro | Rischio principale | Livello e modello | Dati a supporto |
|---|---|---|---|
| Passaggi di agenti, chiamate a tool, estrazione, output JSON | Pagare il ragionamento su passaggi semplici | Gemini 4 Argon medium; qui spende già quasi zero in ragionamento | 0 token di ragionamento per ricerche puntuali, estrazione, output con schema e passaggi con tool |
| Matematica difficile, algoritmi, codice a più passaggi | Risposte errate | Argon medium; provate high sui vostri test prima di pagarne il costo | 14/15 contro 15/15 sul set difficile, high costa 3.4x |
| Ragionamento ad alto volume in cui conta soprattutto il costo per risposta | Volume del ragionamento | GPT-6.1 Sol, stesso punteggio su questo set di 13 problemi | $0.0020 contro $0.0063 per risposta corretta, 6.3x dopo il 1 dicembre |
| Attività di fascia alta con budget oltre dicembre | Raddoppio del prezzo di Argon | Ripetete i vostri test su Claude Opus 5.5, allo stesso prezzo di listino di $4/$20 | $0.0083 contro $0.0125 per risposta corretta ai prezzi di dicembre; Argon è primo in più righe di Google sul lavoro intellettuale |
| Documenti lunghi oltre 200K token | Sovrapprezzo per il contesto lungo | Argon al posto di Gemini 3.1 Pro | $1.42 contro $2.84 per un prompt da 709K token |
| Solo ricerche puntuali e conversione di formato | Ragionamento inutile | Argon low | 15/15 sui problemi a un passaggio, 7 token in output |
Dopo il 1 dicembre, Batch e Flex costeranno quanto Standard oggi ($2/$10). Spostando lì i job offline, manterrete i prezzi di ottobre.
Domande frequenti
Si può disattivare il ragionamento su Gemini 4 Argon?
Gemini 4 Argon non ha un’impostazione documentata per disattivarlo, ma nei nostri test thinking_level: "low" ha funzionato come un interruttore: nessun token di ragionamento riportato in tutte le 39 chiamate, il cui intero output era di 5-11 token, e uno 0 esplicito in tutte e quattro le chiamate su un secondo percorso API verso Google. A low ha risposto correttamente a 1 chiamata su 15 nei cinque problemi più difficili, contro 14 su 15 al livello predefinito medium.
Gemini 4 Argon costa di più per i prompt lunghi? Gemini 4 Argon applica la stessa tariffa di $2/$10 a qualsiasi prompt entro la finestra di 1,048,576 token fino al 30 novembre 2026, poi $4/$20. Gemini 3.1 Pro costa $4/$18 sopra 200K token: ai prezzi di listino, un prompt da 709K token costa quindi $1.42 su Argon e $2.84 su 3.1 Pro.
La cache implicita funziona su Gemini 4 Argon? La cache implicita di Gemini 4 Argon ha servito dalla cache 4,881 token di un prompt da 6,935 token ripetuto 4 secondi dopo la prima chiamata, al prezzo di $0.10 per milione di token (sconto del 95% sull’input). Ha anche memorizzato parte di un prompt da 3,006 token, sotto il minimo di 4,096 token indicato nella documentazione di Google.
Altri articoli
- GPT-6.1 Sol contro Claude Sonnet 5.5: lo stesso set di 13 problemi allo stesso prezzo di $2/$10
- Controlli del ragionamento degli LLM a confronto: cosa fa il parametro di ragionamento di ciascun fornitore
- Soglie minime della cache dei prompt, misurate: soglie documentate e soglie effettive
- Costo dell’API Gemini 3.7 Flash: il precedente lancio di Gemini con prezzi introduttivi
Misurazioni del 15 ottobre 2026, due giorni dopo la disponibilità generale dell’API. Livelli di ragionamento: 13 problemi con risposte verificate da un programma, 3 esecuzioni per modello e livello, significatività testata contando ogni problema una sola volta, ogni prompt contrassegnato con un ID casuale per impedire che la risposta fosse servita dalla cache; costi calcolati ai prezzi di listino dai conteggi dei token. Test sull’overhead del ragionamento, sull’output strutturato e sui tool: 3 esecuzioni ciascuno; test su migrazione, cache, contesto lungo e fatti inventati: singole chiamate. Il risultato a low e l’overhead dei token del prompt sono stati confermati tramite un secondo percorso API che inoltra le richieste a Google. Dati di Artificial Analysis consultati il 14 ottobre 2026; tabella dei benchmark di Google tratta dalla scheda del modello Gemini 4 Argon.