
Claude Haiku 5.5: oltre 100K token il costo sale di 5x
Indice
- Come abbiamo misurato i costi
- Quanto costa Claude Haiku 5.5 ai due lati della soglia?
- I token in cache e quelli di output contano per la soglia di 100,000 token?
- 100,000 token corrispondono alla stessa quantità di testo su Claude Haiku 4.5?
- Cosa succede quando il contesto di un agente supera la soglia?
- Come si mantiene un agente sotto soglia?
- Costa meno di GPT-6 Luna a parità di listino?
- Domande frequenti
- Quanto costa Claude Haiku 5.5?
- I token in cache contano per la soglia di 100,000 token di Claude Haiku 5.5?
- Claude Haiku 5.5 costa meno di Claude Haiku 4.5?
- Claude Haiku 5.5 costa meno di GPT-6 Luna?
- Come mantengo le richieste a Claude Haiku 5.5 sotto 100,000 token?
- Altri articoli
Claude Haiku 5.5 ha due listini: la lunghezza del prompt determina quale si applica all’intera richiesta. Abbiamo inviato un prompt di esattamente 100,000 token e ci sono stati addebitati $0.0100. Con un token in più, l’addebito è stato di $0.0500. Nel prompt rientra tutto ciò che invii: prompt di sistema, definizioni dei tool e messaggi. Contano anche i token letti dalla prompt cache. Il listino Anthropic non lo specifica, ma lo abbiamo verificato sulla fattura di Anthropic.
TL;DR
- Un prompt da 100,000 token su Claude Haiku 5.5 è costato $0.010008. Con 100,001 token è costato $0.050041, cinque volte tanto.
- Un prompt da 102,011 token, composto per il 94% da letture dalla cache, è stato fatturato ai prezzi più alti: $0.0078 contro $0.0016 ai prezzi più bassi.
- Lo stesso testo inglese occupa su Haiku 5.5 da 1.4 a 1.5 volte i token che occupa su Claude Haiku 4.5.
- In un ciclo agentico, sei richieste oltre soglia hanno rappresentato il 76% del costo di un’esecuzione da $0.083. Con la compattazione o un sub-agent, il costo è sceso a $0.026 o $0.016.
Come abbiamo misurato i costi
La maggior parte delle richieste è passata dal gateway Synthorai l’8 e il 9 ottobre 2026. Per «costo addebitato» intendiamo quanto il gateway ha fatturato per una richiesta. Il gateway applica i due listini Anthropic e calcola la lunghezza del prompt sommando i tre conteggi di input nella risposta: input non in cache, letture dalla cache e scritture nella cache. Tutti i 581 importi addebitati che abbiamo controllato corrispondevano a uno dei due listini fino alla sesta cifra decimale.
La pagina dei prezzi Anthropic dice solo che il modello ha un prezzo «in base alla lunghezza del prompt» e la risposta API non riporta alcun prezzo. Abbiamo quindi inviato 23 degli stessi prompt direttamente all’API Anthropic e controllato nella Anthropic Console il costo giornaliero del modello: $0.33. Il totale di quelle richieste è $0.3301 se ogni prompt oltre 100,000 token paga il listino più alto, anche quando usa la cache, e $0.2678 se le letture dalla cache non contano. Anthropic fattura come il gateway.
Quanto costa Claude Haiku 5.5 ai due lati della soglia?
Superati i 100,000 token di prompt, ogni voce del listino costa cinque volte tanto. I prezzi sono per milione di token.
| Prompt fino a 100,000 token | Prompt oltre 100,000 token | Claude Haiku 4.5 | |
|---|---|---|---|
| Input | $0.10 | $0.50 | $1.00 |
| Output | $0.50 | $2.50 | $5.00 |
| Lettura dalla cache | $0.01 | $0.05 | $0.10 |
| Scrittura nella cache, 5 minuti | $0.125 | $0.625 | $1.25 |
| Input / output Batch | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 |
Una scrittura nella cache avviene alla prima richiesta che memorizza un prefisso del prompt; una lettura avviene quando una richiesta successiva lo riutilizza. Batch è l’API asincrona di Anthropic, a metà prezzo.
Il listino più alto si applica all’intera richiesta, non solo ai token oltre soglia. Abbiamo costruito un prompt da 99,872 token e aggiunto uno o due token alla volta:
| Token del prompt | Costo addebitato | Listino |
|---|---|---|
| 99,998 | $0.010008 | più basso |
| 100,000 | $0.010008 | più basso |
| 100,001 | $0.050041 | più alto |
| 100,002 | $0.050041 | più alto |
A esattamente 100,000 token si applica ancora il listino più basso, come indica la dicitura «oltre 100,000». Secondo Anthropic, i prompt fino a 100,000 token rappresentavano circa il 90% delle richieste a Claude Haiku 4.5. Per token, il nuovo modello costa il 90% in meno del precedente sotto soglia e il 50% in meno sopra.
I token in cache e quelli di output contano per la soglia di 100,000 token?
I token in cache contano, quelli di output no. Abbiamo memorizzato nella cache un prefisso da 96,045 token e lo abbiamo reinviato aggiungendo parti finali di lunghezza diversa:
| Richiesta | Token del prompt | Letti dalla cache | Costo addebitato | Listino |
|---|---|---|---|---|
| prefisso, prima volta (scritto nella cache) | 96,058 | 0 | $0.012009 | più basso |
| prefisso reinviato | 96,058 | 96,045 | $0.000964 | più basso |
| prefisso con 1,000 token aggiuntivi | 97,034 | 96,045 | $0.001061 | più basso |
| prefisso con 6,000 token aggiuntivi | 102,011 | 96,045 | $0.007795 | più alto |
Nell’ultima richiesta, il 94% dei token è letto dalla cache, ma si applica il listino più alto: $0.0078 invece dei $0.0016 del listino più basso. Per verificare l’output, un prompt da 97,864 token con una risposta da 1,905 token è costato $0.010739, secondo il listino più basso.
Per verificare la soglia, somma tre campi della risposta. Se devi saperlo prima di inviare la richiesta, l’endpoint per il conteggio dei token accetta gli stessi system, tools e messages della richiesta:
import anthropic

client = anthropic.Anthropic()

# after a request: the length the price list is chosen by
u = response.usage
prompt_tokens = u.input_tokens + u.cache_read_input_tokens + u.cache_creation_input_tokens

# before a request
count = client.messages.count_tokens(model="claude-haiku-5-5", system=system, tools=tools, messages=messages)
over_the_line = count.input_tokens > 100_000
100,000 token corrispondono alla stessa quantità di testo su Claude Haiku 4.5?
No. Claude Haiku 5.5 usa un tokenizer più recente, il componente che divide il testo nelle unità usate per la fatturazione. Lo stesso testo produce più token che su Claude Haiku 4.5. La guida alla migrazione di Anthropic indica «circa il 30% in più». Abbiamo contato cinque campioni su entrambi i modelli:
| Testo | Haiku 4.5 | Haiku 5.5 | Rapporto | 100,000 su Haiku 5.5 equivalgono, su Haiku 4.5, a |
|---|---|---|---|---|
| Prosa inglese (un rapporto NIST, 12 pagine) | 6,478 | 9,618 | 1.48 | 67,353 |
| Un articolo scientifico, 6 pagine | 4,352 | 6,048 | 1.39 | 71,958 |
| Codice JavaScript | 8,802 | 11,814 | 1.34 | 74,505 |
| Codice Python | 9,743 | 12,144 | 1.25 | 80,229 |
| Markdown con cinese e inglese | 13,351 | 14,710 | 1.10 | 90,761 |
Una prosa inglese che su Haiku 4.5 occupava 68,000 token è già alla soglia su Haiku 5.5. Un budget calcolato sul vecchio modello colloca quindi la soglia nel punto sbagliato. Anche il risparmio per documento è inferiore a quello per token: con 1.48 volte i token, la prosa inglese costa l’85% in meno rispetto a Haiku 4.5 sotto soglia e il 26% in meno sopra.
Cosa succede quando il contesto di un agente supera la soglia?
La prima richiesta che supera la soglia costa circa cinque volte quella precedente, e tutte le successive restano su quel livello. A ogni turno, un ciclo agentico reinvia l’intera conversazione. Se il prompt cresce di un risultato di tool per turno, prima o poi raggiunge 100,000 token.
Abbiamo eseguito su Claude Haiku 5.5 un agente che legge 20 file di log, ciascuno di circa 7,000 token, tramite un tool read_file e ne riporta il totale complessivo. Ogni risultato del tool rimane nella conversazione e il prefisso viene messo in cache, come avviene di solito in questi cicli. Le richieste dalla 15 alla 18 di un’esecuzione:
| Richiesta | Token del prompt | Letti dalla cache | Costo addebitato |
|---|---|---|---|
| 15 | 92,701 | 85,593 | $0.001787 |
| 16 | 99,705 | 92,699 | $0.001845 |
| 17 | 106,744 | 99,703 | $0.009598 |
| 18 | 113,771 | 106,742 | $0.009942 |
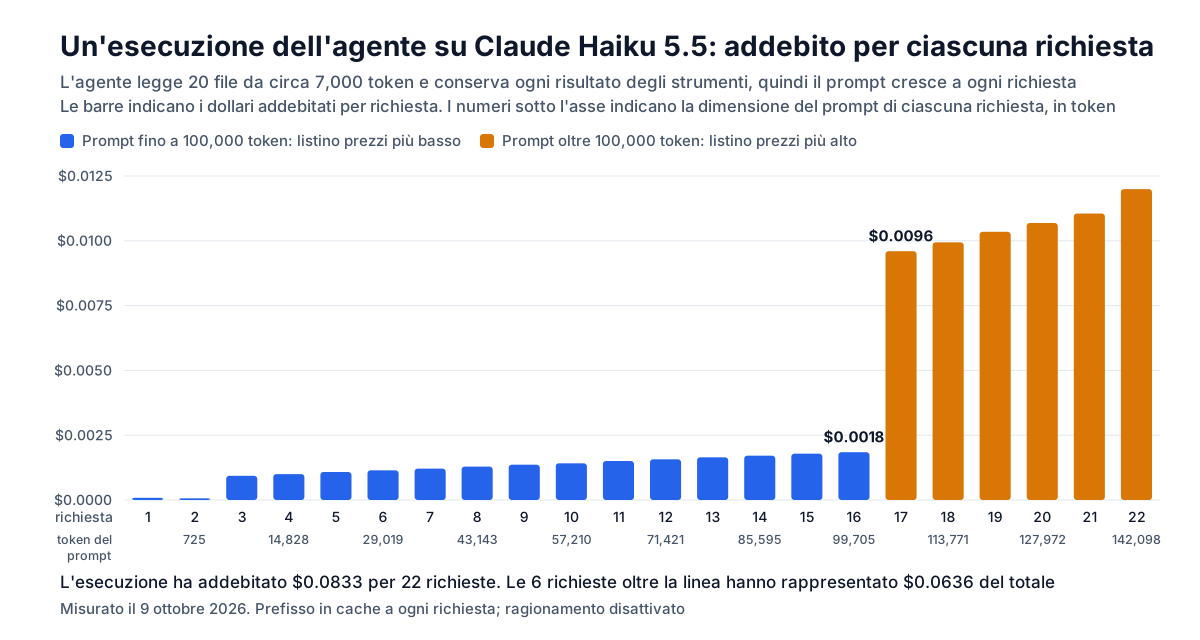
La richiesta 17 ha 7,000 token in più della 16 e costa 5.2 volte tanto. L’esecuzione ha fatto 22 richieste per un costo di $0.0833. Le sei richieste oltre soglia sono costate $0.0636, pari al 76%. Agli stessi token, con il listino più basso il costo sarebbe stato $0.0324.
Come si mantiene un agente sotto soglia?
Bisogna evitare che i vecchi risultati dei tool si accumulino nella conversazione principale. Abbiamo eseguito lo stesso task in quattro modi su Claude Haiku 5.5, con cinque esecuzioni per ciascun metodo e la cache vuota all’inizio di ognuna:
| Metodo | Totale corretto | Costo per esecuzione (mediana) | Richieste | Prompt più lungo |
|---|---|---|---|---|
| Conservare tutto | 5 su 5 | $0.0823 | 22 | 142,119 |
| Compattare a 80,000 token | 5 su 5 | $0.0261 | 23 | 92,829 |
| Tagliare i vecchi risultati dei tool | 3 su 5 | $0.0228 | 22 | 10,278 |
| Un sub-agent legge ogni file | 5 su 5 | $0.0156 | 42 | 7,100 |
- Compattazione. Quando il prompt supera 80,000 token, una richiesta aggiuntiva chiede al modello un riepilogo dello stato; la conversazione riparte da lì. La soglia scelta deve lasciare margine: anche il successivo risultato del tool deve rientrare nei 100,000 token.
- Taglio dei risultati. Prima di ogni richiesta, tutti i risultati dei tool tranne il più recente vengono sostituiti da una riga segnaposto. In due esecuzioni su cinque, il totale restituito era sbagliato per un errore di calcolo nel totale parziale mantenuto dal modello nelle risposte. Cinque esecuzioni non bastano a dimostrare che questo metodo sia meno affidabile (3 su 5 contro 5 su 5 non è una differenza significativa), ma mostrano il rischio: una volta eliminata la fonte, non si può correggere un errore.
- Sub-agent. Il tool dell’agente principale passa ogni file a una richiesta separata, che restituisce una riga. È stato il metodo più economico, ma ha fatto più richieste e ha impiegato circa un quarto di tempo in più. La richiesta separata vede solo ciò che riceve: le istruzioni devono quindi specificare cosa cercare con la stessa precisione di quelle dell’agente principale.
In tutti e quattro i casi, il thinking era disabilitato. Il thinking è il ragionamento interno del modello prima della risposta ed è attivo per impostazione predefinita. Secondo la guida alla migrazione di Anthropic, una richiesta che reinvia blocchi di thinking dopo la modifica di un messaggio precedente restituisce un errore 400. Per gli account creati prima del 31 agosto 2026, succede solo se aderiscono al controllo. Per tagliare i risultati bisogna quindi disattivare il thinking oppure escludere i relativi blocchi. Compattazione e sub-agent avviano una nuova conversazione ed evitano il problema.
Costa meno di GPT-6 Luna a parità di listino?
No, nelle nostre esecuzioni: a parità di accuratezza è costato circa il doppio. GPT-6 Luna ha gli stessi prezzi di listino, $0.10 e $0.50, senza variazioni legate alla lunghezza del prompt.
Nei benchmark pubblicati da Anthropic, Claude Haiku 5.5 supera GPT-6 Luna nei task agentici e distacca nettamente Claude Haiku 4.5:
| Benchmark (annuncio Anthropic) | Cosa misura | Haiku 5.5 | GPT-6 Luna | Haiku 4.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | attività di knowledge work, punteggio Elo | 1620 | 1437 | 735 |
| OSWorld 2.1, sottoinsieme offline | uso di un computer | 72.4% | 48.9% | 15.7% |
| Terminal-Bench 4.0 | task di programmazione nel terminale | 39.2% | 16.4% | 0.0% |
Abbiamo provato i tre modelli con le impostazioni predefinite, e Haiku 5.5 anche con thinking disabilitato, su due insiemi più piccoli con risposte verificabili: 96 task di classificazione, estrazione e instradamento ai tool, attività per cui Anthropic indica questo modello, e 14 task a più passaggi ripetuti tre volte ciascuno.
| Modello | Task brevi corretti, su 96 | Costo per 1,000 chiamate | Task a più passaggi corretti, su 42 | Costo per risposta corretta |
|---|---|---|---|---|
| Claude Haiku 5.5 | 95 | $0.107 | 39 | $0.00103 |
| Claude Haiku 5.5, thinking disabilitato | 94 | $0.069 | 33 | $0.00036 |
| GPT-6 Luna | 95 | $0.049 | 38 | $0.00043 |
| Claude Haiku 4.5, senza extended thinking | 94 | $0.679 | 10 | $0.01053 |
Il costo per risposta corretta è la spesa totale divisa per il numero di risposte esatte. Haiku 5.5 e GPT-6 Luna hanno un’accuratezza equivalente in entrambi gli insiemi (39 e 38 su 42 sono lo stesso risultato), ma Haiku 5.5 costa poco più del doppio. Nei task brevi ha contato 482 token di input contro i 231 di GPT-6 Luna; nei task a più passaggi ha prodotto 1,902 token di output per chiamata contro 759. Rispetto a Haiku 4.5, eseguito con l’impostazione predefinita senza extended thinking, costa l’84% in meno sui task brevi e risolve circa quattro volte più task a più passaggi.
Il thinking usa medium effort per impostazione predefinita. L’effort regola quanto il modello ragiona, da low a max; thinking: {"type": "disabled"} lo disattiva. Con il thinking disabilitato, il punteggio sui task brevi è rimasto lo stesso a due terzi del costo. Nei task a più passaggi, però, il modello ha sbagliato 6 risposte in più su 42 e ha inserito i passaggi del proprio ragionamento in ogni risposta che richiedeva un solo numero. Con effort max, ha ottenuto lo stesso punteggio predefinito di 39, al doppio del costo.
In pratica, è il modello economico della linea Claude e un netto passo avanti rispetto a Haiku 4.5 a un decimo del prezzo per token. Nelle nostre esecuzioni, GPT-6 Luna ha svolto gli stessi task brevi ad alto volume a metà costo. Il punto forte di Haiku 5.5 sono i task agentici: nei benchmark Anthropic è nettamente avanti, anche se noi non abbiamo confrontato i due modelli su quel tipo di lavoro. Il prompt, però, deve restare sotto 100,000 token. Prima di migrare un workload da Haiku 4.5, riconta i token dei prompt sul nuovo modello ed elimina ciò che, secondo la guida alla migrazione, Haiku 5.5 rifiuta con un errore 400: un budget di thinking impostato manualmente, valori non predefiniti di temperature, top_p o top_k, e un turno dell’assistente già iniziato.
Domande frequenti
Quanto costa Claude Haiku 5.5?
Per prompt fino a 100,000 token, Claude Haiku 5.5 costa $0.10 per milione di token di input e $0.50 per milione di token di output. Oltre 100,000 token di prompt, i prezzi sono $0.50 e $2.50 e si applicano all’intera richiesta. Le letture dalla cache costano $0.01 e $0.05; la Batch API dimezza i prezzi di input e output in entrambi i listini.
I token in cache contano per la soglia di 100,000 token di Claude Haiku 5.5?
Sì. Un prompt da 102,011 token inviato a Claude Haiku 5.5, di cui 96,045 letti dalla cache, è stato fatturato ai prezzi più alti: $0.0078 contro $0.0016 ai prezzi più bassi. La lunghezza del prompt è la somma di input non in cache, letture dalla cache e scritture nella cache. Il listino Anthropic non lo specifica, ma dieci richieste di questo tipo inviate direttamente alla sua API sono state addebitate ai prezzi più alti sulla nostra fattura Anthropic. I token di output non contano.
Claude Haiku 5.5 costa meno di Claude Haiku 4.5?
Sì, sia sotto sia sopra soglia, ma meno di quanto suggeriscano i listini: lo stesso testo produce più token sul nuovo modello. Per la prosa inglese abbiamo misurato 1.48 volte i token. Di conseguenza, Claude Haiku 5.5 costa circa l’85% in meno di Claude Haiku 4.5 sotto 100,000 token e circa il 26% in meno sopra.
Claude Haiku 5.5 costa meno di GPT-6 Luna?
Non nelle nostre esecuzioni, anche se i prezzi di listino sono uguali. Su 96 task brevi, Claude Haiku 5.5 con le impostazioni predefinite è costato $0.107 per 1,000 chiamate e GPT-6 Luna $0.049, con la stessa accuratezza. Sugli stessi task, Haiku 5.5 ha contato circa il doppio dei token di input e ha prodotto più output.
Come mantengo le richieste a Claude Haiku 5.5 sotto 100,000 token?
Conta i token prima dell’invio e, nei cicli agentici, evita di accumulare i vecchi risultati dei tool. Riassumi la conversazione in una nota prima della soglia, oppure usa una richiesta separata per leggere ogni input di grandi dimensioni e restituire solo il risultato. Nel nostro test con Claude Haiku 5.5, questi metodi hanno ridotto il costo di un task da $0.082 a $0.026 e $0.016, con la risposta corretta in ogni esecuzione.
Altri articoli
- Fasce di prezzo per i contesti lunghi: gli altri modelli il cui prezzo varia con la lunghezza del prompt.
- Claude Sonnet 5.5 e Sonnet 5 a confronto: effort e costo per task nella fascia superiore.
- GPT-6 Luna: quanto costa regolare il ragionamento: il modello con lo stesso prezzo di listino.
- Il tokenizer di Claude Sonnet 5: il tokenizer ora usato anche da Haiku 5.5.