
Prix des API LLM 2026 : tokens en hausse, capacités 50x moins chères
Sommaire
- Comment les prix catalogue des API LLM ont-ils évolué en un an ?
- Comment Anthropic, OpenAI, Google et DeepSeek ont-ils fixé leurs prix sur deux ans ?
- Les modèles sont-ils devenus plus chers ou simplement plus performants ?
- Comment les prix ont-ils évolué par catégorie ?
- Comment les stratégies tarifaires différaient-elles d’un laboratoire à l’autre ?
- Comment la stratégie tarifaire de DeepSeek se compare-t-elle à celle des autres fournisseurs ?
- Comment les quatre laboratoires se comparent-ils ?
- Comment les prix ont-ils évolué par catégorie ?
- Combien coûte aujourd’hui un niveau de capacité donné ?
- Pourquoi les prix ont-ils évolué ainsi ?
- Pourquoi le prix par token ne donne-t-il pas le coût par tâche ?
- Comment les prix du cache ont-ils évolué par rapport à l’entrée ?
- Que faire de ces résultats ?
- FAQ
- À lire aussi
Entre octobre 2025 et octobre 2026, le prix catalogue par token des API LLM a augmenté dans 10 gammes sur 14. Pourtant, à niveau de capacité donné, le modèle le moins cher coûte beaucoup moins par token : de 17 à 50 fois moins pour les scores de 20 à 40, et 2.5 fois moins pour un score de 50. Une gamme correspond à une ligne de produits d’un fournisseur, comme Claude Opus ou Gemini Flash. La capacité est mesurée par le score du modèle sur l’indice d’intelligence d’Artificial Analysis, un indicateur composite indépendant noté de 0 à 100 (le meilleur modèle atteint aujourd’hui 57.6). Les prix sont des prix pondérés, en dollars par million de tokens, avec trois tokens d’entrée pour un token de sortie. Ces deux tendances coexistent parce que chaque nouveau modèle d’une gamme est plus performant que son prédécesseur.
TL;DR
- D’octobre 2025 à octobre 2026, le prix catalogue en entrée a augmenté dans 10 gammes sur 14 ; les 3 qui ont baissé sont toutes chez Anthropic.
- Le modèle le moins cher atteignant 40 sur l’indice Artificial Analysis est passé de $10 à $0.20 par million de tokens pondérés entre avril et octobre 2026.
- Depuis octobre 2024, Anthropic a baissé les prix de ses trois gammes (Opus est passé de $15 / $75 à $4 / $20), Google a augmenté ceux de ses trois gammes et OpenAI n’a augmenté que ceux de sa gamme intermédiaire.
- L’écart de prix en entrée entre les modèles phares fermés s’est resserré de 12x à 2x ; le prix médian des modèles phares à poids ouverts a doublé.
Comment les prix catalogue des API LLM ont-ils évolué en un an ?
Dans la plupart des gammes, le token coûte plus cher qu’il y a un an. Nous avons comparé le modèle représentant chaque gamme au 15 octobre 2025 à celui qui la représentait au 15 octobre 2026 :
| Gamme | Modèle en oct. 2025, $ par million de tokens (entrée / sortie) | Modèle en oct. 2026, $ par million de tokens (entrée / sortie) | Prix en entrée, 2026 par rapport à 2025 |
|---|---|---|---|
| OpenAI phare | GPT-5, $1.25 / $10 | GPT-6.1 Sol, $2 / $10 | 1.6x |
| OpenAI intermédiaire | GPT-5 mini, $0.25 / $2 | GPT-5.6 Terra, $2 / $12 | 8x |
| OpenAI petit modèle | GPT-5 nano, $0.05 / $0.40 | GPT-6 Luna, $0.10 / $0.50 | 2x |
| Claude Opus | Opus 4.1, $15 / $75 | Opus 5.5, $4 / $20 | 0.27x |
| Claude Sonnet | Sonnet 4.5, $3 / $15 | Sonnet 5.5, $2 / $10 | 0.67x |
| Claude Haiku | Haiku 4.5, $1 / $5 | Haiku 5.5, $0.10 / $0.50 | 0.1x |
| Gemini Pro | Gemini 2.5 Pro, $1.25 / $10 | Gemini 4 Argon, $2 / $10 | 1.6x |
| Gemini Flash | Gemini 2.5 Flash, $0.30 / $2.50 | Gemini 3.8 Flash, $0.75 / $3.75 | 2.5x |
| Gemini Flash-Lite | Gemini 2.5 Flash-Lite, $0.10 / $0.40 | Gemini 3.5 Flash-Lite, $0.30 / $2.50 | 3x |
| DeepSeek économique | V3.2-Exp, $0.28 / $0.42 | V4.1 Flash, $0.30 / $1.20 en heures de pointe | 1.07x |
| Zhipu GLM phare | GLM-4.6, $0.60 / $2.20 | GLM-5.3, $1.40 / $4.40 | 2.3x |
| Moonshot Kimi phare | Kimi K2, $0.60 / $2.50 | Kimi K3, $3 / $15 | 5x |
| Alibaba Qwen Max | Qwen3-Max, $1.20 / $6 | Qwen3.8 Max, $2 / $6 | 1.67x |
| MiniMax | M2 (à partir du 23 octobre), $0.30 / $1.20 | M3, $0.30 / $1.20 | 1x |
Certains tarifs sont soumis à conditions : les prix de lancement d’Argon et de Gemini 3.8 Flash doublent respectivement le 1 décembre et le 1 janvier, Haiku 5.5 coûte $0.50 / $2.50 au-delà de 100,000 tokens de prompt, et la ligne DeepSeek retient le tarif de pointe, appliqué pendant les heures de bureau à Pékin (le tarif en heures creuses est deux fois moins élevé, sous le prix pondéré de V3.2-Exp). Le décompte de 10 gammes sur 14 reste le même avec les prix pondérés plutôt que les prix en entrée. Les prix de Kimi K2 et Qwen3-Max proviennent d’archives tierces.
Comment Anthropic, OpenAI, Google et DeepSeek ont-ils fixé leurs prix sur deux ans ?
Sur deux ans, Anthropic a baissé ses prix catalogue dans ses trois gammes. Chez OpenAI, le modèle phare et le petit modèle terminent à des niveaux proches de ceux du départ, tandis que le prix de la gamme intermédiaire a été multiplié par 17x. Google a augmenté les prix de toutes ses gammes. Chez DeepSeek, le prix du modèle économique a été multiplié par environ 3x aux heures de pointe, tandis que son prix de lecture du cache est tombé à 2% du prix en entrée. Le graphique et les tableaux ci-dessous remontent jusqu’à octobre 2024 pour les trois principaux laboratoires de modèles fermés. Ils suivent, à chaque date, le modèle phare, le modèle intermédiaire et le petit modèle de chacun. DeepSeek commercialise un ou deux modèles plutôt que trois gammes : une sous-section lui est donc consacrée, puis un dernier tableau compare les quatre laboratoires.
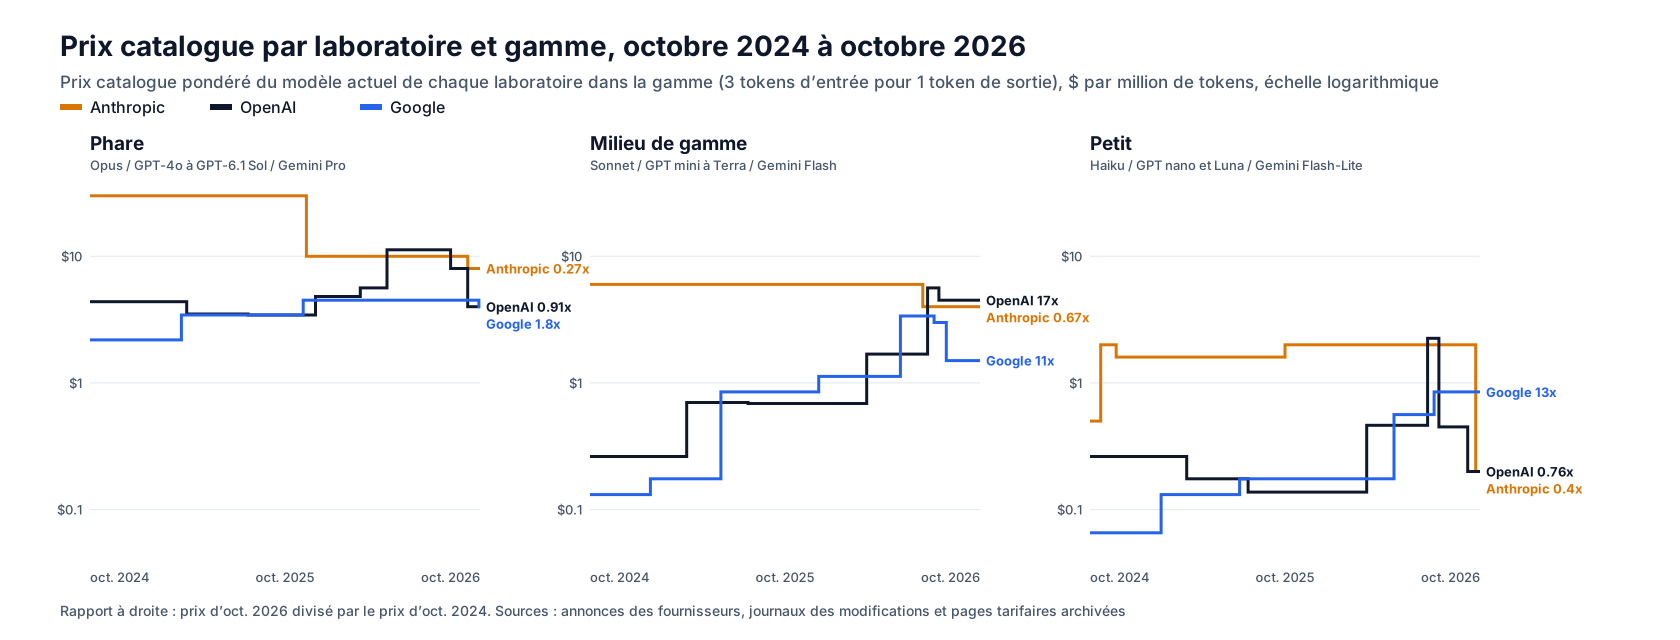
| Catégorie | Anthropic | OpenAI | |
|---|---|---|---|
| Phare | De Claude 3 Opus à $15 / $75 à Opus 5.5 à $4 / $20 : 0.27x | De GPT-4o à $2.50 / $10 à GPT-6.1 Sol à $2 / $10 : 0.91x | De Gemini 1.5 Pro à $1.25 / $5 à Gemini 4 Argon à $2 / $10 : 1.8x |
| Intermédiaire | De Claude 3.5 Sonnet à $3 / $15 à Sonnet 5.5 à $2 / $10 : 0.67x | De GPT-4o mini à $0.15 / $0.60 à GPT-5.6 Terra à $2 / $12 : 17x | De Gemini 1.5 Flash à $0.075 / $0.30 à Gemini 3.8 Flash à $0.75 / $3.75 : 11x |
| Petit modèle | De Claude 3 Haiku à $0.25 / $1.25 à Haiku 5.5 à $0.10 / $0.50 : 0.4x | De GPT-4o mini à GPT-6 Luna à $0.10 / $0.50 : 0.76x | De Gemini 1.5 Flash-8B à $0.0375 / $0.15 à Gemini 3.5 Flash-Lite à $0.30 / $2.50 : 13x |
Les prix sont ceux du 15 octobre de chaque année, et le ratio compare les prix pondérés. GPT-4o mini sert de point de départ aux deux lignes inférieures d’OpenAI, car OpenAI n’avait pas de petit modèle distinct avant GPT-4.1 nano en avril 2025.
Les modèles sont-ils devenus plus chers ou simplement plus performants ?
Les modèles sont surtout devenus plus performants. D’octobre 2025 à octobre 2026, le score sur l’indice du modèle courant de chaque gamme a été multiplié par 1.9 à 3.3. Le prix par point d’indice (prix pondéré divisé par le score sur l’indice ; un rapport inférieur à 1x signifie qu’un même niveau de capacité coûte moins cher) a baissé dans sept des neuf gammes. L’indice ne fournit des scores pour les anciens modèles qu’à partir de mi-2025 ; cette comparaison porte donc sur la deuxième année :
| Laboratoire et gamme | Indice, oct. 2025 à oct. 2026 | Prix pondéré | Prix par point d’indice |
|---|---|---|---|
| Anthropic phare | 22.8 à 57.6 | $30.00 à $8.00 | 0.11x |
| Anthropic intermédiaire | 19.3 à 35.9 (réglage par défaut) | $6.00 à $4.00 | 0.36x |
| Anthropic petit modèle | 16.9 à 43.4 | $2.00 à $0.20 | 0.04x |
| OpenAI phare | 23.0 à 51.8 | $3.44 à $4.00 | 0.52x |
| OpenAI intermédiaire | 16.8 à 42.1 | $0.69 à $4.50 | 2.6x |
| OpenAI petit modèle | 13.0 à 38.1 | $0.14 à $0.20 | 0.50x |
| Google phare | 16.1 à 52.6 | $3.44 à $4.00 | 0.36x |
| Google intermédiaire | 13.1 à 40.9 | $0.85 à $1.50 | 0.57x |
| Google petit modèle | 8.5 à 22.2 | $0.18 à $0.85 | 1.9x |
Les modèles sont ceux du premier tableau. Les scores correspondent au réglage de raisonnement le plus élevé de chaque modèle (l’option de la requête qui lui permet de réfléchir plus longtemps avant de répondre) ; ceux de Sonnet correspondent au réglage par défaut, le seul évalué pour les anciens Sonnet, et les scores d’octobre 2025 des anciens modèles sont des estimations d’Artificial Analysis. Le prix par point n’a augmenté que lorsqu’un laboratoire a relevé le prix d’un modèle plus vite que ses capacités ne progressaient.
Comment les prix ont-ils évolué par catégorie ?
Les prix des modèles phares se sont rapprochés, ceux des modèles intermédiaires ont augmenté, et la catégorie des petits modèles s’est divisée. En octobre 2024, le prix en entrée le plus élevé parmi les modèles phares était 12 fois supérieur au plus bas (Claude 3 Opus à $15, Gemini 1.5 Pro à $1.25). Cet écart était encore de 12 fois en octobre 2025. Il est aujourd’hui de 2 fois ; entre-temps, le modèle phare d’OpenAI est monté à $5 / $30 avec GPT-5.5 en avril 2026, avant de redescendre à $2 / $10. Les modèles intermédiaires obtiennent désormais de meilleurs scores que les modèles phares d’un an plus tôt, et OpenAI et Google ont fixé leurs prix en conséquence. L’écart en entrée dans cette catégorie est ainsi passé de 40x à 2.7x, la baisse de Sonnet contribuant à le réduire davantage. Dans la catégorie des petits modèles, OpenAI et Anthropic se sont tous deux établis à $0.10 / $0.50, tandis que Gemini 3.5 Flash-Lite de Google coûte autant que Gemini 2.5 Flash à la mi-2025.
Comment les stratégies tarifaires différaient-elles d’un laboratoire à l’autre ?
Anthropic a maintenu ses prix sur de longues périodes, puis les a baissés par paliers. OpenAI a souvent revu ses tarifs, en justifiant chaque changement par les capacités ou l’efficacité des modèles. Google a augmenté ses prix à chaque génération et annoncé les hausses à l’avance. Aucun des trois n’a invoqué un concurrent pour expliquer un changement de prix, même lors du lancement d’Opus 5.5, de GPT-6 Sol et de GPT-6 Luna le même jour.
Anthropic : prix stables, puis baisses par paliers. Sonnet est resté à $3 / $15 de mars 2024 jusqu’à Sonnet 4.6 en 2026, et Opus à $15 / $75 jusqu’à ce qu’Opus 4.5 ramène son prix à $5 / $25 en novembre 2025, « rendant les capacités d’Opus accessibles à davantage d’utilisateurs » (Anthropic). Les baisses suivantes ont accompagné de nouveaux modèles : Opus 5.5 « nécessite moins de ressources de calcul pour l’inférence qu’Opus 5, ce que reflète son prix » (Anthropic), et le tarif de lancement de Sonnet 5, à $2 / $10, est devenu son tarif standard en août. Les hausses ont concerné la gamme Haiku : Claude 3.5 Haiku a été lancé à $1 / $5 en novembre 2024 « pour refléter ses capacités accrues », puis ramené à $0.80 / $4 un mois plus tard (TechCrunch), avant qu’Haiku 4.5 ne repasse à $1 / $5 en octobre 2025.
OpenAI : des révisions fréquentes des prix, justifiées par les capacités ou l’efficacité. Les hausses s’accompagnaient d’arguments sur les capacités : GPT-5.2 était « plus cher par token que GPT‑5.1 parce qu’il est plus performant » (OpenAI). Les baisses étaient justifiées par une réduction des coûts d’inférence : le prix d’o3 a baissé de 80% en juin 2025 parce que « nous avons optimisé notre infrastructure d’inférence pour o3 » (OpenAIDevs), et GPT-6 Sol et Luna ont été lancés à la moitié du prix en entrée de leurs prédécesseurs parce que « les améliorations du cache et de l’inférence nous permettent d’exécuter ces modèles à moindre coût » (OpenAI). Les tarifs de lancement ont été de courte durée : les trois modèles GPT-5.6, lancés en juillet, ont tous vu leur prix baisser en moins de six semaines. Reuters reliait la baisse d’août sur GPT-5.6 Sol à « la concurrence croissante d’Anthropic et des modèles d’IA chinois » ; OpenAI invoquait des gains d’efficacité.
Google : des prix en hausse, avec des augmentations déjà prévues. Google était au départ le laboratoire le moins cher dans chaque catégorie, puis a augmenté ses prix à presque chaque génération, généralement sans donner de raison. L’exception était Gemini 2.5 Flash, dont le prix en entrée a doublé en juin 2025, un « ajustement spécifique reflétant la valeur exceptionnelle de Flash » (Google). Depuis août, Google lance ses modèles à des tarifs de lancement dont la hausse est déjà programmée : Gemini 3.7 Flash et 3.8 Flash à $0.75 / $3.75 jusqu’au 31 décembre, puis $1.50 / $7.50, et Argon à $2 / $10 jusqu’au 30 novembre, puis $4 / $20. Google n’a donné aucune raison, mais Sundar Pichai a déclaré aux investisseurs en juillet que « nos capacités restent insuffisantes pour répondre à la demande » (Alphabet).
Comment la stratégie tarifaire de DeepSeek se compare-t-elle à celle des autres fournisseurs ?
DeepSeek a baissé ses prix lorsqu’une nouvelle architecture a réduit son coût d’inférence, puis les a relevés lorsque la demande a dépassé la capacité de ses GPU. L’efficacité fixait donc le prix plancher, et la capacité de calcul disponible déterminait le tarif à chaque instant. Le cache joue un rôle central dans ce mécanisme : lorsqu’un prompt commence par un texte que le fournisseur a déjà traité, celui-ci peut réutiliser l’état intermédiaire stocké (le cache KV) au lieu de le recalculer. Ces tokens d’entrée sont alors facturés comme une lecture du cache, à un tarif réduit.
| Date | Changement | Lecture du cache / entrée hors cache / sortie, $ par million de tokens |
|---|---|---|
| Août 2024 | Lancement du cache de prompt sur disque (DeepSeek V2, puis V2.5) | $0.014 / $0.14 / $0.28 |
| Février 2025 | V3 passe au plein tarif après une promotion de lancement ; remise nocturne de 50% sur V3 et de 75% sur R1, son modèle de raisonnement, à partir du 26 février | $0.07 / $0.27 / $1.10 |
| 5 septembre 2025 | Tarif unique pour les modes avec et sans raisonnement de V3.1 ; fin de la remise nocturne | $0.07 / $0.56 / $1.68 |
| 29 septembre 2025 | V3.2-Exp, prix réduits de plus de moitié | $0.028 / $0.28 / $0.42 |
| Avril 2026 | Lancement de V4 Flash ; deux jours plus tard, le prix de lecture du cache est divisé par dix | $0.0028 / $0.14 / $0.28 |
| 17 août 2026 | Introduction d’un tarif de pointe ; le tarif en heures creuses est deux fois moins élevé | $0.014 / $0.44 / $1.32 en heures de pointe |
| 10 septembre 2026 | V4.1 Flash remplace V4 Flash | $0.006 / $0.30 / $1.20 en heures de pointe |
Les prix sont ceux du modèle DeepSeek le moins cher à chaque date. Les heures de pointe vont de 09:00 à 12:00 et de 14:00 à 18:00, heure de Pékin, les jours ouvrés.
Efficacité. DeepSeek relie trois baisses de prix à des travaux sur l’architecture. En 2024, la mise en cache sur disque reposait sur MLA, son mécanisme d’attention compressée, qui réduisait suffisamment le cache KV pour le stocker sur des disques peu coûteux (DeepSeek). La baisse de septembre 2025 a accompagné l’arrivée de DeepSeek Sparse Attention, qui ne prend en compte qu’un sous-ensemble des tokens précédents. L’annonce en chinois l’attribue à la forte baisse du coût d’inférence du nouveau modèle (DeepSeek). Le cache KV de V4.1 Flash nécessite « 1/4 de la HBM » (mémoire GPU) et « 1/8 du stockage SSD » de son prédécesseur. DeepSeek soulignait aussi que « les lectures du cache représentent souvent une part importante du coût des agents » (DeepSeek). Une lecture du cache coûte désormais 2% du prix en entrée, contre 10% en 2024 et 2.5% à 10% chez les laboratoires américains aujourd’hui. La seule journée de données d’inférence publiée par DeepSeek, en mars 2025, fait état de 56.3% des tokens d’entrée servis depuis le cache sur disque et d’une marge théorique de 545% à $2 par heure-GPU, avec des revenus réels « nettement inférieurs » (DeepSeek).
Capacité. Selon cette même vue d’ensemble, DeepSeek réaffecte la nuit des nœuds d’inférence à la recherche et à l’entraînement. Ces heures de faible charge étaient celles que visait sa remise nocturne de 2025. Les hausses sont intervenues lorsque la capacité manquait : en septembre 2025, la fusion des modes de V3.1 a supprimé cette remise et doublé le prix en entrée hors cache du modèle sans raisonnement, de $0.27 à $0.56, sans explication (DeepSeek). En août 2026, la tarification de pointe a triplé le prix en entrée de V4 Flash aux heures chargées pour « répartir les ressources plus raisonnablement » (notre traduction de l’annonce en chinois, DeepSeek). Même en heures creuses, V4.1 Flash coûte plus cher que V4 Flash avant août. Mais par point de l’indice, son coût représente 0.70x celui de V3.2-Exp un an plus tôt en heures de pointe, et 0.35x en heures creuses (score de 39.5 contre une estimation de 16.6).
Comment les quatre laboratoires se comparent-ils ?
| Anthropic | OpenAI | DeepSeek | ||
|---|---|---|---|---|
| Évolution sur deux ans | Baisse dans les trois gammes | Légère baisse pour le modèle phare et le petit modèle (0.91x, 0.76x), hausse de 17x dans la gamme intermédiaire | Hausse dans les trois gammes | Prix du modèle économique multiplié par 3x en heures de pointe, par 1.5x en heures creuses |
| Fréquence des changements de prix | Rarement : même prix sur plusieurs versions, puis changement par palier | Souvent : nouveaux prix à la plupart des sorties, baisses quelques semaines après | À chaque génération, avec aussi des hausses programmées | Souvent : nouveaux prix à la plupart des sorties, avec aussi des promotions et des tarifs selon l’heure |
| Prix de lancement | Un tarif de lancement (Sonnet 5), devenu permanent | Baisse peu après le lancement (famille GPT-5.6) | Tarifs de lancement avec hausse annoncée | Promotions de lancement (V3, V4 Pro) ; celle de V4 Pro est devenue permanente |
| Motif annoncé des hausses | Intelligence (Claude 3.5 Haiku) | Capacités (GPT-5.2) | Valeur apportée, une fois (2.5 Flash) ; généralement aucun motif | Allocation des ressources (tarifs de pointe) |
| Motif annoncé des baisses | Accessibilité, puis baisse du coût d’inférence | Gains d’efficacité de l’inférence et du cache | Aucun motif annoncé ; des tarifs de lancement plutôt que des baisses | Baisse du coût d’inférence grâce à une nouvelle architecture |
| Modèle économique, oct. 2026 | $0.10 / $0.50 | $0.10 / $0.50 | $0.30 / $2.50 | $0.30 / $1.20 en heures de pointe, moitié moins en heures creuses |
Les prix ont suivi le positionnement choisi par chaque laboratoire, et non un tarif fixe par catégorie : un modèle atteignant les scores d’un modèle phare était facturé à un prix proche de celui-ci, et un laboratoire capable de réduire le coût d’inférence d’un modèle en baissait le prix.
Comment les prix ont-ils évolué par catégorie ?
Les prix des modèles phares fermés se sont rapprochés, ceux des modèles phares à poids ouverts ont augmenté, et la catégorie économique termine en baisse après un pic en milieu d’année. Les modèles actuels de chaque laboratoire se répartissent en quatre catégories :
- SOTA haut de gamme : SOTA (state of the art, ou état de l’art) désigne ici les principaux laboratoires de modèles fermés. Cette catégorie regroupe le modèle le plus cher de chacun. C’est une catégorie de prix : Opus 5.5, classé parmi les modèles phares, obtient un meilleur score que les trois modèles haut de gamme. Quand le modèle le plus cher d’un laboratoire est aussi son modèle phare, il figure dans les deux catégories (c’est aujourd’hui le cas de Gemini 4 Argon).
- SOTA phare : le principal modèle généraliste de chaque laboratoire de modèles fermés.
- Phare à poids ouverts : le modèle principal de cinq laboratoires dont chacun peut télécharger et héberger les poids.
- Économique / Flash : la gamme à bas coût de chaque laboratoire, ainsi nommée en référence aux modèles Flash de Google.
Le graphique représente, sur une échelle logarithmique, le prix pondéré médian de chaque catégorie par une courbe et la fourchette entre le moins cher et le plus cher par une bande. Les écarts du tableau portent uniquement sur les prix en entrée.
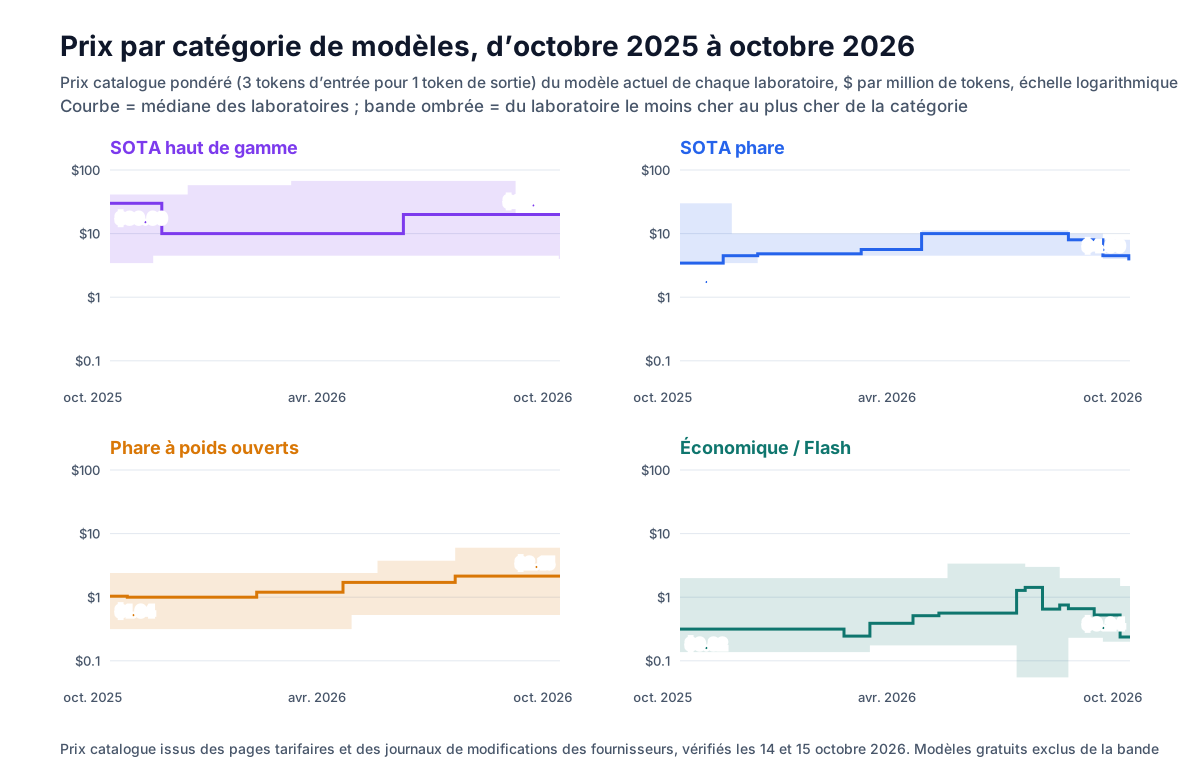
| Catégorie | Modèles au 15 oct. 2026 | Prix pondéré médian, oct. 2025 | Prix pondéré médian, oct. 2026 | Écart en entrée (maximum ÷ minimum), oct. 2025 | Écart en entrée, oct. 2026 |
|---|---|---|---|---|---|
| SOTA haut de gamme | Claude Fable 5.1, GPT-6 Astra, Gemini 4 Argon | $30.00 | $20.00 | 12x | 5x |
| SOTA phare | Claude Opus 5.5, GPT-6.1 Sol, Gemini 4 Argon | $3.44 | $4.00 | 12x | 2x |
| Phare à poids ouverts | GLM-5.3, Kimi K3, Qwen3.8 Max, DeepSeek V4 Pro, MiniMax M3 | $1.04 | $2.15 | 4.3x | 10x |
| Économique / Flash | Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite, DeepSeek V4.1 Flash, GLM-5.3 Flash, Qwen3.8 Flash | $0.32 | $0.24 | 20x | 7.5x |
- SOTA haut de gamme : chez OpenAI, les modèles pro sont passés de GPT-5 Pro à $15 / $120 à GPT-5.4 Pro à $30 / $180, avant que GPT-6 Astra ne ramène la gamme à $10 / $50, au même prix que Claude Fable 5.1. Google facture pour l’instant Argon à $2 / $10, ce qui explique à lui seul l’écart actuel de 5x.
- Phare à poids ouverts : le prix médian en entrée a plus que doublé, de $0.60 à $1.40, et les prix se sont écartés : Kimi K3 à $3 / $15 coûte plus cher que Claude Sonnet 5.5, tandis que MiniMax M3 est resté à $0.30 / $1.20 sur cinq versions. Le prix médian en sortie des modèles à poids ouverts est passé de 24% à 44% de la médiane des modèles phares fermés. DeepSeek V4 Pro est comptabilisé au tarif de pointe.
- Économique / Flash : la médiane est montée à $0.56 de mai à juillet, avec le lancement de modèles économiques comme Gemini 3.1 Flash-Lite et Qwen3.6 Flash à $0.25 / $1.50. Elle a surtout baissé en octobre, quand Haiku 5.5 s’est aligné sur les $0.10 / $0.50 de GPT-6 Luna.
GPT-5.6 Terra est exclu de la catégorie économique parce qu’il coûte autant qu’un modèle phare. Les données couvrent huit laboratoires ; elles n’incluent ni xAI ni Mistral.
Combien coûte aujourd’hui un niveau de capacité donné ?
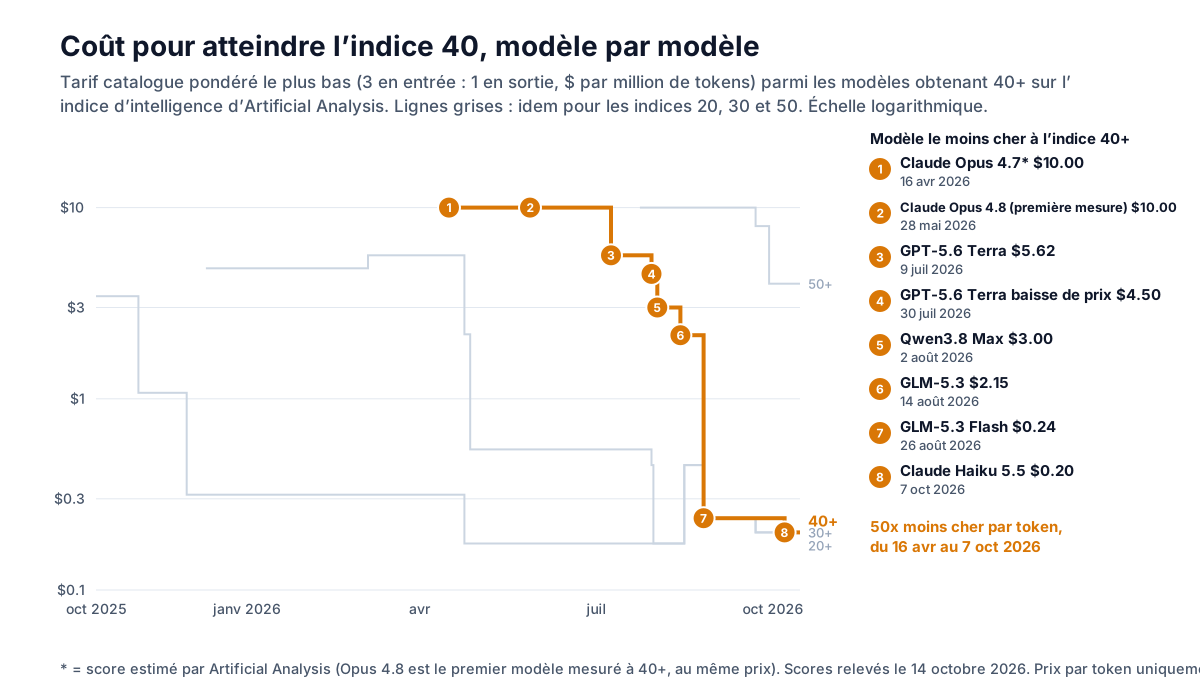
À chaque niveau de l’indice, le modèle le moins cher coûte de 2.5 à 50 fois moins par token, et de 8 à 19 fois moins par tâche lorsque les données par tâche sont disponibles aux deux extrémités de la période. Le coût par tâche correspond ici au montant calculé par Artificial Analysis pour exécuter une tâche de son indice au tarif catalogue, selon la consommation réelle de tokens de chaque modèle. Pour chaque jour, nous avons retenu le modèle courant le moins cher atteignant au moins 20, 30, 40 ou 50 sur la version 4.3.2 de l’indice, avec son réglage de raisonnement le plus élevé.
| Niveau de l’indice | Modèle le moins cher au premier franchissement entre oct. 2025 et oct. 2026, $ pondérés par million de tokens | Le moins cher aujourd’hui | Réduction du coût par token | Réduction du coût par tâche |
|---|---|---|---|---|
| 20 | Début de période, oct. 2025 : GPT-5*, $3.44 | Claude Haiku 5.5 ou GPT-6 Luna, $0.20 | 17x | non publié pour GPT-5 |
| 30 | Déc. 2025 : GPT-5.2*, $4.81 | Claude Haiku 5.5 ou GPT-6 Luna, $0.20 | 24x | non publié pour GPT-5.2 |
| 40 | Avr. 2026 : Claude Opus 4.7*, $10 | Claude Haiku 5.5, $0.20 | 50x | 19x, de $4.08 pour Opus 4.8 (premier avec des données par tâche) à $0.21 pour Haiku 5.5 |
| 50 | Juil. 2026 : Claude Opus 5, $10 | GPT-6.1 Sol ou Gemini 4 Argon, $4 | 2.5x | 8.1x, de $5.86 pour Opus 5 à $0.72 pour GPT-6.1 Sol |
* Score estimé par Artificial Analysis, et non mesuré. Le premier modèle mesuré au niveau 40, Opus 4.8 en mai, affichait lui aussi $10.
La baisse du prix plancher n’a pas été régulière : le niveau 20 coûtait $0.175 sur DeepSeek V4 Flash de fin avril à mi-août, soit moins que les $0.20 actuels.
Les modèles aux meilleurs scores ne sont pas devenus bon marché. Il y a un an, les deux premiers étaient GPT-5 et Opus 4.1, avec des scores estimés de 23.0 et 22.8, pour des prix pondérés de $3.44 et $30. Aujourd’hui, le meilleur modèle est Claude Opus 5.5, avec un score de 57.6 pour $8 pondérés. Les fortes baisses concernent les niveaux que seul le meilleur modèle atteignait quelques mois plus tôt.
Pourquoi les prix ont-ils évolué ainsi ?
Au-delà des déclarations des laboratoires sur leurs propres prix, trois évolutions du marché ont accompagné ces mouvements, avec des effets qui vont dans des directions différentes. Elles se chevauchent dans le temps : les données ne permettent donc pas d’isoler leurs effets.
Demande et capacité d’inférence. Quand la demande dépasse la capacité des GPU disponibles pour répondre aux requêtes, un fournisseur peut plafonner l’utilisation ou facturer davantage aux heures chargées. OpenRouter, une place de marché qui achemine les requêtes API vers de nombreux hébergeurs de modèles, est passé d’environ 5 mille milliards de tokens par semaine en avril 2025 à plus de 20 mille milliards en avril 2026. La programmation est passée d’environ 11% de son trafic à plus de la moitié (Wing VC). Anthropic a levé les plafonds d’utilisation des abonnements Claude aux heures chargées après avoir obtenu l’accès au centre de données Colossus 1 de xAI le 6 mai. Sur la même période, les mouvements de prix des API comprennent GPT-5.5 à $5 / $30 en avril, les hausses prévues par Google, qui déclare manquer de capacité, et les tarifs de pointe de DeepSeek.
Concurrence et prix plancher. Les modèles chinois à poids ouverts sont passés d’environ 2% des tokens d’OpenRouter fin 2024 à environ 61% en mai 2026 (Wing VC). Le trafic des services directs comme ChatGPT reste toutefois bien supérieur à celui du routeur. En juin, le Wall Street Journal rapportait qu’OpenAI envisageait des baisses de prix en prévision de celles d’Anthropic (Decrypt), et les deux ont lancé des modèles moins chers le 22 septembre. Le prix plancher, le prix le plus bas à un niveau de capacité donné, était détenu par DeepSeek V4 Flash de fin avril jusqu’à la hausse de DeepSeek en août, puis est passé à Claude Haiku 5.5 et GPT-6 Luna.
Revenus des laboratoires à poids ouverts. Des poids ouverts permettent à n’importe quel hébergeur de commercialiser le même modèle. Après la sortie de GLM-5.3 Flash, la part de l’API de Zhipu dans le trafic OpenRouter de ce modèle est passée de 88% à 22% en trois semaines. Epoch AI, un groupe de recherche en IA, estime que DeepSeek perçoit environ 8% des dépenses effectuées sur OpenRouter pour ses modèles (Huxiu, cité par Weijin Research). Ces chiffres sont postérieurs à l’essentiel de la hausse des prix des modèles à poids ouverts : ils sont donc cohérents avec cette hausse, sans l’expliquer. Les hébergeurs ont peu cassé les prix des derniers modèles phares : au 16 octobre, le tarif du laboratoire était le plus courant pour GLM-5.3 (15 hébergeurs sur 44) et Kimi K3 (7 sur 25). Parmi les 15 hébergeurs moins chers pour Kimi K3, 12 utilisaient des poids quantifiés sur 4 bits, une version compressée dont les réponses peuvent différer de celles de l’original.
Pourquoi le prix par token ne donne-t-il pas le coût par tâche ?
Deux modèles au même tarif catalogue peuvent coûter plusieurs fois plus ou moins cher par tâche. La différence vient surtout des tokens de raisonnement : les étapes de réflexion internes que le modèle produit avant de répondre, facturées comme des tokens de sortie. Artificial Analysis publie le coût moyen de chaque modèle par tâche de l’indice au tarif catalogue.
| Comparaison | Prix catalogue, $ par million de tokens (entrée / sortie) | Coût moyen par tâche de l’indice |
|---|---|---|
| Claude Haiku 5.5 contre GPT-6 Luna | tous deux à $0.10 / $0.50 | $0.21 contre $0.07 |
| Gemini 4 Argon contre GPT-6.1 Sol | tous deux à $2 / $10 | $1.99 contre $0.72 |
| Qwen3.8 Max contre GPT-6.1 Sol | $2 / $6 contre $2 / $10 | $5.41 contre $0.72 |
Qwen3.8 Max a le prix en sortie le plus bas de sa paire, mais coûte 7.5 fois plus par tâche. Dans notre propre test, Argon coûtait 3.1 fois plus que GPT-6.1 Sol par réponse correcte (Coût de l’API Gemini 4 Argon). Pour comparer les modèles sur votre propre trafic, calculez le coût d’un lot de requêtes réelles à partir du nombre de tokens de chaque réponse (les tokens de raisonnement sont facturés comme des tokens de sortie). Divisez le total par le nombre de réponses acceptables, puis comparez les modèles sur ce coût par réponse.
Comment les prix du cache ont-ils évolué par rapport à l’entrée ?
Les lectures du cache (les accès au cache décrits dans la section DeepSeek) ont baissé par rapport au prix en entrée pour les modèles phares et haut de gamme des laboratoires de modèles fermés, tandis que les écritures du cache ont augmenté chez deux fournisseurs. Le tableau exprime le tarif de lecture du cache de chaque modèle en pourcentage de son propre prix en entrée.
| Catégorie | Lecture du cache ÷ entrée, oct. 2025 : médiane (fourchette) | Oct. 2026 : médiane (fourchette) | Minimum et maximum actuels |
|---|---|---|---|
| SOTA haut de gamme | 10% (tous les modèles) | 5% (2.5% à 10%) | Claude Fable 5.1 2.5%, GPT-6 Astra 10% |
| SOTA phare | 10% (tous les modèles) | 5% (tous les modèles) | Claude Opus 5.5, GPT-6.1 Sol et Gemini 4 Argon tous à 5% |
| Phare à poids ouverts | 18% (10% à 25%) | 12.5% (3.3% à 20%) | DeepSeek V4 Pro 3.3%, MiniMax M3 20% |
| Économique / Flash | 10% (tous les modèles) | 10% (2% à 20%) | DeepSeek V4.1 Flash 2%, GLM-5.3 Flash 20% |
Les modèles phares fermés ont divisé leur taux de lecture du cache par deux en trois semaines : Opus 5.5 le 22 septembre, GPT-6.1 Sol le 29 septembre et Argon le 13 octobre. Les laboratoires à poids ouverts appliquent un taux plus élevé, à l’exception de DeepSeek. Les 3.3% de V4 Pro s’expliquent toutefois par un prix en entrée plus élevé, et non par une lecture du cache moins chère. MiniMax est passé de 10% à 20% avec M2.7 en mars. Les modèles sans tarif de cache indiqué sont exclus.
Les tarifs d’écriture du cache, c’est-à-dire de la requête qui stocke un préfixe pour la première fois, ont changé chez deux fournisseurs. OpenAI les facture depuis GPT-5.6 en juillet : 1.25 fois le prix en entrée pour le cache par défaut de 30 minutes et, depuis le 20 octobre, 2.5 fois pour un cache de 12 heures. Kimi K3 facture toujours l’écriture par défaut pour 5 minutes au prix en entrée, comme Kimi K2, mais propose désormais un cache optionnel de 1 heure à 2 fois ce prix. Anthropic facture toujours 1.25 fois le prix en entrée pour un cache de 5 minutes et 2 fois pour un cache de 1 heure. Google, DeepSeek et Zhipu ne facturent toujours aucun supplément. Le guide sur l’écriture du cache explique dans quels cas une écriture est rentable.
Que faire de ces résultats ?
Établissez vos budgets par niveau de capacité et par tâche plutôt que par nom de gamme, et testez à nouveau les petits modèles.
| Charge de travail | Point à vérifier | Modèles et chiffres |
|---|---|---|
| Extraction, classification et routage à fort volume | Un petit modèle de 2026 atteint-il votre seuil de qualité ? | Claude Haiku 5.5 obtient 43.4 et GPT-6 Luna 38.1 à $0.10 / $0.50 ; il y a un an, aucun modèle des données ne dépassait 23 |
| Agents et raisonnements longs | Coût par tâche terminée | GPT-6.1 Sol à $0.72 par tâche de l’indice, Gemini 4 Argon à $1.99 pour le même tarif catalogue |
| Tâches exigeant les meilleures capacités | Avez-vous besoin du niveau 50 ou du meilleur modèle ? | Le niveau 50 coûte $4 pondérés sur GPT-6.1 Sol, ou sur Argon jusqu’au 1 décembre ; Claude Opus 5.5, à 57.6, coûte $8 |
| Budget établi sur un tarif de lancement | Durée de validité du tarif | Les tarifs de lancement de Google doivent augmenter (Argon le 1 décembre, Gemini 3.8 Flash le 1 janvier) ; OpenAI a baissé les tarifs de lancement des trois GPT-5.6 en six semaines ; Anthropic a maintenu ses tarifs d’une version à l’autre et les a baissés avec de nouveaux modèles |
| Traitements par lots sur DeepSeek | Le travail peut-il s’exécuter en heures creuses ? | DeepSeek V4.1 Flash coûte moitié moins cher en dehors des heures de bureau à Pékin : $0.15 / $0.60 contre $0.30 / $1.20 |
| Modèles phares à poids ouverts choisis pour leur coût | Les prix des hébergeurs pour le modèle exact et la précision des poids | 12 des 15 hébergeurs proposant Kimi K3 moins cher que Moonshot utilisent des poids quantifiés sur 4 bits |
FAQ
Les prix des API LLM baissent-ils en 2026 ? Les prix par token ont surtout augmenté : le prix catalogue en entrée a progressé dans 10 des 14 gammes comparées entre octobre 2025 et octobre 2026. À capacité égale, ils ont baissé : le modèle le moins cher atteignant 40 sur l’indice d’intelligence d’Artificial Analysis coûtait $10 par million de tokens pondérés en avril 2026, contre $0.20 en octobre (Claude Haiku 5.5). Par tâche, le coût a été divisé par 19 entre mai et octobre.
Quel laboratoire d’IA a le plus baissé ses prix d’API ? Anthropic a le plus baissé ses prix : sur les deux années précédant octobre 2026, le laboratoire a réduit les prix catalogue de ses trois gammes, avec Claude Opus 5.5 à $4 / $20 contre $15 / $75 pour Claude 3 Opus, et Claude Haiku 5.5 à $0.10 / $0.50. Google a augmenté les prix de ses trois gammes. Chez OpenAI, les prix pondérés du modèle phare et du petit modèle ont terminé la période à moins de 25% de leurs niveaux d’octobre 2024, tandis que celui de la gamme intermédiaire a été multiplié par 17.
À lire aussi
- Coût de l’API Gemini 4 Argon : même tarif catalogue que GPT-6.1 Sol, mais 3.1x par réponse correcte
- Paliers tarifaires des contextes longs : à quelle longueur de prompt chaque fournisseur augmente ses prix
- Coût d’une écriture dans le cache de prompt : prix d’écriture et de lecture par fournisseur
- Coût de Claude Haiku 5.5 : mesures autour du seuil tarifaire de 100,000 tokens
- Coût de Kimi K3 : un modèle phare à poids ouverts au prix d’un modèle fermé