
Claude Haiku 5.5 : un token au-delà de 100K coûte 5x plus
Sommaire
- Comment nous avons mesuré les coûts
- Combien coûte Claude Haiku 5.5 de chaque côté du seuil ?
- Les tokens en cache et en sortie comptent-ils dans les 100,000 tokens ?
- 100,000 tokens représentent-ils autant de texte que sur Claude Haiku 4.5 ?
- Que se passe-t-il quand le contexte d’un agent dépasse le seuil ?
- Comment garder un agent sous le seuil ?
- Est-il moins cher que GPT-6 Luna au même prix catalogue ?
- FAQ
- Combien coûte Claude Haiku 5.5 ?
- Les tokens en cache comptent-ils dans le seuil de 100,000 tokens de Claude Haiku 5.5 ?
- Claude Haiku 5.5 est-il moins cher que Claude Haiku 4.5 ?
- Claude Haiku 5.5 est-il moins cher que GPT-6 Luna ?
- Comment garder les requêtes Claude Haiku 5.5 sous les 100,000 tokens ?
- À lire aussi
Claude Haiku 5.5 a deux grilles tarifaires. La longueur du prompt détermine celle qui s’applique à toute la requête. Nous avons envoyé un prompt de 100,000 tokens exactement : il a coûté $0.0100. Avec un seul token de plus, il a coûté $0.0500. Le prompt comprend tout ce que vous envoyez : instructions système, définitions des outils et messages. Il inclut aussi les tokens lus dans le prompt cache. La grille d’Anthropic ne le précise pas, mais nous l’avons vérifié sur notre facture Anthropic.
TL;DR
- Un prompt de 100,000 tokens sur Claude Haiku 5.5 a coûté $0.010008. À 100,001 tokens, il a coûté $0.050041, soit cinq fois plus.
- Un prompt de 102,011 tokens, dont 94% lus dans le cache, a été facturé au tarif supérieur : $0.0078 au lieu de $0.0016 au tarif inférieur.
- Le même texte anglais représente 1.4 à 1.5 fois plus de tokens sur Haiku 5.5 que sur Claude Haiku 4.5.
- Dans une boucle d’agent, six requêtes au-delà du seuil ont représenté 76% d’une exécution à $0.083. La compaction ou un sous-agent ont ramené le coût à $0.026 ou $0.016.
Comment nous avons mesuré les coûts
La plupart des requêtes sont passées par la passerelle Synthorai les 8 et 9 octobre 2026. « Facturé » désigne le montant prélevé par la passerelle pour une requête. Elle applique l’une des deux grilles d’Anthropic selon la longueur du prompt, calculée en additionnant les trois compteurs d’entrée de la réponse : tokens non mis en cache, lectures du cache et écritures dans le cache. Les 581 montants vérifiés correspondaient tous à l’une des deux grilles, à six décimales près.
La page de tarification d’Anthropic indique seulement que le modèle est « priced by prompt length », et la réponse de l’API ne contient aucun prix. Nous avons donc aussi envoyé 23 des mêmes prompts directement à l’API Anthropic, puis consulté le coût du jour pour ce modèle dans l’Anthropic Console : $0.33. Ces requêtes totalisent $0.3301 si tous les prompts de plus de 100,000 tokens passent au tarif supérieur, cache compris, contre $0.2678 si les lectures du cache ne comptent pas. Anthropic facture comme la passerelle.
Combien coûte Claude Haiku 5.5 de chaque côté du seuil ?
Dès que le prompt dépasse 100,000 tokens, chaque ligne de la grille coûte cinq fois plus cher. Les prix sont indiqués par million de tokens.
| Prompt jusqu’à 100,000 tokens | Prompt de plus de 100,000 tokens | Claude Haiku 4.5 | |
|---|---|---|---|
| Entrée | $0.10 | $0.50 | $1.00 |
| Sortie | $0.50 | $2.50 | $5.00 |
| Lecture du cache | $0.01 | $0.05 | $0.10 |
| Écriture dans le cache, 5 minutes | $0.125 | $0.625 | $1.25 |
| Batch entrée / sortie | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 |
Une écriture dans le cache correspond à la première requête qui y stocke un préfixe de prompt. Une lecture du cache correspond à une requête ultérieure qui réutilise ce préfixe. Batch est l’API asynchrone d’Anthropic, facturée moitié prix.
Le tarif supérieur s’applique à toute la requête, pas seulement aux tokens qui dépassent le seuil. Nous avons construit un prompt de 99,872 tokens, puis ajouté un ou deux tokens à la fois :
| Tokens du prompt | Facturé | Tarif |
|---|---|---|
| 99,998 | $0.010008 | inférieur |
| 100,000 | $0.010008 | inférieur |
| 100,001 | $0.050041 | supérieur |
| 100,002 | $0.050041 | supérieur |
À 100,000 tokens exactement, le tarif inférieur s’applique encore : Anthropic parle bien de prompts de « plus de 100,000 » tokens. Selon Anthropic, environ 90% des requêtes adressées à Claude Haiku 4.5 avaient un prompt de 100,000 tokens ou moins. Par token, le nouveau modèle coûte 90% de moins que l’ancien sous le seuil et 50% de moins au-dessus.
Les tokens en cache et en sortie comptent-ils dans les 100,000 tokens ?
Les tokens en cache comptent, ceux en sortie non. Nous avons mis en cache un préfixe de 96,045 tokens, puis l’avons renvoyé avec des suffixes de différentes longueurs :
| Requête | Tokens du prompt | Lus dans le cache | Facturé | Tarif |
|---|---|---|---|---|
| préfixe, première fois (écrit dans le cache) | 96,058 | 0 | $0.012009 | inférieur |
| préfixe renvoyé | 96,058 | 96,045 | $0.000964 | inférieur |
| préfixe et suffixe de 1,000 tokens | 97,034 | 96,045 | $0.001061 | inférieur |
| préfixe et suffixe de 6,000 tokens | 102,011 | 96,045 | $0.007795 | supérieur |
Dans la dernière requête, 94% des tokens du prompt viennent du cache, mais le tarif supérieur s’applique : $0.0078, contre $0.0016 au tarif inférieur. Pour la sortie, un prompt de 97,864 tokens suivi d’une réponse de 1,905 tokens a coûté $0.010739, au tarif inférieur.
Pour vérifier le seuil, additionnez trois champs de la réponse. Avant l’envoi, l’endpoint de comptage des tokens accepte les mêmes system, tools et messages que la requête :
import anthropic

client = anthropic.Anthropic()

# after a request: the length the price list is chosen by
u = response.usage
prompt_tokens = u.input_tokens + u.cache_read_input_tokens + u.cache_creation_input_tokens

# before a request
count = client.messages.count_tokens(model="claude-haiku-5-5", system=system, tools=tools, messages=messages)
over_the_line = count.input_tokens > 100_000
100,000 tokens représentent-ils autant de texte que sur Claude Haiku 4.5 ?
Non. Claude Haiku 5.5 utilise un tokenizer plus récent, qui découpe le texte en unités facturées. Un même texte produit davantage de tokens que sur Claude Haiku 4.5. Le guide de migration d’Anthropic annonce « approximately 30% more ». Nous avons compté les tokens de cinq échantillons sur les deux modèles :
| Texte | Haiku 4.5 | Haiku 5.5 | Ratio | 100,000 sur Haiku 5.5 équivalent à, sur Haiku 4.5 |
|---|---|---|---|---|
| Prose anglaise (rapport du NIST, 12 pages) | 6,478 | 9,618 | 1.48 | 67,353 |
| Article de recherche, 6 pages | 4,352 | 6,048 | 1.39 | 71,958 |
| Code source JavaScript | 8,802 | 11,814 | 1.34 | 74,505 |
| Code source Python | 9,743 | 12,144 | 1.25 | 80,229 |
| Markdown mêlant chinois et anglais | 13,351 | 14,710 | 1.10 | 90,761 |
Un texte anglais qui représentait 68,000 tokens sur Haiku 4.5 atteint déjà le seuil sur Haiku 5.5. Un budget calculé sur l’ancien modèle place donc le seuil au mauvais endroit. L’économie par document est aussi plus faible que l’économie par token : avec 1.48 fois plus de tokens, la prose anglaise coûte 85% de moins que sur Haiku 4.5 sous le seuil, et 26% de moins au-dessus.
Que se passe-t-il quand le contexte d’un agent dépasse le seuil ?
La requête qui franchit le seuil coûte environ cinq fois plus que la précédente, et toutes les suivantes restent à ce niveau. À chaque tour, une boucle d’agent renvoie toute la conversation. Si le prompt s’allonge d’un résultat d’outil à chaque tour, il finit par atteindre 100,000 tokens.
Nous avons fait lire à un agent sur Claude Haiku 5.5 20 fichiers de logs d’environ 7,000 tokens chacun via un outil read_file, puis lui avons demandé d’en calculer un total. Chaque résultat d’outil reste dans la conversation et le préfixe est mis en cache, comme c’est généralement le cas dans ce type de boucle. Voici les requêtes 15 à 18 d’une exécution :
| Requête | Tokens du prompt | Lus dans le cache | Facturé |
|---|---|---|---|
| 15 | 92,701 | 85,593 | $0.001787 |
| 16 | 99,705 | 92,699 | $0.001845 |
| 17 | 106,744 | 99,703 | $0.009598 |
| 18 | 113,771 | 106,742 | $0.009942 |
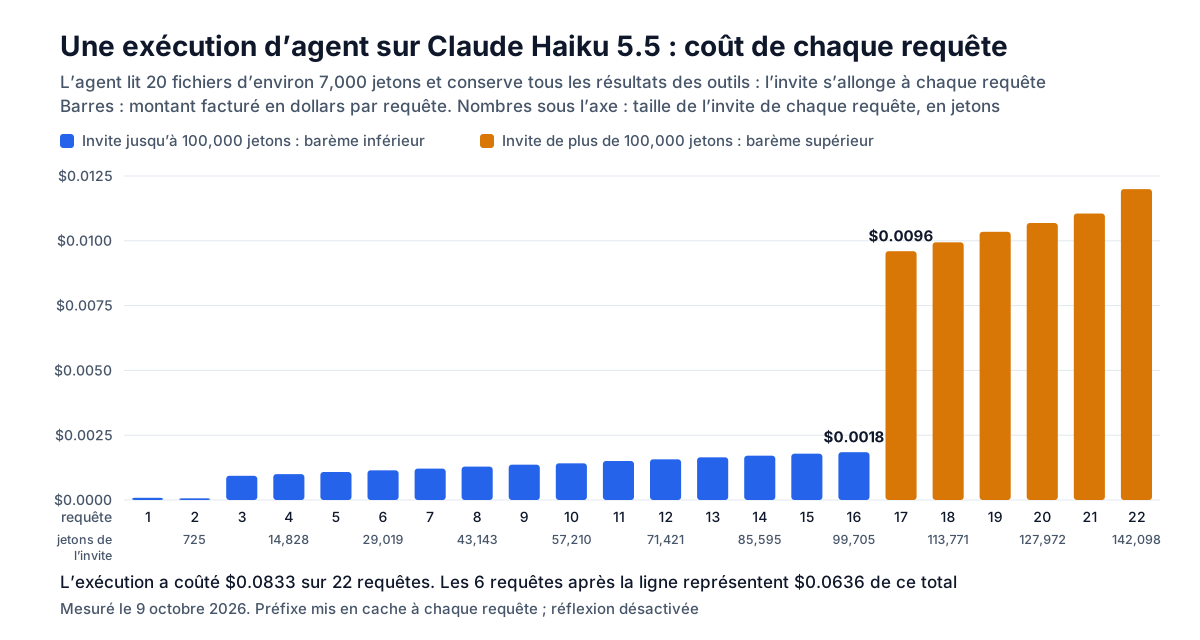
La requête 17 compte 7,000 tokens de plus que la requête 16 et coûte 5.2 fois plus. L’exécution a envoyé 22 requêtes pour $0.0833. Les six requêtes au-delà du seuil en représentent $0.0636, soit 76%. Les mêmes tokens auraient coûté $0.0324 au tarif inférieur.
Comment garder un agent sous le seuil ?
Il faut empêcher les anciens résultats d’outils de s’accumuler dans la conversation principale. Nous avons exécuté la même tâche de quatre façons sur Claude Haiku 5.5, cinq fois par méthode, avec un cache vide au début de chaque exécution :
| Méthode | Total correct | Facturé par exécution (médiane) | Requêtes | Plus grand prompt |
|---|---|---|---|---|
| Tout conserver | 5 sur 5 | $0.0823 | 22 | 142,119 |
| Compacter à 80,000 tokens | 5 sur 5 | $0.0261 | 23 | 92,829 |
| Réduire les anciens résultats d’outils | 3 sur 5 | $0.0228 | 22 | 10,278 |
| Faire lire chaque fichier par un sous-agent | 5 sur 5 | $0.0156 | 42 | 7,100 |
- Compaction. Quand le prompt dépasse 80,000 tokens, une requête supplémentaire demande au modèle un résumé de l’avancement, puis la conversation repart de ce résumé. Prévoyez une marge : le résultat d’outil suivant doit lui aussi tenir sous les 100,000 tokens.
- Réduction. Avant chaque requête, tous les résultats d’outils sauf le plus récent sont remplacés par une ligne. Deux exécutions sur cinq ont donné un total erroné après une erreur de calcul dans le total intermédiaire conservé par le modèle dans ses réponses. Cinq exécutions ne permettent pas de conclure que cette méthode est moins fiable (3 sur 5 contre 5 sur 5 n’est pas une différence significative), mais elles montrent le risque : une fois la source retirée, impossible de corriger l’erreur.
- Sous-agent. L’outil de l’agent principal transmet chaque fichier à une requête distincte, qui renvoie une seule ligne. C’était la méthode la moins chère, mais elle a envoyé le plus de requêtes et pris environ un quart de temps en plus. Chaque requête distincte ne voit que les données qu’elle reçoit : ses instructions doivent donc préciser aussi clairement que celles de l’agent principal ce qu’elle doit chercher.
Les quatre méthodes ont été exécutées avec le thinking désactivé. Le thinking correspond au travail interne du modèle avant sa réponse ; il est activé par défaut sur ce modèle. Selon le guide de migration d’Anthropic, une requête qui renvoie des blocs de thinking après modification d’un message précédent reçoit une erreur 400. Pour les comptes créés avant le 31 août 2026, cela ne s’applique que si le contrôle a été activé. Avec la réduction, il faut donc désactiver le thinking ou exclure ses blocs. La compaction et les sous-agents repartent d’une nouvelle conversation et évitent le problème.
Est-il moins cher que GPT-6 Luna au même prix catalogue ?
Pas dans nos tests : à précision égale, il a coûté environ deux fois plus. GPT-6 Luna affiche les mêmes prix, $0.10 et $0.50, sans changement selon la longueur du prompt.
D’après les chiffres d’Anthropic, Claude Haiku 5.5 devance GPT-6 Luna sur les benchmarks d’agents, et devance largement Claude Haiku 4.5 :
| Benchmark (annonce d’Anthropic) | Ce qu’il mesure | Haiku 5.5 | GPT-6 Luna | Haiku 4.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | tâches de travail intellectuel, score Elo | 1620 | 1437 | 735 |
| OSWorld 2.1, sous-ensemble hors ligne | utilisation d’un ordinateur | 72.4% | 48.9% | 15.7% |
| Terminal-Bench 4.0 | tâches de programmation dans un terminal | 39.2% | 16.4% | 0.0% |
Nous avons testé les trois modèles avec leurs réglages par défaut, ainsi que Haiku 5.5 avec le thinking désactivé, sur deux jeux plus petits dont les réponses sont vérifiables : 96 questions de classification, d’extraction et de routage d’outils, les usages cités par Anthropic pour ce modèle, et 14 tâches à plusieurs étapes exécutées trois fois chacune.
| Modèle | Réponses correctes sur les questions courtes, sur 96 | Coût pour 1,000 appels | Tâches à plusieurs étapes réussies, sur 42 | Coût par bonne réponse |
|---|---|---|---|---|
| Claude Haiku 5.5 | 95 | $0.107 | 39 | $0.00103 |
| Claude Haiku 5.5, thinking désactivé | 94 | $0.069 | 33 | $0.00036 |
| GPT-6 Luna | 95 | $0.049 | 38 | $0.00043 |
| Claude Haiku 4.5, sans extended thinking | 94 | $0.679 | 10 | $0.01053 |
Le coût par bonne réponse correspond à la dépense totale divisée par le nombre de réponses correctes. Haiku 5.5 et GPT-6 Luna sont au même niveau de précision sur les deux jeux (39 et 38 sur 42 donnent le même résultat), mais Haiku 5.5 coûte un peu plus du double. Sur les questions courtes, il a compté 482 tokens d’entrée là où GPT-6 Luna en a compté 231. Sur les tâches à plusieurs étapes, il a produit 1,902 tokens de sortie par appel, contre 759. Face à Haiku 4.5, exécuté avec son réglage par défaut sans extended thinking, il coûte 84% de moins sur les questions courtes et réussit environ quatre fois plus de tâches à plusieurs étapes.
Par défaut, le thinking utilise l’effort medium. Ce réglage détermine l’effort de réflexion du modèle, de low à max ; thinking: {"type": "disabled"} le désactive. Sans thinking, les questions courtes ont obtenu le même score pour deux tiers du coût, mais les tâches à plusieurs étapes ont perdu 6 réponses sur 42. Le modèle a aussi inclus son raisonnement dans chaque réponse où un seul nombre était demandé. Avec l’effort max, il a obtenu le même score de 39 que par défaut, pour le double du coût.
En pratique, ce modèle est l’option économique de la gamme Claude, avec un net progrès par rapport à Haiku 4.5 pour un dixième du prix par token. Pour les appels courts à grand volume, GPT-6 Luna a fait le même travail pour deux fois moins cher dans nos tests. L’intérêt de Haiku 5.5 se situe dans les tâches d’agent, où les benchmarks d’Anthropic le placent nettement devant, même si nous n’avons pas comparé les deux sur ce point, à condition de garder les prompts sous 100,000 tokens. Avant de migrer une charge de travail depuis Haiku 4.5, recomptez ses prompts sur le nouveau modèle et retirez les paramètres que Haiku 5.5 refuse avec une erreur 400 d’après le guide de migration : un budget de thinking défini manuellement, une valeur non par défaut de temperature, top_p ou top_k, et un tour assistant prérempli.
FAQ
Combien coûte Claude Haiku 5.5 ?
Pour les prompts de 100,000 tokens ou moins, Claude Haiku 5.5 coûte $0.10 par million de tokens d’entrée et $0.50 par million de tokens de sortie. Au-delà de 100,000 tokens, ces prix passent à $0.50 et $2.50 pour toute la requête. Les lectures du cache coûtent $0.01 ou $0.05, et l’API Batch divise par deux les prix d’entrée et de sortie dans les deux grilles.
Les tokens en cache comptent-ils dans le seuil de 100,000 tokens de Claude Haiku 5.5 ?
Oui. Un prompt de 102,011 tokens envoyé à Claude Haiku 5.5, dont 96,045 lus dans le cache, a été facturé au tarif supérieur : $0.0078 contre $0.0016 au tarif inférieur. La longueur du prompt additionne les tokens d’entrée non mis en cache, les lectures du cache et les écritures dans le cache. La grille d’Anthropic ne le précise pas, mais dix requêtes de ce type envoyées directement à son API ont été facturées au tarif supérieur sur notre facture Anthropic. Les tokens de sortie ne comptent pas.
Claude Haiku 5.5 est-il moins cher que Claude Haiku 4.5 ?
Oui, des deux côtés du seuil, mais l’écart est plus faible que ne le suggère la grille tarifaire : le même texte représente davantage de tokens sur le nouveau modèle. Pour la prose anglaise, nous avons mesuré 1.48 fois plus de tokens. Claude Haiku 5.5 revient ainsi environ 85% moins cher que Claude Haiku 4.5 sous les 100,000 tokens, et environ 26% moins cher au-dessus.
Claude Haiku 5.5 est-il moins cher que GPT-6 Luna ?
Pas dans nos tests, malgré des prix catalogue identiques. Sur 96 tâches courtes, Claude Haiku 5.5 a coûté $0.107 pour 1,000 appels avec ses réglages par défaut, contre $0.049 pour GPT-6 Luna, à précision égale. Haiku 5.5 a compté environ deux fois plus de tokens d’entrée pour les mêmes questions et produit davantage de tokens de sortie.
Comment garder les requêtes Claude Haiku 5.5 sous les 100,000 tokens ?
Comptez les tokens avant l’envoi et, dans les boucles d’agent, empêchez les anciens résultats d’outils de s’accumuler. Résumez la conversation avant qu’elle atteigne le seuil, ou faites lire chaque entrée volumineuse par une requête distincte qui ne renvoie que le résultat. Dans notre test sur Claude Haiku 5.5, ces méthodes ont ramené le coût d’une tâche de $0.082 à $0.026 et $0.016, avec une bonne réponse à chaque exécution.
À lire aussi
- Tarifs selon la longueur du contexte : les autres modèles dont le prix change avec la longueur du prompt.
- Claude Sonnet 5.5 face à Sonnet 5 : effort et coût par tâche dans la gamme supérieure.
- GPT-6 Luna : le coût du réglage de raisonnement : le modèle au même prix catalogue.
- Le tokenizer de Claude Sonnet 5 : celui qu’utilise désormais aussi Haiku 5.5.