
Gemini 4 Argon : tarif de GPT-6.1 Sol, coût par bonne réponse x3
Sommaire
- Combien coûte Gemini 4 Argon ?
- À quels modèles OpenAI et Claude Gemini 4 Argon se compare-t-il ?
- Quel est le coût par réponse d’Argon face à GPT-6.1 Sol, GPT-6 Astra et Opus 5.5 ?
- Que fait chaque niveau de raisonnement ?
- Qu’est-ce qui casse lors d’une migration vers Gemini 4 Argon ?
- Quel niveau de raisonnement choisir selon la charge de travail ?
- FAQ
- À lire aussi
Gemini 4 Argon facture $2 par million de tokens en entrée et $10 par million de tokens en sortie, comme GPT-6.1 Sol. Pourtant, sur notre jeu de 13 tâches de raisonnement, son coût par bonne réponse était 3.1x plus élevé ($0.0063 contre $0.0020, calculés en divisant la dépense totale par le nombre de bonnes réponses). Il a produit 3.3x plus de tokens de sortie pour le même score : 38 appels corrects sur 39. Face aux modèles haut de gamme auxquels Google le compare, le classement s’inverse : Argon coûte 0.76x le prix de Claude Opus 5.5 et 0.6x celui de GPT-6 Astra, jusqu’au doublement de son tarif le 1 décembre. Le principal levier de coût est thinking_level, un paramètre de requête qui règle la durée du raisonnement de gemini-4-argon avant sa réponse (low, medium par défaut, high). Les tokens de raisonnement sont facturés comme des tokens de sortie, même quand ils ne sont pas visibles dans la réponse. Nous avons mesuré les trois niveaux deux jours après le lancement de l’API, en exécutant les modèles de comparaison et Gemini 3.1 Pro le même jour.
TL;DR
- Gemini 4 Argon coûte $2/$10 par million de tokens jusqu’au 30 novembre 2026, puis $4/$20.
- Google compare Argon à GPT-6 Astra, Claude Fable 5.1 et Claude Opus 5.5 ; Argon arrive en tête sur 13 des 19 lignes publiées.
- À
medium, le coût par bonne réponse était de $0.0063 pour Argon, $0.0020 pour GPT-6.1 Sol et $0.0083 pour Opus 5.5 ; aux tarifs de décembre, celui d’Argon passe à $0.0125. - Au niveau
low, Argon n’a signalé aucun raisonnement et n’a réussi que 1 des 15 appels sur les cinq tâches les plus difficiles, contre 14 sur 15 àmedium.
Combien coûte Gemini 4 Argon ?
Le tarif API de Gemini 4 Argon double le 1 décembre 2026. La page des tarifs de Google indique un tarif jusqu’au 30 novembre, puis le tarif catalogue, sans offre gratuite. L’entrée en cache correspond à du texte que le serveur a déjà reçu dans une requête précédente, par exemple un prompt système répété. Elle est facturée à 5% du prix de l’entrée. Les prix ci-dessous sont en dollars par million de tokens :
| Offre | Entrée | Sortie (raisonnement inclus) | Entrée en cache |
|---|---|---|---|
| Standard, jusqu’au 30 nov. | $2.00 | $10.00 | $0.10 |
| Standard, à partir du 1 déc. | $4.00 | $20.00 | $0.20 |
| Batch et Flex, jusqu’au 30 nov. | $1.00 | $5.00 | $0.05 |
| Priority, jusqu’au 30 nov. | $3.60 | $18.00 | $0.18 |
Batch (soumission sous forme de job, résultats sous quelques heures) et Flex (capacité selon disponibilité) restent à la moitié du tarif standard après le 1 décembre, et Priority (capacité réservée) à 1.8x. Trois points changent par rapport à Gemini 3.1 Pro, le précédent modèle haut de gamme de Google à $2/$12 :
- Pas de surcoût pour les contextes longs. Gemini 3.1 Pro facture $4/$18 dès qu’un prompt dépasse 200K tokens. Argon conserve le tarif de $2/$10 jusqu’à sa fenêtre de contexte de 1,048,576 tokens, soit le nombre maximal de tokens qu’une requête peut contenir en cumulant l’entrée, le raisonnement et la réponse. Au tarif catalogue, notre prompt de 709K tokens a coûté $1.42 sur Argon et $2.84 sur 3.1 Pro.
- Cache implicite uniquement. Le cache explicite, qui nécessitait de créer un objet de cache et de payer son stockage, disparaît. Les préfixes de prompt répétés sont automatiquement mis en cache et facturés au tarif de l’entrée en cache.
- Un autre mode est nécessaire au-delà de 64K tokens de sortie. Une requête normale renvoie au maximum 65,536 tokens de sortie. Pour des sorties plus longues, il faut utiliser le mode d’exécution en arrière-plan de Google : le serveur poursuit la génération par tranches de 64K, jusqu’à 1M tokens.
À quels modèles OpenAI et Claude Gemini 4 Argon se compare-t-il ?
Sur les capacités, Google positionne Gemini 4 Argon face au meilleur modèle de chaque laboratoire : GPT-6 Astra, Claude Fable 5.1 et Claude Opus 5.5. Côté prix, il se situe un cran en dessous, au tarif de $2/$10 de GPT-6.1 Sol jusqu’au 30 novembre, puis à celui de $4/$20 d’Opus 5.5 à partir du 1 décembre. GPT-6 Astra et Fable 5.1 sont affichés à $10/$50.
L’indice d’intelligence d’Artificial Analysis regroupe des benchmarks d’agents, de code, de connaissances et de sciences qu’Artificial Analysis exécute lui-même. Il indique aussi le coût d’exécution d’une tâche de l’indice pour chaque modèle. Argon y fait jeu égal avec GPT-6 Astra et Fable 5.1, tandis qu’Opus 5.5 les devance de quatre à cinq points :
| Modèle | Tarif catalogue, $ par million de tokens | Présent dans le tableau de benchmarks de Google | Score de l’indice (au réglage maximal du fournisseur) | Coût par tâche de l’indice |
|---|---|---|---|---|
| Gemini 4 Argon | 2/10, puis 4/20 | Modèle évalué | 52.6 | $1.99 |
| GPT-6 Astra | 10/50 | Oui | 52.7 | $3.26 |
| Claude Fable 5.1 | 10/50 | Oui | 53.4 | $7.63 |
| Claude Opus 5.5 | 4/20 | Oui | 57.6 | $5.98 |
| GPT-6.1 Sol | 2/10 | Non | 51.8 | $0.72 |
Le tableau de Google, tiré de la fiche du modèle Argon, comporte 19 lignes. Argon arrive en tête sur 13 et à égalité sur une ; GPT-6 Astra en remporte trois et Opus 5.5 deux. Voici dix des 19 lignes : celles où les écarts sont les plus marqués, sur le travail intellectuel et les contextes longs, ainsi que les cinq où Argon perd, sur le code nécessitant plusieurs heures, le travail en terminal et l’utilisation d’un ordinateur de bureau. Les scores sont des pourcentages ; plus ils sont élevés, mieux c’est :
| Benchmark | Ce qu’il teste | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|---|
| Vals Index | Indice composite de Vals AI sur le travail intellectuel | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey Legal Agent | Tâches juridiques réalisées de bout en bout par le modèle | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | Correction de problèmes dans de vrais dépôts | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | Tâches d’ingénierie et d’optimisation sur plusieurs heures | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | Tâches dans un terminal Linux | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | Entraînement d’un modèle sur un GPU en 10 heures | 45.3% | 44.3% | 40.2% | 49.3% |
| Terminal-Bench Science 0.1 | Calcul scientifique dans un terminal | 57.6% | 68.1% | 52.6% | 63.3% |
| RiemannBench | Problèmes mathématiques de niveau recherche | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks, 256K à 1M | Suivi de liens dans un graphe en contexte long | 84.2% | 71.8% | 65.0% | 66.8% |
| OSWorld 2.0, hors ligne | Utilisation d’un ordinateur de bureau | 69.2% | 72.6% | non communiqué | non communiqué |
Ce tableau présente les résultats annoncés par Google, pas une comparaison contrôlée. Selon la note méthodologique de Google, Argon utilisait son réglage de raisonnement maximal. La plupart des chiffres des concurrents proviennent de leurs propres rapports d’évaluation ou de classements publics, avec leur réglage de raisonnement maximal ou le meilleur disponible. Google a produit plusieurs scores d’Argon (DeepSWE, les deux lignes Terminal-Bench, OSWorld) avec son propre banc de test, le code qui exécute et note les tâches, alors que les résultats des concurrents venaient d’autres sources. Sur Terminal-Bench Science, le programme de notation disposait de six fois plus de temps pour Argon.
Quel est le coût par réponse d’Argon face à GPT-6.1 Sol, GPT-6 Astra et Opus 5.5 ?
Au même tarif par token, Gemini 4 Argon coûtait 3.1x plus par bonne réponse que GPT-6.1 Sol à medium, le niveau par défaut des deux modèles, et 7.7x plus à high. Les deux ont obtenu 38/39 à medium. Face aux modèles haut de gamme, Argon reste moins cher pour l’instant : son coût par bonne réponse est de 0.6x celui de GPT-6 Astra et de 0.76x celui de Claude Opus 5.5.
Nous avons exécuté 13 tâches de raisonnement dont les réponses avaient été vérifiées par un petit programme, avec trois exécutions par tâche. Chaque combinaison de modèle et de niveau ci-dessous totalise donc 39 appels. Un appel est correct si l’entier final correspond à la réponse attendue. Les huit tâches les plus faciles étaient : sommer les nombres premiers inférieurs à 60, compter le chiffre 7 de 1 à 500, résoudre un problème d’horaires de train, calculer 7 puissance 222 modulo 1000, appliquer une règle 40 fois de suite, compter les nombres à quatre chiffres distincts et non nuls divisibles par 11, compter les chemins dans une grille avec une case bloquée et les façons de former 47 cents. Les cinq tâches les plus difficiles, que nous appelons le jeu difficile, étaient : appliquer la même règle 200 fois, calculer le reste de 13 puissance 1001 divisé par 10007, parcourir une grille 8x8 avec trois cases bloquées, choisir parmi 10 objets ceux qui respectent une limite de poids, et former 187 cents avec cinq types de pièces.
Chaque modèle a été appelé avec le format de requête qui expose son réglage de raisonnement : Argon et Gemini 3.1 Pro via l’ancien format chat d’OpenAI, repris par de nombreux fournisseurs et où le paramètre est reasoning_effort ; les modèles GPT via le format Responses plus récent d’OpenAI ; Opus 5.5 via le format natif d’Anthropic, où le paramètre est output_config.effort. Nous avons utilisé les niveaux medium et high de chaque fournisseur, ainsi que low quand le modèle le propose.
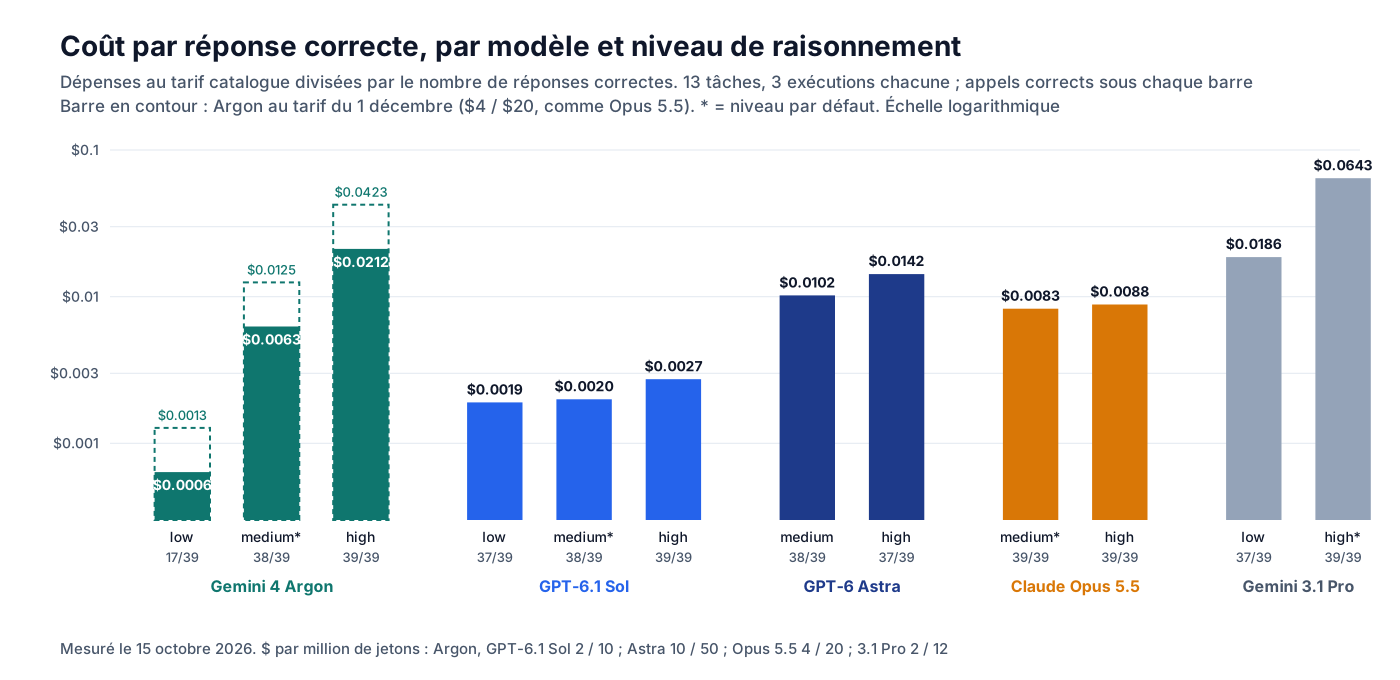
| Modèle et niveau | Appels corrects (sur 24 faciles / sur 15 difficiles) | Médiane des tokens de sortie (raisonnement inclus) | Coût par bonne réponse | Au tarif de décembre d’Argon |
|---|---|---|---|---|
Argon low | 16/24, 1/15 | 7 | $0.0006 | $0.0013 |
Argon medium (par défaut) | 24/24, 14/15 | 383 | $0.0063 | $0.0125 |
Argon high | 24/24, 15/15 | 1,455 | $0.0212 | $0.0423 |
GPT-6.1 Sol low | 24/24, 13/15 | 90 | $0.0019 | |
GPT-6.1 Sol medium (par défaut) | 24/24, 14/15 | 81 | $0.0020 | |
GPT-6.1 Sol high | 24/24, 15/15 | 192 | $0.0027 | |
GPT-6 Astra medium (par défaut) | 24/24, 14/15 | 90 | $0.0102 | |
GPT-6 Astra high | 24/24, 13/15 | 134 | $0.0142 | |
Claude Opus 5.5 medium (par défaut) | 24/24, 15/15 | 188 | $0.0083 | |
Claude Opus 5.5 high | 24/24, 15/15 | 223 | $0.0088 | |
Gemini 3.1 Pro low | 24/24, 13/15 | 1,091 | $0.0186 | |
Gemini 3.1 Pro high (par défaut) | 24/24, 15/15 | 3,272 | $0.0643 |
L’écart avec GPT-6.1 Sol vient de la longueur des sorties. Sur les 39 appels à medium, Argon a produit 22,980 tokens de sortie au total, contre 7,032 pour GPT-6.1 Sol. Sur la tâche la plus difficile, 13 puissance 1001 modulo 10007, la médiane d’Argon était de 1,523 tokens à medium et de 6,108 à high ; celle de GPT-6.1 Sol était de 524 et 901. Les scores sur le jeu difficile étaient identiques : 14/15 chacun à medium et 15/15 chacun à high. À partir du 1 décembre, l’écart à medium double pour atteindre 6.3x, car le prix d’Argon double et celui de GPT-6.1 Sol reste inchangé.
Décembre change aussi la comparaison avec Opus 5.5. Les deux seront affichés à $4/$20. Sur notre jeu de tâches, Opus 5.5 a produit moins de tokens (15,414 contre 22,980 pour Argon à medium) et a répondu correctement aux 39 appels. Au tarif de décembre, Argon coûte $0.0125 par bonne réponse contre $0.0083 pour Opus 5.5, soit 1.5x plus ; par rapport à GPT-6 Astra, il passe de 0.6x à 1.2x. Avec 15 appels difficiles par niveau, aucun des écarts de score entre Argon, Opus 5.5 et GPT-6 Astra n’est statistiquement significatif (ces paires ont été testées séparément du groupe de comparaisons corrigé dans la section suivante). Les coûts par tâche d’Artificial Analysis classent les modèles dans le même ordre : GPT-6.1 Sol à $0.72 au réglage maximal, Argon à $1.99 avec high au tarif actuel, GPT-6 Astra à $3.26, Opus 5.5 à $5.98.
Par rapport à Gemini 3.1 Pro, le modèle qu’il remplace, Argon est environ 10x moins cher par bonne réponse au niveau par défaut de chaque modèle : $0.0063 contre $0.0643. Le tarif explique une partie de cet écart, puisque 3.1 Pro facture $12 par million de tokens de sortie au lieu de $10. À prix égal, l’écart est de 8.6x et vient de la médiane de 3,272 tokens de sortie par appel pour 3.1 Pro, contre 383 pour Argon. Après le 1 décembre, Argon reste 5.1x moins cher sur ce jeu. Nous avons aussi mesuré combien de tokens chaque modèle utilise pour reconnaître qu’il ne connaît pas un fait inventé. Interrogés sur cinq entités fictives (le cours de l’action d’une entreprise, un institut de recherche, une charte municipale, un alliage et un prix), les deux ont refusé de répondre dans les cinq cas, avec une médiane de 146 tokens de sortie pour Argon et de 1,014 pour 3.1 Pro.
Que fait chaque niveau de raisonnement ?
Sur Gemini 4 Argon, low revenait à désactiver le raisonnement. Google documente trois niveaux et décrit low comme celui qui utilise le « moins de tokens », en ajoutant que « la qualité peut baisser sur les tâches difficiles ». Sur les 39 appels à low, Argon n’a indiqué aucun token de raisonnement, et sa sortie entière, qui sur ce chemin inclut tout raisonnement éventuel, comptait 5 à 11 tokens. Un second chemin API relayant les requêtes vers les serveurs de Google a indiqué explicitement 0 token de raisonnement sur les quatre appels à low que nous avons envoyés. À l’inverse, le niveau low de Gemini 3.1 Pro produisait encore une médiane de 1,091 tokens de sortie, presque tous consacrés au raisonnement.
Sans raisonnement, Argon résolvait encore les tâches en une étape, mais échouait sur celles qui nécessitent des étapes intermédiaires :
- Toujours correct à
low: la somme des nombres premiers, le comptage des chiffres, les horaires, la grille avec une case bloquée et les 47 cents (15 appels sur 15). - Incorrect à
low: la règle appliquée 40 fois (0/3), le comptage des nombres à quatre chiffres (0/3), 7 puissance 222 (1/3), et 14 des 15 appels du jeu difficile.
La baisse se maintient lorsque chaque tâche ne compte qu’une fois, ce qui importe car trois exécutions de la même tâche ne sont pas indépendantes : medium a battu low sur 8 des 13 tâches et n’a perdu sur aucune (test des signes, p = 0.008, soit moins de 1% de chances qu’un écart aussi grand soit dû au hasard). Sur le jeu difficile seul, low n’a résolu aucune des cinq tâches lors d’au moins deux des trois exécutions, tandis que medium les a toutes résolues selon ce critère (test exact de Fisher, p = 0.008 ; 0.047 après la correction de Holm pour les six comparaisons réalisées). Considérez low comme un mode sans raisonnement, destiné à la recherche d’informations simples et à la conversion de formats. À l’autre extrême, high coûtait 3.4x plus par bonne réponse que medium et réussissait un appel difficile de plus sur 15, un écart que cet échantillon ne permet pas de distinguer du hasard.
Le niveau par défaut s’adapte au prompt. Sur des prompts simples envoyés sans préciser de niveau, Argon, dont le défaut est medium, utilisait souvent zéro token de raisonnement, tandis que Gemini 3.1 Pro, dont le défaut est high, raisonnait à chaque fois. Lors d’un appel d’outil, le modèle demande à votre code d’exécuter une fonction, puis vous lui renvoyez le résultat :
| Type de prompt (médiane de 3 exécutions) | Tokens de raisonnement d’Argon | Tokens de raisonnement de Gemini 3.1 Pro |
|---|---|---|
| Recherche d’information avec réponse en un mot | 0 | 145 |
| Extraction JSON | 0 | 353 |
| Sortie conforme à un schéma JSON strict | 0 | 309 |
| Problème en deux étapes | 41 | 137 |
| Enchaînement de cinq opérations arithmétiques | 68 | 373 |
| Boucle d’appels d’outils, premier tour (choisir un outil) | 0 (31 tokens de sortie) | 173 |
| Boucle d’appels d’outils, second tour (utiliser le résultat) | 0 (32 tokens de sortie) | 67 |
Les deux modèles ont répondu correctement à tous les prompts et appelé les bons outils. Dans l’API native de Google, le niveau se place dans generation_config et le nombre de tokens de raisonnement est renvoyé dans usage :
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Compute 13 raised to the power 1001, modulo 10007. Reply with a single integer.",
    generation_config={"thinking_level": "medium", "max_output_tokens": 32768},
)
print(interaction.output_text)
print("thinking tokens:", interaction.usage.total_thought_tokens)  # billed at the output rate
print("output tokens:", interaction.usage.total_output_tokens)
Dans le format chat compatible OpenAI utilisé pour nos mesures, la passerelle traduit reasoning_effort vers les mêmes trois niveaux, et le compteur est renvoyé dans usage.completion_tokens_details.reasoning_tokens.
Qu’est-ce qui casse lors d’une migration vers Gemini 4 Argon ?
Les prompts qui se terminent par un message assistant prérempli échouent désormais avec HTTP 400, le cache explicite disparaît et les réglages d’aléa (temperature, top_p, top_k) sont ignorés. Le préremplissage consiste à commencer soi-même la réponse du modèle, par exemple avec une accolade ouvrante pour imposer du JSON. La plupart de ces changements figurent dans la liste de vérification de Google pour la migration, mais pas l’erreur de préremplissage, le surcoût en tokens du prompt ni le comportement en cas de dépassement :
| Changement | Documentation de Google | Nos mesures |
|---|---|---|
| Message assistant prérempli | Non mentionné | HTTP 400 sur Gemini 4 Argon : « Les requêtes se terminant par un tour du modèle ne sont pas prises en charge » ; Gemini 3.1 Pro l’accepte |
Cache explicite (cachedContents) | Supprimé | Non testé ; le cache implicite fonctionnait |
| Cache implicite | Réduction de 95%, prompts de 4,096+ tokens | Sur un prompt répété de 6,935 tokens, 4,881 tokens provenaient du cache 4 secondes plus tard, à $0.10 par million ; un prompt de 3,006 tokens a aussi obtenu 952 tokens en cache |
temperature, top_p, top_k | Ignorés | Acceptés avec HTTP 200 (sans erreur) |
| Surcoût fixe du prompt en tokens | Non mentionné | Environ 30 tokens d’entrée de plus par requête que Gemini 3.1 Pro pour un texte identique ; un second chemin API vers Google indique le même nombre |
| Prompt dépassant la fenêtre de 1M | Non mentionné | HTTP 400 indiquant la limite, sans troncature silencieuse |
max_output_tokens | Augmenter à 32,768 ou plus | La réponse la plus longue d’Argon comptait 6,391 tokens à high, celle de Gemini 3.1 Pro 21,362 |
Pour éviter l’erreur de préremplissage, placez l’instruction dans le prompt. Le surcoût ajoute $0.00006 par requête au tarif actuel et reste constant : 27 tokens supplémentaires pour un prompt d’une ligne et 31 pour un document de 709K tokens par rapport à Gemini 3.1 Pro. Le tokenizer, l’étape qui découpe le texte en tokens, n’a donc pas changé. Ce prompt de 709K tokens contenait 60,000 éléments numérotés, avec une question sur l’élément 42 à la fin ; Argon l’a accepté et a répondu 529, la valeur insérée.
Quel niveau de raisonnement choisir selon la charge de travail ?
Commencez à medium, n’utilisez jamais low pour les tâches à plusieurs étapes et prévoyez le tarif de décembre dans votre budget.
| Charge de travail | Risque principal | Niveau et modèle | Chiffres à l’appui |
|---|---|---|---|
| Étapes d’agent, appels d’outils, extraction, sortie JSON | Payer du raisonnement pour des étapes faciles | Gemini 4 Argon medium ; il ne consacre déjà presque rien au raisonnement ici | 0 token de raisonnement pour la recherche d’informations, l’extraction, la sortie avec schéma et les étapes d’outils |
| Mathématiques difficiles, algorithmes, code à plusieurs étapes | Réponses incorrectes | Argon medium ; testez high sur vos propres évaluations avant d’en payer le coût | 14/15 contre 15/15 sur les appels difficiles, avec un coût 3.4x plus élevé à high |
| Raisonnement à gros volume où le coût par réponse prime | Volume de raisonnement | GPT-6.1 Sol, même score sur ce jeu de 13 tâches | $0.0020 contre $0.0063 par bonne réponse, écart de 6.3x après le 1 décembre |
| Travail haut de gamme avec un budget au-delà de décembre | Doublement du prix d’Argon | Relancez vos évaluations sur Claude Opus 5.5, au même tarif catalogue de $4/$20 | $0.0083 contre $0.0125 par bonne réponse aux tarifs de décembre ; Argon remporte davantage de lignes de Google sur le travail intellectuel |
| Documents longs de plus de 200K tokens | Surcoût des contextes longs | Argon plutôt que Gemini 3.1 Pro | $1.42 contre $2.84 pour un prompt de 709K tokens |
| Recherche d’informations simples et conversion de formats uniquement | Raisonnement inutile | Argon low | 15/15 sur les tâches en une étape, 7 tokens de sortie |
Après le 1 décembre, Batch et Flex coûteront autant que l’offre standard actuelle ($2/$10). Y déplacer les jobs hors ligne permet donc de conserver les tarifs d’octobre.
FAQ
Peut-on désactiver le raisonnement sur Gemini 4 Argon ?
Gemini 4 Argon ne propose aucun réglage de désactivation documenté, mais thinking_level: "low" a joué ce rôle dans nos tests : aucun token de raisonnement signalé sur les 39 appels, dont la sortie totale était de 5 à 11 tokens chacun, et un 0 explicite sur les quatre appels passant par un second chemin API vers Google. À low, il a répondu correctement à 1 des 15 appels sur les cinq tâches les plus difficiles, contre 14 sur 15 au niveau par défaut medium.
Gemini 4 Argon facture-t-il davantage les prompts longs ? Gemini 4 Argon applique le même tarif de $2/$10 à tous les prompts jusqu’à sa fenêtre de 1,048,576 tokens jusqu’au 30 novembre 2026, puis $4/$20. Gemini 3.1 Pro facture $4/$18 au-delà de 200K tokens. Au tarif catalogue, un prompt de 709K tokens coûte donc $1.42 sur Argon et $2.84 sur 3.1 Pro.
Le cache implicite fonctionne-t-il sur Gemini 4 Argon ? Sur Gemini 4 Argon, le cache implicite a servi 4,881 tokens d’un prompt répété de 6,935 tokens, 4 secondes après le premier appel, au tarif de $0.10 par million de tokens (réduction de 95% sur l’entrée). Il a aussi mis en cache une partie d’un prompt de 3,006 tokens, en dessous du minimum de 4,096 tokens indiqué dans la documentation de Google.
À lire aussi
- GPT-6.1 Sol face à Claude Sonnet 5.5 : le même jeu de 13 tâches au même tarif de $2/$10
- Comparaison des réglages de raisonnement des LLM : le rôle du paramètre d’effort de chaque fournisseur
- Seuils minimaux du cache de prompts, mesurés : seuils documentés et seuils réels
- Coût de l’API Gemini 3.7 Flash : le précédent lancement Gemini avec un tarif de lancement
Mesures réalisées le 15 octobre 2026, deux jours après la disponibilité générale de l’API. Niveaux de raisonnement : 13 tâches aux réponses vérifiées par programme, 3 exécutions par modèle et par niveau, significativité testée en comptant chaque tâche une seule fois, chaque prompt marqué d’un identifiant aléatoire pour qu’aucune réponse ne puisse provenir d’un cache ; coûts calculés au tarif catalogue à partir du nombre de tokens. Tests du surcoût de raisonnement, des sorties structurées et des outils : 3 exécutions chacun ; tests de migration, de cache, de contexte long et de faits inventés : un seul appel chacun. Le résultat à low et le surcoût en tokens du prompt ont été confirmés via un second chemin API relayant les requêtes vers Google. Chiffres d’Artificial Analysis consultés le 14 octobre 2026 ; tableau de benchmarks de Google tiré de la fiche du modèle Gemini 4 Argon.