
Preços de API LLM em 2026: tokens sobem, capacidade custa 50x menos
Conteúdo
- Como mudaram os preços de tabela das APIs de LLM no último ano?
- Como Anthropic, OpenAI, Google e DeepSeek mudaram os preços de seus modelos ao longo de dois anos?
- Os modelos ficaram mais caros ou apenas mais capazes?
- Como o preço mudou em cada categoria?
- Como a estratégia de preços variou entre os laboratórios?
- Como a estratégia de preços da DeepSeek se compara às demais?
- Como os quatro laboratórios se comparam?
- Como o preço mudou em cada categoria?
- Quanto custa hoje um determinado nível de capacidade?
- Por que os preços mudaram assim?
- Por que o preço por token não é o preço por tarefa?
- Como os preços de cache mudaram em relação à entrada?
- O que fazer com esses dados?
- Perguntas frequentes
- Leituras relacionadas
Os preços de tabela por token das APIs de LLM subiram em 10 de 14 linhas de modelos entre outubro de 2025 e outubro de 2026. Mesmo assim, o modelo mais barato a atingir um determinado nível de capacidade passou a custar de 17 a 50 vezes menos por token nos níveis 20 a 40 do índice, e 2.5 vezes menos no nível 50. Uma linha é uma família de produtos de um fornecedor, como Claude Opus ou Gemini Flash. A capacidade é a pontuação do modelo no Artificial Analysis Intelligence Index, um índice independente que combina benchmarks em uma escala de 0 a 100 (o melhor modelo hoje marca 57.6). Os preços são combinados: dólares por milhão de tokens, na proporção de três tokens de entrada para um de saída. As duas tendências coexistem porque cada novo modelo de uma linha é mais capaz que seu antecessor.
TL;DR
- Os preços de tabela de entrada subiram em 10 de 14 categorias de outubro de 2025 a outubro de 2026; as 3 que tiveram queda são da Anthropic.
- O modelo mais barato com 40 pontos no índice da Artificial Analysis passou de $10 para $0.20 por milhão de tokens combinados, de abril a outubro de 2026.
- Desde outubro de 2024, a Anthropic reduziu os preços das três categorias (Opus de $15 / $75 para $4 / $20), o Google aumentou os das três e a OpenAI aumentou apenas o da intermediária.
- A diferença entre o maior e o menor preço de entrada dos modelos principais fechados caiu de 12x para 2x; o preço mediano dos modelos principais de pesos abertos dobrou.
Como mudaram os preços de tabela das APIs de LLM no último ano?
A maioria das linhas custa mais por token do que há um ano. Comparamos o modelo que representava cada linha em 15 de outubro de 2025 com o que a representava em 15 de outubro de 2026:
| Linha | Modelo em out. de 2025, $ por milhão de tokens (entrada / saída) | Modelo em out. de 2026, $ por milhão de tokens (entrada / saída) | Preço de entrada, 2026 vs 2025 |
|---|---|---|---|
| OpenAI principal | GPT-5, $1.25 / $10 | GPT-6.1 Sol, $2 / $10 | 1.6x |
| OpenAI intermediária | GPT-5 mini, $0.25 / $2 | GPT-5.6 Terra, $2 / $12 | 8x |
| OpenAI pequena | GPT-5 nano, $0.05 / $0.40 | GPT-6 Luna, $0.10 / $0.50 | 2x |
| Claude Opus | Opus 4.1, $15 / $75 | Opus 5.5, $4 / $20 | 0.27x |
| Claude Sonnet | Sonnet 4.5, $3 / $15 | Sonnet 5.5, $2 / $10 | 0.67x |
| Claude Haiku | Haiku 4.5, $1 / $5 | Haiku 5.5, $0.10 / $0.50 | 0.1x |
| Gemini Pro | Gemini 2.5 Pro, $1.25 / $10 | Gemini 4 Argon, $2 / $10 | 1.6x |
| Gemini Flash | Gemini 2.5 Flash, $0.30 / $2.50 | Gemini 3.8 Flash, $0.75 / $3.75 | 2.5x |
| Gemini Flash-Lite | Gemini 2.5 Flash-Lite, $0.10 / $0.40 | Gemini 3.5 Flash-Lite, $0.30 / $2.50 | 3x |
| DeepSeek de baixo custo | V3.2-Exp, $0.28 / $0.42 | V4.1 Flash, $0.30 / $1.20 no horário de pico | 1.07x |
| Zhipu GLM principal | GLM-4.6, $0.60 / $2.20 | GLM-5.3, $1.40 / $4.40 | 2.3x |
| Moonshot Kimi principal | Kimi K2, $0.60 / $2.50 | Kimi K3, $3 / $15 | 5x |
| Alibaba Qwen Max | Qwen3-Max, $1.20 / $6 | Qwen3.8 Max, $2 / $6 | 1.67x |
| MiniMax | M2 (a partir de 23 de outubro), $0.30 / $1.20 | M3, $0.30 / $1.20 | 1x |
Alguns preços têm condições: Argon e Gemini 3.8 Flash têm preços de lançamento que dobram em 1 de dezembro e 1 de janeiro, respectivamente; o Haiku 5.5 custa $0.50 / $2.50 acima de 100,000 tokens no prompt; e a linha da DeepSeek usa o preço de pico, cobrado no horário comercial de Pequim (fora de pico, o preço é a metade, abaixo do preço combinado do V3.2-Exp). A contagem de 10 em 14 se mantém com os preços combinados em vez dos preços de entrada. Os preços do Kimi K2 e do Qwen3-Max vêm de registros de terceiros.
Como Anthropic, OpenAI, Google e DeepSeek mudaram os preços de seus modelos ao longo de dois anos?
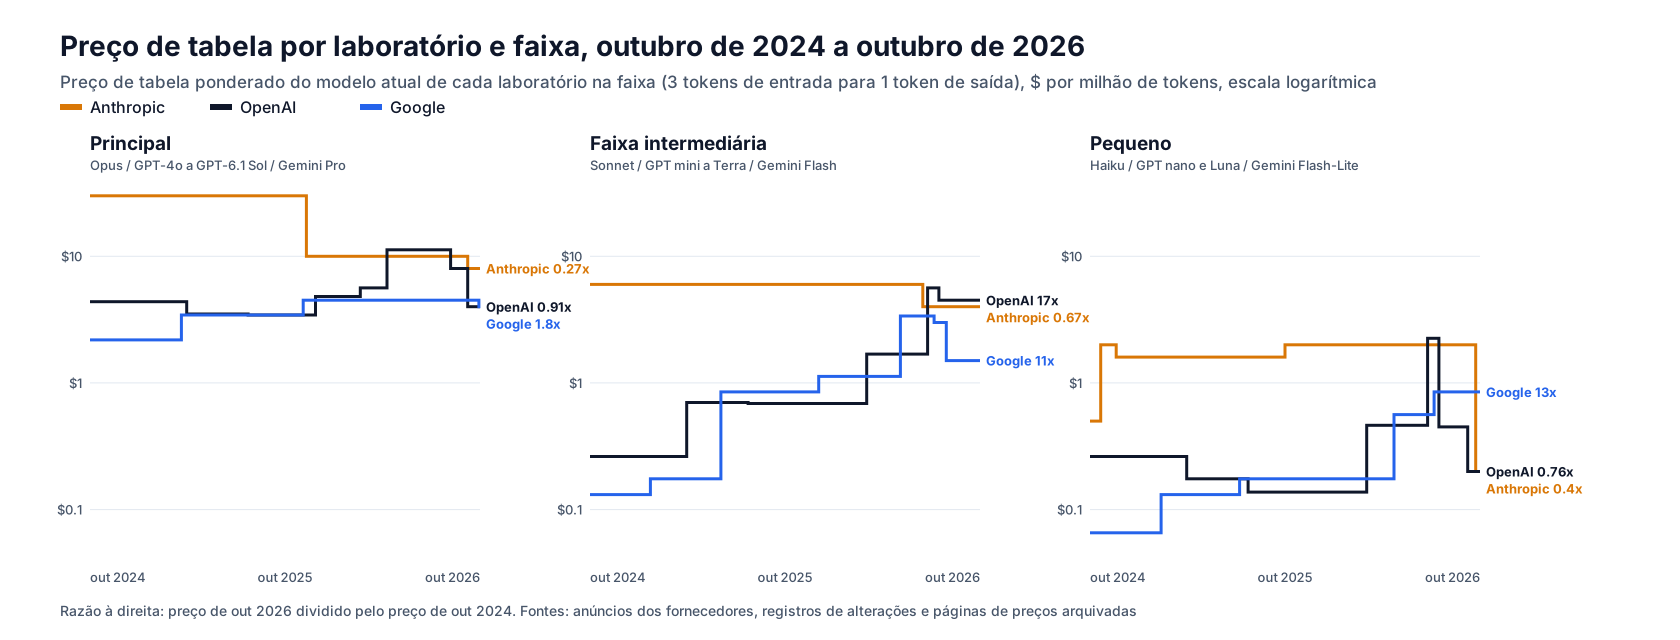
Em dois anos, a Anthropic reduziu os preços de tabela nas três categorias. Na OpenAI, os modelos principal e pequeno terminaram perto dos preços iniciais, enquanto a categoria intermediária subiu 17x. O Google aumentou os preços em todas as categorias. O modelo de baixo custo da DeepSeek ficou cerca de 3x mais caro nos horários de pico, enquanto seu preço de leitura de cache caiu para 2% do preço de entrada. O gráfico e as tabelas abaixo acompanham os três maiores laboratórios de modelos fechados desde outubro de 2024, considerando os modelos principal, intermediário e pequeno vigentes de cada um. A DeepSeek vende um ou dois modelos, em vez de três categorias, por isso tem uma subseção própria. Uma tabela final compara os quatro laboratórios.
| Categoria | Anthropic | OpenAI | |
|---|---|---|---|
| Principal | Claude 3 Opus $15 / $75 para Opus 5.5 $4 / $20: 0.27x | GPT-4o $2.50 / $10 para GPT-6.1 Sol $2 / $10: 0.91x | Gemini 1.5 Pro $1.25 / $5 para Gemini 4 Argon $2 / $10: 1.8x |
| Intermediária | Claude 3.5 Sonnet $3 / $15 para Sonnet 5.5 $2 / $10: 0.67x | GPT-4o mini $0.15 / $0.60 para GPT-5.6 Terra $2 / $12: 17x | Gemini 1.5 Flash $0.075 / $0.30 para Gemini 3.8 Flash $0.75 / $3.75: 11x |
| Pequena | Claude 3 Haiku $0.25 / $1.25 para Haiku 5.5 $0.10 / $0.50: 0.4x | GPT-4o mini para GPT-6 Luna $0.10 / $0.50: 0.76x | Gemini 1.5 Flash-8B $0.0375 / $0.15 para Gemini 3.5 Flash-Lite $0.30 / $2.50: 13x |
Os preços são de 15 de outubro de cada ano, e a razão compara os preços combinados. O GPT-4o mini aparece como modelo inicial nas duas linhas menores da OpenAI porque a empresa não tinha um modelo pequeno separado até o lançamento do GPT-4.1 nano em abril de 2025.
Os modelos ficaram mais caros ou apenas mais capazes?
A maioria dos modelos ficou mais capaz. De outubro de 2025 a outubro de 2026, a pontuação no índice do modelo vigente em cada categoria aumentou de 1.9 a 3.3 vezes. O preço por ponto do índice (preço combinado dividido pela pontuação; abaixo de 1x indica que o mesmo nível de capacidade ficou mais barato) caiu em sete das nove categorias. O índice só tem pontuações para modelos a partir de meados de 2025, por isso esta comparação cobre o segundo ano:
| Laboratório e categoria | Índice, out. de 2025 a out. de 2026 | Preço combinado | Preço por ponto do índice |
|---|---|---|---|
| Anthropic principal | 22.8 a 57.6 | $30.00 a $8.00 | 0.11x |
| Anthropic intermediária | 19.3 a 35.9 (configuração padrão) | $6.00 a $4.00 | 0.36x |
| Anthropic pequena | 16.9 a 43.4 | $2.00 a $0.20 | 0.04x |
| OpenAI principal | 23.0 a 51.8 | $3.44 a $4.00 | 0.52x |
| OpenAI intermediária | 16.8 a 42.1 | $0.69 a $4.50 | 2.6x |
| OpenAI pequena | 13.0 a 38.1 | $0.14 a $0.20 | 0.50x |
| Google principal | 16.1 a 52.6 | $3.44 a $4.00 | 0.36x |
| Google intermediária | 13.1 a 40.9 | $0.85 a $1.50 | 0.57x |
| Google pequena | 8.5 a 22.2 | $0.18 a $0.85 | 1.9x |
Os modelos são os da primeira tabela. As pontuações correspondem à maior configuração de raciocínio de cada modelo (a opção da requisição que permite ao modelo pensar por mais tempo antes de responder); as do Sonnet usam a configuração padrão, a única avaliada nos modelos Sonnet mais antigos, e as pontuações de outubro de 2025 dos modelos mais antigos são estimativas da Artificial Analysis. O preço por ponto só subiu nos casos em que o laboratório aumentou o preço do modelo mais do que sua capacidade melhorou.
Como o preço mudou em cada categoria?
Os preços da categoria principal se aproximaram, os da intermediária subiram e os da pequena se dividiram. Em outubro de 2024, o maior preço de entrada da categoria principal era 12 vezes o menor (Claude 3 Opus a $15, Gemini 1.5 Pro a $1.25), e essa razão continuava em 12 vezes em outubro de 2025. Hoje, é de 2 vezes; nesse intervalo, o modelo principal da OpenAI chegou a $5 / $30 com o GPT-5.5 em abril de 2026, antes de cair para $2 / $10. Os modelos intermediários hoje superam as pontuações que os principais atingiam um ano antes, e a OpenAI e o Google ajustaram seus preços a esse nível de capacidade. Com isso, a razão entre o maior e o menor preço de entrada da categoria intermediária caiu de 40x para 2.7x, e a redução do preço do Sonnet diminuiu ainda mais essa diferença. Na categoria pequena, OpenAI e Anthropic chegaram ao mesmo preço de $0.10 / $0.50, enquanto o Gemini 3.5 Flash-Lite do Google custa o que o Gemini 2.5 Flash custava em meados de 2025.
Como a estratégia de preços variou entre os laboratórios?
A Anthropic manteve os preços por longos períodos e fez cortes em etapas. A OpenAI mudou os preços com frequência, atribuindo cada mudança à capacidade ou à eficiência. O Google aumentou os preços a cada geração e anunciou os aumentos com antecedência. Nenhuma das três citou um concorrente como motivo para mudar os preços, nem mesmo quando Opus 5.5, GPT-6 Sol e GPT-6 Luna foram lançados no mesmo dia.
Anthropic: preços estáveis, depois reduções em etapas. O Sonnet manteve $3 / $15 de março de 2024 até o Sonnet 4.6, em 2026, e o Opus manteve $15 / $75 até o Opus 4.5 reduzir o preço para $5 / $25 em novembro de 2025, “tornando a capacidade do Opus acessível a ainda mais usuários” (Anthropic). As reduções seguintes vieram com novos modelos: o Opus 5.5 “exige menos recursos computacionais para inferência que o Opus 5, e seu preço reflete isso” (Anthropic), e o preço de lançamento de $2 / $10 do Sonnet 5 tornou-se seu preço padrão em agosto. Os aumentos ficaram na linha Haiku: o Claude 3.5 Haiku foi lançado a $1 / $5 em novembro de 2024 “para refletir o aumento de sua capacidade” e caiu para $0.80 / $4 um mês depois (TechCrunch), e o Haiku 4.5 voltou a $1 / $5 em outubro de 2025.
OpenAI: mudanças frequentes de preço, atribuídas à capacidade ou à eficiência. Os aumentos vieram acompanhados de alegações de maior capacidade: o GPT-5.2 tinha “preço por token maior que o GPT‑5.1 por ser um modelo mais capaz” (OpenAI). Os cortes foram justificados por reduções no custo de inferência: o preço do o3 caiu 80% em junho de 2025 porque “otimizamos a infraestrutura de inferência que atende o o3” (OpenAIDevs), e GPT-6 Sol e Luna foram lançados pela metade do preço de entrada de seus antecessores porque “melhorias no cache e na inferência nos permitem servir esses modelos a um custo menor” (OpenAI). Os preços de lançamento não duraram: os três modelos GPT-5.6, lançados em julho, tiveram reduções de preço em até seis semanas. A Reuters associou o corte de agosto no GPT-5.6 Sol à “concorrência crescente da Anthropic e dos modelos chineses de IA”; a OpenAI citou ganhos de eficiência.
Google: preços em alta e aumentos programados. O Google começou como o laboratório mais barato em todas as categorias e aumentou os preços na maioria das gerações, geralmente sem explicar o motivo. A exceção foi o Gemini 2.5 Flash, cujo preço de entrada dobrou em junho de 2025 como “um ajuste específico que reflete o valor excepcional do Flash” (Google). Desde agosto, o Google lança modelos com preços promocionais e aumento já programado: Gemini 3.7 Flash e 3.8 Flash a $0.75 / $3.75 até 31 de dezembro, depois $1.50 / $7.50, e Argon a $2 / $10 até 30 de novembro, depois $4 / $20. O Google não explicou o motivo, mas Sundar Pichai disse aos investidores em julho que “continuamos com capacidade insuficiente para atender à demanda” (Alphabet).
Como a estratégia de preços da DeepSeek se compara às demais?
A DeepSeek reduziu os preços quando uma nova arquitetura baixou seu custo de inferência e os aumentou quando a demanda superou a capacidade de suas GPUs. A eficiência definiu até onde o preço podia cair; a capacidade computacional disponível definiu o preço em cada momento. Boa parte disso passa pelo cache: quando um prompt começa com um texto que o provedor já processou, ele pode reutilizar o estado intermediário armazenado (o KV cache) em vez de refazer o cálculo, e cobra menos por esses tokens de entrada, como uma leitura de cache.
| Data | Mudança | Cache hit / cache miss / saída, $ por milhão de tokens |
|---|---|---|
| Agosto de 2024 | Lançamento do cache de prompt em disco (DeepSeek V2, depois V2.5) | $0.014 / $0.14 / $0.28 |
| Fevereiro de 2025 | V3 passa ao preço integral após a promoção de lançamento; desconto noturno de 50% no V3 e 75% no R1, seu modelo de raciocínio, a partir de 26 de fevereiro | $0.07 / $0.27 / $1.10 |
| 5 de setembro de 2025 | Preço único para os modos com e sem raciocínio do V3.1; fim do desconto noturno | $0.07 / $0.56 / $1.68 |
| 29 de setembro de 2025 | V3.2-Exp, com redução de preços de mais da metade | $0.028 / $0.28 / $0.42 |
| Abril de 2026 | Lançamento do V4 Flash; dois dias depois, o preço de cache hit cai para um décimo do preço de lançamento | $0.0028 / $0.14 / $0.28 |
| 17 de agosto de 2026 | Introdução de preços de pico; fora de pico, o preço é a metade | $0.014 / $0.44 / $1.32 no horário de pico |
| 10 de setembro de 2026 | V4.1 Flash substitui o V4 Flash | $0.006 / $0.30 / $1.20 no horário de pico |
Os preços são do modelo mais barato da DeepSeek em cada data. Os horários de pico são das 09:00 às 12:00 e das 14:00 às 18:00, no horário de Pequim, em dias úteis.
Eficiência. Os anúncios da DeepSeek associam três reduções de preço a mudanças na arquitetura. O cache em disco de 2024 se apoiava no MLA, a arquitetura de atenção comprimida da DeepSeek, que reduziu o cache KV o suficiente para armazená-lo em discos baratos (DeepSeek). A redução de setembro de 2025 veio com o DeepSeek Sparse Attention, que aplica atenção a um subconjunto dos tokens anteriores. O anúncio em chinês atribui a redução ao custo muito menor de servir o novo modelo (DeepSeek). O cache KV do V4.1 Flash precisa de “1/4 da HBM” (memória da GPU) e “1/8 do armazenamento SSD” de seu antecessor, e a DeepSeek destacou que “as cobranças por leituras de cache costumam representar uma grande parcela dos custos dos agentes” (DeepSeek). Sua leitura de cache agora custa 2% do preço de entrada, contra 10% em 2024 e 2.5% a 10% nos laboratórios dos EUA hoje. O único dia de dados de operação publicado pela DeepSeek, de março de 2025, mostra que 56.3% dos tokens de entrada foram atendidos pelo cache em disco, com margem teórica de 545% a $2 por GPU-hora, mas receita real “substancialmente menor” (DeepSeek).
Capacidade. O mesmo panorama informa que a DeepSeek realoca nós de inferência para pesquisa e treinamento à noite, nos horários de baixa demanda aos quais se aplicava o desconto noturno de 2025. Os aumentos vieram quando faltava capacidade: a unificação dos modos do V3.1 em setembro de 2025 encerrou esse desconto e dobrou o preço de entrada em cache miss do modelo sem raciocínio, de $0.27 para $0.56, sem explicação (DeepSeek); em agosto de 2026, a introdução de preços de pico triplicou o preço de entrada do V4 Flash nos horários de maior demanda para “alocar recursos de forma mais razoável” (tradução nossa do anúncio em chinês, DeepSeek). Mesmo fora de pico, o V4.1 Flash custa mais do que o V4 Flash custava antes de agosto, mas, por ponto no índice, custa 0.70x no pico e 0.35x fora de pico o que custava o V3.2-Exp um ano antes (39.5 pontos contra uma estimativa de 16.6).
Como os quatro laboratórios se comparam?
| Anthropic | OpenAI | DeepSeek | ||
|---|---|---|---|---|
| Tendência em dois anos | Queda nas três categorias | Principal e pequena em leve queda (0.91x, 0.76x), intermediária em alta de 17x | Alta nas três categorias | Modelo de baixo custo subiu 3x no horário de pico, 1.5x fora de pico |
| Frequência das mudanças de preço | Raramente: mesmo preço por vários lançamentos, depois uma mudança de patamar | Frequente: novos preços na maioria dos lançamentos, reduções em poucas semanas | A cada geração, além de aumentos programados | Frequente: novos preços na maioria dos lançamentos, além de promoções e tarifas por horário |
| Preços de lançamento | Um preço promocional (Sonnet 5), que se tornou permanente | Reduzidos logo após o lançamento (família GPT-5.6) | Promocionais, com aumento já anunciado | Promoções de lançamento (V3, V4 Pro); a do V4 Pro se tornou permanente |
| Justificativa para os aumentos | Inteligência (Claude 3.5 Haiku) | Capacidade (GPT-5.2) | Valor, uma vez (2.5 Flash); geralmente nenhuma | Alocação de recursos (preços de pico) |
| Justificativa para as reduções | Acesso, depois menor custo de inferência | Eficiência de inferência e cache | Nenhuma; preços promocionais em vez de reduções | Menor custo de inferência com nova arquitetura |
| Modelo de baixo custo, out. de 2026 | $0.10 / $0.50 | $0.10 / $0.50 | $0.30 / $2.50 | $0.30 / $1.20 no horário de pico, metade fora de pico |
Os preços acompanharam o posicionamento de cada modelo pelo laboratório, não um valor fixo por categoria: modelos que atingiam pontuações de modelos principais tinham preços próximos aos deles, e laboratórios que conseguiam reduzir o custo de servir um modelo baixavam seu preço.
Como o preço mudou em cada categoria?
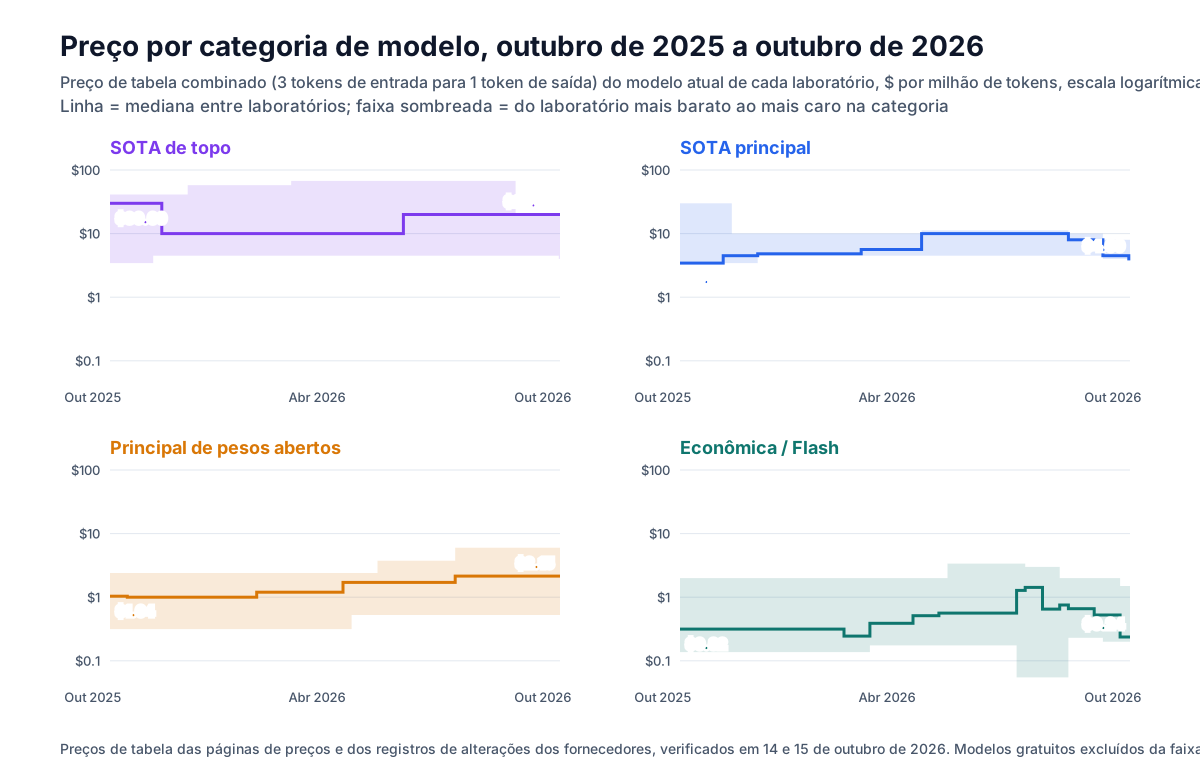
Os preços dos modelos principais fechados se aproximaram, os modelos principais de pesos abertos ficaram mais caros, e a categoria econômica terminou mais barata após um pico no meio do ano. Os modelos atuais de cada laboratório se dividem em quatro categorias:
- SOTA de topo: SOTA (estado da arte) abrange os principais laboratórios de modelos fechados, e esta categoria reúne o modelo mais caro de cada um. É uma faixa de preço: o Opus 5.5, um modelo principal, supera os três modelos de topo em pontuação. Quando o modelo de topo de um laboratório também é seu modelo principal, ele aparece nas duas categorias (hoje, o Gemini 4 Argon).
- SOTA principal: o modelo de uso geral principal de cada laboratório de modelos fechados.
- Principal de pesos abertos: o modelo principal de cinco laboratórios cujos pesos qualquer pessoa pode baixar e hospedar.
- Econômica / Flash: a linha de baixo custo de cada laboratório, com o nome inspirado nos modelos Flash do Google.
O gráfico mostra, em escala logarítmica, o preço combinado mediano de cada categoria entre os laboratórios como uma linha, e a faixa entre o menor e o maior preço como uma banda. A diferença de preços na tabela considera apenas a entrada.
| Categoria | Modelos em 15 de out. de 2026 | Preço combinado mediano, out. de 2025 | Preço combinado mediano, out. de 2026 | Razão entre preços de entrada (maior ÷ menor), out. de 2025 | Razão entre preços de entrada, out. de 2026 |
|---|---|---|---|---|---|
| SOTA de topo | Claude Fable 5.1, GPT-6 Astra, Gemini 4 Argon | $30.00 | $20.00 | 12x | 5x |
| SOTA principal | Claude Opus 5.5, GPT-6.1 Sol, Gemini 4 Argon | $3.44 | $4.00 | 12x | 2x |
| Principal de pesos abertos | GLM-5.3, Kimi K3, Qwen3.8 Max, DeepSeek V4 Pro, MiniMax M3 | $1.04 | $2.15 | 4.3x | 10x |
| Econômica / Flash | Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite, DeepSeek V4.1 Flash, GLM-5.3 Flash, Qwen3.8 Flash | $0.32 | $0.24 | 20x | 7.5x |
- SOTA de topo: os modelos pro da OpenAI passaram do GPT-5 Pro a $15 / $120 para o GPT-5.4 Pro a $30 / $180, até que o GPT-6 Astra reposicionou a linha em $10 / $50, o mesmo preço do Claude Fable 5.1. O Google cobra, por enquanto, $2 / $10 pelo Argon, o que explica toda a diferença atual de 5x.
- Principal de pesos abertos: o preço mediano de entrada mais que dobrou, de $0.60 para $1.40, e os preços se distanciaram: o Kimi K3, a $3 / $15, custa mais que o Claude Sonnet 5.5, enquanto o MiniMax M3 manteve $0.30 / $1.20 ao longo de cinco lançamentos. O preço mediano de saída dos modelos de pesos abertos passou de 24% para 44% da mediana dos modelos principais fechados. O DeepSeek V4 Pro entra na conta com seu preço de pico.
- Econômica / Flash: a mediana subiu para $0.56 de maio a julho, com o lançamento de modelos de baixo custo como Gemini 3.1 Flash-Lite e Qwen3.6 Flash a $0.25 / $1.50. A queda veio principalmente em outubro, quando o Haiku 5.5 igualou o preço do GPT-6 Luna, de $0.10 / $0.50.
O GPT-5.6 Terra fica fora da categoria econômica porque custa tanto quanto um modelo principal. Os dados cobrem oito laboratórios; xAI e Mistral não estão incluídos.
Quanto custa hoje um determinado nível de capacidade?
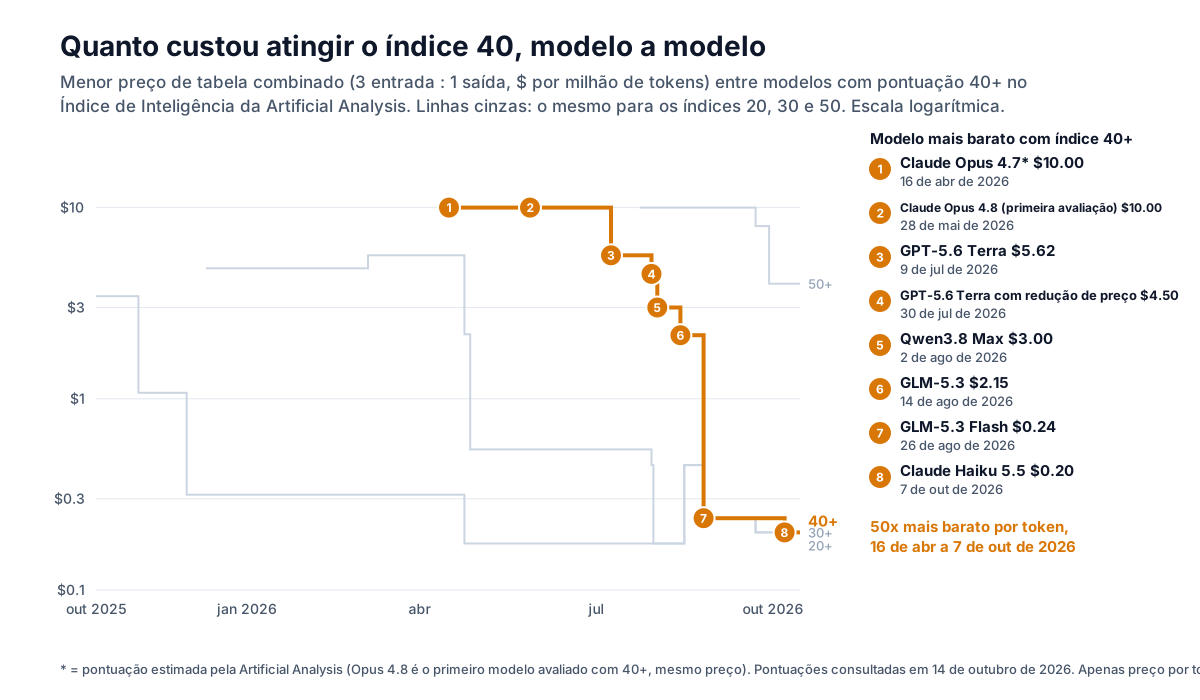
O modelo mais barato em cada nível do índice ficou de 2.5 a 50 vezes mais barato por token, e de 8 a 19 vezes mais barato por tarefa nos casos em que há dados por tarefa nas duas pontas. O custo por tarefa é o valor informado pela Artificial Analysis para executar uma tarefa do índice ao preço de tabela, usando o consumo real de tokens de cada modelo. Para cada dia, selecionamos o modelo atual mais barato com pelo menos 20, 30, 40 ou 50 pontos na versão 4.3.2 do índice, sempre na maior configuração de raciocínio.
| Nível do índice | Modelo mais barato quando o nível foi atingido pela primeira vez entre out. de 2025 e out. de 2026, $ combinados por milhão de tokens | Mais barato hoje | Redução por token | Redução por tarefa |
|---|---|---|---|---|
| 20 | Início do período, out. de 2025: GPT-5*, $3.44 | Claude Haiku 5.5 ou GPT-6 Luna, $0.20 | 17x | não publicado para GPT-5 |
| 30 | Dez. de 2025: GPT-5.2*, $4.81 | Claude Haiku 5.5 ou GPT-6 Luna, $0.20 | 24x | não publicado para GPT-5.2 |
| 40 | Abr. de 2026: Claude Opus 4.7*, $10 | Claude Haiku 5.5, $0.20 | 50x | 19x, de $4.08 no Opus 4.8 (primeiro com dados por tarefa) para $0.21 no Haiku 5.5 |
| 50 | Jul. de 2026: Claude Opus 5, $10 | GPT-6.1 Sol ou Gemini 4 Argon, $4 | 2.5x | 8.1x, de $5.86 no Opus 5 para $0.72 no GPT-6.1 Sol |
* Pontuação estimada pela Artificial Analysis, não medida. O primeiro modelo com medição no nível 40, Opus 4.8 em maio, tinha o mesmo preço de tabela de $10.
O menor preço não caiu de forma contínua: do fim de abril a meados de agosto, o nível 20 do índice custava $0.175 no DeepSeek V4 Flash, abaixo dos $0.20 atuais.
Os modelos com as maiores pontuações não ficaram baratos. Há um ano, os dois primeiros eram GPT-5 e Opus 4.1, com pontuações estimadas de 23.0 e 22.8 e preços combinados de $3.44 e $30. Hoje, o líder é o Claude Opus 5.5, com 57.6 pontos a $8 combinados. As grandes quedas ocorrem em níveis que só o melhor modelo alcançava poucos meses antes.
Por que os preços mudaram assim?
Além do que os laboratórios disseram sobre seus próprios preços, três movimentos do mercado coincidem com essas mudanças e atuam em direções diferentes. Como se sobrepõem no tempo, os dados não permitem isolar seus efeitos.
Demanda e capacidade de inferência. Quando a demanda supera a capacidade das GPUs disponíveis para responder às requisições, o provedor pode limitar o uso ou cobrar mais nos horários de pico. O OpenRouter, um marketplace que encaminha requisições de API a vários provedores de hospedagem de modelos, passou de cerca de 5 trilhões de tokens por semana em abril de 2025 para mais de 20 trilhões em abril de 2026, com programação passando de cerca de 11% do tráfego para mais da metade (Wing VC). A Anthropic retirou os limites de horário de pico das assinaturas Claude depois de obter acesso ao data center Colossus 1 da xAI em 6 de maio. Entre as mudanças nos preços de API no mesmo período estão o GPT-5.5 a $5 / $30 em abril, os aumentos programados do Google, que declarou estar com “restrições de capacidade”, e os preços de pico da DeepSeek.
Concorrência e piso de preço. A participação dos modelos chineses de pesos abertos nos tokens do OpenRouter subiu de cerca de 2% no fim de 2024 para cerca de 61% em maio de 2026 (Wing VC), mas o tráfego direto, como o do ChatGPT, é muito maior que o do roteador. Em junho, o Wall Street Journal noticiou que a OpenAI avaliava cortes de preço antes de reduções esperadas da Anthropic (Decrypt), e ambas lançaram modelos mais baratos em 22 de setembro. O piso de preço, o menor preço em um nível de capacidade, foi do DeepSeek V4 Flash do fim de abril até o aumento da DeepSeek em agosto, quando passou ao Claude Haiku 5.5 e ao GPT-6 Luna.
Receita dos laboratórios de pesos abertos. Pesos abertos permitem que qualquer provedor venda acesso ao mesmo modelo. Depois que a Zhipu lançou o GLM-5.3 Flash, a participação de sua própria API no tráfego desse modelo no OpenRouter caiu de 88% para 22% em três semanas. A Epoch AI, um grupo de pesquisa em IA, estima que a DeepSeek recebe cerca de 8% dos gastos no OpenRouter com modelos DeepSeek (Huxiu via Weijin Research). Esses dados são posteriores à maior parte da alta dos preços dos modelos de pesos abertos; portanto, são compatíveis com ela, mas não a explicam. Os provedores de hospedagem não têm cobrado muito menos pelos modelos principais mais novos: em 16 de outubro, o preço do próprio laboratório era o mais comum para o GLM-5.3 (15 de 44 provedores) e o Kimi K3 (7 de 25). Dos 15 provedores mais baratos do Kimi K3, 12 usavam pesos quantizados em 4 bits, uma versão comprimida cujas respostas podem diferir das do original.
Por que o preço por token não é o preço por tarefa?
Dois modelos com o mesmo preço de tabela podem ter custos por tarefa várias vezes diferentes. A principal razão são os tokens de raciocínio: o raciocínio passo a passo oculto que o modelo escreve antes de responder, cobrado como saída. A Artificial Analysis publica o custo médio de cada modelo por tarefa do índice ao preço de tabela.
| Comparação | Preço de tabela, $ por milhão de tokens (entrada / saída) | Custo médio por tarefa do índice |
|---|---|---|
| Claude Haiku 5.5 vs GPT-6 Luna | ambos $0.10 / $0.50 | $0.21 vs $0.07 |
| Gemini 4 Argon vs GPT-6.1 Sol | ambos $2 / $10 | $1.99 vs $0.72 |
| Qwen3.8 Max vs GPT-6.1 Sol | $2 / $6 vs $2 / $10 | $5.41 vs $0.72 |
O Qwen3.8 Max tem o menor preço de saída entre os dois modelos comparados e custa 7.5 vezes mais por tarefa. Nosso próprio teste mediu um custo por resposta correta do Argon 3.1 vezes maior que o do GPT-6.1 Sol (custo da API do Gemini 4 Argon). Para comparar modelos com seu próprio tráfego, calcule o custo de um lote de requisições reais a partir da contagem de tokens de cada resposta (tokens de raciocínio são cobrados como saída), divida o total pelo número de respostas aceitáveis e compare os modelos por esse custo por resposta.
Como os preços de cache mudaram em relação à entrada?
As leituras de cache (os cache hits descritos na seção sobre a DeepSeek) ficaram mais baratas em relação à entrada nos modelos principais e de topo dos laboratórios de modelos fechados, e as escritas de cache ficaram mais caras em dois fornecedores. A tabela mostra a tarifa de leitura de cache de cada modelo como porcentagem de seu próprio preço de entrada.
| Categoria | Leitura de cache ÷ entrada, out. de 2025: mediana (faixa) | Out. de 2026: mediana (faixa) | Menor e maior hoje |
|---|---|---|---|
| SOTA de topo | 10% (todos os modelos) | 5% (2.5% a 10%) | Claude Fable 5.1 2.5%, GPT-6 Astra 10% |
| SOTA principal | 10% (todos os modelos) | 5% (todos os modelos) | Claude Opus 5.5, GPT-6.1 Sol e Gemini 4 Argon, todos 5% |
| Principal de pesos abertos | 18% (10% a 25%) | 12.5% (3.3% a 20%) | DeepSeek V4 Pro 3.3%, MiniMax M3 20% |
| Econômica / Flash | 10% (todos os modelos) | 10% (2% a 20%) | DeepSeek V4.1 Flash 2%, GLM-5.3 Flash 20% |
Os modelos principais fechados reduziram pela metade a tarifa de leitura de cache em três semanas: Opus 5.5 em 22 de setembro, GPT-6.1 Sol em 29 de setembro e Argon em 13 de outubro. Os laboratórios de pesos abertos cobram uma proporção maior, com exceção da DeepSeek, embora os 3.3% do V4 Pro resultem de um preço de entrada maior, não de uma leitura de cache mais barata. A MiniMax passou de 10% para 20% com o M2.7 em março. Os modelos que não listavam preço de cache ficaram de fora.
A cobrança pela escrita de cache, a requisição que armazena um prefixo pela primeira vez, mudou em dois fornecedores. A OpenAI passou a cobrá-la com o GPT-5.6 em julho: 1.25 vezes o preço de entrada para o cache padrão de 30 minutos e, a partir de 20 de outubro, 2.5 vezes para um cache de 12 horas. O Kimi K3 continua cobrando a escrita padrão de 5 minutos ao preço de entrada, como o Kimi K2, mas adicionou um cache opcional de 1 hora a 2 vezes esse preço. A Anthropic continua cobrando 1.25 vezes para um cache de 5 minutos e 2 vezes para um cache de 1 hora, e Google, DeepSeek e Zhipu continuam sem cobrar nada a mais. O guia de escrita de cache explica quando uma escrita compensa.
O que fazer com esses dados?
Planeje o orçamento por capacidade e por tarefa, não pelo nome da linha, e teste novamente os modelos pequenos.
| Carga de trabalho | O que verificar | Candidatos e números |
|---|---|---|
| Extração, classificação e roteamento em alto volume | Se um modelo pequeno de 2026 atende ao seu critério de qualidade | Claude Haiku 5.5 marca 43.4 e GPT-6 Luna marca 38.1 a $0.10 / $0.50; há um ano, nenhum modelo nos dados passava de 23 |
| Agentes e raciocínio longo | Custo por tarefa concluída | GPT-6.1 Sol a $0.72 por tarefa do índice, Gemini 4 Argon a $1.99 com o mesmo preço de tabela |
| Trabalho que exige alta capacidade | Se você precisa do nível 50 ou do melhor modelo disponível | O nível 50 custa $4 combinados no GPT-6.1 Sol, ou no Argon até 1 de dezembro; o Claude Opus 5.5, com 57.6 pontos, custa $8 |
| Planejar o orçamento pelo preço de lançamento | Por quanto tempo o preço vai durar | Os preços introdutórios do Google têm aumentos programados (Argon em 1 de dezembro, Gemini 3.8 Flash em 1 de janeiro); a OpenAI reduziu os preços de lançamento dos três modelos GPT-5.6 em até seis semanas; a Anthropic manteve os preços entre lançamentos e os reduziu com novos modelos |
| Processamento em lote na DeepSeek | Se o trabalho pode rodar fora do horário de pico | O DeepSeek V4.1 Flash custa metade fora do horário comercial de Pequim: $0.15 / $0.60 contra $0.30 / $1.20 |
| Modelos principais de pesos abertos para reduzir custos | Os preços dos provedores para o modelo exato e a precisão dos pesos | 12 dos 15 provedores que vendem Kimi K3 abaixo do preço da Moonshot usam pesos quantizados em 4 bits |
Perguntas frequentes
Os preços das APIs de LLM estão caindo em 2026? Os preços por token das APIs de LLM subiram na maioria dos casos: o preço de tabela de entrada aumentou em 10 das 14 linhas de modelos comparadas entre outubro de 2025 e outubro de 2026. Por unidade de capacidade, os preços caíram: o modelo mais barato com 40 pontos no Artificial Analysis Intelligence Index custava $10 por milhão de tokens combinados em abril de 2026 e $0.20 em outubro (Claude Haiku 5.5). Por tarefa, o custo ficou 19 vezes menor de maio a outubro.
Qual laboratório de IA mais reduziu os preços de API? A Anthropic foi a que mais reduziu: nos dois anos até outubro de 2026, baixou os preços de tabela nas três categorias, com o Claude Opus 5.5 a $4 / $20, contra $15 / $75 do Claude 3 Opus, e o Claude Haiku 5.5 a $0.10 / $0.50. O Google aumentou os preços nas três categorias. Na OpenAI, os preços combinados dos modelos principal e pequeno terminaram com variação de até 25% em relação a outubro de 2024, enquanto o preço da linha intermediária subiu 17 vezes.
Leituras relacionadas
- Custo da API do Gemini 4 Argon: o mesmo preço de tabela do GPT-6.1 Sol, 3.1x por resposta correta
- Faixas de preço para contexto longo: em que tamanho de prompt o preço de cada fornecedor sobe
- Quanto custa uma escrita de cache de prompt: preços de escrita e leitura por fornecedor
- Custo do Claude Haiku 5.5: o limite de preço de 100,000 tokens, medido
- Custo do Kimi K3: um modelo principal de pesos abertos a preço de modelo fechado