
Claude Haiku 5.5: 1 token além de 100 mil custa 5x mais
Conteúdo
- Como medimos
- Quanto custa o Claude Haiku 5.5 de cada lado do limite?
- Tokens em cache e tokens de saída contam para o limite de 100,000?
- 100,000 tokens representam a mesma quantidade de texto que no Claude Haiku 4.5?
- O que acontece quando o contexto de um agente ultrapassa o limite?
- Como manter um agente abaixo do limite?
- Ele custa menos que o GPT-6 Luna com o mesmo preço de tabela?
- Perguntas frequentes
- Quanto custa o Claude Haiku 5.5?
- Tokens em cache contam para o limite de 100,000 tokens do Claude Haiku 5.5?
- O Claude Haiku 5.5 custa menos que o Claude Haiku 4.5?
- O Claude Haiku 5.5 custa menos que o GPT-6 Luna?
- Como manter as requisições ao Claude Haiku 5.5 abaixo de 100,000 tokens?
- Leituras relacionadas
O Claude Haiku 5.5 tem duas tabelas de preços. O tamanho do prompt determina qual delas vale para a requisição inteira. Enviamos um prompt com exatamente 100,000 tokens e pagamos $0.0100. Com mais um token, o custo foi $0.0500. O prompt inclui tudo o que você envia: prompt de sistema, definições de ferramentas e mensagens. Inclui também os tokens lidos do cache de prompts. A tabela de preços da Anthropic não deixa isso explícito, mas confirmamos na própria fatura da Anthropic.
TL;DR
- Um prompt de 100,000 tokens no Claude Haiku 5.5 custou $0.010008. Com 100,001 tokens, custou $0.050041, cinco vezes mais.
- Um prompt de 102,011 tokens, com 94% deles lidos do cache, foi cobrado pela tabela mais cara: $0.0078, contra $0.0016 pela tabela mais barata.
- O mesmo texto em inglês gera de 1.4 a 1.5 vezes mais tokens no Haiku 5.5 do que no Claude Haiku 4.5.
- Em um loop de agente, seis requisições acima do limite responderam por 76% de uma execução de $0.083. Compactar o contexto ou usar um subagente reduziu o custo para $0.026 ou $0.016.
Como medimos
A maioria das requisições passou pelo gateway da Synthorai em 8 e 9 de outubro de 2026. Aqui, “cobrado” é o valor que o gateway cobrou por requisição. Ele aplica as duas tabelas de preços da Anthropic e calcula o tamanho do prompt somando três contagens de entrada na resposta: tokens de entrada sem cache, leituras do cache e gravações no cache. Todos os 581 valores cobrados que conferimos batiam com uma das duas tabelas até a sexta casa decimal.
A página de preços da Anthropic diz apenas que o modelo tem o preço definido pelo tamanho do prompt, e a resposta da API não informa o preço. Por isso, enviamos também 23 dos mesmos prompts diretamente à API da Anthropic e consultamos no Anthropic Console o custo do dia para o modelo: $0.33. Essas requisições somam $0.3301 se todo prompt acima de 100,000 tokens paga a tabela mais cara, com ou sem cache. Se as leituras do cache não contarem, a soma é $0.2678. A Anthropic cobra da mesma forma que o gateway.
Quanto custa o Claude Haiku 5.5 de cada lado do limite?
Acima de 100,000 tokens no prompt, cada item da tabela custa cinco vezes mais. Os preços são por milhão de tokens.
| Prompt de até 100,000 tokens | Prompt acima de 100,000 tokens | Claude Haiku 4.5 | |
|---|---|---|---|
| Entrada | $0.10 | $0.50 | $1.00 |
| Saída | $0.50 | $2.50 | $5.00 |
| Leitura do cache | $0.01 | $0.05 | $0.10 |
| Gravação no cache, 5 minutos | $0.125 | $0.625 | $1.25 |
| Entrada / saída em lote | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 |
A gravação no cache acontece na primeira requisição que armazena um prefixo do prompt. A leitura acontece em uma requisição posterior que reutiliza esse prefixo. O Batch é a API assíncrona da Anthropic, com preço pela metade.
A tabela mais cara vale para a requisição inteira, não apenas para os tokens acima do limite. Montamos um prompt de 99,872 tokens e acrescentamos um ou dois tokens por vez:
| Tokens no prompt | Cobrado | Tabela |
|---|---|---|
| 99,998 | $0.010008 | mais barata |
| 100,000 | $0.010008 | mais barata |
| 100,001 | $0.050041 | mais cara |
| 100,002 | $0.050041 | mais cara |
Exatamente 100,000 tokens ainda ficam na tabela mais barata, como indica a expressão “acima de 100,000”. Segundo a Anthropic, prompts de até 100,000 tokens representavam cerca de 90% das requisições ao Claude Haiku 4.5. Por token, o novo modelo custa 90% menos que o anterior abaixo do limite e 50% menos acima dele.
Tokens em cache e tokens de saída contam para o limite de 100,000?
Tokens em cache contam; tokens de saída, não. Armazenamos no cache um prefixo de 96,045 tokens e depois o reenviamos com trechos finais de tamanhos diferentes:
| Requisição | Tokens no prompt | Lidos do cache | Cobrado | Tabela |
|---|---|---|---|---|
| prefixo, primeira vez (gravado no cache) | 96,058 | 0 | $0.012009 | mais barata |
| prefixo novamente | 96,058 | 96,045 | $0.000964 | mais barata |
| prefixo e trecho final de 1,000 tokens | 97,034 | 96,045 | $0.001061 | mais barata |
| prefixo e trecho final de 6,000 tokens | 102,011 | 96,045 | $0.007795 | mais cara |
Na última requisição, 94% dos tokens vieram de leituras do cache, mas ela foi cobrada pela tabela mais cara: $0.0078, contra $0.0016 pela mais barata. Quanto à saída, um prompt de 97,864 tokens com uma resposta de 1,905 tokens custou $0.010739, pela tabela mais barata.
Para comparar com o limite, some três campos da resposta. Antes do envio, o endpoint de contagem de tokens aceita os mesmos system, tools e messages da requisição:
import anthropic

client = anthropic.Anthropic()

# after a request: the length the price list is chosen by
u = response.usage
prompt_tokens = u.input_tokens + u.cache_read_input_tokens + u.cache_creation_input_tokens

# before a request
count = client.messages.count_tokens(model="claude-haiku-5-5", system=system, tools=tools, messages=messages)
over_the_line = count.input_tokens > 100_000
100,000 tokens representam a mesma quantidade de texto que no Claude Haiku 4.5?
Não. O Claude Haiku 5.5 usa um tokenizador mais novo. É ele que divide o texto nas unidades usadas para a cobrança, e o mesmo texto gera mais tokens do que no Claude Haiku 4.5. O guia de migração da Anthropic fala em “aproximadamente 30% mais”. Contamos cinco amostras nos dois modelos:
| Texto | Haiku 4.5 | Haiku 5.5 | Proporção | 100,000 no Haiku 5.5 equivalem, no Haiku 4.5, a |
|---|---|---|---|---|
| Texto em inglês (relatório do NIST, 12 páginas) | 6,478 | 9,618 | 1.48 | 67,353 |
| Artigo científico, 6 páginas | 4,352 | 6,048 | 1.39 | 71,958 |
| Código-fonte JavaScript | 8,802 | 11,814 | 1.34 | 74,505 |
| Código-fonte Python | 9,743 | 12,144 | 1.25 | 80,229 |
| Markdown com chinês e inglês | 13,351 | 14,710 | 1.10 | 90,761 |
Um texto em inglês que tinha 68,000 tokens no Haiku 4.5 já chega ao limite no Haiku 5.5. Um orçamento de tokens calculado no modelo antigo, portanto, posiciona o limite no lugar errado. A economia por documento também é menor que a economia por token: com 1.48 vezes mais tokens, um texto em inglês custa 85% menos que no Haiku 4.5 abaixo do limite e 26% menos acima dele.
O que acontece quando o contexto de um agente ultrapassa o limite?
A requisição que cruza o limite custa cerca de cinco vezes mais que a anterior, e todas as seguintes continuam nesse patamar. Um loop de agente reenvia a conversa inteira a cada turno. Se o prompt cresce com mais um resultado de ferramenta por turno, acaba chegando a 100,000 tokens.
Executamos um agente no Claude Haiku 5.5 que lê 20 arquivos de log, com cerca de 7,000 tokens cada, usando a ferramenta read_file e informa um total calculado a partir deles. Todos os resultados da ferramenta permanecem na conversa, e o prefixo fica em cache, como costuma acontecer nesses loops. Estas são as requisições 15 a 18 de uma execução:
| Requisição | Tokens no prompt | Lidos do cache | Cobrado |
|---|---|---|---|
| 15 | 92,701 | 85,593 | $0.001787 |
| 16 | 99,705 | 92,699 | $0.001845 |
| 17 | 106,744 | 99,703 | $0.009598 |
| 18 | 113,771 | 106,742 | $0.009942 |
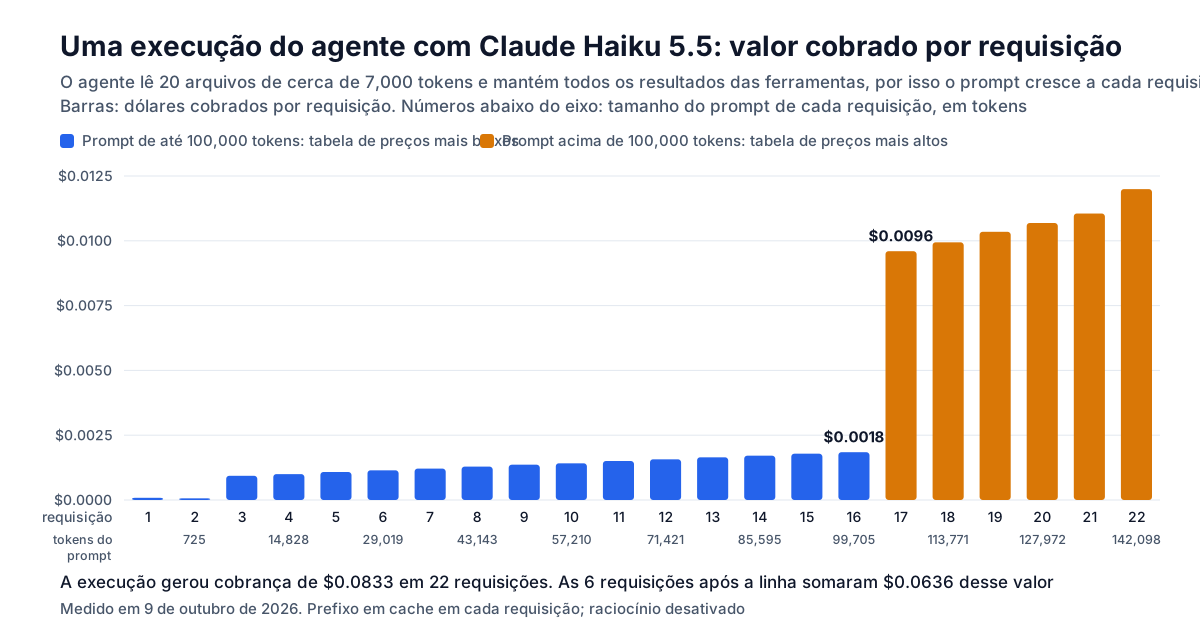
A requisição 17 tem 7,000 tokens a mais que a 16 e custa 5.2 vezes mais. A execução fez 22 requisições e custou $0.0833. As seis requisições acima do limite responderam por $0.0636, ou 76% do total. Os mesmos tokens, pela tabela mais barata, teriam custado $0.0324.
Como manter um agente abaixo do limite?
Não deixe os resultados antigos das ferramentas se acumularem na conversa principal. Executamos a mesma tarefa de quatro formas no Claude Haiku 5.5, com cinco execuções de cada uma. Todas começaram com o cache vazio:
| Abordagem | Total correto | Custo por execução (mediana) | Requisições | Maior prompt |
|---|---|---|---|---|
| Manter tudo | 5 de 5 | $0.0823 | 22 | 142,119 |
| Compactar aos 80,000 tokens | 5 de 5 | $0.0261 | 23 | 92,829 |
| Remover resultados antigos das ferramentas | 3 de 5 | $0.0228 | 22 | 10,278 |
| Um subagente lê cada arquivo | 5 de 5 | $0.0156 | 42 | 7,100 |
- Compactação. Quando o prompt passa de 80,000 tokens, uma requisição extra pede ao modelo um resumo do andamento, e a conversa recomeça a partir dele. Deixe uma margem ao definir o limite: o próximo resultado de ferramenta também precisa caber nos 100,000 tokens.
- Remoção dos resultados antigos. Antes de cada requisição, todos os resultados de ferramentas, exceto o mais recente, são substituídos por uma linha. Duas das cinco execuções deram um total errado depois de um erro aritmético no acumulado que o modelo mantinha nas respostas. Cinco execuções não bastam para concluir que essa abordagem é menos confiável (3 de 5 contra 5 de 5 não é uma diferença significativa), mas mostram o risco: depois que a fonte é removida, não há como corrigir o erro.
- Subagente. A ferramenta do agente principal envia cada arquivo a uma requisição separada, que devolve uma linha. Foi a opção mais barata, fez mais requisições e levou cerca de um quarto a mais de tempo. A requisição separada só vê o que recebe, então suas instruções precisam especificar o que procurar com a mesma precisão das instruções do agente principal.
Nas quatro abordagens, desativamos o modo de raciocínio. Ele corresponde ao trabalho interno do modelo antes da resposta e vem ativado por padrão nesse modelo. Segundo o guia de migração da Anthropic, uma requisição que reenvia blocos de raciocínio depois que uma mensagem anterior foi alterada retorna erro 400. Em contas criadas antes de 31 de agosto de 2026, isso só acontece se a verificação tiver sido ativada. Portanto, ao remover resultados antigos, é preciso desativar o modo de raciocínio ou deixar de fora os blocos de raciocínio. A compactação e os subagentes iniciam uma conversa nova e evitam o problema.
Ele custa menos que o GPT-6 Luna com o mesmo preço de tabela?
Não nos nossos testes: com a mesma taxa de acerto, custou cerca de duas vezes mais. O GPT-6 Luna tem os mesmos preços de tabela, $0.10 e $0.50, sem mudança conforme o tamanho do prompt.
Nos números da própria Anthropic, o Claude Haiku 5.5 supera o GPT-6 Luna em benchmarks de agentes e fica muito à frente do Claude Haiku 4.5:
| Benchmark (anúncio da Anthropic) | O que avalia | Haiku 5.5 | GPT-6 Luna | Haiku 4.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | tarefas de trabalho intelectual, pontuação Elo | 1620 | 1437 | 735 |
| OSWorld 2.1, subconjunto offline | uso de um computador | 72.4% | 48.9% | 15.7% |
| Terminal-Bench 4.0 | tarefas de programação no terminal | 39.2% | 16.4% | 0.0% |
Testamos os três modelos com as configurações padrão, além do Haiku 5.5 com o modo de raciocínio desativado. Usamos dois conjuntos menores com respostas verificáveis: 96 itens de classificação, extração e encaminhamento para ferramentas, tarefas que a Anthropic cita para esse modelo, e 14 tarefas com várias etapas, executadas três vezes cada.
| Modelo | Itens curtos corretos, de 96 | Custo por 1,000 chamadas | Tarefas com várias etapas corretas, de 42 | Custo por resposta correta |
|---|---|---|---|---|
| Claude Haiku 5.5 | 95 | $0.107 | 39 | $0.00103 |
| Claude Haiku 5.5, modo de raciocínio desativado | 94 | $0.069 | 33 | $0.00036 |
| GPT-6 Luna | 95 | $0.049 | 38 | $0.00043 |
| Claude Haiku 4.5, sem raciocínio estendido | 94 | $0.679 | 10 | $0.01053 |
O custo por resposta correta é o gasto total dividido pelo número de respostas certas. A taxa de acerto do Haiku 5.5 e do GPT-6 Luna ficou no mesmo nível nos dois conjuntos (39 e 38 de 42 são resultados equivalentes), mas o Haiku 5.5 custou pouco mais que o dobro. Nos itens curtos, ele contou 482 tokens de entrada, contra 231 do GPT-6 Luna. Nas tarefas com várias etapas, gerou 1,902 tokens de saída por chamada, contra 759. Em relação ao Haiku 4.5, executado com a configuração padrão, sem raciocínio estendido, custou 84% menos nos itens curtos e acertou cerca de quatro vezes mais tarefas com várias etapas.
O esforço do modo de raciocínio vem em medium por padrão. Essa configuração controla quanto o modelo raciocina, de low a max; thinking: {"type": "disabled"} desativa o modo. Com ele desativado, o resultado nos itens curtos foi equivalente, a dois terços do custo. Nas tarefas com várias etapas, porém, o modelo acertou 6 de 42 respostas a menos e incluiu o raciocínio em todas as respostas que pediam apenas um número. Com esforço max, acertou os mesmos 39 da configuração padrão, pelo dobro do custo.
O Haiku 5.5 ocupa a faixa barata da linha Claude e representa um grande avanço em relação ao Haiku 4.5 por um décimo do preço por token. Em chamadas curtas e de alto volume, o GPT-6 Luna fez o mesmo trabalho pela metade do custo nos nossos testes. O argumento a favor do Haiku 5.5 está nas tarefas de agentes, em que os benchmarks da Anthropic o colocam bem à frente, mas não comparamos os dois nesse cenário, desde que o prompt fique abaixo de 100,000 tokens. Antes de migrar uma carga de trabalho do Haiku 4.5, reconte os tokens dos prompts no novo modelo e remova o que, segundo o guia de migração, faz o Haiku 5.5 retornar erro 400: um orçamento manual de raciocínio, um valor não padrão de temperature, top_p ou top_k, e um turno do assistente preenchido antecipadamente.
Perguntas frequentes
Quanto custa o Claude Haiku 5.5?
Para prompts de até 100,000 tokens, o Claude Haiku 5.5 custa $0.10 por milhão de tokens de entrada e $0.50 por milhão de tokens de saída. Acima de 100,000 tokens no prompt, custa $0.50 e $2.50, aplicados à requisição inteira. Leituras do cache custam $0.01 e $0.05, e a Batch API reduz pela metade os preços de entrada e saída nas duas tabelas.
Tokens em cache contam para o limite de 100,000 tokens do Claude Haiku 5.5?
Sim. Um prompt de 102,011 tokens enviado ao Claude Haiku 5.5, com 96,045 tokens lidos do cache, foi cobrado pela tabela mais cara: $0.0078, contra $0.0016 pela mais barata. O tamanho do prompt é a soma da entrada sem cache, das leituras do cache e das gravações no cache. A tabela de preços da Anthropic não deixa isso explícito, mas dez requisições desse tipo, enviadas diretamente à API dela, foram cobradas pela tabela mais cara na nossa fatura da Anthropic. Tokens de saída não contam.
O Claude Haiku 5.5 custa menos que o Claude Haiku 4.5?
Sim, tanto abaixo quanto acima do limite, mas a diferença é menor do que a tabela de preços sugere: o mesmo texto gera mais tokens no modelo novo. Para textos em inglês, medimos 1.48 vezes mais tokens. Com isso, o Claude Haiku 5.5 custa cerca de 85% menos que o Claude Haiku 4.5 abaixo de 100,000 tokens e cerca de 26% menos acima.
O Claude Haiku 5.5 custa menos que o GPT-6 Luna?
Não nos nossos testes, apesar dos preços de tabela iguais. Em 96 tarefas curtas, o Claude Haiku 5.5 custou $0.107 por 1,000 chamadas com a configuração padrão, contra $0.049 do GPT-6 Luna, com a mesma taxa de acerto. O Haiku 5.5 contou cerca de duas vezes mais tokens de entrada para os mesmos itens e gerou mais tokens de saída.
Como manter as requisições ao Claude Haiku 5.5 abaixo de 100,000 tokens?
Conte os tokens antes do envio e, em loops de agente, evite acumular resultados antigos das ferramentas. Resuma a conversa em uma nota antes de chegar ao limite ou use uma requisição separada para ler cada entrada grande e retornar apenas o resultado. No nosso teste com o Claude Haiku 5.5, essas abordagens reduziram o custo de uma tarefa de $0.082 para $0.026 e $0.016, com a resposta correta em todas as execuções.
Leituras relacionadas
- Faixas de preços para contextos longos: outros modelos cujo preço muda conforme o tamanho do prompt.
- Claude Sonnet 5.5 vs Sonnet 5: esforço e custo por tarefa na faixa acima.
- GPT-6 Luna: quanto custa ajustar o raciocínio: o modelo com o mesmo preço de tabela.
- O tokenizador do Claude Sonnet 5: o tokenizador que o Haiku 5.5 agora também usa.