
Gemini 4 Argon: preço do GPT-6.1 Sol, 3x por resposta correta
Conteúdo
- Quanto custa o Gemini 4 Argon?
- Com quais modelos da OpenAI e da Claude o Gemini 4 Argon compete?
- Como o custo por resposta do Argon se compara ao GPT-6.1 Sol, GPT-6 Astra e Opus 5.5?
- O que cada nível de raciocínio faz?
- O que quebra ao migrar para o Gemini 4 Argon?
- Qual nível de raciocínio usar em cada tipo de carga?
- Perguntas frequentes
- Leituras relacionadas
Gemini 4 Argon cobra os mesmos $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída que o GPT-6.1 Sol. Mas, no nosso conjunto de 13 tarefas de raciocínio, seu custo por resposta correta foi 3.1x maior ($0.0063 contra $0.0020, dividindo o gasto total pelo número de acertos). O motivo: gerou 3.3x mais tokens de saída para obter a mesma pontuação, com 38 acertos em 39 chamadas. Contra os modelos de ponta usados pelo Google nos benchmarks, a ordem se inverte: o custo do Argon foi 0.76x o do Claude Opus 5.5 e 0.6x o do GPT-6 Astra, até seu preço dobrar em 1 de dezembro. O principal controle de custo é thinking_level, um parâmetro da requisição que define quanto tempo o gemini-4-argon raciocina antes de responder (low, medium por padrão, high). Tokens de raciocínio são cobrados como saída mesmo quando não aparecem na resposta. Medimos os três níveis dois dias após o lançamento da API, com os modelos de comparação e o Gemini 3.1 Pro testados no mesmo dia.
TL;DR
- Gemini 4 Argon custa $2/$10 por milhão de tokens até 30 de novembro de 2026, depois $4/$20.
- O Google compara o Argon com GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5; o Argon lidera 13 das 19 linhas publicadas.
- Em
medium, o Argon custou $0.0063 por resposta correta, o GPT-6.1 Sol $0.0020 e o Opus 5.5 $0.0083; com os preços de dezembro, o Argon passa a $0.0125. - No nível
low, o Argon não relatou raciocínio e acertou 1 de 15 chamadas nas cinco tarefas mais difíceis, contra 14 de 15 emmedium.
Quanto custa o Gemini 4 Argon?
O preço da API do Gemini 4 Argon dobra em 1 de dezembro de 2026. A página de preços do Google lista uma tarifa até 30 de novembro e o preço de tabela a partir dessa data, sem faixa gratuita. Entrada em cache é texto que o servidor já recebeu em uma requisição anterior, como um system prompt repetido, e custa 5% do preço da entrada. Os preços abaixo são em dólares por milhão de tokens:
| Modalidade | Entrada | Saída (inclui raciocínio) | Entrada em cache |
|---|---|---|---|
| Standard, até 30 de novembro | $2.00 | $10.00 | $0.10 |
| Standard, a partir de 1 de dezembro | $4.00 | $20.00 | $0.20 |
| Batch e Flex, até 30 de novembro | $1.00 | $5.00 | $0.05 |
| Priority, até 30 de novembro | $3.60 | $18.00 | $0.18 |
Batch (enviado como job, com resultado em algumas horas) e Flex (capacidade sem garantia de disponibilidade) continuam custando metade da tarifa Standard após 1 de dezembro, e Priority (capacidade reservada) continua em 1.8x. Há três diferenças em relação ao Gemini 3.1 Pro, o modelo de ponta anterior do Google, que custa $2/$12:
- Sem acréscimo por contexto longo. O Gemini 3.1 Pro cobra $4/$18 quando o prompt passa de 200K tokens; o Argon mantém $2/$10 até sua janela de contexto de 1,048,576 tokens, o limite de uma requisição somando entrada, raciocínio e resposta. Pelo preço de tabela, nosso prompt de 709K tokens custou $1.42 no Argon e $2.84 no 3.1 Pro.
- Só cache implícito. O cache explícito, no qual você criava um objeto de cache e pagava pelo armazenamento, foi removido. Prefixos de prompt repetidos entram no cache automaticamente e são cobrados pela tarifa de entrada em cache.
- Saídas acima de 64K exigem outro modo. Uma requisição normal retorna no máximo 65,536 tokens de saída; saídas maiores exigem o modo de execução em segundo plano do Google, no qual o servidor continua gerando em blocos de 64K até chegar a 1M de tokens.
Com quais modelos da OpenAI e da Claude o Gemini 4 Argon compete?
Em capacidade, o Google posiciona o Gemini 4 Argon contra o modelo de ponta de cada laboratório: GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. Em preço, fica uma faixa abaixo: custa os mesmos $2/$10 do GPT-6.1 Sol até 30 de novembro e os mesmos $4/$20 do Opus 5.5 a partir de 1 de dezembro. GPT-6 Astra e Fable 5.1 têm preço de tabela de $10/$50.
O índice de inteligência da Artificial Analysis reúne benchmarks de agentes, programação, conhecimento e ciência executados pela própria Artificial Analysis. Ele também informa quanto custa executar uma tarefa do índice em cada modelo. Nesse índice, o Argon está no mesmo nível do GPT-6 Astra e do Fable 5.1, enquanto o Opus 5.5 lidera por quatro a cinco pontos:
| Modelo | Preço de tabela, $ por milhão de tokens | Na tabela de benchmarks do Google | Pontuação no índice (na configuração máxima do fornecedor) | Custo por tarefa do índice |
|---|---|---|---|---|
| Gemini 4 Argon | 2/10, depois 4/20 | Modelo avaliado | 52.6 | $1.99 |
| GPT-6 Astra | 10/50 | Sim | 52.7 | $3.26 |
| Claude Fable 5.1 | 10/50 | Sim | 53.4 | $7.63 |
| Claude Opus 5.5 | 4/20 | Sim | 57.6 | $5.98 |
| GPT-6.1 Sol | 2/10 | Não | 51.8 | $0.72 |
A tabela do próprio Google, publicada na ficha do modelo Argon, tem 19 linhas. O Argon lidera 13 e empata em uma; o GPT-6 Astra lidera três e o Opus 5.5, duas. Abaixo estão dez das 19 linhas: as maiores diferenças, em trabalho intelectual e contexto longo, e todas as cinco em que o Argon perde, que envolvem programação por várias horas, trabalho no terminal e uso de computador desktop. As pontuações são percentuais; quanto maior, melhor:
| Benchmark | O que testa | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|---|
| Vals Index | Índice composto da Vals AI para trabalho intelectual | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey Legal Agent | Tarefas jurídicas executadas do início ao fim pelo modelo | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | Correção de problemas em repositórios reais | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | Tarefas de engenharia e otimização que duram horas | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | Tarefas em um terminal Linux | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | Treinamento de um modelo em uma GPU em 10 horas | 45.3% | 44.3% | 40.2% | 49.3% |
| Terminal-Bench Science 0.1 | Computação científica no terminal | 57.6% | 68.1% | 52.6% | 63.3% |
| RiemannBench | Problemas matemáticos de nível de pesquisa | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks, 256K a 1M | Percorrer links em um grafo dentro de um contexto longo | 84.2% | 71.8% | 65.0% | 66.8% |
| OSWorld 2.0, offline | Uso de computador desktop | 69.2% | 72.6% | não informado | não informado |
Leia a tabela como uma afirmação do Google, não como uma comparação controlada. Segundo a nota metodológica do Google, o Argon usou o nível máximo de raciocínio. A maioria dos números dos concorrentes vem dos relatórios de avaliação dos próprios fornecedores ou de rankings públicos, com a configuração de raciocínio máxima ou a melhor disponível. Várias pontuações do Argon (DeepSWE, as duas linhas de Terminal-Bench e OSWorld) foram produzidas pelo Google com seu próprio harness de testes, o código que executa e avalia as tarefas, enquanto as dos concorrentes vieram de outras fontes. No Terminal-Bench Science, o programa de avaliação teve seis vezes mais tempo para o Argon.
Como o custo por resposta do Argon se compara ao GPT-6.1 Sol, GPT-6 Astra e Opus 5.5?
Com o mesmo preço por token, o custo por resposta correta do Gemini 4 Argon foi 3.1x o do GPT-6.1 Sol em medium, o nível padrão de ambos, e 7.7x em high. Ambos acertaram 38/39 em medium. Contra os modelos de ponta, ele ainda é mais barato: 0.6x o custo por resposta correta do GPT-6 Astra e 0.76x o do Claude Opus 5.5.
Executamos 13 tarefas de raciocínio cujas respostas foram verificadas por um programa curto, com três execuções de cada uma. Assim, cada combinação de modelo e nível abaixo tem 39 chamadas. Uma chamada conta como correta quando o inteiro final corresponde à resposta esperada. As oito tarefas mais fáceis: somar os primos abaixo de 60, contar o dígito 7 de 1 a 500, resolver um horário de trens, calcular 7 elevado a 222 módulo 1000, aplicar uma regra 40 vezes seguidas, contar números de quatro dígitos distintos e não nulos divisíveis por 11, contar caminhos em uma grade com uma célula bloqueada e contar formas de compor 47 centavos. As cinco mais difíceis, que chamamos de conjunto difícil: aplicar a mesma regra 200 vezes, calcular o resto de 13 elevado a 1001 dividido por 10007, contar caminhos em uma grade 8x8 com três células bloqueadas, escolher quais de 10 itens cabem em um limite de peso e compor 187 centavos com cinco tipos de moeda.
Cada modelo foi testado pelo formato de requisição que oferece seu controle de raciocínio: Argon e Gemini 3.1 Pro pelo formato de chat antigo da OpenAI, adotado por muitos provedores e no qual o controle é reasoning_effort; os modelos GPT pelo formato Responses mais recente da OpenAI; e Opus 5.5 pelo formato próprio da Anthropic, no qual o controle é output_config.effort. Usamos medium e high de cada fornecedor, além de low nos modelos que o oferecem.
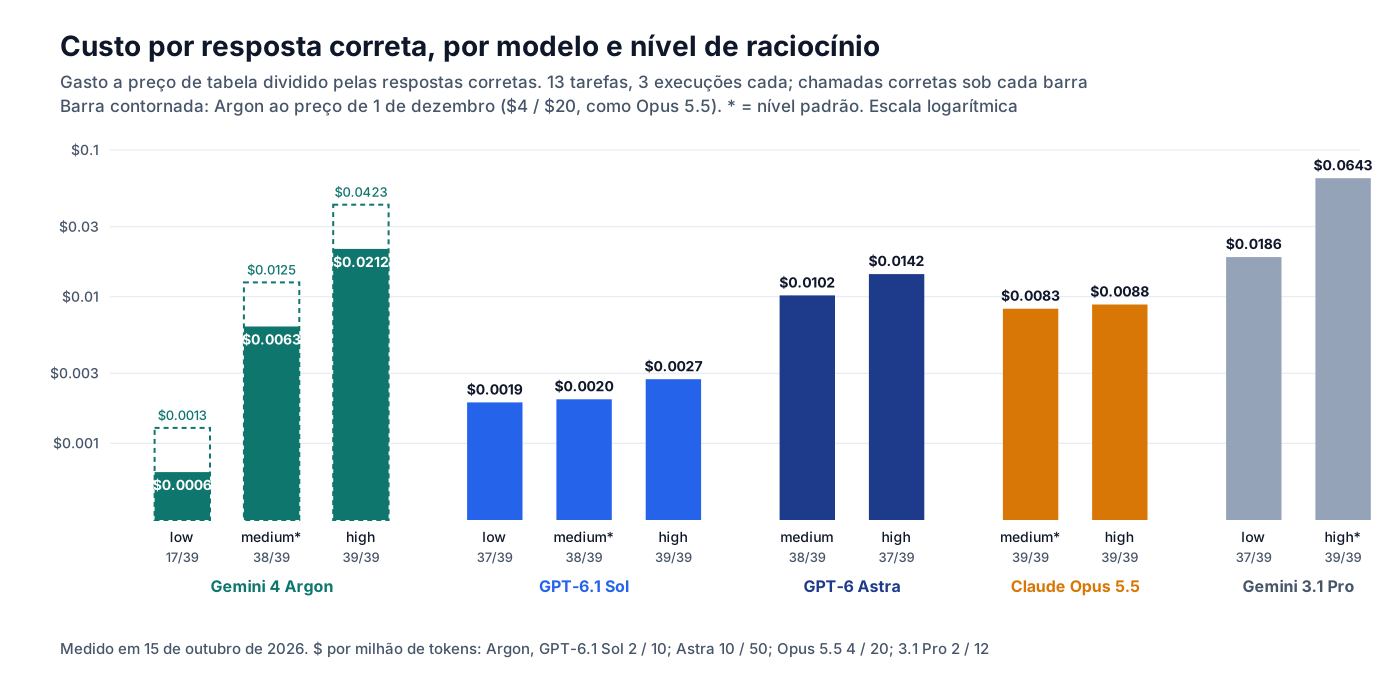
| Modelo e nível | Chamadas corretas (de 24 fáceis / de 15 difíceis) | Mediana de tokens de saída (inclui raciocínio) | Custo por resposta correta | Com o preço do Argon em dezembro |
|---|---|---|---|---|
Argon low | 16/24, 1/15 | 7 | $0.0006 | $0.0013 |
Argon medium (padrão) | 24/24, 14/15 | 383 | $0.0063 | $0.0125 |
Argon high | 24/24, 15/15 | 1,455 | $0.0212 | $0.0423 |
GPT-6.1 Sol low | 24/24, 13/15 | 90 | $0.0019 | |
GPT-6.1 Sol medium (padrão) | 24/24, 14/15 | 81 | $0.0020 | |
GPT-6.1 Sol high | 24/24, 15/15 | 192 | $0.0027 | |
GPT-6 Astra medium (padrão) | 24/24, 14/15 | 90 | $0.0102 | |
GPT-6 Astra high | 24/24, 13/15 | 134 | $0.0142 | |
Claude Opus 5.5 medium (padrão) | 24/24, 15/15 | 188 | $0.0083 | |
Claude Opus 5.5 high | 24/24, 15/15 | 223 | $0.0088 | |
Gemini 3.1 Pro low | 24/24, 13/15 | 1,091 | $0.0186 | |
Gemini 3.1 Pro high (padrão) | 24/24, 15/15 | 3,272 | $0.0643 |
A diferença para o GPT-6.1 Sol vem do tamanho da saída. Nas 39 chamadas em medium, o Argon gerou 22,980 tokens de saída no total, contra 7,032 do GPT-6.1 Sol. Na tarefa mais difícil, 13 elevado a 1001 módulo 10007, a mediana do Argon foi de 1,523 tokens em medium e 6,108 em high; as do GPT-6.1 Sol foram 524 e 901. As pontuações no conjunto difícil foram iguais: 14/15 para cada um em medium e 15/15 em high. A partir de 1 de dezembro, a diferença em medium dobra para 6.3x, porque o preço do Argon dobra e o do GPT-6.1 Sol não.
Dezembro também muda a comparação com o Opus 5.5. Ambos terão preço de tabela de $4/$20 e, no nosso conjunto, o Opus 5.5 gerou menos tokens (15,414 contra 22,980 do Argon em medium) e acertou todas as 39 chamadas. Com o preço de dezembro, o Argon custa $0.0125 por resposta correta, contra $0.0083 do Opus 5.5, ou 1.5x mais; em relação ao GPT-6 Astra, passa de 0.6x para 1.2x. Com 15 chamadas do conjunto difícil por nível, nenhuma diferença de pontuação entre Argon, Opus 5.5 e GPT-6 Astra é estatisticamente distinguível (esses pares foram verificados separadamente do grupo de comparações com correção da próxima seção). Os custos por tarefa da Artificial Analysis colocam os modelos na mesma ordem: GPT-6.1 Sol a $0.72 na configuração máxima, Argon a $1.99 em high e ao preço atual, GPT-6 Astra a $3.26 e Opus 5.5 a $5.98.
Comparado ao Gemini 3.1 Pro, modelo que substitui, o Argon é cerca de 10x mais barato por resposta correta no nível padrão de cada um: $0.0063 contra $0.0643. Parte disso vem do preço, já que o 3.1 Pro cobra $12 por milhão de tokens de saída em vez de $10. Com preços iguais, a diferença é de 8.6x e vem da mediana de 3,272 tokens de saída por chamada do 3.1 Pro, contra 383 do Argon. Após 1 de dezembro, o Argon ainda é 5.1x mais barato nesse conjunto. Também verificamos quantos tokens cada modelo gasta para admitir que não sabe um fato inventado: perguntamos sobre cinco entidades fictícias (o preço da ação de uma empresa, um instituto de pesquisa, o estatuto de uma cidade, uma liga metálica e um prêmio). Ambos se recusaram a responder às cinco, com mediana de 146 tokens de saída no Argon e 1,014 no 3.1 Pro.
O que cada nível de raciocínio faz?
No Gemini 4 Argon, low equivaleu, na prática, a desligar o raciocínio. O Google documenta três níveis e descreve low como o que usa a “menor quantidade de tokens”, acrescentando que “a qualidade pode cair em tarefas difíceis”. Nas 39 chamadas em low, o Argon informou não haver tokens de raciocínio, e sua saída inteira, que nessa rota inclui qualquer raciocínio, foi de 5 a 11 tokens. Uma segunda rota de API, que encaminha as requisições aos servidores do Google, informou explicitamente 0 tokens de raciocínio nas quatro chamadas em low que enviamos. Já o low do Gemini 3.1 Pro ainda gerou uma mediana de 1,091 tokens de saída, quase todos de raciocínio.
Sem raciocínio, o Argon ainda resolveu as tarefas de uma etapa e falhou nas que exigem etapas intermediárias:
- Ainda corretas em
low: a soma dos primos, a contagem de dígitos, o horário de trens, a grade com uma célula bloqueada e os 47 centavos (15 de 15 chamadas). - Erradas em
low: a regra de 40 etapas (0/3), a contagem de números de quatro dígitos (0/3), 7 elevado a 222 (1/3) e 14 de 15 chamadas no conjunto difícil.
A queda se mantém quando cada tarefa conta uma única vez, o que importa porque três execuções da mesma tarefa não são independentes: medium superou low em 8 das 13 tarefas e não perdeu em nenhuma (teste dos sinais, p = 0.008, uma chance inferior a 1% de uma diferença desse tamanho ocorrer por acaso). Apenas no conjunto difícil, low não resolveu nenhuma das cinco tarefas em pelo menos duas das três execuções e medium resolveu todas as cinco (teste exato de Fisher, p = 0.008; 0.047 após a correção de Holm para as seis comparações que executamos). Trate low como um modo sem raciocínio para consultas diretas e conversão de formato. No outro extremo, high custou 3.4x mais por resposta correta que medium e acertou uma chamada a mais entre as 15 do conjunto difícil, uma diferença que esta amostra não permite distinguir do acaso.
O nível padrão se adapta ao prompt. Em prompts simples enviados sem especificar o nível, o Argon, cujo padrão é medium, frequentemente usou zero tokens de raciocínio, enquanto o Gemini 3.1 Pro, cujo padrão é high, raciocinou em todos eles. Na chamada de ferramentas, o modelo pede que seu código execute uma função e você devolve o resultado:
| Tipo de prompt (mediana de 3 execuções) | Tokens de raciocínio do Argon | Tokens de raciocínio do Gemini 3.1 Pro |
|---|---|---|
| Consulta com resposta de uma palavra | 0 | 145 |
| Extração para JSON | 0 | 353 |
| Saída com schema JSON estrito | 0 | 309 |
| Problema com enunciado em duas etapas | 41 | 137 |
| Sequência de cinco operações aritméticas | 68 | 373 |
| Ciclo de chamada de ferramenta, primeiro turno (escolher uma ferramenta) | 0 (31 tokens de saída) | 173 |
| Ciclo de chamada de ferramenta, segundo turno (usar o resultado) | 0 (32 tokens de saída) | 67 |
Os dois modelos responderam corretamente a todos os prompts e chamaram as ferramentas certas. Na API nativa do Google, o nível vai em generation_config e a contagem de raciocínio volta em usage:
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Compute 13 raised to the power 1001, modulo 10007. Reply with a single integer.",
    generation_config={"thinking_level": "medium", "max_output_tokens": 32768},
)
print(interaction.output_text)
print("thinking tokens:", interaction.usage.total_thought_tokens)  # billed at the output rate
print("output tokens:", interaction.usage.total_output_tokens)
No formato de chat compatível com OpenAI que usamos nas medições, o gateway mapeia reasoning_effort para os mesmos três níveis, e a contagem volta em usage.completion_tokens_details.reasoning_tokens.
O que quebra ao migrar para o Gemini 4 Argon?
Prompts que terminam com um turno do assistente pré-preenchido agora falham com HTTP 400, o cache explícito foi removido e as configurações de aleatoriedade (temperature, top_p, top_k) são ignoradas. Pré-preencher significa começar você mesmo a resposta do modelo, por exemplo com uma chave de abertura para forçar JSON. A maioria dessas mudanças está no checklist de migração do Google; o erro de pré-preenchimento, os tokens extras do prompt e o comportamento ao exceder o limite não estão:
| Mudança | Documentação do Google | O que medimos |
|---|---|---|
| Turno do assistente pré-preenchido | Não consta | HTTP 400 no Gemini 4 Argon: “Requisições que terminam com um turno do modelo não são suportadas”; o Gemini 3.1 Pro aceita |
Cache explícito (cachedContents) | Removido | Não testado; o cache implícito funcionou |
| Cache implícito | Desconto de 95%, prompts com 4,096+ tokens | Um prompt repetido de 6,935 tokens teve 4,881 tokens atendidos pelo cache 4 segundos depois, a $0.10 por milhão; um prompt de 3,006 tokens também teve 952 tokens em cache |
temperature, top_p, top_k | Ignorados | Aceitos com HTTP 200 (sem erro) |
| Tokens extras fixos por prompt | Não consta | Cerca de 30 tokens de entrada a mais por requisição que o Gemini 3.1 Pro para texto idêntico; uma segunda rota de API para o Google informa a mesma contagem |
| Prompt acima da janela de 1M | Não consta | HTTP 400 informando o limite, sem truncamento silencioso |
max_output_tokens | Aumentar para 32,768 ou mais | A resposta mais longa do Argon teve 6,391 tokens em high; a do Gemini 3.1 Pro, 21,362 |
Para resolver o erro de pré-preenchimento, mova a instrução para o prompt. Os tokens extras acrescentam $0.00006 por requisição ao preço atual, e a diferença é constante: 27 tokens a mais em um prompt de uma linha e 31 em um documento de 709K tokens em relação ao Gemini 3.1 Pro. Isso indica que o tokenizer, a etapa que divide o texto em tokens, não mudou. Esse prompt de 709K tokens continha 60,000 itens numerados e uma pergunta sobre o item 42 no final; o Argon aceitou o prompt e respondeu 529, o valor inserido para o teste.
Qual nível de raciocínio usar em cada tipo de carga?
Comece com medium, nunca use low para trabalho com várias etapas e inclua o preço de dezembro no orçamento.
| Carga de trabalho | Principal risco | Nível e modelo | Números que sustentam a escolha |
|---|---|---|---|
| Etapas de agentes, chamadas de ferramentas, extração, saída JSON | Pagar por raciocínio em etapas fáceis | Gemini 4 Argon medium; ele já gasta quase nada com raciocínio nesses casos | 0 tokens de raciocínio em consulta, extração, saída com schema e etapas de ferramentas |
| Matemática difícil, algoritmos, código com várias etapas | Respostas erradas | Argon medium; teste high nas suas próprias avaliações antes de pagar por ele | 14/15 contra 15/15 chamadas no conjunto difícil, com high a 3.4x o custo |
| Raciocínio em alto volume, com foco no custo por resposta | Volume de raciocínio | GPT-6.1 Sol, mesma pontuação neste conjunto de 13 tarefas | $0.0020 contra $0.0063 por resposta correta, 6.3x após 1 de dezembro |
| Trabalho de ponta com orçamento para depois de dezembro | Preço do Argon dobrando | Refaça suas avaliações no Claude Opus 5.5, com o mesmo preço de tabela de $4/$20 | $0.0083 contra $0.0125 por resposta correta com os preços de dezembro; o Argon lidera mais linhas de trabalho intelectual do Google |
| Documentos longos, acima de 200K tokens | Acréscimo por contexto longo | Argon em vez de Gemini 3.1 Pro | $1.42 contra $2.84 para um prompt de 709K tokens |
| Apenas consultas diretas e conversão de formato | Raciocínio desnecessário | Argon low | 15/15 nas tarefas de uma etapa, 7 tokens de saída |
Após 1 de dezembro, Batch e Flex custarão o que Standard custa hoje ($2/$10). Mover os jobs offline para essas modalidades mantém os preços de outubro.
Perguntas frequentes
É possível desligar o raciocínio no Gemini 4 Argon?
O Gemini 4 Argon não tem uma configuração documentada para desligar o raciocínio, mas thinking_level: "low" funcionou assim nos nossos testes: nenhum token de raciocínio reportado nas 39 chamadas, cuja saída completa foi de 5 a 11 tokens, e um 0 explícito nas quatro chamadas por uma segunda rota de API para o Google. Em low, acertou 1 de 15 chamadas nas cinco tarefas mais difíceis, contra 14 de 15 no padrão medium.
O Gemini 4 Argon cobra mais por prompts longos? O Gemini 4 Argon cobra a mesma tarifa de $2/$10 para qualquer prompt dentro da janela de 1,048,576 tokens até 30 de novembro de 2026, e $4/$20 depois. O Gemini 3.1 Pro cobra $4/$18 acima de 200K tokens. Pelo preço de tabela, um prompt de 709K tokens custa $1.42 no Argon e $2.84 no 3.1 Pro.
O cache implícito funciona no Gemini 4 Argon? O cache implícito do Gemini 4 Argon atendeu 4,881 tokens de um prompt repetido de 6,935 tokens pelo cache, 4 segundos após a primeira chamada, a $0.10 por milhão de tokens (desconto de 95% sobre a entrada). Também armazenou parte de um prompt de 3,006 tokens, abaixo do mínimo de 4,096 tokens documentado pelo Google.
Leituras relacionadas
- GPT-6.1 Sol vs Claude Sonnet 5.5: o mesmo conjunto de 13 tarefas ao mesmo preço de $2/$10
- Comparação dos controles de raciocínio de LLMs: o que faz o parâmetro de esforço de cada fornecedor
- Mínimos do cache de prompts, medidos: limites mínimos documentados versus reais
- Custo da API do Gemini 3.7 Flash: o lançamento anterior do Gemini com preço introdutório
Medições feitas em 15 de outubro de 2026, dois dias após a disponibilidade geral da API. Níveis de raciocínio: 13 tarefas com respostas verificadas por programa, 3 execuções por modelo e nível, significância testada com cada tarefa contada uma única vez, cada prompt marcado com um ID aleatório para impedir que a resposta viesse de cache; custos calculados pelo preço de tabela a partir das contagens de tokens. Testes de custo adicional do raciocínio, saída estruturada e ferramentas: 3 execuções cada; testes de migração, cache, contexto longo e fatos inventados: chamadas únicas. O resultado de low e os tokens extras do prompt foram confirmados por uma segunda rota de API que encaminha as requisições ao Google. Números da Artificial Analysis consultados em 14 de outubro de 2026; tabela de benchmarks do Google extraída da ficha do modelo Gemini 4 Argon.