
LLM-API-Preise 2026: Token teurer, gleiche Leistung 50x billiger
Inhalt
- Wie haben sich die LLM-API-Listenpreise im vergangenen Jahr verändert?
- Wie haben Anthropic, OpenAI, Google und DeepSeek ihre Modellpreise über zwei Jahre gestaltet?
- Sind die Modelle teurer geworden oder nur leistungsfähiger?
- Wie haben sich die Preise in den einzelnen Kategorien entwickelt?
- Wie unterschieden sich die Preisstrategien der einzelnen Anbieter?
- Wie unterscheidet sich DeepSeeks Preisstrategie?
- Wie unterscheiden sich die vier KI-Labore?
- Wie haben sich die Preise in den einzelnen Kategorien entwickelt?
- Was kostet ein bestimmtes Leistungsniveau heute?
- Warum haben sich die Preise so entwickelt?
- Warum entspricht der Token-Preis nicht den Kosten pro Aufgabe?
- Wie haben sich Cache-Preise im Verhältnis zum Input-Preis verändert?
- Was folgt daraus für die Praxis?
- Häufige Fragen
- Weiterführende Artikel
Zwischen Oktober 2025 und Oktober 2026 stiegen die Token-Listenpreise für LLM-APIs in 10 von 14 Modellreihen. Gleichzeitig wurde das günstigste Modell, das ein bestimmtes Leistungsniveau erreicht, pro Token deutlich billiger: um den Faktor 17 bis 50 bei Indexwerten von 20 bis 40 und um den Faktor 2.5 bei einem Indexwert von 50. Eine Modellreihe ist die Produktlinie eines Anbieters, etwa Claude Opus oder Gemini Flash. Als Leistungsmaß dient der Artificial Analysis Intelligence Index, ein unabhängiger Gesamtindex aus mehreren Benchmarks auf einer Skala von 0 bis 100. Das derzeit beste Modell erreicht 57.6. Die Preise sind Mischpreise in Dollar pro Million Token, gewichtet mit drei Input-Token je Output-Token. Beide Entwicklungen passen zusammen: Jedes neue Modell einer Reihe leistet mehr als sein Vorgänger.
TL;DR
- Von Oktober 2025 bis Oktober 2026 stiegen die Input-Listenpreise in 10 von 14 Modellreihen; die 3 Reihen mit Preissenkungen gehören alle zu Anthropic.
- Das günstigste Modell mit einem Wert von 40 im Artificial Analysis Index kostete im April 2026 $10 pro Million Token im Mischpreis, im Oktober nur noch $0.20.
- Seit Oktober 2024 senkte Anthropic die Preise in allen drei Kategorien (Opus von $15 / $75 auf $4 / $20), Google erhöhte sie in allen drei und OpenAI nur in der Mittelklasse.
- Bei den proprietären Flaggschiffen schrumpfte der Abstand zwischen höchstem und niedrigstem Input-Preis von 12x auf 2x; der Medianpreis der Open-Weight-Flaggschiffe verdoppelte sich.
Wie haben sich die LLM-API-Listenpreise im vergangenen Jahr verändert?
In den meisten Modellreihen kostet ein Token heute mehr als vor einem Jahr. Wir haben für jede Reihe das Modell vom 15. Oktober 2025 mit dem Modell vom 15. Oktober 2026 verglichen:
| Modellreihe | Modell im Okt. 2025, $ pro Million Token (Input / Output) | Modell im Okt. 2026, $ pro Million Token (Input / Output) | Input-Preis, 2026 gegenüber 2025 |
|---|---|---|---|
| OpenAI Flaggschiff | GPT-5, $1.25 / $10 | GPT-6.1 Sol, $2 / $10 | 1.6x |
| OpenAI Mittelklasse | GPT-5 mini, $0.25 / $2 | GPT-5.6 Terra, $2 / $12 | 8x |
| OpenAI Kleinmodell | GPT-5 nano, $0.05 / $0.40 | GPT-6 Luna, $0.10 / $0.50 | 2x |
| Claude Opus | Opus 4.1, $15 / $75 | Opus 5.5, $4 / $20 | 0.27x |
| Claude Sonnet | Sonnet 4.5, $3 / $15 | Sonnet 5.5, $2 / $10 | 0.67x |
| Claude Haiku | Haiku 4.5, $1 / $5 | Haiku 5.5, $0.10 / $0.50 | 0.1x |
| Gemini Pro | Gemini 2.5 Pro, $1.25 / $10 | Gemini 4 Argon, $2 / $10 | 1.6x |
| Gemini Flash | Gemini 2.5 Flash, $0.30 / $2.50 | Gemini 3.8 Flash, $0.75 / $3.75 | 2.5x |
| Gemini Flash-Lite | Gemini 2.5 Flash-Lite, $0.10 / $0.40 | Gemini 3.5 Flash-Lite, $0.30 / $2.50 | 3x |
| DeepSeek Niedrigpreisreihe | V3.2-Exp, $0.28 / $0.42 | V4.1 Flash, $0.30 / $1.20 zu Spitzenzeiten | 1.07x |
| Zhipu GLM Flaggschiff | GLM-4.6, $0.60 / $2.20 | GLM-5.3, $1.40 / $4.40 | 2.3x |
| Moonshot Kimi Flaggschiff | Kimi K2, $0.60 / $2.50 | Kimi K3, $3 / $15 | 5x |
| Alibaba Qwen Max | Qwen3-Max, $1.20 / $6 | Qwen3.8 Max, $2 / $6 | 1.67x |
| MiniMax | M2 (ab 23. Oktober), $0.30 / $1.20 | M3, $0.30 / $1.20 | 1x |
Für einige Preise gelten Einschränkungen: Die Einführungspreise von Argon und Gemini 3.8 Flash verdoppeln sich am 1. Dezember beziehungsweise am 1. Januar. Haiku 5.5 kostet bei mehr als 100,000 Prompt-Token $0.50 / $2.50. Die DeepSeek-Zeile verwendet den Spitzenpreis, der während der Pekinger Geschäftszeiten gilt. Außerhalb dieser Zeiten kostet das Modell die Hälfte und liegt damit unter dem Mischpreis von V3.2-Exp. Auch beim Vergleich der Mischpreise statt der Input-Preise ergibt sich dieselbe Zahl: Preiserhöhungen in 10 von 14 Reihen. Die Preise für Kimi K2 und Qwen3-Max stammen aus Aufzeichnungen Dritter.
Wie haben Anthropic, OpenAI, Google und DeepSeek ihre Modellpreise über zwei Jahre gestaltet?
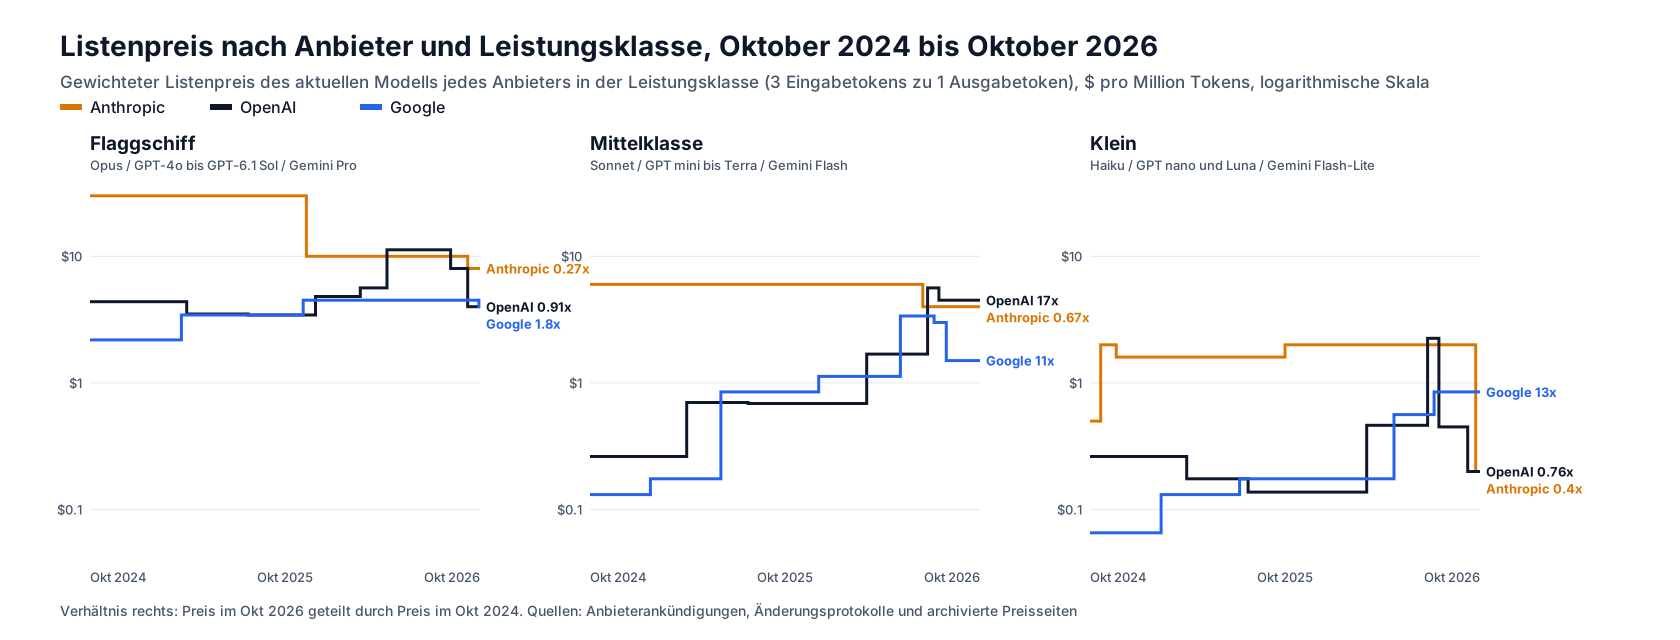
Über zwei Jahre senkte Anthropic die Listenpreise in allen drei Kategorien. Bei OpenAI lagen das Flaggschiff und das Kleinmodell am Ende nahe am Ausgangsniveau, während der Preis in der Mittelklasse auf das 17x stieg. Google erhöhte die Preise in jeder Kategorie. Bei DeepSeeks günstigem Modell stieg der Preis zu Spitzenzeiten auf etwa das 3x, während der Preis für Cache-Treffer auf 2% des Input-Preises sank. Die Grafik und die Tabellen unten zeigen die Entwicklung bei den drei größten Anbietern proprietärer Modelle seit Oktober 2024, jeweils für das aktuelle Flaggschiff, die Mittelklasse und das Kleinmodell. DeepSeek bietet ein oder zwei Modelle statt drei Kategorien an und hat deshalb einen eigenen Unterabschnitt. Eine abschließende Tabelle vergleicht alle vier Anbieter.
| Kategorie | Anthropic | OpenAI | |
|---|---|---|---|
| Flaggschiff | Von Claude 3 Opus $15 / $75 zu Opus 5.5 $4 / $20: 0.27x | Von GPT-4o $2.50 / $10 zu GPT-6.1 Sol $2 / $10: 0.91x | Von Gemini 1.5 Pro $1.25 / $5 zu Gemini 4 Argon $2 / $10: 1.8x |
| Mittelklasse | Von Claude 3.5 Sonnet $3 / $15 zu Sonnet 5.5 $2 / $10: 0.67x | Von GPT-4o mini $0.15 / $0.60 zu GPT-5.6 Terra $2 / $12: 17x | Von Gemini 1.5 Flash $0.075 / $0.30 zu Gemini 3.8 Flash $0.75 / $3.75: 11x |
| Kleinmodell | Von Claude 3 Haiku $0.25 / $1.25 zu Haiku 5.5 $0.10 / $0.50: 0.4x | Von GPT-4o mini zu GPT-6 Luna $0.10 / $0.50: 0.76x | Von Gemini 1.5 Flash-8B $0.0375 / $0.15 zu Gemini 3.5 Flash-Lite $0.30 / $2.50: 13x |
Die Preise gelten jeweils am 15. Oktober; das Verhältnis vergleicht die Mischpreise. GPT-4o mini steht in beiden unteren OpenAI-Zeilen am Anfang, weil OpenAI erst mit GPT-4.1 nano im April 2025 ein separates Kleinmodell anbot.
Sind die Modelle teurer geworden oder nur leistungsfähiger?
Die Modelle wurden überwiegend leistungsfähiger. Von Oktober 2025 bis Oktober 2026 stieg der Indexwert des jeweils aktuellen Modells in jeder Kategorie auf das 1.9- bis 3.3-Fache. Der Preis pro Indexpunkt sank in sieben der neun Kategorien. Er ergibt sich aus dem Mischpreis geteilt durch den Indexwert; ein Verhältnis unter 1x bedeutet, dass dasselbe Leistungsniveau günstiger wurde. Da der Index ältere Modelle erst ab Mitte 2025 erfasst, deckt dieser Vergleich das zweite Jahr ab:
| Anbieter und Kategorie | Index, Okt. 2025 bis Okt. 2026 | Mischpreis | Preis pro Indexpunkt |
|---|---|---|---|
| Anthropic Flaggschiff | 22.8 bis 57.6 | $30.00 bis $8.00 | 0.11x |
| Anthropic Mittelklasse | 19.3 bis 35.9 (Standardeinstellung) | $6.00 bis $4.00 | 0.36x |
| Anthropic Kleinmodell | 16.9 bis 43.4 | $2.00 bis $0.20 | 0.04x |
| OpenAI Flaggschiff | 23.0 bis 51.8 | $3.44 bis $4.00 | 0.52x |
| OpenAI Mittelklasse | 16.8 bis 42.1 | $0.69 bis $4.50 | 2.6x |
| OpenAI Kleinmodell | 13.0 bis 38.1 | $0.14 bis $0.20 | 0.50x |
| Google Flaggschiff | 16.1 bis 52.6 | $3.44 bis $4.00 | 0.36x |
| Google Mittelklasse | 13.1 bis 40.9 | $0.85 bis $1.50 | 0.57x |
| Google Kleinmodell | 8.5 bis 22.2 | $0.18 bis $0.85 | 1.9x |
Die Modelle entsprechen denen in der ersten Tabelle. Die Indexwerte gelten jeweils für die höchste Reasoning-Einstellung, also die Anfrageoption, mit der ein Modell vor der Antwort länger nachdenken kann. Für Sonnet gilt die Standardeinstellung, da für ältere Sonnet-Modelle nur dafür Indexwerte vorliegen. Die Werte älterer Modelle für Oktober 2025 sind Schätzungen von Artificial Analysis. Der Preis pro Indexpunkt stieg nur dort, wo ein Anbieter den Modellpreis stärker anhob, als sich die Leistung verbesserte.
Wie haben sich die Preise in den einzelnen Kategorien entwickelt?
Die Preise der Flaggschiffe rückten zusammen, die Mittelklasse wurde teurer, und bei den Kleinmodellen gingen die Preise auseinander. Im Oktober 2024 lag der höchste Input-Preis der Flaggschiffe beim 12-Fachen des niedrigsten (Claude 3 Opus mit $15, Gemini 1.5 Pro mit $1.25), im Oktober 2025 weiterhin beim 12-Fachen. Heute beträgt der Abstand den Faktor 2. Zwischenzeitlich stieg der Preis von OpenAIs Flaggschiff im April 2026 mit GPT-5.5 auf $5 / $30, bevor er auf $2 / $10 fiel. Mittelklassemodelle erzielen heute höhere Indexwerte als die Flaggschiffe ein Jahr zuvor. OpenAI und Google haben ihre Preise entsprechend angesetzt. Dadurch schrumpfte die Input-Preisspanne in der Mittelklasse von 40x auf 2.7x, wobei Sonnets Preissenkung den Abstand weiter verringerte. Bei den Kleinmodellen haben sich OpenAI und Anthropic beide bei $0.10 / $0.50 eingependelt. Googles Gemini 3.5 Flash-Lite kostet dagegen so viel wie Gemini 2.5 Flash Mitte 2025.
Wie unterschieden sich die Preisstrategien der einzelnen Anbieter?
Anthropic hielt die Preise über längere Zeit stabil und senkte sie dann schrittweise. OpenAI änderte die Preise häufig und begründete jede Änderung mit höherer Leistung oder Effizienz. Google erhöhte die Preise mit jeder Generation und kündigte Erhöhungen im Voraus an. Keiner der drei Anbieter nannte einen Wettbewerber als Grund für eine Preisänderung, auch nicht, als Opus 5.5, GPT-6 Sol und GPT-6 Luna am selben Tag erschienen.
Anthropic: erst stabile Preise, dann schrittweise Senkungen. Sonnet blieb von März 2024 bis zu Sonnet 4.6 im Jahr 2026 bei $3 / $15. Opus kostete $15 / $75, bis Opus 4.5 den Preis im November 2025 auf $5 / $25 senkte, „um die Leistungsfähigkeit von Opus noch mehr Nutzern zugänglich zu machen“ (Anthropic). Weitere Preissenkungen kamen mit neuen Modellen: Opus 5.5 „benötigt für die Inferenz weniger Rechenleistung als Opus 5, und das spiegelt sich im Preis wider“ (Anthropic). Der Einführungspreis von $2 / $10 für Sonnet 5 wurde im August zum Standardpreis. Preiserhöhungen gab es in der Haiku-Reihe: Claude 3.5 Haiku startete im November 2024 für $1 / $5, „um seiner höheren Leistungsfähigkeit Rechnung zu tragen“. Einen Monat später sank der Preis auf $0.80 / $4 (TechCrunch). Mit Haiku 4.5 stieg er im Oktober 2025 wieder auf $1 / $5.
OpenAI: häufige Preisänderungen, begründet mit Leistung oder Effizienz. Preiserhöhungen begründete OpenAI mit höherer Leistung: GPT-5.2 koste „pro Token mehr als GPT‑5.1, weil es ein leistungsfähigeres Modell ist“ (OpenAI). Bei Preissenkungen verwies OpenAI auf niedrigere Inferenzkosten: o3 wurde im Juni 2025 um 80% günstiger, weil „wir unseren Inferenz-Stack für o3 optimiert haben“ (OpenAIDevs). GPT-6 Sol und Luna starteten zum halben Input-Preis ihrer Vorgänger, weil „Verbesserungen beim Caching und bei der Inferenz es uns ermöglichen, diese Modelle zu niedrigeren Kosten zu betreiben“ (OpenAI). Die Einführungspreise blieben nicht lange bestehen: Alle drei im Juli veröffentlichten GPT-5.6-Modelle wurden innerhalb von sechs Wochen günstiger. Reuters brachte die Preissenkung bei GPT-5.6 Sol im August mit dem „wachsenden Wettbewerb durch Anthropic und chinesische KI-Modelle“ in Verbindung; OpenAI verwies auf Effizienzsteigerungen.
Google: steigende Preise mit angekündigten Erhöhungen. Google war anfangs in jeder Kategorie der günstigste Anbieter und erhöhte die Preise mit den meisten Modellgenerationen, meist ohne Begründung. Die Ausnahme war Gemini 2.5 Flash, dessen Input-Preis sich im Juni 2025 verdoppelte. Google bezeichnete das als „gezielte Anpassung, die den außergewöhnlichen Nutzen von Flash widerspiegelt“ (Google). Seit August bringt Google Modelle zu Einführungspreisen auf den Markt und kündigt die spätere Erhöhung gleich mit an: Gemini 3.7 Flash und 3.8 Flash kosten bis zum 31. Dezember $0.75 / $3.75, danach $1.50 / $7.50. Argon kostet bis zum 30. November $2 / $10, danach $4 / $20. Google nannte keinen Grund. Sundar Pichai sagte Investoren allerdings im Juli: „Unsere Kapazität reicht weiterhin nicht aus, um die Nachfrage zu decken“ (Alphabet).
Wie unterscheidet sich DeepSeeks Preisstrategie?
DeepSeek senkte die Preise, als eine neue Architektur die Inferenzkosten verringerte, und erhöhte sie, als die Nachfrage die GPU-Kapazität überstieg. Die Effizienz bestimmte damit die Preisuntergrenze, die verfügbare Rechenkapazität den jeweils tatsächlichen Preis. Dabei spielt Caching eine große Rolle: Beginnt ein Prompt mit Text, den der Anbieter bereits verarbeitet hat, kann er den gespeicherten Zwischenzustand (den KV-Cache) wiederverwenden, statt ihn neu zu berechnen. Diese Input-Token rechnet er als Cache-Treffer zu einem niedrigeren Preis ab.
| Datum | Änderung | Cache-Treffer / Cache-Fehlschlag / Output, $ pro Million Token |
|---|---|---|
| August 2024 | Prompt-Caching auf Festplatte eingeführt (DeepSeek V2, danach V2.5) | $0.014 / $0.14 / $0.28 |
| Februar 2025 | V3 nach einer Einführungsaktion zum vollen Preis; ab 26. Februar nachts 50% Rabatt auf V3 und 75% auf R1, DeepSeeks Reasoning-Modell | $0.07 / $0.27 / $1.10 |
| 5. September 2025 | Einheitlicher Preis für den Reasoning-Modus und den Modus ohne Reasoning von V3.1; nächtlicher Rabatt entfällt | $0.07 / $0.56 / $1.68 |
| 29. September 2025 | V3.2-Exp, Preise um mehr als die Hälfte gesenkt | $0.028 / $0.28 / $0.42 |
| April 2026 | V4 Flash erscheint; zwei Tage später sinkt der Preis für Cache-Treffer auf ein Zehntel des Einführungspreises | $0.0028 / $0.14 / $0.28 |
| 17. August 2026 | Spitzenzeitenpreise eingeführt; außerhalb der Spitzenzeiten gilt der halbe Preis | $0.014 / $0.44 / $1.32 zu Spitzenzeiten |
| 10. September 2026 | V4.1 Flash ersetzt V4 Flash | $0.006 / $0.30 / $1.20 zu Spitzenzeiten |
Die Preise gelten jeweils für das zum betreffenden Zeitpunkt günstigere Modell von DeepSeek. Spitzenzeiten sind an Arbeitstagen von 09:00 bis 12:00 und von 14:00 bis 18:00 Uhr Pekinger Zeit.
Effizienz. DeepSeek führt in seinen Ankündigungen drei Preissenkungen auf Arbeiten an der Architektur zurück. Das Disk-Caching von 2024 basierte auf MLA, DeepSeeks komprimiertem Attention-Verfahren. Damit wurde der KV-Cache klein genug, um ihn auf günstigen Festplatten zu speichern (DeepSeek). Die Preissenkung im September 2025 ging mit der Einführung von DeepSeek Sparse Attention einher, das nur einen Teil der vorherigen Token berücksichtigt. Die chinesische Ankündigung nennt die deutlich niedrigeren Inferenzkosten des neuen Modells als Grund (DeepSeek). Der KV-Cache von V4.1 Flash benötigt gegenüber dem Vorgänger „1/4 des HBM“ (GPU-Speicher) und „1/8 des SSD-Speichers“. DeepSeek wies außerdem darauf hin, dass „Cache-Lesezugriffe oft einen großen Teil der Agentenkosten ausmachen“ (DeepSeek). Sein Cache-Lesepreis beträgt heute 2% des Input-Preises, gegenüber 10% im Jahr 2024 und aktuell 2.5% bis 10% bei den US-Anbietern. DeepSeek hat für einen einzigen Tag im März 2025 Daten zum Inferenzbetrieb veröffentlicht: 56.3% der Input-Token wurden aus dem Disk-Cache bedient. Bei $2 pro GPU-Stunde ergab sich eine theoretische Marge von 545%, wobei der tatsächliche Umsatz „deutlich niedriger“ lag (DeepSeek).
Kapazität. Laut derselben Übersicht setzt DeepSeek nachts Inferenzknoten für Forschung und Training ein. Auf diese Stunden mit geringer Auslastung zielte der Nachtrabatt von 2025 ab. Die Preiserhöhungen fielen in Zeiten knapper Kapazität: Als DeepSeek im September 2025 die Modi von V3.1 zusammenführte, entfiel der Rabatt und der Input-Preis für Cache-Fehlschläge des Modells ohne Reasoning verdoppelte sich von $0.27 auf $0.56, ohne Erklärung (DeepSeek). Die im August 2026 eingeführten Spitzenzeitenpreise verdreifachten den Input-Preis von V4 Flash zu Spitzenzeiten, um „Ressourcen sinnvoller zu verteilen“ (unsere Übersetzung der chinesischen Ankündigung, DeepSeek). Selbst außerhalb der Spitzenzeiten kostet V4.1 Flash mehr als V4 Flash vor August. Pro Indexpunkt kostet es jedoch zu Spitzenzeiten 0.70x und außerhalb der Spitzenzeiten 0.35x so viel wie V3.2-Exp ein Jahr zuvor (Indexwerte von 39.5 gegenüber geschätzten 16.6).
Wie unterscheiden sich die vier KI-Labore?
| Anthropic | OpenAI | DeepSeek | ||
|---|---|---|---|---|
| Entwicklung über zwei Jahre | In allen drei Kategorien gesunken | Flaggschiff und Kleinmodell leicht gesunken (0.91x, 0.76x), Mittelklasse auf das 17x gestiegen | In allen drei Kategorien gestiegen | Niedrigpreismodell zu Spitzenzeiten auf das 3x gestiegen, außerhalb auf das 1.5x |
| Häufigkeit der Preisänderungen | Selten: gleicher Preis über mehrere Releases, dann eine Änderung | Oft: neue Preise bei den meisten Releases, Senkungen innerhalb weniger Wochen | Mit jeder Generation, dazu angekündigte Erhöhungen | Oft: neue Preise bei den meisten Releases, dazu Aktionen und tageszeitabhängige Tarife |
| Einführungspreise | Ein Einführungspreis (Sonnet 5), dauerhaft übernommen | Kurz nach Einführung gesenkt (GPT-5.6-Familie) | Einführungspreise mit angekündigter Erhöhung | Einführungsaktionen (V3, V4 Pro); bei V4 Pro dauerhaft übernommen |
| Genannter Grund für Erhöhungen | Intelligenz (Claude 3.5 Haiku) | Leistungsfähigkeit (GPT-5.2) | Einmal der gebotene Nutzen (2.5 Flash), meist keine Angabe | Ressourcenverteilung (Spitzenzeitenpreise) |
| Genannter Grund für Senkungen | Breiterer Zugang, später niedrigere Inferenzkosten | Effizientere Inferenz und effizienteres Caching | Keine Angabe; Einführungspreise statt Senkungen | Niedrigere Inferenzkosten durch neue Architektur |
| Niedrigpreismodell, Okt. 2026 | $0.10 / $0.50 | $0.10 / $0.50 | $0.30 / $2.50 | $0.30 / $1.20 zu Spitzenzeiten, außerhalb die Hälfte |
Die Preise richteten sich danach, wie der jeweilige Anbieter ein Modell positionierte, nicht nach einem festen Preis pro Kategorie: Erreichte ein Modell Indexwerte auf Flaggschiff-Niveau, näherte sich auch sein Preis dem Flaggschiff an. Konnte ein Anbieter ein Modell günstiger betreiben, senkte er den Preis.
Wie haben sich die Preise in den einzelnen Kategorien entwickelt?
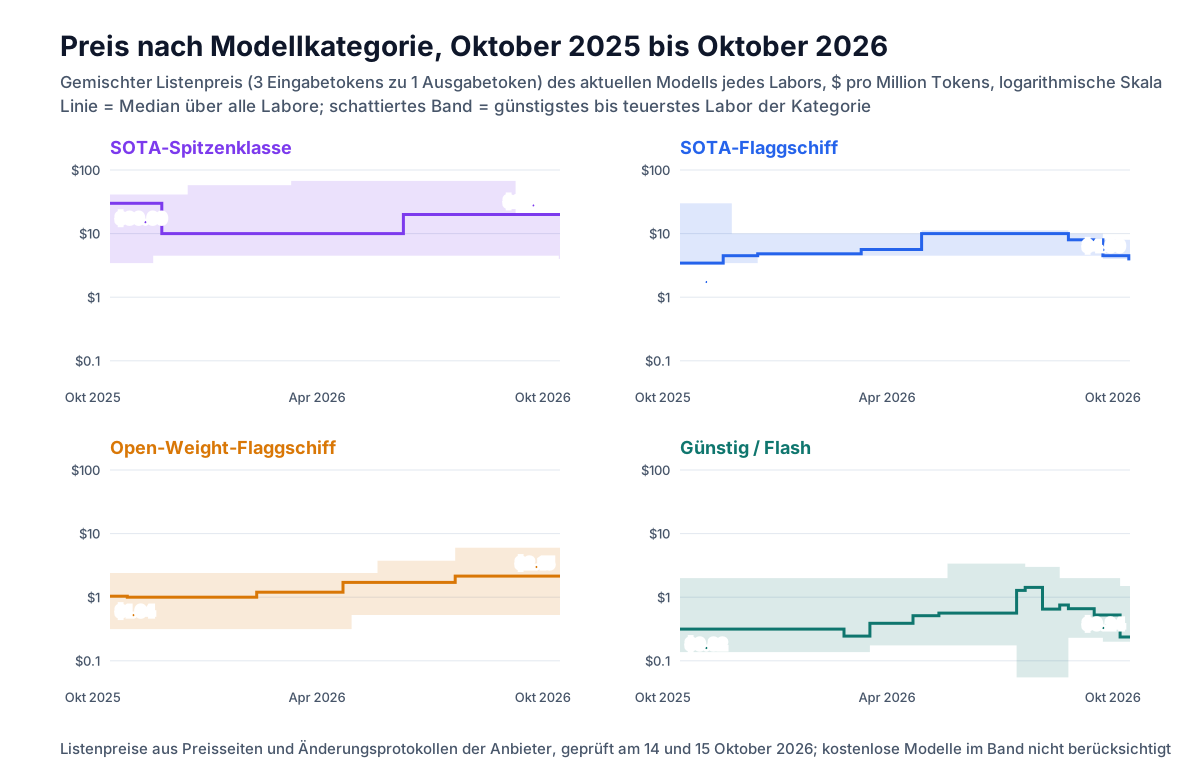
Die Preise der proprietären Flaggschiffe rückten zusammen, Open-Weight-Flaggschiffe wurden teurer. Die günstige Kategorie endete nach einem Preissprung zur Jahresmitte unter ihrem Ausgangswert. Die aktuellen Modelle der Anbieter lassen sich in vier Kategorien einteilen:
- SOTA-Spitzenklasse: SOTA (State of the Art) bezeichnet hier die führenden Anbieter proprietärer Modelle. In dieser Kategorie steht jeweils ihr teuerstes Modell. Es ist eine Preiskategorie: Das Flaggschiff Opus 5.5 erzielt bessere Ergebnisse als alle drei Spitzenklasse-Modelle. Ist das teuerste Modell eines Anbieters zugleich sein Flaggschiff, erscheint es in beiden Kategorien, aktuell etwa Gemini 4 Argon.
- SOTA-Flaggschiff: das zentrale Allzweckmodell jedes Anbieters proprietärer Modelle.
- Open-Weight-Flaggschiff: das Hauptmodell von fünf Anbietern, deren Modellgewichte jeder herunterladen und selbst hosten kann.
- Günstig / Flash: die preiswerte Modellreihe jedes Anbieters, benannt nach Googles Flash-Modellen.
Die Grafik zeigt für jede Kategorie den Median des Mischpreises über alle Anbieter als Linie. Das Band reicht vom günstigsten bis zum teuersten Modell; die Skala ist logarithmisch. Die Preisspanne in der Tabelle bezieht sich nur auf Input-Preise.
| Kategorie | Modelle am 15. Okt. 2026 | Median des Mischpreises, Okt. 2025 | Median des Mischpreises, Okt. 2026 | Input-Preisspanne (höchster ÷ niedrigster), Okt. 2025 | Input-Preisspanne, Okt. 2026 |
|---|---|---|---|---|---|
| SOTA-Spitzenklasse | Claude Fable 5.1, GPT-6 Astra, Gemini 4 Argon | $30.00 | $20.00 | 12x | 5x |
| SOTA-Flaggschiff | Claude Opus 5.5, GPT-6.1 Sol, Gemini 4 Argon | $3.44 | $4.00 | 12x | 2x |
| Open-Weight-Flaggschiff | GLM-5.3, Kimi K3, Qwen3.8 Max, DeepSeek V4 Pro, MiniMax M3 | $1.04 | $2.15 | 4.3x | 10x |
| Günstig / Flash | Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite, DeepSeek V4.1 Flash, GLM-5.3 Flash, Qwen3.8 Flash | $0.32 | $0.24 | 20x | 7.5x |
- SOTA-Spitzenklasse: Bei OpenAIs Pro-Modellen stieg der Preis von $15 / $120 für GPT-5 Pro auf $30 / $180 für GPT-5.4 Pro. Mit GPT-6 Astra sank er dann auf $10 / $50, denselben Preis wie bei Claude Fable 5.1. Google verlangt für Argon vorerst $2 / $10. Allein dadurch ergibt sich die heutige Preisspanne vom Faktor 5.
- Open-Weight-Flaggschiff: Der Median des Input-Preises stieg von $0.60 auf $1.40 und damit auf mehr als das Doppelte. Zugleich gingen die Preise der Anbieter weiter auseinander: Kimi K3 kostet mit $3 / $15 mehr als Claude Sonnet 5.5, während MiniMax M3 über fünf Releases hinweg bei $0.30 / $1.20 blieb. Der Median des Output-Preises bei Open-Weight-Modellen stieg von 24% auf 44% des Medians proprietärer Flaggschiffe. DeepSeek V4 Pro geht mit seinem Spitzenzeitenpreis ein.
- Günstig / Flash: Von Mai bis Juli stieg der Median auf $0.56, weil neue günstige Modelle zu höheren Preisen starteten, etwa Gemini 3.1 Flash-Lite und Qwen3.6 Flash mit $0.25 / $1.50. Der Rückgang kam vor allem im Oktober, als Haiku 5.5 mit $0.10 / $0.50 denselben Preis wie GPT-6 Luna erreichte.
GPT-5.6 Terra bleibt aus der günstigen Kategorie ausgeschlossen, weil es so viel kostet wie ein Flaggschiff. Die Daten decken acht Anbieter ab. xAI und Mistral sind nicht enthalten.
Was kostet ein bestimmtes Leistungsniveau heute?
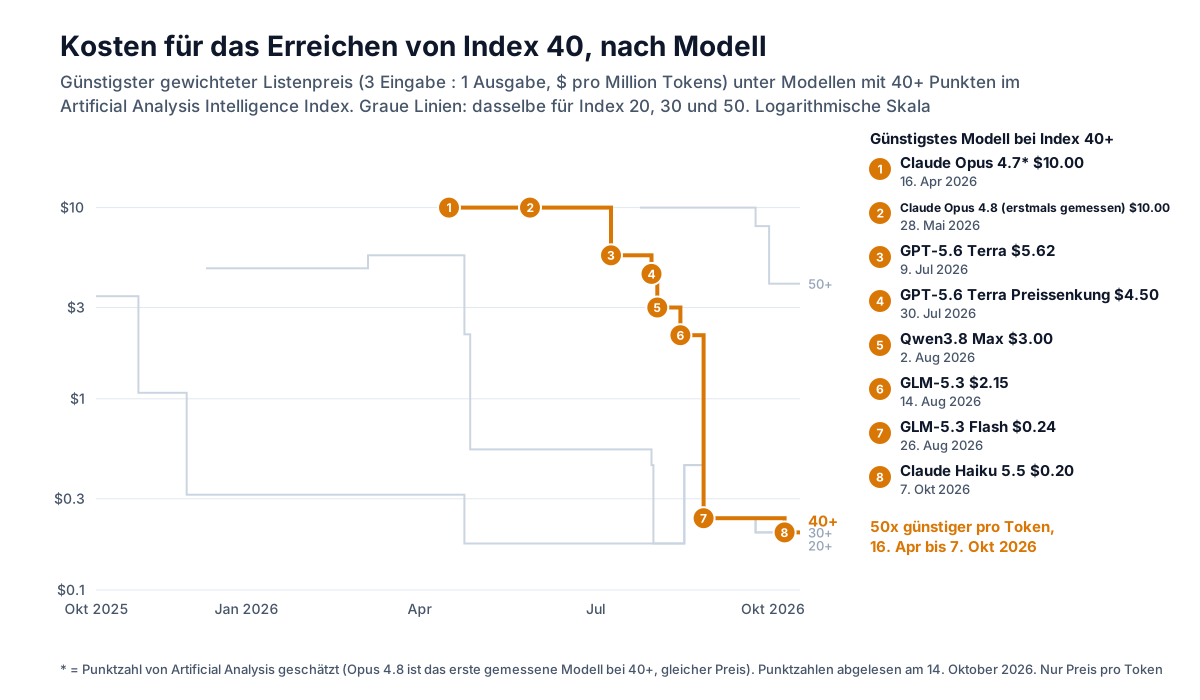
Das günstigste Modell je Indexwert wurde pro Token um den Faktor 2.5 bis 50 billiger. Pro Aufgabe beträgt der Rückgang den Faktor 8 bis 19, sofern für beide Vergleichszeitpunkte Aufgabenkosten vorliegen. Als Kosten pro Aufgabe verwenden wir die Angaben von Artificial Analysis: die Kosten einer einzelnen Indexaufgabe zum Listenpreis, berechnet mit dem tatsächlichen Token-Verbrauch des jeweiligen Modells. Für jeden Tag haben wir das günstigste aktuelle Modell ermittelt, das in Indexversion 4.3.2 mindestens 20, 30, 40 oder 50 erreicht, jeweils mit seiner höchsten Reasoning-Einstellung.
| Indexwert | Günstigstes Modell beim ersten Erreichen zwischen Okt. 2025 und Okt. 2026, Mischpreis in $ pro Million Token | Heute am günstigsten | Preisrückgang pro Token | Preisrückgang pro Aufgabe |
|---|---|---|---|---|
| 20 | Beginn des Zeitraums, Okt. 2025: GPT-5*, $3.44 | Claude Haiku 5.5 oder GPT-6 Luna, $0.20 | 17x | für GPT-5 nicht veröffentlicht |
| 30 | Dez. 2025: GPT-5.2*, $4.81 | Claude Haiku 5.5 oder GPT-6 Luna, $0.20 | 24x | für GPT-5.2 nicht veröffentlicht |
| 40 | Apr. 2026: Claude Opus 4.7*, $10 | Claude Haiku 5.5, $0.20 | 50x | 19x, von Opus 4.8 (erstes Modell mit Aufgabenkosten) mit $4.08 auf Haiku 5.5 mit $0.21 |
| 50 | Juli 2026: Claude Opus 5, $10 | GPT-6.1 Sol oder Gemini 4 Argon, $4 | 2.5x | 8.1x, von Opus 5 mit $5.86 auf GPT-6.1 Sol mit $0.72 |
* Von Artificial Analysis geschätzt, nicht gemessen. Das erste gemessene Modell bei Indexwert 40, Opus 4.8 im Mai, hatte denselben Listenpreis von $10.
Der niedrigste Preis sank nicht gleichmäßig: Von Ende April bis Mitte August kostete Indexwert 20 mit DeepSeek V4 Flash $0.175 und damit weniger als die heutigen $0.20.
Die Modelle mit den höchsten Indexwerten wurden nicht billig. Vor einem Jahr lagen GPT-5 und Opus 4.1 mit geschätzten Werten von 23.0 und 22.8 vorn, bei Mischpreisen von $3.44 und $30. Heute führt Claude Opus 5.5 mit 57.6 für $8 im Mischpreis. Die großen Preisrückgänge betreffen Leistungsniveaus, die wenige Monate zuvor nur das beste Modell erreichte.
Warum haben sich die Preise so entwickelt?
Neben den Aussagen der Anbieter zu ihren eigenen Preisen fallen drei Marktentwicklungen mit diesen Preisänderungen zusammen und wirken in unterschiedliche Richtungen. Da sie sich zeitlich überschneiden, lassen sich ihre Effekte anhand der Daten nicht voneinander trennen.
Nachfrage und Inferenzkapazität. Übersteigt die Nachfrage die verfügbare GPU-Kapazität zur Beantwortung von Anfragen, kann ein Anbieter die Nutzung begrenzen oder zu Spitzenzeiten höhere Preise verlangen. OpenRouter ist ein Marktplatz, der API-Anfragen an verschiedene Modellhoster weiterleitet. Sein wöchentliches Volumen stieg von etwa 5 Billionen Token im April 2025 auf über 20 Billionen im April 2026. Der Anteil der Programmieraufgaben wuchs dabei von etwa 11% auf mehr als die Hälfte des Traffics (Wing VC). Anthropic hob die Beschränkungen für Claude-Abos zu Spitzenzeiten auf, nachdem es am 6. Mai Zugang zu xAIs Rechenzentrum Colossus 1 erhalten hatte. Zu den API-Preisänderungen im selben Zeitraum gehören GPT-5.5 für $5 / $30 im April, Googles angekündigte Preiserhöhungen bei nach eigenen Angaben begrenzter Kapazität sowie DeepSeeks Spitzenzeitenpreise.
Wettbewerb und Preisuntergrenze. Der Anteil chinesischer Open-Weight-Modelle an den OpenRouter-Token stieg von etwa 2% Ende 2024 auf etwa 61% bis Mai 2026 (Wing VC). Der direkte Traffic etwa von ChatGPT übersteigt den des Routers allerdings bei Weitem. Im Juni berichtete das Wall Street Journal, OpenAI erwäge Preissenkungen im Vorfeld erwarteter Senkungen bei Anthropic (Decrypt). Beide veröffentlichten am 22. September günstigere Modelle. Die Preisuntergrenze, also den günstigsten Preis für ein Leistungsniveau, setzte von Ende April bis zu DeepSeeks Preiserhöhung im August DeepSeek V4 Flash. Danach übernahmen Claude Haiku 5.5 und GPT-6 Luna diese Position.
Umsatz für Open-Weight-Anbieter. Mit offenen Modellgewichten kann jeder Hoster dasselbe Modell anbieten. Nach der Veröffentlichung von GLM-5.3 Flash fiel der Anteil von Zhipus eigener API am OpenRouter-Traffic dieses Modells innerhalb von drei Wochen von 88% auf 22%. Die KI-Forschungsgruppe Epoch AI schätzt, dass DeepSeek etwa 8% der OpenRouter-Ausgaben für DeepSeek-Modelle erhält (Huxiu, zitiert von Weijin Research). Diese Zahlen stammen aus der Zeit nach dem Großteil des Preisanstiegs bei Open-Weight-Modellen. Sie passen zur Entwicklung, erklären sie aber nicht. Bei den neuesten Flaggschiffen unterbieten Hoster die Modellanbieter nur begrenzt: Am 16. Oktober war der Preis des jeweiligen Entwicklers bei GLM-5.3 (15 von 44 Hostern) und Kimi K3 (7 von 25) der häufigste. Von den 15 günstigeren Kimi-K3-Hostern verwendeten 12 mit 4 Bit quantisierte Gewichte, also eine komprimierte Fassung, deren Antworten vom Original abweichen können.
Warum entspricht der Token-Preis nicht den Kosten pro Aufgabe?
Zwei Modelle mit demselben Listenpreis können sich bei den Kosten pro Aufgabe um ein Mehrfaches unterscheiden. Der Hauptgrund sind Reasoning-Token: die verborgenen Denkschritte, die ein Modell vor der Antwort erzeugt und die als Output abgerechnet werden. Artificial Analysis veröffentlicht für jedes Modell die durchschnittlichen Kosten einer Indexaufgabe zum Listenpreis.
| Vergleich | Listenpreis, $ pro Million Token (Input / Output) | Durchschnittliche Kosten pro Indexaufgabe |
|---|---|---|
| Claude Haiku 5.5 gegenüber GPT-6 Luna | beide $0.10 / $0.50 | $0.21 gegenüber $0.07 |
| Gemini 4 Argon gegenüber GPT-6.1 Sol | beide $2 / $10 | $1.99 gegenüber $0.72 |
| Qwen3.8 Max gegenüber GPT-6.1 Sol | $2 / $6 gegenüber $2 / $10 | $5.41 gegenüber $0.72 |
Qwen3.8 Max hat in diesem Vergleich den niedrigeren Output-Preis, kostet pro Aufgabe aber 7.5-mal so viel. In unserem eigenen Test kostete Argon pro korrekter Antwort 3.1-mal so viel wie GPT-6.1 Sol (API-Kosten von Gemini 4 Argon). Für einen Vergleich mit eurem eigenen Traffic berechnet ihr die Kosten eines Batches realer Anfragen anhand der Token-Zahlen jeder Antwort. Reasoning-Token werden als Output abgerechnet. Teilt die Gesamtkosten durch die Zahl der brauchbaren Antworten und vergleicht die Modelle anhand dieser Kosten pro Antwort.
Wie haben sich Cache-Preise im Verhältnis zum Input-Preis verändert?
Bei den Flaggschiffen und Spitzenmodellen proprietärer Anbieter wurden Cache-Lesezugriffe (die im DeepSeek-Abschnitt beschriebenen Cache-Treffer) relativ zum Input günstiger. Cache-Schreibzugriffe wurden bei zwei Anbietern teurer. Die Tabelle gibt den Cache-Lesepreis jedes Modells als Anteil seines eigenen Input-Preises an.
| Kategorie | Cache-Lesen ÷ Input, Okt. 2025: Median (Spanne) | Okt. 2026: Median (Spanne) | Niedrigster und höchster Wert heute |
|---|---|---|---|
| SOTA-Spitzenklasse | 10% (alle Modelle) | 5% (2.5% bis 10%) | Claude Fable 5.1 2.5%, GPT-6 Astra 10% |
| SOTA-Flaggschiff | 10% (alle Modelle) | 5% (alle Modelle) | Claude Opus 5.5, GPT-6.1 Sol und Gemini 4 Argon jeweils 5% |
| Open-Weight-Flaggschiff | 18% (10% bis 25%) | 12.5% (3.3% bis 20%) | DeepSeek V4 Pro 3.3%, MiniMax M3 20% |
| Günstig / Flash | 10% (alle Modelle) | 10% (2% bis 20%) | DeepSeek V4.1 Flash 2%, GLM-5.3 Flash 20% |
Bei den proprietären Flaggschiffen halbierte sich der relative Cache-Lesepreis innerhalb von drei Wochen: bei Opus 5.5 am 22. September, GPT-6.1 Sol am 29. September und Argon am 13. Oktober. Open-Weight-Anbieter verlangen einen höheren Anteil, mit DeepSeek als Ausnahme. Die 3.3% bei V4 Pro ergeben sich allerdings aus einem höheren Input-Preis, nicht aus einem günstigeren Cache-Lesepreis. MiniMax wechselte mit M2.7 im März von 10% auf 20%. Modelle ohne aufgeführten Cache-Preis bleiben unberücksichtigt.
Bei zwei Anbietern haben sich die Preise für Cache-Schreibzugriffe geändert, also für die Anfrage, die einen Präfix erstmals speichert. OpenAI berechnet dafür seit GPT-5.6 im Juli das 1.25-Fache des Input-Preises für den standardmäßigen 30-Minuten-Cache und seit dem 20. Oktober das 2.5-Fache für einen 12-Stunden-Cache. Kimi K3 rechnet das standardmäßige Schreiben für 5 Minuten weiterhin zum Input-Preis ab, wie schon Kimi K2. Neu ist ein optionaler 1-Stunden-Cache zum 2-Fachen des Input-Preises. Anthropic verlangt weiterhin das 1.25-Fache für einen 5-Minuten-Cache und das 2-Fache für einen 1-Stunden-Cache. Google, DeepSeek und Zhipu berechnen nach wie vor keinen Aufpreis. Der Leitfaden zu Cache-Schreibkosten erklärt, wann sich ein Schreibzugriff lohnt.
Was folgt daraus für die Praxis?
Plant Budgets nach Leistungsniveau und Aufgabe statt nach dem Namen der Modellreihe. Testet die kleinen Modelle erneut.
| Workload | Was ihr prüfen solltet | Kandidaten und Zahlen |
|---|---|---|
| Extraktion, Klassifikation und Routing in großem Umfang | Ob ein kleines Modell aus 2026 eure Qualitätsanforderungen erfüllt | Claude Haiku 5.5 erreicht 43.4 und GPT-6 Luna 38.1 für $0.10 / $0.50; vor einem Jahr lag kein Modell im Datensatz über 23 |
| Agenten und langes Reasoning | Kosten pro abgeschlossener Aufgabe | GPT-6.1 Sol $0.72 pro Indexaufgabe, Gemini 4 Argon $1.99 bei gleichem Listenpreis |
| Aufgaben mit höchsten Leistungsanforderungen | Ob ihr Indexwert 50 oder tatsächlich das beste Modell braucht | Indexwert 50 kostet mit GPT-6.1 Sol $4 im Mischpreis, mit Argon ebenfalls bis zum 1. Dezember; Claude Opus 5.5 mit 57.6 kostet $8 |
| Budgetplanung mit Einführungspreisen | Wie lange der Preis gilt | Für Googles Einführungspreise sind Erhöhungen angekündigt (Argon am 1. Dezember, Gemini 3.8 Flash am 1. Januar); OpenAI senkte alle drei GPT-5.6-Einführungspreise innerhalb von sechs Wochen; Anthropic hielt die Preise über mehrere Releases hinweg konstant und senkte sie mit neuen Modellen |
| Batch-Jobs auf DeepSeek | Ob die Verarbeitung außerhalb der Spitzenzeiten laufen kann | DeepSeek V4.1 Flash kostet außerhalb der Pekinger Geschäftszeiten die Hälfte: $0.15 / $0.60 statt $0.30 / $1.20 |
| Open-Weight-Flaggschiffe zur Kostensenkung | Hoster-Preise und Präzision der Gewichte für das konkrete Modell | 12 der 15 Hoster, die Kimi K3 unter Moonshots Preis anbieten, verwenden mit 4 Bit quantisierte Gewichte |
Häufige Fragen
Sinken die LLM-API-Preise 2026? Die Token-Preise für LLM-APIs sind überwiegend gestiegen: Zwischen Oktober 2025 und Oktober 2026 stieg der Input-Listenpreis in 10 der 14 verglichenen Modellreihen. Gemessen am Leistungsniveau sanken die Preise: Das günstigste Modell mit einem Wert von 40 im Artificial Analysis Intelligence Index kostete im April 2026 $10 pro Million Token im Mischpreis, im Oktober nur noch $0.20 (Claude Haiku 5.5). Pro Aufgabe sank der Preis von Mai bis Oktober um den Faktor 19.
Welches KI-Labor hat die API-Preise am stärksten gesenkt? Anthropic hat die Preise am stärksten gesenkt: In den zwei Jahren bis Oktober 2026 sanken die Listenpreise in allen drei Kategorien. Claude Opus 5.5 kostet $4 / $20 gegenüber $15 / $75 für Claude 3 Opus, Claude Haiku 5.5 kostet $0.10 / $0.50. Google erhöhte die Preise in allen drei Kategorien. Bei OpenAI lagen die Mischpreise für das Flaggschiff und das Kleinmodell am Ende jeweils höchstens 25% über oder unter dem Stand vom Oktober 2024, während der Mischpreis der Mittelklasse auf das 17-Fache stieg.
Weiterführende Artikel
- API-Kosten von Gemini 4 Argon: gleicher Listenpreis wie GPT-6.1 Sol, aber 3.1x pro korrekter Antwort
- Preisstufen für lange Kontexte: ab welcher Prompt-Länge die Preise der Anbieter steigen
- Was das Schreiben in den Prompt-Cache kostet: Schreib- und Lesepreise nach Anbieter
- Kosten von Claude Haiku 5.5: die Preisgrenze bei 100,000 Token im Test
- Kosten von Kimi K3: ein Open-Weight-Flaggschiff zum Preis eines proprietären Modells