Was bauen Sie?
Gemessene Empfehlungen für jedes Szenario: mit Live-Preisen, ohne Marketingfloskeln.
- Chatbots Chatbot Schritt für Schritt: Modellauswahl, echter Stop beim Provider, gemessenes Kontextbudget, Kompression ins Memory und Websuche per Gateway.
- Agent-Tracing Drei Request-Header pro Modellaufruf liefern einen Wasserfall für jeden Agentenlauf: parallele Aufrufe, Zeit im eigenen Code, Fehler und Kosten.
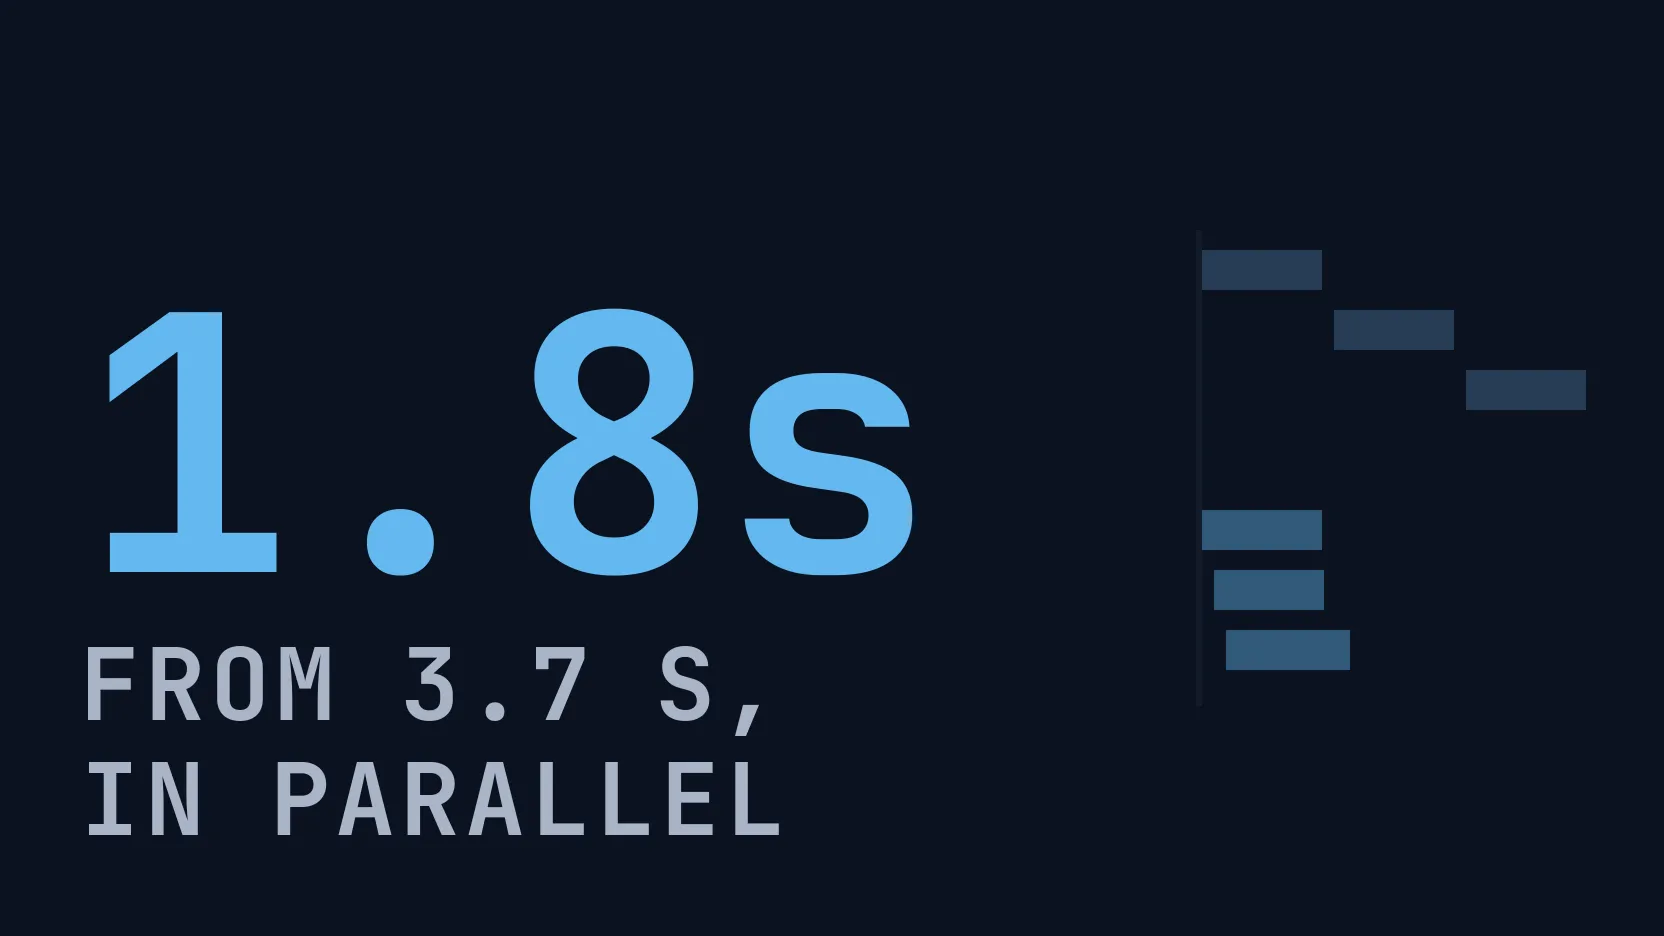
- Agentenlatenz Drei Ursachen für langsame Agenten, reproduziert und behoben: serielle Modellaufrufe (3.7 s auf 1.8 s), langsamer eigener Tool-Code und Reasoning bei Ein-Satz-Antworten.
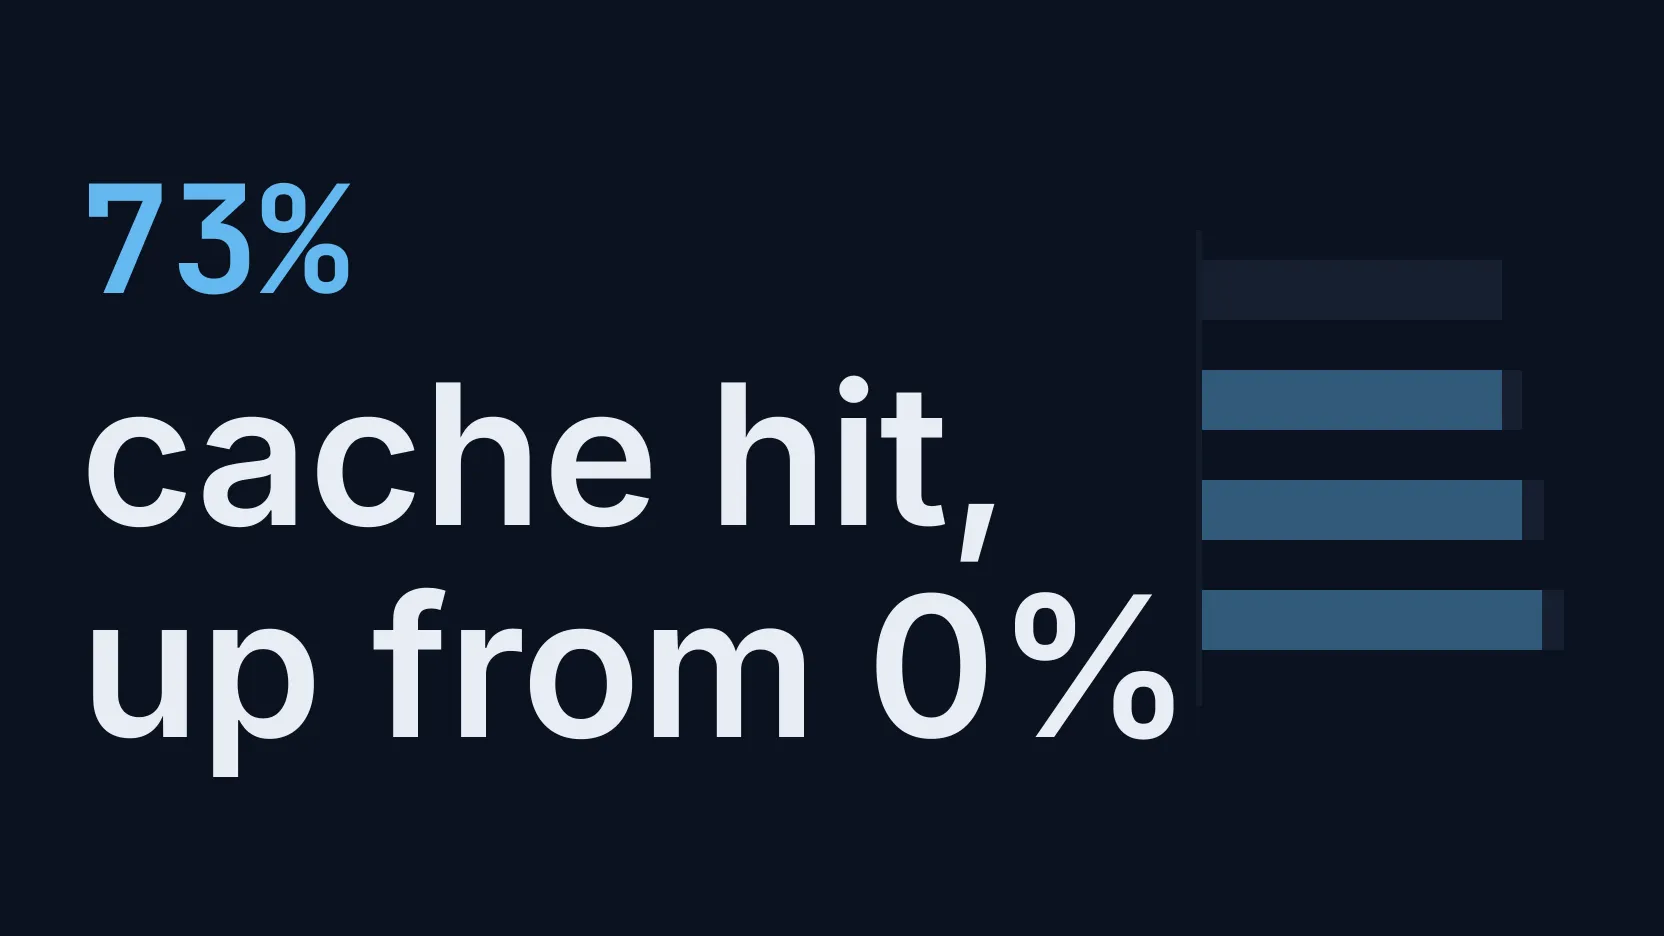
- Agent-Kosten Vier Ursachen hoher Agent-Kosten, reproduziert und behoben: ein Timestamp ohne Cache-Treffer (0% auf 73%), wachsender Kontext, eine Retry-Schleife und das falsche Modell.
- Agenten-Debugging Agent-Läufe eines Nutzers per Label finden und drei Fehler im Trace erkennen: 404 mit Retry, abgebrochene Antworten bei Status 200 und 400 im zweiten Turn.
- Kosten des Coding-Agenten Ein Claude-Code-Lauf über ein Gateway, nach Agent aufgeschlüsselt: Die ersten Aufrufe der drei Agents machten 72% von $0.17 aus. Zwei Umgebungsvariablen reichen.
- Fragen zum Agentenprotokoll Ein LLM-Gateway als eigenen Connector in Claude einbinden, anmelden, Lesezugriff auf das Request-Log erlauben und im Chat fragen. Drei Fragen, 14 Tool-Aufrufe, geprüft.
- Tools für Agentenprotokolle Mit einem API-Key erhält dein Agent die Log-Tools eines LLM-Gateways per MCP. Eine Kostenanalyse mit einem kleinen Modell kostete $0.0015, eine feste REST-Abfrage $0.