
Claude Haiku 5.5: Ein Token über 100K kostet 5x (gemessen)
Inhalt
- So haben wir gemessen
- Was kostet Claude Haiku 5.5 auf beiden Seiten der Grenze?
- Zählen Cache-Token und Output zu den 100,000 Token?
- Sind 100,000 Token genauso viel Text wie bei Claude Haiku 4.5?
- Was passiert, wenn der Kontext eines Agents über die Grenze wächst?
- Wie bleibt ein Agent unter der Grenze?
- Ist es bei gleichem Listenpreis günstiger als GPT-6 Luna?
- FAQ
- Was kostet Claude Haiku 5.5?
- Zählen Cache-Token zur 100,000-Token-Grenze von Claude Haiku 5.5?
- Ist Claude Haiku 5.5 günstiger als Claude Haiku 4.5?
- Ist Claude Haiku 5.5 günstiger als GPT-6 Luna?
- Wie halte ich Requests an Claude Haiku 5.5 unter 100,000 Token?
- Weiterlesen
Für Claude Haiku 5.5 gibt es zwei Preislisten. Die Länge des Prompts entscheidet, welche davon für den gesamten Request gilt. Wir haben einen Prompt mit genau 100,000 Token gesendet und dafür $0.0100 bezahlt. Mit einem Token mehr waren es $0.0500. Zum Prompt gehört alles, was gesendet wird: System-Prompt, Tool-Definitionen und Nachrichten. Auch Token, die aus dem Prompt Cache gelesen werden, zählen mit. Das geht aus der Preisliste von Anthropic nicht hervor; wir haben es anhand der Anthropic-Rechnung bestätigt.
TL;DR
- Ein Prompt mit 100,000 Token kostete bei Claude Haiku 5.5 $0.010008. Mit 100,001 Token waren es $0.050041, also fünfmal so viel.
- Bei einem Prompt mit 102,011 Token, von denen 94% aus dem Cache gelesen wurden, galten die höheren Preise: $0.0078 statt $0.0016 zum niedrigeren Tarif.
- Derselbe englische Text ergibt auf Haiku 5.5 1.4- bis 1.5-mal so viele Token wie auf Claude Haiku 4.5.
- In einem Agent-Loop machten sechs Requests oberhalb der Grenze 76% eines Laufs für $0.083 aus. Mit Compaction oder einem Sub-Agent sank der Betrag auf $0.026 beziehungsweise $0.016.
So haben wir gemessen
Die meisten Requests liefen am 8. und 9. Oktober 2026 über das Synthorai-Gateway. „Gekostet“ bezeichnet hier den Betrag, den das Gateway für einen Request berechnet hat. Es verwendet die beiden Preislisten von Anthropic und addiert für die Prompt-Länge drei Input-Zähler aus der Response: Input ohne Cache, Cache Reads und Cache Writes. Alle 581 geprüften Rechnungsbeträge stimmten auf sechs Nachkommastellen mit einer der beiden Preislisten überein.
Auf der Preisseite von Anthropic steht nur, dass sich der Preis nach der Prompt-Länge richtet („priced by prompt length“). Die API-Response enthält keinen Preis. Deshalb haben wir 23 derselben Prompts direkt an die Anthropic API gesendet und in der Anthropic Console die Tageskosten für das Modell abgelesen: $0.33. Wenn jeder Prompt über 100,000 Token den höheren Tarif zahlt, auch mit Cache Reads, ergeben diese Requests zusammen $0.3301. Ohne Cache Reads bei der Grenzberechnung wären es $0.2678. Anthropic rechnet also genauso ab wie das Gateway.
Was kostet Claude Haiku 5.5 auf beiden Seiten der Grenze?
Sobald der Prompt mehr als 100,000 Token umfasst, kostet jede Position der Preisliste fünfmal so viel. Die Preise gelten pro Million Token.
| Prompt bis 100,000 Token | Prompt über 100,000 Token | Claude Haiku 4.5 | |
|---|---|---|---|
| Input | $0.10 | $0.50 | $1.00 |
| Output | $0.50 | $2.50 | $5.00 |
| Cache Read | $0.01 | $0.05 | $0.10 |
| Cache Write, 5 Minuten | $0.125 | $0.625 | $1.25 |
| Batch Input / Output | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 |
Ein Cache Write fällt beim ersten Request an, der ein Prompt-Präfix speichert. Ein späterer Request, der es wiederverwendet, ist ein Cache Read. Batch ist die asynchrone API von Anthropic zum halben Preis.
Der höhere Tarif gilt für den gesamten Request, nicht nur als Aufschlag auf die Token oberhalb der Grenze. Wir haben einen Prompt mit 99,872 Token erstellt und ihn jeweils um ein oder zwei Token verlängert:
| Prompt-Token | Berechnet | Preisliste |
|---|---|---|
| 99,998 | $0.010008 | niedriger |
| 100,000 | $0.010008 | niedriger |
| 100,001 | $0.050041 | höher |
| 100,002 | $0.050041 | höher |
Genau 100,000 Token fallen noch unter den niedrigeren Tarif. Entscheidend ist „über 100,000“. Laut Anthropic lagen etwa 90% der Requests an Claude Haiku 4.5 bei höchstens 100,000 Prompt-Token. Pro Token ist das neue Modell unterhalb der Grenze 90% günstiger als das alte, oberhalb 50%.
Zählen Cache-Token und Output zu den 100,000 Token?
Cache-Token zählen mit, Output nicht. Wir haben ein Präfix mit 96,045 Token gecacht und es anschließend mit unterschiedlich langen Anhängen erneut gesendet:
| Request | Prompt-Token | Aus Cache gelesen | Berechnet | Preisliste |
|---|---|---|---|---|
| Präfix, erstmals (in Cache geschrieben) | 96,058 | 0 | $0.012009 | niedriger |
| Präfix erneut | 96,058 | 96,045 | $0.000964 | niedriger |
| Präfix mit Anhang von 1,000 Token | 97,034 | 96,045 | $0.001061 | niedriger |
| Präfix mit Anhang von 6,000 Token | 102,011 | 96,045 | $0.007795 | höher |
Beim letzten Request stammen 94% der Token aus dem Cache. Trotzdem gilt der höhere Tarif: $0.0078 statt $0.0016 zum niedrigeren. Output zählt nicht mit: Ein Prompt mit 97,864 Token und einer Antwort mit 1,905 Token kostete $0.010739 nach dem niedrigeren Tarif.
Für den Vergleich mit der Grenze müssen drei Felder der Response addiert werden. Vor dem Senden lässt sich die Tokenzahl über den Token-Counting-Endpoint ermitteln. Er nimmt dieselben system-, tools- und messages-Werte wie der Request entgegen:
import anthropic

client = anthropic.Anthropic()

# after a request: the length the price list is chosen by
u = response.usage
prompt_tokens = u.input_tokens + u.cache_read_input_tokens + u.cache_creation_input_tokens

# before a request
count = client.messages.count_tokens(model="claude-haiku-5-5", system=system, tools=tools, messages=messages)
over_the_line = count.input_tokens > 100_000
Sind 100,000 Token genauso viel Text wie bei Claude Haiku 4.5?
Nein. Claude Haiku 5.5 verwendet einen neueren Tokenizer. Er zerlegt Text in die Einheiten, nach denen das Modell abgerechnet wird. Derselbe Text ergibt damit mehr Token als bei Claude Haiku 4.5. Im Migrationsleitfaden spricht Anthropic von „ungefähr 30% mehr“. Wir haben fünf Textproben mit beiden Modellen gezählt:
| Text | Haiku 4.5 | Haiku 5.5 | Verhältnis | 100,000 auf Haiku 5.5 entsprechen auf Haiku 4.5 |
|---|---|---|---|---|
| Englischer Fließtext (NIST-Bericht, 12 Seiten) | 6,478 | 9,618 | 1.48 | 67,353 |
| Forschungsarbeit, 6 Seiten | 4,352 | 6,048 | 1.39 | 71,958 |
| JavaScript-Quellcode | 8,802 | 11,814 | 1.34 | 74,505 |
| Python-Quellcode | 9,743 | 12,144 | 1.25 | 80,229 |
| Markdown, Chinesisch und Englisch gemischt | 13,351 | 14,710 | 1.10 | 90,761 |
Englischer Fließtext mit 68,000 Token auf Haiku 4.5 liegt auf Haiku 5.5 bereits an der Grenze. Wer das Budget am alten Modell ausgerichtet hat, rechnet also mit der falschen Grenze. Pro Dokument fällt die Ersparnis zudem kleiner aus als pro Token: Bei 1.48-mal so vielen Token kostet englischer Fließtext unterhalb der Grenze 85% weniger als auf Haiku 4.5, oberhalb nur 26% weniger.
Was passiert, wenn der Kontext eines Agents über die Grenze wächst?
Der Request, der die Grenze überschreitet, kostet etwa fünfmal so viel wie der vorherige. Alle folgenden Requests bleiben auf diesem Preisniveau. Ein Agent-Loop sendet bei jedem Schritt die gesamte Unterhaltung erneut. Kommt pro Schritt ein Tool-Ergebnis hinzu, erreicht der Prompt irgendwann 100,000 Token.
Wir haben einen Agent auf Claude Haiku 5.5 ausgeführt. Er liest mit einem read_file-Tool 20 Logdateien mit jeweils etwa 7,000 Token und meldet eine Gesamtsumme daraus. Jedes Tool-Ergebnis bleibt in der Unterhaltung, das Präfix wird gecacht. So sind solche Loops üblicherweise aufgebaut. Die Requests 15 bis 18 eines Laufs:
| Request | Prompt-Token | Aus Cache gelesen | Berechnet |
|---|---|---|---|
| 15 | 92,701 | 85,593 | $0.001787 |
| 16 | 99,705 | 92,699 | $0.001845 |
| 17 | 106,744 | 99,703 | $0.009598 |
| 18 | 113,771 | 106,742 | $0.009942 |
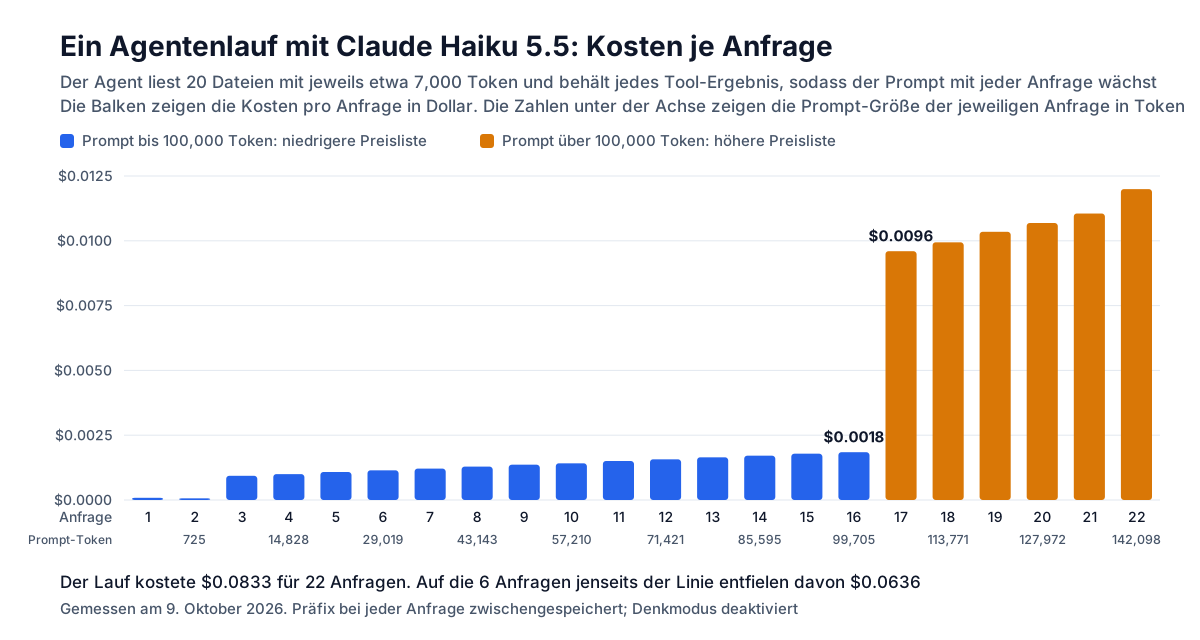
Request 17 ist 7,000 Token länger als Request 16 und kostet 5.2-mal so viel. Der Lauf umfasste 22 Requests und kostete $0.0833. Davon entfielen $0.0636 oder 76% auf die sechs Requests oberhalb der Grenze. Dieselben Token hätten zum niedrigeren Tarif $0.0324 gekostet.
Wie bleibt ein Agent unter der Grenze?
Alte Tool-Ergebnisse dürfen sich nicht in der Hauptunterhaltung ansammeln. Wir haben dieselbe Aufgabe auf Claude Haiku 5.5 mit vier Ansätzen ausgeführt: jeweils fünf Läufe, jeder mit leerem Cache gestartet.
| Ansatz | Richtige Gesamtsumme | Kosten pro Lauf (Median) | Requests | Größter Prompt |
|---|---|---|---|---|
| Alles behalten | 5 von 5 | $0.0823 | 22 | 142,119 |
| Compaction bei 80,000 Token | 5 von 5 | $0.0261 | 23 | 92,829 |
| Alte Tool-Ergebnisse kürzen | 3 von 5 | $0.0228 | 22 | 10,278 |
| Ein Sub-Agent liest jede Datei | 5 von 5 | $0.0156 | 42 | 7,100 |
- Compaction. Sobald der Prompt 80,000 Token überschreitet, fordert ein zusätzlicher Request vom Modell eine Zusammenfassung des Arbeitsstands an. Die Unterhaltung beginnt anschließend mit dieser Zusammenfassung neu. Der Schwellenwert braucht Spielraum: Auch das nächste Tool-Ergebnis muss noch unter 100,000 Token passen.
- Kürzen. Vor jedem Request werden alle Tool-Ergebnisse außer dem neuesten durch einen einzeiligen Platzhalter ersetzt. In zwei von fünf Läufen war die Gesamtsumme falsch, nachdem sich das Modell bei der laufend mitgeführten Summe verrechnet hatte. Aus fünf Läufen lässt sich nicht ableiten, dass Kürzen weniger zuverlässig ist (3 von 5 gegenüber 5 von 5 ist kein signifikanter Unterschied). Das Risiko ist aber sichtbar: Sobald die Quelldaten entfernt sind, lässt sich ein Rechenfehler nicht mehr korrigieren.
- Sub-Agent. Das Tool des Haupt-Agents übergibt jede Datei an einen separaten Request, der eine Zeile zurückgibt. Das war der günstigste Ansatz, brauchte aber die meisten Requests und dauerte etwa ein Viertel länger. Der separate Request sieht nur die übergebenen Daten. Seine Anweisung muss daher genauso präzise beschreiben, wonach gesucht wird, wie die des Haupt-Agents.
Bei allen vier Ansätzen war Thinking deaktiviert. Thinking ist die nicht sichtbare Denkarbeit des Modells vor der Antwort und bei diesem Modell standardmäßig aktiviert. Laut Migrationsleitfaden von Anthropic liefert ein Request einen 400-Fehler, wenn er Thinking-Blöcke erneut sendet, nachdem eine frühere Nachricht geändert wurde. Bei Accounts, die vor dem 31. August 2026 erstellt wurden, gilt das nur, wenn sie die Prüfung aktiviert haben. Beim Kürzen muss Thinking daher ausgeschaltet sein, oder die Thinking-Blöcke müssen weggelassen werden. Compaction und Sub-Agents beginnen eine neue Unterhaltung und umgehen das Problem.
Ist es bei gleichem Listenpreis günstiger als GPT-6 Luna?
In unseren Läufen nicht: Bei gleicher Genauigkeit kostete es etwa doppelt so viel. GPT-6 Luna hat dieselben Listenpreise von $0.10 und $0.50, unabhängig von der Prompt-Länge.
In den Benchmarks von Anthropic liegt Claude Haiku 5.5 bei Agent-Aufgaben vor GPT-6 Luna und deutlich vor Claude Haiku 4.5:
| Benchmark (Anthropic-Ankündigung) | Was getestet wird | Haiku 5.5 | GPT-6 Luna | Haiku 4.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | Wissensarbeit, Elo-Wert | 1620 | 1437 | 735 |
| OSWorld 2.1, Offline-Teilmenge | Computerbedienung | 72.4% | 48.9% | 15.7% |
| Terminal-Bench 4.0 | Programmieraufgaben im Terminal | 39.2% | 16.4% | 0.0% |
Wir haben die drei Modelle mit ihren Standardeinstellungen getestet, Haiku 5.5 zusätzlich mit deaktiviertem Thinking. Dafür nutzten wir zwei kleinere Testsets mit überprüfbaren Antworten: 96 Aufgaben zu Klassifikation, Extraktion und Tool-Routing, also den von Anthropic für dieses Modell genannten Einsatzbereichen, sowie 14 mehrstufige Aufgaben, jeweils dreimal ausgeführt.
| Modell | Kurze Aufgaben richtig, von 96 | Kosten pro 1,000 Aufrufe | Mehrstufige Aufgaben richtig, von 42 | Kosten pro richtiger Antwort |
|---|---|---|---|---|
| Claude Haiku 5.5 | 95 | $0.107 | 39 | $0.00103 |
| Claude Haiku 5.5, Thinking aus | 94 | $0.069 | 33 | $0.00036 |
| GPT-6 Luna | 95 | $0.049 | 38 | $0.00043 |
| Claude Haiku 4.5, ohne Extended Thinking | 94 | $0.679 | 10 | $0.01053 |
Die Kosten pro richtiger Antwort sind die Gesamtkosten geteilt durch die Zahl richtiger Antworten. Haiku 5.5 und GPT-6 Luna erreichten in beiden Testsets praktisch dieselbe Genauigkeit (39 und 38 von 42 sind dasselbe Ergebnis), Haiku 5.5 kostete aber etwas mehr als doppelt so viel. Bei den kurzen Aufgaben zählte es 482 Input-Token, GPT-6 Luna nur 231. Bei den mehrstufigen Aufgaben schrieb es pro Aufruf 1,902 Output-Token statt 759. Gegenüber Haiku 4.5, das mit der Standardeinstellung ohne Extended Thinking lief, kostete es bei den kurzen Aufgaben 84% weniger und löste etwa viermal so viele mehrstufige Aufgaben richtig.
Thinking läuft standardmäßig mit medium Effort. Effort legt von low bis max fest, wie viel das Modell nachdenkt; thinking: {"type": "disabled"} schaltet Thinking aus. Ohne Thinking erzielte das Modell bei den kurzen Aufgaben fast dasselbe Ergebnis zu zwei Dritteln der Kosten. Bei den mehrstufigen Aufgaben waren jedoch 6 von 42 Antworten weniger richtig. Außerdem schrieb es seine Rechenschritte in jede Antwort, obwohl nur eine Zahl gefragt war. Mit max Effort erreichte es dieselben 39 richtigen Antworten wie mit der Standardeinstellung, kostete aber doppelt so viel.
Damit ist das Modell die günstige Stufe der Claude-Reihe und ein deutlicher Sprung gegenüber Haiku 4.5 bei einem Zehntel des Token-Preises. Bei kurzen Aufrufen in großer Zahl erledigte GPT-6 Luna in unseren Läufen dieselbe Arbeit zum halben Preis. Für Haiku 5.5 sprechen Agent-Aufgaben, bei denen es laut Anthropic-Benchmarks deutlich vorne liegt und für die wir die beiden Modelle nicht verglichen haben, solange der Prompt unter 100,000 Token bleibt. Vor der Migration eines Haiku-4.5-Workloads sollten die Prompts mit dem neuen Modell erneut gezählt werden. Außerdem müssen laut Migrationsleitfaden Parameter entfernt werden, die Haiku 5.5 mit einem 400-Fehler ablehnt: ein manuelles Thinking-Budget, nicht standardmäßige Werte für temperature, top_p oder top_k sowie ein vorbefüllter Assistant-Turn.
FAQ
Was kostet Claude Haiku 5.5?
Bei Prompts mit bis zu 100,000 Token kostet Claude Haiku 5.5 $0.10 pro Million Input-Token und $0.50 pro Million Output-Token. Oberhalb von 100,000 Prompt-Token sind es $0.50 und $2.50 für den gesamten Request. Cache Reads kosten $0.01 beziehungsweise $0.05. Die Batch API halbiert bei beiden Preislisten die Kosten für Input und Output.
Zählen Cache-Token zur 100,000-Token-Grenze von Claude Haiku 5.5?
Ja. Ein Prompt an Claude Haiku 5.5 mit 102,011 Token, davon 96,045 aus dem Cache gelesen, wurde zum höheren Tarif abgerechnet: $0.0078 statt $0.0016 zum niedrigeren. Die Prompt-Länge setzt sich aus Input ohne Cache, Cache Reads und Cache Writes zusammen. In der Preisliste von Anthropic steht das nicht. Zehn solche Requests, die wir direkt an die API gesendet haben, wurden auf unserer Anthropic-Rechnung aber zum höheren Tarif berechnet. Output-Token zählen nicht mit.
Ist Claude Haiku 5.5 günstiger als Claude Haiku 4.5?
Ja, auf beiden Seiten der Grenze. Die Ersparnis ist aber kleiner, als die Preisliste vermuten lässt, weil derselbe Text auf dem neuen Modell mehr Token ergibt. Bei englischem Fließtext haben wir 1.48-mal so viele Token gemessen. Damit ist Claude Haiku 5.5 unterhalb von 100,000 Token etwa 85% günstiger als Claude Haiku 4.5, oberhalb etwa 26%.
Ist Claude Haiku 5.5 günstiger als GPT-6 Luna?
Nicht in unseren Läufen, obwohl die Listenpreise gleich sind. Bei 96 kurzen Aufgaben kostete Claude Haiku 5.5 mit den Standardeinstellungen $0.107 pro 1,000 Aufrufe, GPT-6 Luna $0.049, bei gleicher Genauigkeit. Haiku 5.5 zählte für dieselben Aufgaben etwa doppelt so viele Input-Token und schrieb mehr Output.
Wie halte ich Requests an Claude Haiku 5.5 unter 100,000 Token?
Die Token vor dem Senden zählen und in Agent-Loops verhindern, dass sich alte Tool-Ergebnisse ansammeln. Die Unterhaltung lässt sich vor Erreichen der Grenze in einer Notiz zusammenfassen. Alternativ kann ein separater Request jeden großen Input lesen und nur das Ergebnis zurückgeben. In unserem Test mit Claude Haiku 5.5 sanken die Kosten für eine Aufgabe dadurch von $0.082 auf $0.026 beziehungsweise $0.016. Jeder Lauf lieferte die richtige Antwort.
Weiterlesen
- Preisstaffeln für lange Kontexte: weitere Modelle, deren Preis von der Prompt-Länge abhängt.
- Claude Sonnet 5.5 im Vergleich zu Sonnet 5: Effort und Kosten pro Aufgabe in der nächsthöheren Modellstufe.
- GPT-6 Luna: Was die Reasoning-Einstellung kostet: das Modell mit demselben Listenpreis.
- Der Tokenizer von Claude Sonnet 5: diesen Tokenizer verwendet jetzt auch Haiku 5.5.