
Gemini 4 Argon: GPT-6.1 Sol-Preis, 3x Kosten pro richtiger Antwort
Inhalt
- Was kostet Gemini 4 Argon?
- Mit welchen OpenAI- und Claude-Modellen konkurriert Gemini 4 Argon?
- Wie liegen Argons Kosten pro Antwort gegenüber GPT-6.1 Sol, GPT-6 Astra und Opus 5.5?
- Was bewirken die einzelnen Thinking-Stufen?
- Was funktioniert nach der Migration zu Gemini 4 Argon nicht mehr?
- Welche Thinking-Stufe passt zu welcher Arbeitslast?
- FAQ
- Weiterführende Artikel
Gemini 4 Argon kostet wie GPT-6.1 Sol $2 pro Million Eingabe-Tokens und $10 pro Million Ausgabe-Tokens. In unserem Testsatz mit 13 Reasoning-Aufgaben waren die Kosten pro richtiger Antwort trotzdem 3.1x so hoch: $0.0063 statt $0.0020, berechnet als Gesamtkosten geteilt durch die Zahl richtiger Antworten. Argon erzeugte für dasselbe Ergebnis, 38 richtige Antworten bei 39 Aufrufen, 3.3x so viele Ausgabe-Tokens. Gegenüber den Spitzenmodellen, mit denen Google es vergleicht, kehrt sich das Verhältnis um: Argon kostete 0.76x so viel wie Claude Opus 5.5 und 0.6x so viel wie GPT-6 Astra. Das gilt allerdings nur, bis sich der Preis am 1. Dezember verdoppelt. Der wichtigste Hebel für die Kosten ist thinking_level. Dieser Request-Parameter legt fest, wie lange gemini-4-argon vor der Antwort nachdenkt: low, standardmäßig medium oder high. Reasoning-Tokens werden als Ausgabe abgerechnet, auch wenn sie in der Antwort nicht sichtbar sind. Wir haben alle drei Stufen zwei Tage nach dem API-Start gemessen. Die Vergleichsmodelle und Gemini 3.1 Pro liefen am selben Tag.
TL;DR
- Gemini 4 Argon kostet bis zum 30. November 2026 $2/$10 pro Million Tokens, danach $4/$20.
- Google vergleicht Argon mit GPT-6 Astra, Claude Fable 5.1 und Claude Opus 5.5. Argon liegt in 13 der 19 veröffentlichten Zeilen vorn.
- Mit
mediumkostete eine richtige Antwort bei Argon $0.0063, bei GPT-6.1 Sol $0.0020 und bei Opus 5.5 $0.0083. Zum Dezemberpreis kostet Argon $0.0125. - Mit
lowmeldete Argon kein Reasoning und beantwortete bei den fünf schwierigsten Aufgaben nur 1 von 15 Aufrufen richtig. Mitmediumwaren es 14 von 15.
Was kostet Gemini 4 Argon?
Der API-Preis von Gemini 4 Argon verdoppelt sich am 1. Dezember 2026. Auf Googles Preisseite stehen ein Preis bis zum 30. November und der reguläre Listenpreis für die Zeit danach. Ein kostenloses Kontingent gibt es nicht. Gecachte Eingaben sind Texte, die der Server bereits in einem früheren Request gesehen hat, etwa ein wiederholter System-Prompt. Sie kosten 5% des Eingabepreises. Die Preise gelten in Dollar pro Million Tokens:
| Tarif | Eingabe | Ausgabe (einschließlich Thinking) | Gecachte Eingabe |
|---|---|---|---|
| Standard, bis 30. November | $2.00 | $10.00 | $0.10 |
| Standard, ab 1. Dezember | $4.00 | $20.00 | $0.20 |
| Batch und Flex, bis 30. November | $1.00 | $5.00 | $0.05 |
| Priority, bis 30. November | $3.60 | $18.00 | $0.18 |
Batch (als Job eingereicht, Ergebnisse innerhalb von Stunden) und Flex (Kapazität nach Verfügbarkeit) bleiben auch nach dem 1. Dezember bei der Hälfte des Standardpreises. Priority (reservierte Kapazität) bleibt bei 1.8x. Gegenüber Gemini 3.1 Pro, Googles bisherigem Spitzenmodell für $2/$12, gibt es drei Unterschiede:
- Kein Aufpreis für langen Kontext. Gemini 3.1 Pro verlangt $4/$18, sobald ein Prompt 200K Tokens überschreitet. Argon bleibt bei $2/$10 bis zur Grenze seines Kontextfensters von 1,048,576 Tokens. Das ist die maximale Tokenzahl eines Requests, einschließlich Eingabe, Thinking und Antwort. Zum Listenpreis kostete unser Prompt mit 709K Tokens auf Argon $1.42 und auf 3.1 Pro $2.84.
- Nur implizites Caching. Explizites Caching, bei dem man ein Cache-Objekt angelegt und für dessen Speicherung bezahlt hat, entfällt. Wiederholte Prompt-Präfixe werden automatisch gecacht und zum Preis für gecachte Eingaben abgerechnet.
- Ausgaben über 64K brauchen einen anderen Modus. Ein normaler Request liefert höchstens 65,536 Ausgabe-Tokens. Für längere Ausgaben ist Googles Modus für Hintergrundausführung nötig. Dabei generiert der Server in Schritten von 64K weiter, bis zu 1M Tokens.
Mit welchen OpenAI- und Claude-Modellen konkurriert Gemini 4 Argon?
Bei der Leistungsfähigkeit stellt Google Gemini 4 Argon den Spitzenmodellen der anderen Anbieter gegenüber: GPT-6 Astra, Claude Fable 5.1 und Claude Opus 5.5. Preislich liegt es eine Klasse darunter: bis zum 30. November bei den $2/$10 von GPT-6.1 Sol, ab dem 1. Dezember bei den $4/$20 von Opus 5.5. GPT-6 Astra und Fable 5.1 kosten laut Liste $10/$50.
Der Artificial Analysis Intelligence Index kombiniert Benchmarks für Agenten, Programmierung, Wissen und Wissenschaft, die Artificial Analysis selbst ausführt. Er weist auch aus, was die Ausführung einer Index-Aufgabe mit dem jeweiligen Modell kostet. Argon liegt dort gleichauf mit GPT-6 Astra und Fable 5.1. Opus 5.5 liegt vier bis fünf Punkte vorn:
| Modell | Listenpreis, $ pro Million Tokens | In Googles Benchmark-Tabelle | Indexwert (höchste Einstellung des Anbieters) | Kosten pro Index-Aufgabe |
|---|---|---|---|---|
| Gemini 4 Argon | 2/10, danach 4/20 | Gegenstand des Vergleichs | 52.6 | $1.99 |
| GPT-6 Astra | 10/50 | Ja | 52.7 | $3.26 |
| Claude Fable 5.1 | 10/50 | Ja | 53.4 | $7.63 |
| Claude Opus 5.5 | 4/20 | Ja | 57.6 | $5.98 |
| GPT-6.1 Sol | 2/10 | Nein | 51.8 | $0.72 |
Googles eigene Tabelle aus der Argon-Modellkarte hat 19 Zeilen. Argon führt in 13 und liegt in einer gleichauf; GPT-6 Astra führt in drei, Opus 5.5 in zwei. Unten stehen zehn der 19 Zeilen: die größten Abstände, die bei Wissensarbeit und langem Kontext auftreten, sowie alle fünf Zeilen, in denen Argon verliert. Bei diesen geht es um stundenlange Programmieraufgaben, Terminal-Arbeit und Desktop-Bedienung. Die Ergebnisse sind Prozentwerte; höher ist besser:
| Benchmark | Was getestet wird | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|---|
| Vals Index | Kombinierter Test von Vals AI für Wissensarbeit | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey Legal Agent | Vom Modell vollständig bearbeitete juristische Aufgaben | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | Issues in echten Repositories beheben | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | Stundenlange Entwicklungs- und Optimierungsaufgaben | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | Aufgaben in einem Linux-Terminal | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | Ein Modell auf einer GPU in 10 Stunden trainieren | 45.3% | 44.3% | 40.2% | 49.3% |
| Terminal-Bench Science 0.1 | Wissenschaftliches Rechnen im Terminal | 57.6% | 68.1% | 52.6% | 63.3% |
| RiemannBench | Mathematikprobleme auf Forschungsniveau | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks, 256K bis 1M | Verknüpfungen in einem Graphen mit langem Kontext verfolgen | 84.2% | 71.8% | 65.0% | 66.8% |
| OSWorld 2.0, offline | Desktop-Bedienung | 69.2% | 72.6% | nicht angegeben | nicht angegeben |
Die Tabelle zeigt Googles Angaben, keinen kontrollierten Vergleich. Laut Googles Methodikhinweis lief Argon mit der höchsten Thinking-Einstellung. Die meisten Werte der Konkurrenz stammen aus den Evaluationsberichten der Anbieter oder aus öffentlichen Ranglisten, jeweils mit der höchsten oder besten verfügbaren Reasoning-Einstellung. Mehrere Argon-Ergebnisse (DeepSWE, beide Terminal-Bench-Zeilen, OSWorld) hat Google mit seinem eigenen Test-Harness erzeugt, also dem Code, der Aufgaben ausführt und bewertet. Die Konkurrenzwerte stammen dagegen aus anderen Quellen. Bei Terminal-Bench Science bekam das Bewertungsprogramm für Argon sechsmal so viel Zeit.
Wie liegen Argons Kosten pro Antwort gegenüber GPT-6.1 Sol, GPT-6 Astra und Opus 5.5?
Bei identischem Tokenpreis kostete eine richtige Antwort mit Gemini 4 Argon auf medium 3.1x so viel wie mit GPT-6.1 Sol. medium ist bei beiden die Standardeinstellung. Auf high waren es 7.7x. Beide erreichten mit medium 38/39. Gegenüber den Spitzenmodellen ist Argon derzeit günstiger: Die Kosten pro richtiger Antwort betragen 0.6x die von GPT-6 Astra und 0.76x die von Claude Opus 5.5.
Wir haben 13 Reasoning-Aufgaben mit Antworten verwendet, die ein kurzes Programm verifiziert hatte, und jede dreimal ausgeführt. Für jedes Modell und jede Stufe in der folgenden Tabelle gibt es damit 39 Aufrufe. Ein Aufruf zählt als richtig, wenn die ausgegebene ganze Zahl stimmt. Die acht leichteren Aufgaben: Primzahlen unter 60 summieren, die Ziffer 7 von 1 bis 500 zählen, ein Zugfahrplan, 7 hoch 222 modulo 1000, eine Regel 40-mal nacheinander anwenden, vierstellige durch 11 teilbare Zahlen mit unterschiedlichen Ziffern ohne Null, Gitterpfade um eine gesperrte Zelle und Möglichkeiten, 47 Cent zusammenzustellen. Die fünf schwierigsten Aufgaben nennen wir den schweren Testsatz: dieselbe Regel 200-mal anwenden, den Rest von 13 hoch 1001 bei Division durch 10007 bestimmen, ein 8x8-Gitter mit drei gesperrten Zellen, aus 10 Gegenständen eine Auswahl unter einem Gewichtslimit treffen und 187 Cent mit fünf Münzsorten zusammenstellen.
Jedes Modell wurde über das Request-Format angesprochen, das seine Thinking-Steuerung unterstützt. Für Argon und Gemini 3.1 Pro war das OpenAIs älteres Chat-Format, das viele Anbieter nachbilden und in dem der Parameter reasoning_effort heißt. Die GPT-Modelle liefen über OpenAIs neueres Responses-Format, Opus 5.5 über Anthropics eigenes Format mit output_config.effort. Wir verwendeten bei jedem Anbieter medium und high, außerdem low, sofern das Modell diese Stufe anbietet.
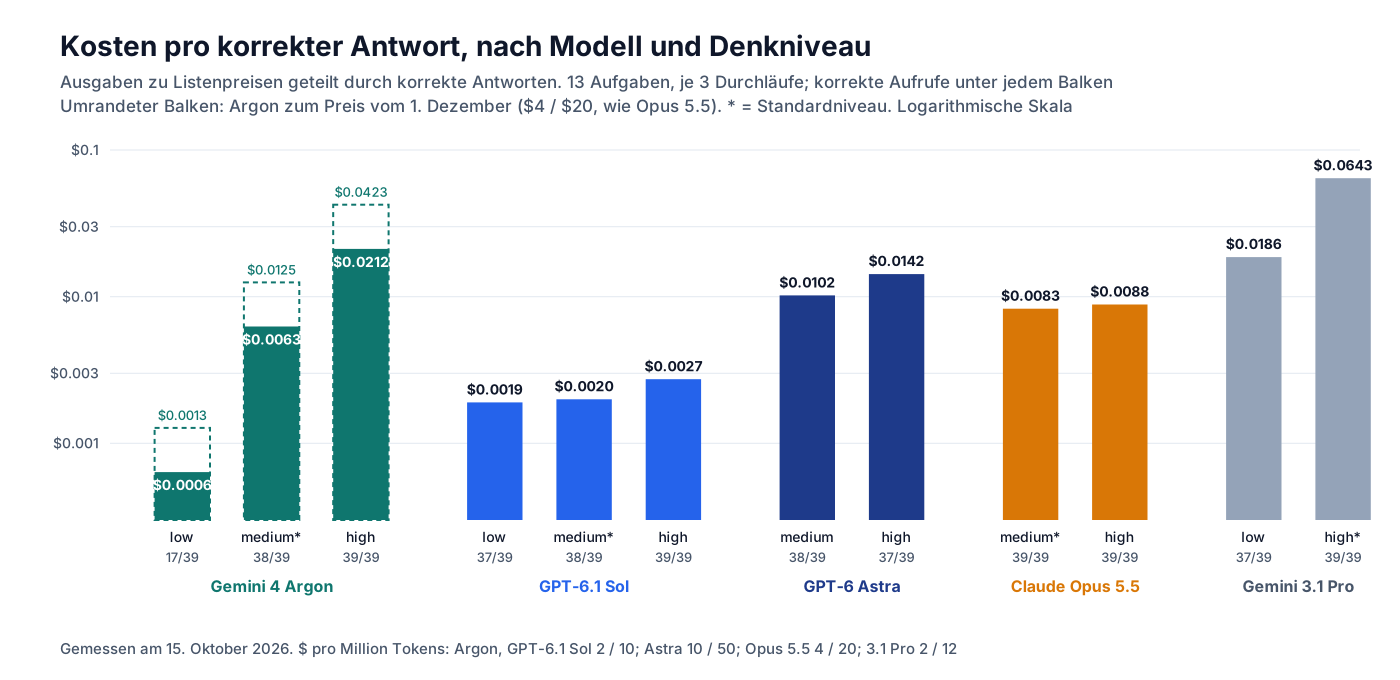
| Modell und Stufe | Richtige Aufrufe (von 24 leichten / von 15 schweren) | Median der Ausgabe-Tokens (einschließlich Thinking) | Kosten pro richtiger Antwort | Zum Dezemberpreis von Argon |
|---|---|---|---|---|
Argon low | 16/24, 1/15 | 7 | $0.0006 | $0.0013 |
Argon medium (Standard) | 24/24, 14/15 | 383 | $0.0063 | $0.0125 |
Argon high | 24/24, 15/15 | 1,455 | $0.0212 | $0.0423 |
GPT-6.1 Sol low | 24/24, 13/15 | 90 | $0.0019 | |
GPT-6.1 Sol medium (Standard) | 24/24, 14/15 | 81 | $0.0020 | |
GPT-6.1 Sol high | 24/24, 15/15 | 192 | $0.0027 | |
GPT-6 Astra medium (Standard) | 24/24, 14/15 | 90 | $0.0102 | |
GPT-6 Astra high | 24/24, 13/15 | 134 | $0.0142 | |
Claude Opus 5.5 medium (Standard) | 24/24, 15/15 | 188 | $0.0083 | |
Claude Opus 5.5 high | 24/24, 15/15 | 223 | $0.0088 | |
Gemini 3.1 Pro low | 24/24, 13/15 | 1,091 | $0.0186 | |
Gemini 3.1 Pro high (Standard) | 24/24, 15/15 | 3,272 | $0.0643 |
Der Abstand zu GPT-6.1 Sol entsteht durch die Ausgabelänge. Über alle 39 Aufrufe mit medium erzeugte Argon insgesamt 22,980 Ausgabe-Tokens, GPT-6.1 Sol dagegen 7,032. Bei der schwierigsten Einzelaufgabe, 13 hoch 1001 modulo 10007, lag Argons Median bei 1,523 Tokens mit medium und 6,108 mit high. Bei GPT-6.1 Sol waren es 524 und 901. Die Ergebnisse im schweren Testsatz waren identisch: jeweils 14/15 mit medium und 15/15 mit high. Ab dem 1. Dezember verdoppelt sich der Abstand bei medium auf 6.3x, weil sich Argons Preis verdoppelt, der von GPT-6.1 Sol aber nicht.
Im Dezember ändert sich auch der Vergleich mit Opus 5.5. Beide kosten dann laut Liste $4/$20. In unserem Testsatz erzeugte Opus 5.5 weniger Tokens (15,414 gegenüber Argons 22,980 mit medium) und beantwortete alle 39 Aufrufe richtig. Zum Dezemberpreis kostet Argon $0.0125 pro richtiger Antwort gegenüber $0.0083 bei Opus 5.5, also 1.5x so viel. Gegenüber GPT-6 Astra steigt das Verhältnis von 0.6x auf 1.2x. Bei 15 Aufrufen im schweren Testsatz pro Stufe sind die Ergebnisunterschiede zwischen Argon, Opus 5.5 und GPT-6 Astra statistisch nicht unterscheidbar. Diese Paare wurden getrennt von der Gruppe der Vergleiche geprüft, auf die wir im nächsten Abschnitt eine Korrektur anwenden. Die Kosten pro Aufgabe von Artificial Analysis ergeben dieselbe Reihenfolge: GPT-6.1 Sol $0.72 auf der höchsten Stufe, Argon $1.99 mit high zum aktuellen Preis, GPT-6 Astra $3.26, Opus 5.5 $5.98.
Gegenüber Gemini 3.1 Pro, das Argon ablöst, ist Argon mit der jeweiligen Standardeinstellung pro richtiger Antwort etwa 10x günstiger: $0.0063 gegenüber $0.0643. Ein Teil davon liegt am Preis, denn 3.1 Pro verlangt $12 statt $10 pro Million Ausgabe-Tokens. Bei gleichen Preisen beträgt der Abstand 8.6x. Er entsteht durch den Median von 3,272 Ausgabe-Tokens pro Aufruf bei 3.1 Pro gegenüber 383 bei Argon. Nach dem 1. Dezember bleibt Argon in diesem Testsatz noch 5.1x günstiger. Wir haben außerdem geprüft, wie viele Tokens die Modelle dafür brauchen, bei erfundenen Fakten ihr Nichtwissen einzugestehen. Wir fragten nach fünf erfundenen Dingen: dem Aktienkurs eines Unternehmens, einem Forschungsinstitut, einer Stadtrechtsurkunde, einer Legierung und einem Preis. Beide Modelle lehnten alle fünf Antworten ab, Argon mit einem Median von 146 Ausgabe-Tokens, 3.1 Pro mit 1,014.
Was bewirken die einzelnen Thinking-Stufen?
Bei Gemini 4 Argon schaltete low das Thinking faktisch ab. Google dokumentiert drei Stufen und beschreibt low als die Stufe mit dem „geringsten Tokenverbrauch“. Dazu kommt der Hinweis, dass „die Qualität bei schwierigen Aufgaben sinken kann“. In allen 39 Aufrufen mit low meldete Argon keine Reasoning-Tokens, und seine gesamte Ausgabe, die bei diesem API-Zugang auch etwaiges Reasoning umfasst, betrug 5 bis 11 Tokens. Ein zweiter API-Zugang, der Requests an Googles Server weiterleitet, meldete bei allen vier darüber gesendeten low-Aufrufen ausdrücklich 0 Reasoning-Tokens. Gemini 3.1 Pro erzeugte mit low dagegen weiterhin einen Median von 1,091 Ausgabe-Tokens, fast ausschließlich für Reasoning.
Ohne Reasoning löste Argon weiterhin die einschrittigen Aufgaben, scheiterte aber an Aufgaben mit Zwischenschritten:
- Mit
lowweiterhin richtig: Primzahlsumme, Ziffernzählung, Fahrplan, Gitter mit einer gesperrten Zelle und 47 Cent (15 von 15 Aufrufen). - Mit
lowfalsch: die Regel mit 40 Schritten (0/3), das Zählen vierstelliger Zahlen (0/3), 7 hoch 222 (1/3) und 14 von 15 Aufrufen im schweren Testsatz.
Der Rückgang bleibt bestehen, wenn jede Aufgabe nur einmal zählt, was wichtig ist, weil drei Durchläufe derselben Aufgabe nicht unabhängig sind: medium war bei 8 der 13 Aufgaben besser als low und bei keiner schlechter (Vorzeichentest, p = 0.008, eine Wahrscheinlichkeit von unter 1%, dass ein so großer Abstand zufällig entsteht). Im schweren Testsatz allein löste low keine der fünf Aufgaben in mindestens zwei von drei Durchläufen und medium alle fünf (exakter Test nach Fisher, p = 0.008; 0.047 nach der Holm-Korrektur für die sechs von uns ausgeführten Vergleiche). Behandelt low als Modus ohne Thinking für Nachschlagen und Formatkonvertierung. Am anderen Ende kostete high pro richtiger Antwort 3.4x so viel wie medium und beantwortete im schweren Testsatz einen zusätzlichen von 15 Aufrufen richtig. Mit dieser Stichprobe lässt sich der Unterschied nicht vom Zufall trennen.
Die Standardeinstellung passt sich dem Prompt an. Bei einfachen Prompts ohne explizite Stufe verwendete Argon, dessen Standard medium ist, häufig keine Reasoning-Tokens. Gemini 3.1 Pro, dessen Standard high ist, nutzte dagegen bei jedem dieser Prompts Reasoning. Bei Tool Calling fordert das Modell euren Code auf, eine Funktion auszuführen; anschließend schickt ihr das Ergebnis zurück:
| Prompt-Typ (Median aus 3 Durchläufen) | Argon-Reasoning-Tokens | Gemini 3.1 Pro-Reasoning-Tokens |
|---|---|---|
| Nachschlagen mit Ein-Wort-Antwort | 0 | 145 |
| JSON-Extraktion | 0 | 353 |
| Ausgabe nach strengem JSON-Schema | 0 | 309 |
| Textaufgabe mit zwei Schritten | 41 | 137 |
| Rechenkette mit fünf Schritten | 68 | 373 |
| Tool-Calling-Schleife, erster Turn (Tool auswählen) | 0 (31 Ausgabe-Tokens) | 173 |
| Tool-Calling-Schleife, zweiter Turn (Ergebnis verwenden) | 0 (32 Ausgabe-Tokens) | 67 |
Beide Modelle beantworteten jeden Prompt richtig und riefen die passenden Tools auf. In Googles nativer API steht die Stufe in generation_config, die Reasoning-Tokenzahl kommt in usage zurück:
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Compute 13 raised to the power 1001, modulo 10007. Reply with a single integer.",
    generation_config={"thinking_level": "medium", "max_output_tokens": 32768},
)
print(interaction.output_text)
print("thinking tokens:", interaction.usage.total_thought_tokens)  # billed at the output rate
print("output tokens:", interaction.usage.total_output_tokens)
Im OpenAI-kompatiblen Chat-Format, über das wir gemessen haben, bildet das Gateway reasoning_effort auf dieselben drei Stufen ab. Die Tokenzahl kommt in usage.completion_tokens_details.reasoning_tokens zurück.
Was funktioniert nach der Migration zu Gemini 4 Argon nicht mehr?
Prompts, die mit einem vorbefüllten Assistant-Turn enden, schlagen jetzt mit HTTP 400 fehl. Explizites Caching entfällt, und die Einstellungen für Zufälligkeit (temperature, top_p, top_k) werden ignoriert. Bei Prefilling beginnt man die Modellantwort selbst, etwa mit einer öffnenden geschweiften Klammer, um JSON zu erzwingen. Die meisten dieser Änderungen stehen in Googles Migrationscheckliste. Der Prefill-Fehler, der Prompt-Overhead und das Verhalten bei Überschreitung des Kontextfensters fehlen dort:
| Änderung | Googles Dokumentation | Unsere Messung |
|---|---|---|
| Vorbefüllter Assistant-Turn | Nicht aufgeführt | HTTP 400 bei Gemini 4 Argon: „Requests, die mit einem Modell-Turn enden, werden nicht unterstützt“; Gemini 3.1 Pro akzeptiert ihn |
Explizites Caching (cachedContents) | Entfernt | Nicht getestet; implizites Caching funktionierte |
| Impliziter Cache | 95% Rabatt, Prompts ab 4,096 Tokens | Bei einem wiederholten Prompt mit 6,935 Tokens kamen 4 Sekunden später 4,881 Tokens aus dem Cache, zum Preis von $0.10 pro Million; auch bei einem Prompt mit 3,006 Tokens wurden 952 Tokens gecacht |
temperature, top_p, top_k | Werden ignoriert | Mit HTTP 200 akzeptiert (kein Fehler) |
| Fester Prompt-Overhead | Nicht aufgeführt | Bei identischem Text etwa 30 Eingabe-Tokens mehr pro Request als bei Gemini 3.1 Pro; ein zweiter API-Zugang zu Google meldet dieselbe Zahl |
| Prompt über dem 1M-Kontextfenster | Nicht aufgeführt | HTTP 400 mit Angabe des Limits, keine stille Kürzung |
max_output_tokens | Auf 32,768 oder mehr erhöhen | Argons längste Antwort hatte mit high 6,391 Tokens, die von Gemini 3.1 Pro 21,362 |
Beim Prefill-Fehler gehört die Anweisung stattdessen in den Prompt. Der Overhead kostet zum aktuellen Preis zusätzlich $0.00006 pro Request und ist konstant: gegenüber Gemini 3.1 Pro 27 zusätzliche Tokens bei einem einzeiligen Prompt und 31 bei einem Dokument mit 709K Tokens. Der Tokenizer, der Text in Tokens zerlegt, hat sich also nicht geändert. Dieser Prompt mit 709K Tokens enthielt 60,000 nummerierte Einträge und am Ende eine Frage zu Eintrag 42. Argon akzeptierte ihn und antwortete mit 529, dem dort hinterlegten Wert.
Welche Thinking-Stufe passt zu welcher Arbeitslast?
Startet mit medium, verwendet low nie für mehrschrittige Aufgaben und plant mit dem Dezemberpreis.
| Arbeitslast | Hauptrisiko | Stufe und Modell | Zahlen dazu |
|---|---|---|---|
| Agentenschritte, Tool-Aufrufe, Extraktion, JSON-Ausgabe | Für Thinking bei einfachen Schritten bezahlen | Gemini 4 Argon medium; hier verbraucht es ohnehin fast nichts für Thinking | 0 Reasoning-Tokens bei Nachschlagen, Extraktion, Schema-Ausgabe und Tool-Schritten |
| Schwierige Mathematik, Algorithmen, mehrschrittige Programmieraufgaben | Falsche Antworten | Argon medium; high erst mit eigenen Evals testen, bevor ihr dafür bezahlt | 14/15 gegenüber 15/15 Aufrufen im schweren Testsatz, high mit 3.4x den Kosten |
| Viel Reasoning mit Fokus auf Kosten pro Antwort | Umfang des Thinking | GPT-6.1 Sol, gleiches Ergebnis in diesem Testsatz mit 13 Aufgaben | $0.0020 gegenüber $0.0063 pro richtiger Antwort, 6.3x ab 1. Dezember |
| Anspruchsvolle Aufgaben mit Budgetplanung über Dezember hinaus | Verdoppelung von Argons Preis | Evals erneut mit Claude Opus 5.5 ausführen, gleicher Listenpreis von $4/$20 | $0.0083 gegenüber $0.0125 pro richtiger Antwort zum Dezemberpreis; Argon führt in mehr Zeilen von Googles Tests zur Wissensarbeit |
| Lange Dokumente über 200K Tokens | Aufpreis für langen Kontext | Argon statt Gemini 3.1 Pro | $1.42 gegenüber $2.84 für einen Prompt mit 709K Tokens |
| Nur Nachschlagen und Formatkonvertierung | Unnötiges Reasoning | Argon low | 15/15 bei einschrittigen Aufgaben, 7 Ausgabe-Tokens |
Nach dem 1. Dezember kosten Batch und Flex so viel wie Standard heute ($2/$10). Wer Offline-Jobs dorthin verlagert, bleibt damit bei den Oktoberpreisen.
FAQ
Lässt sich Thinking bei Gemini 4 Argon abschalten?
Gemini 4 Argon hat keine dokumentierte Einstellung zum Abschalten. In unseren Tests wirkte thinking_level: "low" aber genau so: keine Reasoning-Tokens bei allen 39 Aufrufen gemeldet, deren gesamte Ausgabe jeweils 5 bis 11 Tokens umfasste, und eine explizite 0 bei allen vier Aufrufen über einen zweiten API-Zugang zu Google. Mit low beantwortete es bei den fünf schwierigsten Aufgaben 1 von 15 Aufrufen richtig, mit der Standardeinstellung medium dagegen 14 von 15.
Kosten lange Prompts bei Gemini 4 Argon mehr? Gemini 4 Argon berechnet bis zum 30. November 2026 für jeden Prompt innerhalb seines Kontextfensters von 1,048,576 Tokens denselben Tarif von $2/$10, danach $4/$20. Gemini 3.1 Pro verlangt oberhalb von 200K Tokens $4/$18. Zum Listenpreis kostet ein Prompt mit 709K Tokens deshalb auf Argon $1.42 und auf 3.1 Pro $2.84.
Funktioniert implizites Caching bei Gemini 4 Argon? Bei Gemini 4 Argon kamen 4 Sekunden nach dem ersten Aufruf 4,881 Tokens eines wiederholten Prompts mit 6,935 Tokens aus dem impliziten Cache. Der Preis betrug $0.10 pro Million Tokens (95% Rabatt auf die Eingabe). Auch ein Teil eines Prompts mit 3,006 Tokens wurde gecacht, obwohl er unter dem in Googles Dokumentation genannten Minimum von 4,096 Tokens lag.
Weiterführende Artikel
- GPT-6.1 Sol vs. Claude Sonnet 5.5: derselbe Testsatz mit 13 Aufgaben zum selben Preis von $2/$10
- Thinking-Steuerung bei LLMs im Vergleich: was der Effort-Parameter bei den einzelnen Anbietern bewirkt
- Mindestgrößen für Prompt-Caches im Test: dokumentierte und tatsächliche Cache-Untergrenzen
- API-Kosten von Gemini 3.7 Flash: der vorherige Gemini-Start mit Einführungspreisen
Gemessen am 15. Oktober 2026, zwei Tage nach der allgemeinen Verfügbarkeit der API. Thinking-Stufen: 13 Aufgaben mit programmatisch verifizierten Antworten, 3 Durchläufe pro Modell und Stufe, Signifikanz getestet, wobei jede Aufgabe einmal gezählt wurde. Jeder Prompt erhielt eine zufällige ID, damit keine Antwort aus einem Cache kommen konnte; die Kosten wurden anhand der Tokenzahlen zum Listenpreis berechnet. Tests zum Thinking-Overhead, zu strukturierten Ausgaben und zu Tools: jeweils 3 Durchläufe. Tests zu Migration, Cache, langem Kontext und erfundenen Fakten: einzelne Aufrufe. Das low-Ergebnis und der Prompt-Token-Overhead wurden über einen zweiten API-Zugang bestätigt, der an Google weiterleitet. Die Zahlen von Artificial Analysis wurden am 14. Oktober 2026 abgerufen; Googles Benchmark-Tabelle stammt aus der Modellkarte von Gemini 4 Argon.