
Precios de API LLM en 2026: tokens más caros, capacidad 50x menor
Contenido
- ¿Qué pasó con los precios de tarifa de las API de LLM en el último año?
- ¿Cómo fijaron Anthropic, OpenAI, Google y DeepSeek los precios de sus modelos a lo largo de dos años?
- ¿Los modelos se encarecieron o solo mejoraron en capacidad?
- ¿Cómo evolucionó el precio de cada categoría?
- ¿En qué se diferenció la estrategia de precios de cada laboratorio?
- ¿Cómo se compara la estrategia de precios de DeepSeek?
- ¿Cómo se comparan los cuatro laboratorios?
- ¿Cómo evolucionó el precio de cada categoría?
- ¿Cuánto cuesta ahora alcanzar un nivel de capacidad determinado?
- ¿Por qué evolucionaron así los precios?
- ¿Por qué el precio por token no equivale al precio por tarea?
- ¿Cómo cambiaron los precios de caché respecto a los de entrada?
- ¿Qué hacer con estos datos?
- Preguntas frecuentes
- Lecturas relacionadas
Entre octubre de 2025 y octubre de 2026, el precio de tarifa por token de las API de LLM subió en 10 de 14 gamas. Aun así, el modelo más barato capaz de alcanzar un nivel de rendimiento determinado pasó a costar mucho menos por token: entre 17 y 50 veces menos para los niveles 20 a 40 del índice, y 2.5 veces menos para el nivel 50. Una gama es una línea de productos de un proveedor, como Claude Opus o Gemini Flash. Medimos la capacidad con la puntuación del modelo en el Artificial Analysis Intelligence Index, un índice independiente que combina varias pruebas y puntúa de 0 a 100 (el mejor modelo actual obtiene 57.6). Los precios son combinados: dólares por millón de tokens, con tres tokens de entrada por cada token de salida. Ambas tendencias se dan a la vez porque cada modelo nuevo de una gama supera en capacidad al que sustituye.
TL;DR
- Entre octubre de 2025 y octubre de 2026, el precio de tarifa de entrada subió en 10 de 14 gamas; las 3 que bajaron son de Anthropic.
- El modelo más barato con 40 puntos en el índice de Artificial Analysis pasó de $10 a $0.20 por millón de tokens combinados entre abril y octubre de 2026.
- Desde octubre de 2024, Anthropic rebajó sus tres gamas (Opus pasó de $15 / $75 a $4 / $20), Google subió las tres y OpenAI solo subió la gama media.
- La diferencia entre los precios de entrada de los modelos insignia cerrados se redujo de 12x a 2x; la mediana de precios de los insignia de pesos abiertos se duplicó.
¿Qué pasó con los precios de tarifa de las API de LLM en el último año?
La mayoría de las gamas cuestan más por token que hace un año. Comparamos el modelo que ocupaba cada gama el 15 de octubre de 2025 con el que la ocupaba el 15 de octubre de 2026:
| Gama | Modelo de octubre de 2025, $ por millón de tokens (entrada / salida) | Modelo de octubre de 2026, $ por millón de tokens (entrada / salida) | Precio de entrada, 2026 frente a 2025 |
|---|---|---|---|
| Insignia de OpenAI | GPT-5, $1.25 / $10 | GPT-6.1 Sol, $2 / $10 | 1.6x |
| Gama media de OpenAI | GPT-5 mini, $0.25 / $2 | GPT-5.6 Terra, $2 / $12 | 8x |
| Gama pequeña de OpenAI | GPT-5 nano, $0.05 / $0.40 | GPT-6 Luna, $0.10 / $0.50 | 2x |
| Claude Opus | Opus 4.1, $15 / $75 | Opus 5.5, $4 / $20 | 0.27x |
| Claude Sonnet | Sonnet 4.5, $3 / $15 | Sonnet 5.5, $2 / $10 | 0.67x |
| Claude Haiku | Haiku 4.5, $1 / $5 | Haiku 5.5, $0.10 / $0.50 | 0.1x |
| Gemini Pro | Gemini 2.5 Pro, $1.25 / $10 | Gemini 4 Argon, $2 / $10 | 1.6x |
| Gemini Flash | Gemini 2.5 Flash, $0.30 / $2.50 | Gemini 3.8 Flash, $0.75 / $3.75 | 2.5x |
| Gemini Flash-Lite | Gemini 2.5 Flash-Lite, $0.10 / $0.40 | Gemini 3.5 Flash-Lite, $0.30 / $2.50 | 3x |
| Gama económica de DeepSeek | V3.2-Exp, $0.28 / $0.42 | V4.1 Flash, $0.30 / $1.20 en horas punta | 1.07x |
| Insignia de Zhipu GLM | GLM-4.6, $0.60 / $2.20 | GLM-5.3, $1.40 / $4.40 | 2.3x |
| Insignia de Moonshot Kimi | Kimi K2, $0.60 / $2.50 | Kimi K3, $3 / $15 | 5x |
| Alibaba Qwen Max | Qwen3-Max, $1.20 / $6 | Qwen3.8 Max, $2 / $6 | 1.67x |
| MiniMax | M2 (desde el 23 de octubre), $0.30 / $1.20 | M3, $0.30 / $1.20 | 1x |
Algunos precios están sujetos a condiciones: las tarifas de Argon y Gemini 3.8 Flash son de lanzamiento y se duplican el 1 de diciembre y el 1 de enero, respectivamente; Haiku 5.5 cuesta $0.50 / $2.50 por encima de 100,000 tokens de prompt; y la fila de DeepSeek usa la tarifa punta, que se aplica en horario laboral de Pekín (la tarifa valle es la mitad y queda por debajo del precio combinado de V3.2-Exp). El recuento de 10 de 14 no cambia si se usan los precios combinados en lugar de los de entrada. Los precios de Kimi K2 y Qwen3-Max proceden de registros de terceros.
¿Cómo fijaron Anthropic, OpenAI, Google y DeepSeek los precios de sus modelos a lo largo de dos años?
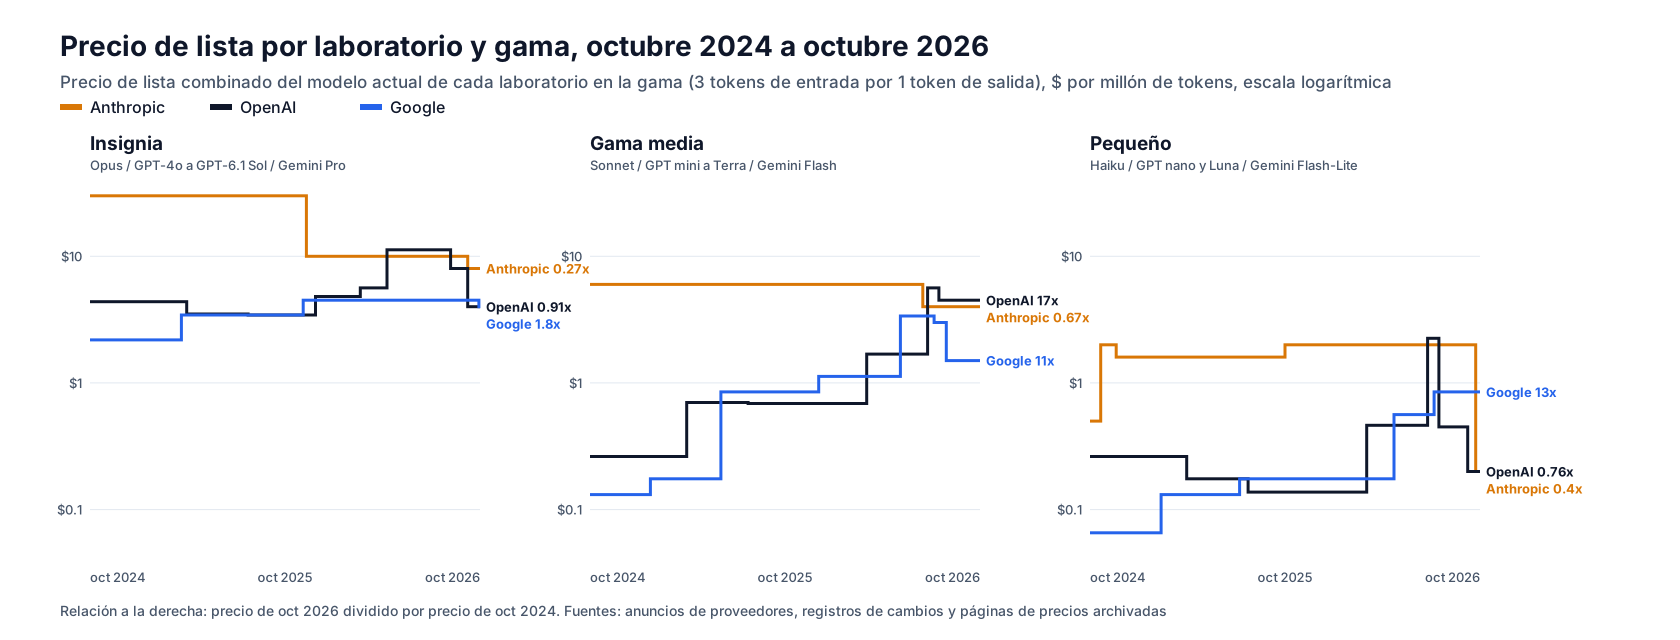
En dos años, Anthropic bajó los precios de tarifa de sus tres gamas. El modelo insignia y el pequeño de OpenAI terminaron cerca de sus precios iniciales, mientras que el de gama media subió 17x. Google subió los precios de todas sus gamas, y el modelo económico de DeepSeek pasó a costar unas 3x más en horas punta, mientras que su precio de lectura de caché cayó al 2% del precio de entrada. El gráfico y las tablas siguientes muestran la evolución de los tres mayores laboratorios de modelos cerrados desde octubre de 2024, siguiendo el modelo insignia, el de gama media y el pequeño vigentes en cada momento. DeepSeek vende uno o dos modelos en lugar de ofrecer tres gamas, por lo que tiene su propia subsección. La última tabla compara los cuatro laboratorios.
| Gama | Anthropic | OpenAI | |
|---|---|---|---|
| Insignia | De Claude 3 Opus a $15 / $75 a Opus 5.5 a $4 / $20: 0.27x | De GPT-4o a $2.50 / $10 a GPT-6.1 Sol a $2 / $10: 0.91x | De Gemini 1.5 Pro a $1.25 / $5 a Gemini 4 Argon a $2 / $10: 1.8x |
| Gama media | De Claude 3.5 Sonnet a $3 / $15 a Sonnet 5.5 a $2 / $10: 0.67x | De GPT-4o mini a $0.15 / $0.60 a GPT-5.6 Terra a $2 / $12: 17x | De Gemini 1.5 Flash a $0.075 / $0.30 a Gemini 3.8 Flash a $0.75 / $3.75: 11x |
| Gama pequeña | De Claude 3 Haiku a $0.25 / $1.25 a Haiku 5.5 a $0.10 / $0.50: 0.4x | De GPT-4o mini a GPT-6 Luna a $0.10 / $0.50: 0.76x | De Gemini 1.5 Flash-8B a $0.0375 / $0.15 a Gemini 3.5 Flash-Lite a $0.30 / $2.50: 13x |
Los precios corresponden al 15 de octubre de cada año, y la proporción compara los precios combinados. GPT-4o mini aparece como modelo inicial en las dos filas de las gamas inferiores de OpenAI porque OpenAI no tuvo un modelo pequeño independiente hasta la llegada de GPT-4.1 nano en abril de 2025.
¿Los modelos se encarecieron o solo mejoraron en capacidad?
La mayoría de los modelos ganaron capacidad. Entre octubre de 2025 y octubre de 2026, la puntuación en el índice del modelo vigente de cada gama se multiplicó entre 1.9 y 3.3 veces. El precio por punto del índice (precio combinado dividido por la puntuación; un valor inferior a 1x indica que la misma capacidad pasó a costar menos) bajó en siete de las nueve gamas. El índice solo tiene puntuaciones de modelos desde mediados de 2025, por lo que esta comparación abarca el segundo año:
| Laboratorio y gama | Índice, octubre de 2025 a octubre de 2026 | Precio combinado | Precio por punto del índice |
|---|---|---|---|
| Insignia de Anthropic | 22.8 a 57.6 | $30.00 a $8.00 | 0.11x |
| Gama media de Anthropic | 19.3 a 35.9 (ajuste predeterminado) | $6.00 a $4.00 | 0.36x |
| Gama pequeña de Anthropic | 16.9 a 43.4 | $2.00 a $0.20 | 0.04x |
| Insignia de OpenAI | 23.0 a 51.8 | $3.44 a $4.00 | 0.52x |
| Gama media de OpenAI | 16.8 a 42.1 | $0.69 a $4.50 | 2.6x |
| Gama pequeña de OpenAI | 13.0 a 38.1 | $0.14 a $0.20 | 0.50x |
| Insignia de Google | 16.1 a 52.6 | $3.44 a $4.00 | 0.36x |
| Gama media de Google | 13.1 a 40.9 | $0.85 a $1.50 | 0.57x |
| Gama pequeña de Google | 8.5 a 22.2 | $0.18 a $0.85 | 1.9x |
Los modelos son los de la primera tabla. Las puntuaciones corresponden al ajuste de razonamiento más alto de cada modelo (la opción de la petición que le permite pensar más tiempo antes de responder). En Sonnet se usa el ajuste predeterminado, el único con puntuación para las versiones antiguas, y las puntuaciones de octubre de 2025 de los modelos antiguos son estimaciones de Artificial Analysis. El precio por punto solo subió cuando un laboratorio aumentó el precio de un modelo en mayor proporción que su capacidad.
¿Cómo evolucionó el precio de cada categoría?
Los precios de la gama insignia convergieron, los de la gama media subieron y los de la gama pequeña tomaron caminos distintos. En octubre de 2024, el precio de entrada más alto entre los insignia era 12 veces el más bajo (Claude 3 Opus a $15, Gemini 1.5 Pro a $1.25), y en octubre de 2025 la diferencia seguía siendo de 12 veces. Hoy es de 2 veces. Durante ese periodo, el insignia de OpenAI subió a $5 / $30 con GPT-5.5 en abril de 2026, antes de bajar a $2 / $10. Los modelos de gama media ya superan las puntuaciones de los insignia de hace un año, y OpenAI y Google fijaron sus precios en consecuencia. Así, la diferencia entre los precios de entrada de la gama media se redujo de 40x a 2.7x, y la rebaja de Sonnet la estrechó aún más. En la gama pequeña, OpenAI y Anthropic se situaron en $0.10 / $0.50, mientras que Gemini 3.5 Flash-Lite de Google cuesta lo mismo que costaba Gemini 2.5 Flash a mediados de 2025.
¿En qué se diferenció la estrategia de precios de cada laboratorio?
Anthropic mantuvo los precios durante largos periodos y aplicó rebajas escalonadas; OpenAI los revisó con frecuencia y atribuyó cada cambio a mejoras de capacidad o eficiencia; Google subió los precios con cada generación y anunció las subidas con antelación. Ninguno de los tres citó a un competidor como motivo para cambiar sus precios, ni siquiera cuando Opus 5.5, GPT-6 Sol y GPT-6 Luna se lanzaron el mismo día.
Anthropic: precios estables y después rebajas escalonadas. Sonnet se mantuvo en $3 / $15 desde marzo de 2024 hasta Sonnet 4.6 en 2026, y Opus en $15 / $75 hasta que Opus 4.5 bajó a $5 / $25 en noviembre de 2025, «para que aún más usuarios pudieran acceder a las capacidades de Opus» (Anthropic). Las siguientes rebajas llegaron con nuevos modelos: Opus 5.5 «requiere menos cómputo para atender las peticiones que Opus 5, y su precio lo refleja» (Anthropic), y el precio de lanzamiento de Sonnet 5, $2 / $10, pasó a ser su tarifa estándar en agosto. Las subidas se concentraron en la gama Haiku: Claude 3.5 Haiku se lanzó a $1 / $5 en noviembre de 2024 «para reflejar su mayor inteligencia» y bajó a $0.80 / $4 un mes después (TechCrunch), mientras que Haiku 4.5 volvió a $1 / $5 en octubre de 2025.
OpenAI: cambios de precio frecuentes, atribuidos a la capacidad o la eficiencia. Las subidas se justificaron por la capacidad: GPT-5.2 tenía «un precio por token más alto que GPT‑5.1 porque es un modelo más capaz» (OpenAI). Las rebajas se justificaron por el coste de servicio: o3 bajó un 80% en junio de 2025 porque «optimizamos la infraestructura de inferencia que ejecuta o3» (OpenAIDevs), y GPT-6 Sol y Luna se lanzaron a la mitad del precio de entrada de sus predecesores porque «las mejoras en caché e inferencia nos permiten ofrecer estos modelos a menor coste» (OpenAI). Los precios de lanzamiento duraron poco: los tres modelos GPT-5.6, lanzados en julio, bajaron de precio en un plazo de seis semanas. Reuters relacionó la rebaja de agosto de GPT-5.6 Sol con «la creciente competencia de Anthropic y los modelos de IA chinos»; OpenAI la atribuyó a la eficiencia.
Google: precios al alza y subidas programadas. Google empezó siendo el laboratorio más barato en todas las gamas y subió los precios con la mayoría de las generaciones, normalmente sin explicar el motivo. La excepción fue Gemini 2.5 Flash, cuyo precio de entrada se duplicó en junio de 2025 como «un ajuste específico que refleja el valor excepcional de Flash» (Google). Desde agosto, Google ha lanzado modelos con precios promocionales y una subida ya programada: Gemini 3.7 Flash y 3.8 Flash a $0.75 / $3.75 hasta el 31 de diciembre y después a $1.50 / $7.50, y Argon a $2 / $10 hasta el 30 de noviembre y después a $4 / $20. Google no explicó el motivo, pero Sundar Pichai dijo a los inversores en julio que «seguimos limitados por la capacidad disponible» (Alphabet).
¿Cómo se compara la estrategia de precios de DeepSeek?
DeepSeek bajó los precios cuando una nueva arquitectura redujo su coste de servicio y los subió cuando la demanda superó la capacidad de sus GPU. La eficiencia marcaba hasta dónde podía bajar; la capacidad de cómputo disponible determinaba el precio en cada momento. Buena parte de esto depende de la caché: cuando un prompt empieza con texto que el proveedor ya ha procesado, puede reutilizar el estado intermedio almacenado (la caché KV) en lugar de volver a calcularlo, y factura esos tokens de entrada como una lectura de caché, a una tarifa menor.
| Fecha | Cambio | Acierto de caché / fallo de caché / salida, $ por millón de tokens |
|---|---|---|
| Agosto de 2024 | Se lanza la caché de prompts en disco (DeepSeek V2, después V2.5) | $0.014 / $0.14 / $0.28 |
| Febrero de 2025 | V3 pasa a precio de tarifa tras la promoción de lanzamiento; desde el 26 de febrero, descuento nocturno del 50% en V3 y del 75% en R1, su modelo de razonamiento | $0.07 / $0.27 / $1.10 |
| 5 de septiembre de 2025 | Precio único para los modos con y sin razonamiento de V3.1; termina el descuento nocturno | $0.07 / $0.56 / $1.68 |
| 29 de septiembre de 2025 | V3.2-Exp, rebaja de más de la mitad | $0.028 / $0.28 / $0.42 |
| Abril de 2026 | Se lanza V4 Flash; dos días después, el precio de lectura de caché baja a una décima parte del precio de lanzamiento | $0.0028 / $0.14 / $0.28 |
| 17 de agosto de 2026 | Tarifas punta; la tarifa valle es la mitad de la tarifa punta | $0.014 / $0.44 / $1.32 en horas punta |
| 10 de septiembre de 2026 | V4.1 Flash sustituye a V4 Flash | $0.006 / $0.30 / $1.20 en horas punta |
Los precios corresponden al modelo más barato de DeepSeek en cada fecha. El horario punta es de 09:00 a 12:00 y de 14:00 a 18:00, hora de Pekín, los días laborables.
Eficiencia. Los anuncios de DeepSeek vinculan tres rebajas con mejoras de arquitectura. La caché en disco de 2024 se apoyaba en MLA, el diseño de atención comprimida de DeepSeek, que redujo la caché KV lo suficiente para almacenarla en discos baratos (DeepSeek). La rebaja de septiembre de 2025 llegó con DeepSeek Sparse Attention, que solo presta atención a un subconjunto de los tokens anteriores. El anuncio en chino atribuye la rebaja al coste de servicio mucho menor del nuevo modelo (DeepSeek). La caché KV de V4.1 Flash necesita «1/4 de la HBM» (memoria de GPU) y «1/8 del almacenamiento SSD» de su predecesor, y DeepSeek señaló que «los cargos por lecturas de caché suelen representar una gran parte del coste de los agentes» (DeepSeek). Su lectura de caché cuesta ahora el 2% del precio de entrada, frente al 10% en 2024 y al 2.5% a 10% que cobran hoy los laboratorios estadounidenses. DeepSeek solo ha publicado datos de servicio de un día, de marzo de 2025: el 56.3% de los tokens de entrada se leyeron de la caché en disco, con un margen teórico del 545% a $2 por hora de GPU, aunque los ingresos reales fueron «sustancialmente inferiores» (DeepSeek).
Capacidad. El mismo análisis señala que DeepSeek destina por la noche nodos de inferencia a investigación y entrenamiento, las horas de menor carga a las que se aplicaba su descuento nocturno de 2025. Las subidas llegaron cuando escaseaba la capacidad: la unificación de los modos de V3.1 en septiembre de 2025 eliminó ese descuento y duplicó el precio de entrada sin acierto de caché del modelo sin razonamiento, de $0.27 a $0.56, sin dar explicaciones (DeepSeek); las tarifas punta de agosto de 2026 triplicaron el precio de entrada de V4 Flash en las horas de mayor demanda para «asignar los recursos de forma más razonable» (traducción nuestra del anuncio en chino, DeepSeek). Incluso en horario valle, V4.1 Flash cuesta más de lo que costaba V4 Flash antes de agosto, pero su coste por punto del índice es de 0.70x en horas punta y de 0.35x en horario valle respecto al de V3.2-Exp un año antes (39.5 puntos frente a una puntuación estimada de 16.6).
¿Cómo se comparan los cuatro laboratorios?
| Anthropic | OpenAI | DeepSeek | ||
|---|---|---|---|---|
| Evolución en dos años | Bajadas en las tres gamas | Ligera bajada en insignia y gama pequeña (0.91x, 0.76x), subida de 17x en la gama media | Subidas en las tres gamas | Modelo económico: subida de 3x en horas punta y 1.5x en horario valle |
| Frecuencia de los cambios de precio | Pocos cambios: mismo precio durante varias versiones, seguido de un salto | Cambios frecuentes: nuevos precios con la mayoría de las versiones, rebajas en pocas semanas | Con cada generación, además de subidas programadas | Cambios frecuentes: nuevos precios con la mayoría de las versiones, además de promociones y tarifas por franja horaria |
| Precios de lanzamiento | Un precio promocional (Sonnet 5) que pasó a ser permanente | Rebajas poco después del lanzamiento (familia GPT-5.6) | Precios promocionales con la subida ya anunciada | Promociones de lanzamiento (V3, V4 Pro); la de V4 Pro pasó a ser permanente |
| Motivo declarado para las subidas | Inteligencia (Claude 3.5 Haiku) | Capacidad (GPT-5.2) | Valor, en una ocasión (2.5 Flash); normalmente, ninguno | Asignación de recursos (tarifas punta) |
| Motivo declarado para las rebajas | Acceso y, después, menor coste de servicio | Eficiencia de la inferencia y la caché | Ninguno declarado; precios promocionales en lugar de rebajas | Menor coste de servicio gracias a una nueva arquitectura |
| Modelo económico, octubre de 2026 | $0.10 / $0.50 | $0.10 / $0.50 | $0.30 / $2.50 | $0.30 / $1.20 en horas punta, la mitad en horario valle |
Los precios dependieron de cómo posicionaba cada laboratorio sus modelos, no de una tarifa fija por gama: si un modelo alcanzaba puntuaciones de nivel insignia, su precio se acercaba al de los insignia; si un laboratorio podía servir un modelo a menor coste, le bajaba el precio.
¿Cómo evolucionó el precio de cada categoría?
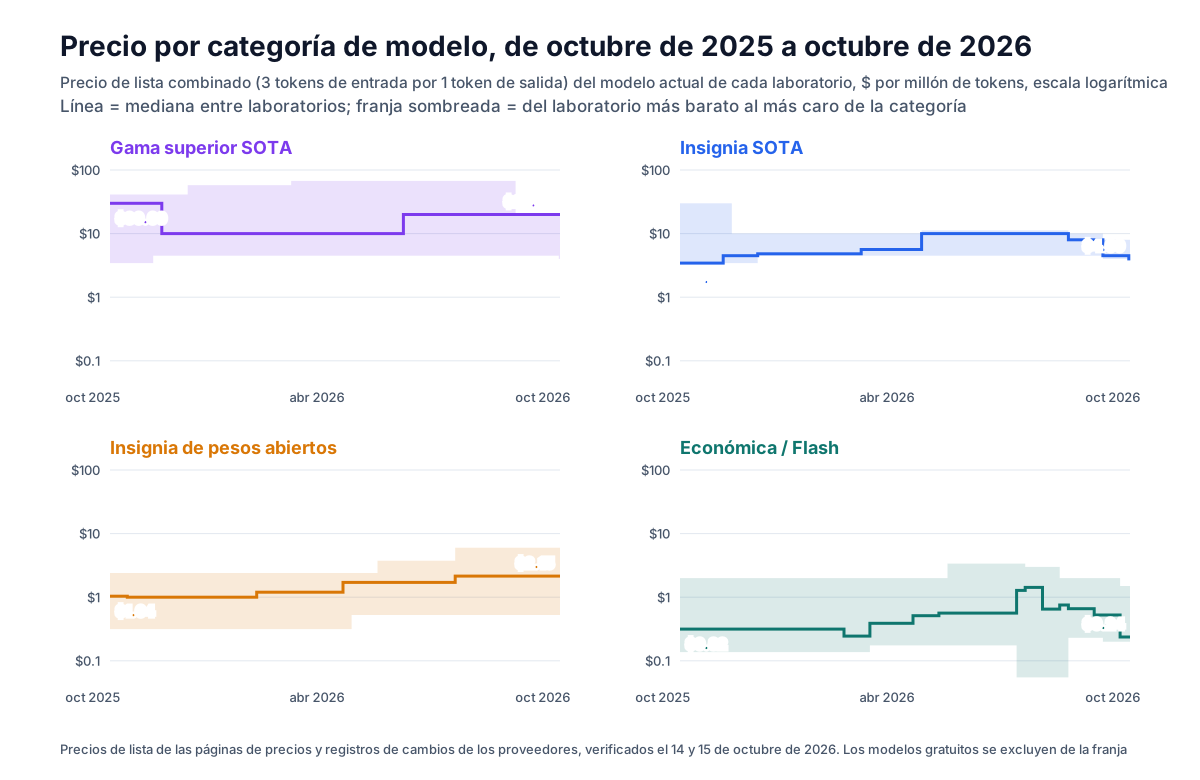
Los precios de los modelos insignia cerrados convergieron, los de pesos abiertos subieron y la gama económica terminó más barata tras un pico a mediados de año. Los modelos actuales de cada laboratorio se agrupan en cuatro categorías:
- Gama superior SOTA: SOTA (estado del arte) abarca a los principales laboratorios de modelos cerrados; esta gama incluye el modelo más caro de cada uno. Es una categoría de precio: Opus 5.5, un modelo insignia, supera en puntuación a los tres modelos de la gama superior. Cuando el modelo más avanzado de un laboratorio es también su insignia, aparece en ambas categorías (actualmente, Gemini 4 Argon).
- Insignia SOTA: el principal modelo de propósito general de cada laboratorio de modelos cerrados.
- Insignia de pesos abiertos: el modelo principal de cinco laboratorios cuyos pesos cualquiera puede descargar y alojar.
- Económica / Flash: la línea de bajo coste de cada laboratorio, denominada así por los modelos Flash de Google.
El gráfico muestra en una línea la mediana del precio combinado entre laboratorios de cada categoría. La banda abarca del precio más bajo al más alto, en escala logarítmica. La diferencia de precios de la tabla solo compara las tarifas de entrada.
| Categoría | Modelos al 15 de octubre de 2026 | Mediana del precio combinado, octubre de 2025 | Mediana del precio combinado, octubre de 2026 | Diferencia de entrada (máximo ÷ mínimo), octubre de 2025 | Diferencia de entrada, octubre de 2026 |
|---|---|---|---|---|---|
| Gama superior SOTA | Claude Fable 5.1, GPT-6 Astra, Gemini 4 Argon | $30.00 | $20.00 | 12x | 5x |
| Insignia SOTA | Claude Opus 5.5, GPT-6.1 Sol, Gemini 4 Argon | $3.44 | $4.00 | 12x | 2x |
| Insignia de pesos abiertos | GLM-5.3, Kimi K3, Qwen3.8 Max, DeepSeek V4 Pro, MiniMax M3 | $1.04 | $2.15 | 4.3x | 10x |
| Económica / Flash | Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite, DeepSeek V4.1 Flash, GLM-5.3 Flash, Qwen3.8 Flash | $0.32 | $0.24 | 20x | 7.5x |
- Gama superior SOTA: los modelos pro de OpenAI pasaron de GPT-5 Pro a $15 / $120 a GPT-5.4 Pro a $30 / $180, hasta que GPT-6 Astra situó de nuevo la gama en $10 / $50, el precio de Claude Fable 5.1. Google ofrece Argon por ahora a $2 / $10, lo que explica toda la diferencia actual de 5x.
- Insignia de pesos abiertos: la mediana del precio de entrada se multiplicó por más de dos, de $0.60 a $1.40, y los precios se distanciaron: Kimi K3, a $3 / $15, cuesta más que Claude Sonnet 5.5, mientras que MiniMax M3 se mantuvo en $0.30 / $1.20 a lo largo de cinco versiones. La mediana del precio de salida de los modelos de pesos abiertos pasó del 24% al 44% de la mediana de los insignia cerrados. DeepSeek V4 Pro se contabiliza con su tarifa punta.
- Económica / Flash: la mediana subió a $0.56 entre mayo y julio, cuando aparecieron modelos de bajo coste como Gemini 3.1 Flash-Lite y Qwen3.6 Flash a $0.25 / $1.50. La bajada llegó sobre todo cuando Haiku 5.5 igualó en octubre el precio de GPT-6 Luna de $0.10 / $0.50.
GPT-5.6 Terra queda fuera de la categoría económica porque cuesta tanto como un modelo insignia. Los datos abarcan ocho laboratorios; no incluyen xAI ni Mistral.
¿Cuánto cuesta ahora alcanzar un nivel de capacidad determinado?
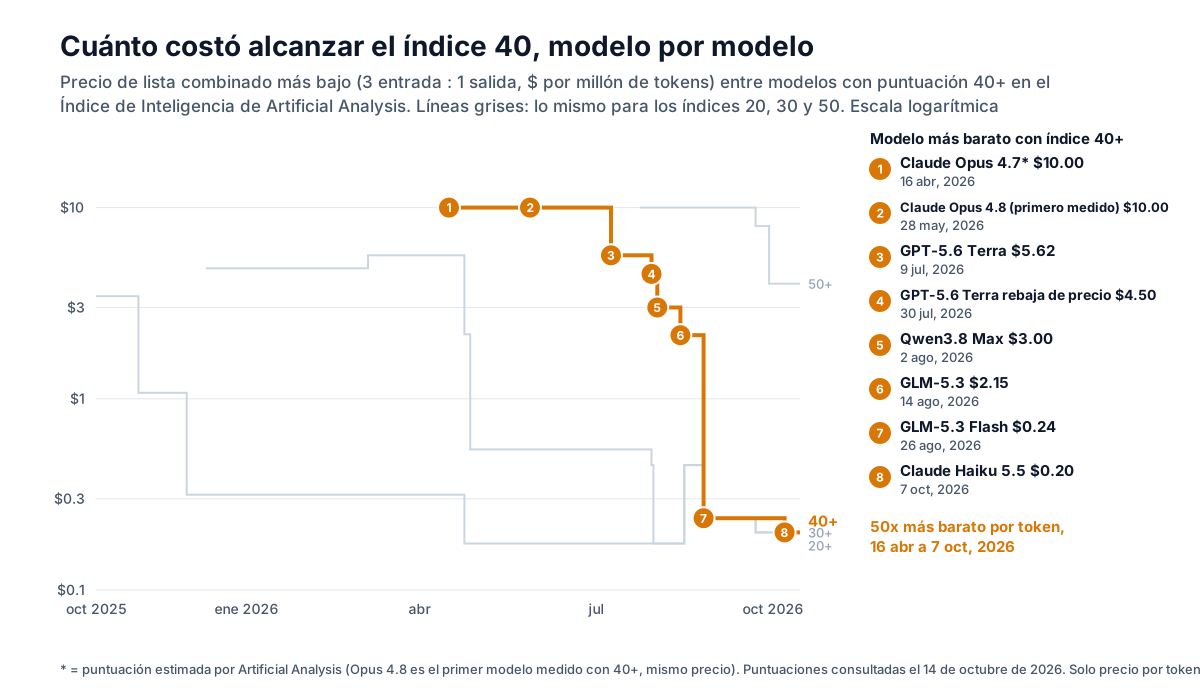
El modelo más barato de cada nivel del índice pasó a costar entre 2.5 y 50 veces menos por token, y entre 8 y 19 veces menos por tarea en los casos con datos por tarea en ambos extremos. Aquí, el coste por tarea es el que publica Artificial Analysis para ejecutar una tarea de su índice a precio de tarifa, con el consumo real de tokens de cada modelo. Para cada día elegimos el modelo vigente más barato con al menos 20, 30, 40 o 50 puntos en la versión 4.3.2 del índice, siempre con su ajuste de razonamiento más alto.
| Nivel del índice | Modelo más barato al alcanzar el nivel por primera vez entre octubre de 2025 y octubre de 2026, $ combinados por millón de tokens | Más barato ahora | Veces más barato por token | Veces más barato por tarea |
|---|---|---|---|---|
| 20 | Inicio del periodo, octubre de 2025: GPT-5*, $3.44 | Claude Haiku 5.5 o GPT-6 Luna, $0.20 | 17x | sin datos publicados para GPT-5 |
| 30 | Diciembre de 2025: GPT-5.2*, $4.81 | Claude Haiku 5.5 o GPT-6 Luna, $0.20 | 24x | sin datos publicados para GPT-5.2 |
| 40 | Abril de 2026: Claude Opus 4.7*, $10 | Claude Haiku 5.5, $0.20 | 50x | 19x, de Opus 4.8 (primero con datos por tarea) a $4.08 a Haiku 5.5 a $0.21 |
| 50 | Julio de 2026: Claude Opus 5, $10 | GPT-6.1 Sol o Gemini 4 Argon, $4 | 2.5x | 8.1x, de Opus 5 a $5.86 a GPT-6.1 Sol a $0.72 |
* Puntuación estimada por Artificial Analysis, no medida. El primer modelo medido en el nivel 40, Opus 4.8 en mayo, tenía el mismo precio de tarifa de $10.
El precio mínimo no bajó de forma continua: el nivel 20 del índice costó $0.175 con DeepSeek V4 Flash desde finales de abril hasta mediados de agosto, menos que los $0.20 actuales.
Los modelos con mayor puntuación no pasaron a ser baratos. Hace un año, los dos primeros eran GPT-5 y Opus 4.1, con puntuaciones estimadas de 23.0 y 22.8 y precios combinados de $3.44 y $30. Hoy, el mejor modelo es Claude Opus 5.5, con 57.6 puntos y un precio combinado de $8. Las grandes bajadas se dan en niveles que solo el mejor modelo alcanzaba unos meses antes.
¿Por qué evolucionaron así los precios?
Además de lo que afirmaron los laboratorios sobre sus propios precios, tres cambios en el mercado coinciden con estos movimientos y empujan en direcciones distintas. Se solapan en el tiempo, por lo que los datos no permiten aislar sus efectos.
Demanda y capacidad de servicio. Cuando la demanda supera las GPU disponibles para responder a las peticiones, el proveedor puede limitar el uso o cobrar más en horas punta. OpenRouter, un mercado que dirige peticiones de API a múltiples proveedores de alojamiento de modelos, pasó de unos 5 billones de tokens semanales en abril de 2025 a más de 20 billones en abril de 2026. La programación pasó de cerca del 11% de su tráfico a más de la mitad (Wing VC). Anthropic retiró sus límites en horas punta para las suscripciones de Claude tras conseguir acceso al centro de datos Colossus 1 de xAI el 6 de mayo. Entre los cambios de precios de las API de ese mismo periodo están GPT-5.5 a $5 / $30 en abril, las subidas programadas de Google junto con su declaración de que su «capacidad es limitada» y las tarifas punta de DeepSeek.
Competencia y precio mínimo. La cuota de los modelos chinos de pesos abiertos pasó de cerca del 2% de los tokens de OpenRouter a finales de 2024 a alrededor del 61% en mayo de 2026 (Wing VC), aunque el tráfico directo de servicios como ChatGPT es muy superior al del enrutador. En junio, el Wall Street Journal informó de que OpenAI estudiaba rebajas ante los recortes de Anthropic que se esperaban (Decrypt); ambas lanzaron modelos más baratos el 22 de septiembre. El precio mínimo para un nivel de capacidad lo marcó DeepSeek V4 Flash desde finales de abril hasta la subida de DeepSeek en agosto. Después pasó a Claude Haiku 5.5 y GPT-6 Luna.
Ingresos de los laboratorios de pesos abiertos. Los pesos abiertos permiten a cualquier proveedor vender acceso al mismo modelo. Tras el lanzamiento de GLM-5.3 Flash por Zhipu, la cuota de su propia API en el tráfico de ese modelo en OpenRouter cayó del 88% al 22% en tres semanas. Epoch AI, un grupo de investigación en IA, estima que DeepSeek recibe alrededor del 8% del gasto en modelos DeepSeek en OpenRouter (Huxiu, a través de Weijin Research). Estas cifras son posteriores a la mayor parte de la subida de precios de los modelos de pesos abiertos: son compatibles con ella, pero no la explican. Los proveedores de alojamiento apenas han rebajado los precios de los insignia más recientes: el 16 de octubre, el precio del propio laboratorio era el más habitual para GLM-5.3 (15 de 44 proveedores) y Kimi K3 (7 de 25). De los 15 proveedores de Kimi K3 más baratos, 12 ejecutaban pesos cuantizados a 4 bits, una versión comprimida cuyas respuestas pueden diferir de las del original.
¿Por qué el precio por token no equivale al precio por tarea?
Dos modelos con el mismo precio de tarifa pueden tener costes por tarea que difieran varias veces. La causa principal son los tokens de razonamiento: el razonamiento interno paso a paso que el modelo genera antes de responder y que se factura como salida. Artificial Analysis publica el coste medio de cada modelo por tarea del índice a precio de tarifa.
| Pareja | Precio de tarifa, $ por millón de tokens (entrada / salida) | Coste medio por tarea del índice |
|---|---|---|
| Claude Haiku 5.5 frente a GPT-6 Luna | ambos $0.10 / $0.50 | $0.21 frente a $0.07 |
| Gemini 4 Argon frente a GPT-6.1 Sol | ambos $2 / $10 | $1.99 frente a $0.72 |
| Qwen3.8 Max frente a GPT-6.1 Sol | $2 / $6 frente a $2 / $10 | $5.41 frente a $0.72 |
Qwen3.8 Max tiene el precio de salida más bajo de su pareja y cuesta 7.5 veces más por tarea. En nuestra prueba, Argon costó 3.1 veces más que GPT-6.1 Sol por respuesta correcta (coste de la API de Gemini 4 Argon). Para comparar modelos con tu propio tráfico, calcula el coste de un lote de peticiones reales a partir del número de tokens de cada respuesta (los tokens de razonamiento se facturan como salida). Divide el total por el número de respuestas aceptables y compara los modelos por ese coste por respuesta.
¿Cómo cambiaron los precios de caché respecto a los de entrada?
Las lecturas de caché (los aciertos de caché descritos en la sección de DeepSeek) se abarataron respecto a la entrada en los modelos insignia y de gama superior de los laboratorios de modelos cerrados, y las escrituras de caché se encarecieron en dos proveedores. La tabla expresa la tarifa de lectura de caché de cada modelo como porcentaje de su propio precio de entrada.
| Categoría | Lectura de caché ÷ entrada, octubre de 2025: mediana (intervalo) | Octubre de 2026: mediana (intervalo) | Mínimo y máximo actuales |
|---|---|---|---|
| Gama superior SOTA | 10% (todos los modelos) | 5% (2.5% a 10%) | Claude Fable 5.1 2.5%, GPT-6 Astra 10% |
| Insignia SOTA | 10% (todos los modelos) | 5% (todos los modelos) | Claude Opus 5.5, GPT-6.1 Sol y Gemini 4 Argon, todos 5% |
| Insignia de pesos abiertos | 18% (10% a 25%) | 12.5% (3.3% a 20%) | DeepSeek V4 Pro 3.3%, MiniMax M3 20% |
| Económica / Flash | 10% (todos los modelos) | 10% (2% a 20%) | DeepSeek V4.1 Flash 2%, GLM-5.3 Flash 20% |
Los insignia cerrados redujeron a la mitad su tarifa relativa de lectura de caché en tres semanas: Opus 5.5 el 22 de septiembre, GPT-6.1 Sol el 29 de septiembre y Argon el 13 de octubre. Los laboratorios de pesos abiertos cobran un porcentaje mayor, salvo DeepSeek, aunque el 3.3% de V4 Pro se debe a un precio de entrada más alto, no a una lectura de caché más barata. MiniMax pasó del 10% al 20% con M2.7 en marzo. Los modelos que no publicaban precio de caché quedan excluidos.
Las escrituras de caché, las peticiones que almacenan un prefijo por primera vez, cambiaron en dos proveedores. OpenAI empezó a cobrarlas con GPT-5.6 en julio: 1.25 veces el precio de entrada para la caché predeterminada de 30 minutos y, desde el 20 de octubre, 2.5 veces para la caché de 12 horas. Kimi K3 sigue facturando la escritura predeterminada de 5 minutos al precio de entrada, como Kimi K2, pero añadió una caché opcional de 1 hora a 2 veces ese precio. Anthropic sigue cobrando 1.25 veces el precio de entrada para la caché de 5 minutos y 2 veces para la de 1 hora, y Google, DeepSeek y Zhipu siguen sin cobrar ningún extra. La guía de escritura de caché explica cuándo compensa una escritura.
¿Qué hacer con estos datos?
Calcula el presupuesto por capacidad y por tarea, no por el nombre de la gama, y vuelve a probar los modelos pequeños.
| Carga de trabajo | Qué comprobar | Candidatos y cifras |
|---|---|---|
| Extracción, clasificación y enrutamiento a gran escala | Si un modelo pequeño de 2026 cumple tu umbral de calidad | Claude Haiku 5.5 obtiene 43.4 puntos y GPT-6 Luna 38.1 a $0.10 / $0.50; hace un año, ningún modelo de los datos superaba los 23 puntos |
| Agentes y razonamiento largo | Coste por tarea terminada | GPT-6.1 Sol $0.72 por tarea del índice, Gemini 4 Argon $1.99 con el mismo precio de tarifa |
| Trabajo que exige máxima capacidad | Si necesitas el nivel 50 o el máximo absoluto | El nivel 50 cuesta $4 combinados con GPT-6.1 Sol, o con Argon hasta el 1 de diciembre; Claude Opus 5.5, con 57.6 puntos, cuesta $8 |
| Presupuestar con un precio de lanzamiento | Cuánto tiempo se mantendrá el precio | Los precios de lanzamiento de Google tienen subidas programadas (Argon el 1 de diciembre, Gemini 3.8 Flash el 1 de enero); OpenAI rebajó los tres precios de lanzamiento de GPT-5.6 en un plazo de seis semanas; Anthropic mantuvo los precios entre versiones y los rebajó con modelos nuevos |
| Trabajos por lotes en DeepSeek | Si el trabajo puede ejecutarse en horario valle | DeepSeek V4.1 Flash cuesta la mitad fuera del horario laboral de Pekín: $0.15 / $0.60 frente a $0.30 / $1.20 |
| Insignia de pesos abiertos elegidos por coste | Los precios de alojamiento y la precisión de los pesos del modelo exacto | 12 de los 15 proveedores que ofrecen Kimi K3 por debajo del precio de Moonshot ejecutan pesos cuantizados a 4 bits |
Preguntas frecuentes
¿Están bajando los precios de las API de LLM en 2026? Los precios por token de las API de LLM subieron en la mayoría de los casos: la tarifa de entrada aumentó en 10 de las 14 gamas que comparamos entre octubre de 2025 y octubre de 2026. Por unidad de capacidad, bajaron: el modelo más barato con 40 puntos en el Artificial Analysis Intelligence Index costaba $10 por millón de tokens combinados en abril de 2026 y $0.20 en octubre (Claude Haiku 5.5). Por tarea, pasó a costar 19 veces menos entre mayo y octubre.
¿Qué laboratorio de IA bajó más los precios de su API? Anthropic fue el que más los bajó: en los dos años hasta octubre de 2026, redujo los precios de tarifa de sus tres gamas. Claude Opus 5.5 quedó en $4 / $20, frente a los $15 / $75 de Claude 3 Opus, y Claude Haiku 5.5 en $0.10 / $0.50. Google subió los precios de sus tres gamas. Los precios combinados del modelo insignia y del modelo pequeño de OpenAI terminaron a menos de un 25% de sus valores de octubre de 2024, mientras que el de su gama media se multiplicó por 17.
Lecturas relacionadas
- Coste de la API de Gemini 4 Argon: el mismo precio de tarifa que GPT-6.1 Sol, 3.1x por respuesta correcta
- Tramos de precios para contextos largos: a partir de qué longitud de prompt sube el precio de cada proveedor
- Cuánto cuesta escribir en la caché de prompts: precios de escritura y lectura por proveedor
- Coste de Claude Haiku 5.5: mediciones del umbral de precio de 100,000 tokens
- Coste de Kimi K3: un insignia de pesos abiertos al precio de un modelo cerrado