
Claude Haiku 5.5: un token más de 100K multiplica el precio por 5
Contenido
- Cómo lo medimos
- ¿Cuánto cuesta Claude Haiku 5.5 a cada lado del límite?
- ¿Cuentan los tokens en caché y los de salida para el límite de 100,000?
- ¿Equivalen 100,000 tokens a la misma cantidad de texto que en Claude Haiku 4.5?
- ¿Qué pasa cuando el contexto de un agente supera el límite?
- ¿Cómo mantener un agente por debajo del límite?
- ¿Es más barato que GPT-6 Luna con el mismo precio de lista?
- Preguntas frecuentes
- ¿Cuánto cuesta Claude Haiku 5.5?
- ¿Cuentan los tokens en caché para el límite de 100,000 tokens de Claude Haiku 5.5?
- ¿Es Claude Haiku 5.5 más barato que Claude Haiku 4.5?
- ¿Es Claude Haiku 5.5 más barato que GPT-6 Luna?
- ¿Cómo mantengo las peticiones a Claude Haiku 5.5 por debajo de 100,000 tokens?
- Lecturas relacionadas
Claude Haiku 5.5 tiene dos tarifas. La longitud del prompt determina cuál se aplica a toda la petición. Enviamos un prompt de exactamente 100,000 tokens y costó $0.0100. Con un token más, costó $0.0500. El prompt incluye todo lo que envías: instrucciones del sistema, definiciones de herramientas y mensajes. También incluye los tokens leídos de la caché del prompt. La tabla de precios de Anthropic no lo especifica, pero lo comprobamos con su propia factura.
TL;DR
- Un prompt de 100,000 tokens en Claude Haiku 5.5 costó $0.010008. Con 100,001 tokens costó $0.050041, cinco veces más.
- Un prompt de 102,011 tokens, de los que el 94% se leyó de caché, se cobró a la tarifa alta: $0.0078 frente a $0.0016 con la tarifa baja.
- El mismo texto en inglés ocupa entre 1.4 y 1.5 veces más tokens en Haiku 5.5 que en Claude Haiku 4.5.
- En un bucle de agente, seis peticiones por encima del límite representaron el 76% de una ejecución de $0.083. Compactar el contexto o usar un subagente redujo el coste a $0.026 o $0.016.
Cómo lo medimos
Enviamos la mayoría de las peticiones a través del gateway de Synthorai los días 8 y 9 de octubre de 2026. «Costó» se refiere a lo que el gateway cobró por cada petición. El gateway aplica las dos tarifas de Anthropic y calcula la longitud del prompt sumando tres contadores de entrada de la respuesta: tokens de entrada no almacenados en caché, lecturas de caché y escrituras en caché. Los 581 importes que comprobamos coincidían con una de las dos tarifas hasta el sexto decimal.
La página de precios de Anthropic solo dice que el modelo «se cobra según la longitud del prompt», y la respuesta de la API no incluye el precio. Por eso enviamos también 23 de esos mismos prompts directamente a la API de Anthropic y consultamos el coste diario del modelo en Anthropic Console: $0.33. Esas peticiones suman $0.3301 si todos los prompts de más de 100,000 tokens pagan la tarifa alta, incluidos los tokens en caché. Si las lecturas de caché no contaran, sumarían $0.2678. Anthropic cobra igual que el gateway.
¿Cuánto cuesta Claude Haiku 5.5 a cada lado del límite?
En cuanto el prompt supera los 100,000 tokens, cada concepto de la tarifa cuesta cinco veces más. Los precios son por millón de tokens.
| Prompt de hasta 100,000 tokens | Prompt de más de 100,000 tokens | Claude Haiku 4.5 | |
|---|---|---|---|
| Entrada | $0.10 | $0.50 | $1.00 |
| Salida | $0.50 | $2.50 | $5.00 |
| Lectura de caché | $0.01 | $0.05 | $0.10 |
| Escritura en caché, 5 minutos | $0.125 | $0.625 | $1.25 |
| Entrada / salida en Batch | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 |
Una escritura en caché ocurre cuando una petición guarda por primera vez un prefijo del prompt. Una lectura ocurre cuando una petición posterior lo reutiliza. Batch es la API asíncrona de Anthropic, que cuesta la mitad.
La tarifa alta se aplica a toda la petición, no solo a los tokens que exceden el límite. Construimos un prompt de 99,872 tokens y lo ampliamos de uno o dos tokens cada vez:
| Tokens del prompt | Coste | Tarifa |
|---|---|---|
| 99,998 | $0.010008 | baja |
| 100,000 | $0.010008 | baja |
| 100,001 | $0.050041 | alta |
| 100,002 | $0.050041 | alta |
Exactamente 100,000 tokens siguen en la tarifa baja, como indica «más de 100,000». Según Anthropic, los prompts de hasta 100,000 tokens representaban cerca del 90% de las peticiones a Claude Haiku 4.5. Por token, el modelo nuevo cuesta un 90% menos que el anterior por debajo del límite y un 50% menos por encima.
¿Cuentan los tokens en caché y los de salida para el límite de 100,000?
Los tokens en caché sí cuentan; los de salida, no. Guardamos en caché un prefijo de 96,045 tokens y volvimos a enviarlo con fragmentos finales de distintas longitudes:
| Petición | Tokens del prompt | Leídos de caché | Coste | Tarifa |
|---|---|---|---|---|
| prefijo, primera vez (escritura en caché) | 96,058 | 0 | $0.012009 | baja |
| prefijo de nuevo | 96,058 | 96,045 | $0.000964 | baja |
| prefijo y fragmento final de 1,000 tokens | 97,034 | 96,045 | $0.001061 | baja |
| prefijo y fragmento final de 6,000 tokens | 102,011 | 96,045 | $0.007795 | alta |
En la última petición, el 94% de los tokens se leyó de caché y se aplicó la tarifa alta: $0.0078, frente a los $0.0016 que habría costado con la tarifa baja. Para comprobar los tokens de salida, un prompt de 97,864 tokens con una respuesta de 1,905 tokens costó $0.010739, según la tarifa baja.
Para comparar la longitud del prompt con el límite, suma tres campos de la respuesta. Si necesitas saberlo antes de enviar la petición, el endpoint de recuento de tokens acepta los mismos system, tools y messages:
import anthropic

client = anthropic.Anthropic()

# after a request: the length the price list is chosen by
u = response.usage
prompt_tokens = u.input_tokens + u.cache_read_input_tokens + u.cache_creation_input_tokens

# before a request
count = client.messages.count_tokens(model="claude-haiku-5-5", system=system, tools=tools, messages=messages)
over_the_line = count.input_tokens > 100_000
¿Equivalen 100,000 tokens a la misma cantidad de texto que en Claude Haiku 4.5?
No. Claude Haiku 5.5 usa un tokenizer más reciente, que divide el texto en las unidades por las que se factura. El mismo texto produce más tokens que en Claude Haiku 4.5. La guía de migración de Anthropic habla de «aproximadamente un 30% más». Contamos cinco muestras en ambos modelos:
| Texto | Haiku 4.5 | Haiku 5.5 | Proporción | 100,000 en Haiku 5.5 equivalen, en Haiku 4.5, a |
|---|---|---|---|---|
| Prosa en inglés (informe del NIST, 12 páginas) | 6,478 | 9,618 | 1.48 | 67,353 |
| Artículo de investigación, 6 páginas | 4,352 | 6,048 | 1.39 | 71,958 |
| Código fuente JavaScript | 8,802 | 11,814 | 1.34 | 74,505 |
| Código fuente Python | 9,743 | 12,144 | 1.25 | 80,229 |
| Markdown con chino e inglés mezclados | 13,351 | 14,710 | 1.10 | 90,761 |
Un texto en inglés que ocupaba 68,000 tokens en Haiku 4.5 ya está en el límite en Haiku 5.5. Si calculas el presupuesto con el modelo anterior, situarás mal el límite. El ahorro por documento también es menor que el ahorro por token: con 1.48 veces más tokens, la prosa en inglés cuesta un 85% menos que en Haiku 4.5 por debajo del límite y un 26% menos por encima.
¿Qué pasa cuando el contexto de un agente supera el límite?
La petición que cruza el límite cuesta unas cinco veces más que la anterior, y las siguientes se mantienen en ese nivel. Un bucle de agente vuelve a enviar la conversación completa en cada turno. Si el prompt crece con el resultado de una herramienta por turno, acaba llegando a los 100,000 tokens.
Ejecutamos un agente con Claude Haiku 5.5 que lee 20 archivos de logs de unos 7,000 tokens cada uno mediante una herramienta read_file y calcula un total a partir de ellos. Cada resultado de la herramienta permanece en la conversación y el prefijo se guarda en caché, como suele hacerse en estos bucles. Estas fueron las peticiones 15 a 18 de una ejecución:
| Petición | Tokens del prompt | Leídos de caché | Coste |
|---|---|---|---|
| 15 | 92,701 | 85,593 | $0.001787 |
| 16 | 99,705 | 92,699 | $0.001845 |
| 17 | 106,744 | 99,703 | $0.009598 |
| 18 | 113,771 | 106,742 | $0.009942 |
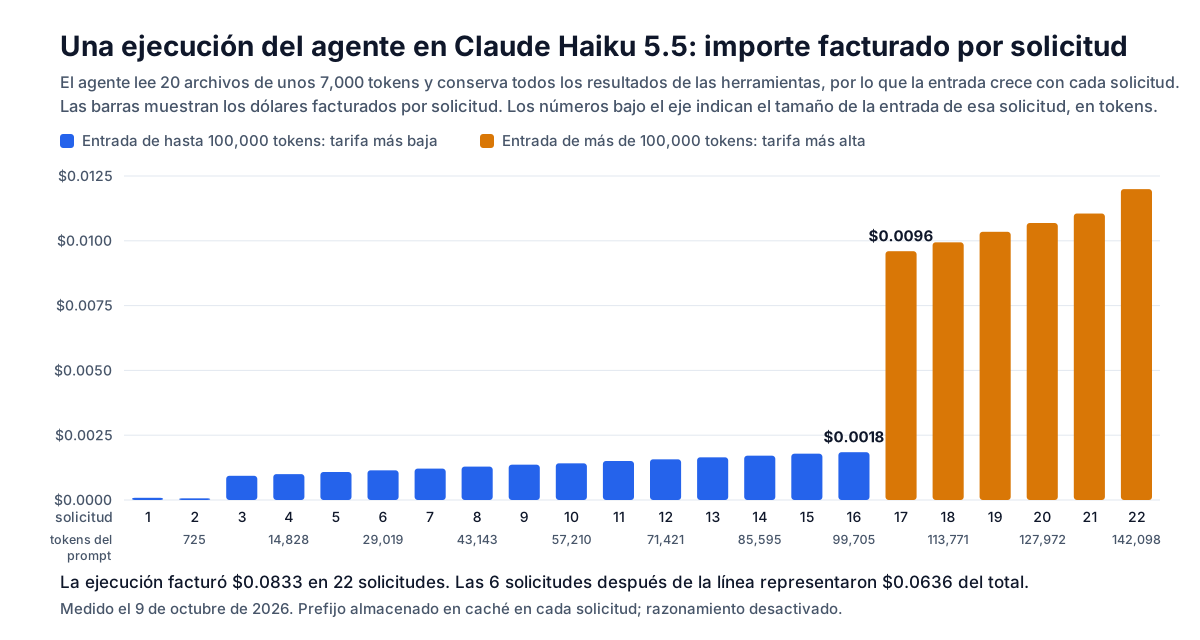
La petición 17 tiene 7,000 tokens más que la 16 y cuesta 5.2 veces más. La ejecución hizo 22 peticiones y costó $0.0833. Las seis peticiones por encima del límite sumaron $0.0636, el 76%. Los mismos tokens habrían costado $0.0324 con la tarifa baja.
¿Cómo mantener un agente por debajo del límite?
Evita que los resultados antiguos de las herramientas se acumulen en la conversación principal. Ejecutamos la misma tarea de cuatro formas con Claude Haiku 5.5, cinco veces por método y con la caché vacía al inicio de cada ejecución:
| Método | Total correcto | Coste por ejecución (mediana) | Peticiones | Prompt más largo |
|---|---|---|---|---|
| Conservar todo | 5 de 5 | $0.0823 | 22 | 142,119 |
| Compactar al llegar a 80,000 tokens | 5 de 5 | $0.0261 | 23 | 92,829 |
| Recortar resultados antiguos de herramientas | 3 de 5 | $0.0228 | 22 | 10,278 |
| Un subagente lee cada archivo | 5 de 5 | $0.0156 | 42 | 7,100 |
- Compactación. Cuando el prompt supera los 80,000 tokens, una petición adicional pide al modelo un resumen del progreso y la conversación se reinicia a partir de él. Deja margen al fijar el umbral: el siguiente resultado de una herramienta también debe caber por debajo de 100,000.
- Recorte. Antes de cada petición, se sustituye cada resultado de una herramienta, salvo el más reciente, por una línea breve. Dos de las cinco ejecuciones dieron un total incorrecto tras un error aritmético en el total acumulado que el modelo mantenía en sus respuestas. Cinco ejecuciones no bastan para concluir que recortar sea menos fiable (la diferencia entre 3 de 5 y 5 de 5 no es significativa), pero sí muestran el riesgo: una vez eliminado el dato original, no se puede corregir el error.
- Subagente. La herramienta del agente principal envía cada archivo a una petición independiente que devuelve una línea. Fue el método más barato, hizo más peticiones y tardó alrededor de un 25% más. La petición independiente solo ve lo que se le envía, así que sus instrucciones deben precisar qué buscar tanto como las del agente principal.
Las cuatro variantes se ejecutaron con thinking desactivado. Thinking es el trabajo interno del modelo antes de responder y está activado por defecto en este modelo. Según la guía de migración de Anthropic, una petición que vuelve a enviar bloques de thinking después de modificar un mensaje anterior recibe un error 400. En cuentas creadas antes del 31 de agosto de 2026, esto solo ocurre si activan esa comprobación. Por tanto, para recortar hay que desactivar thinking u omitir esos bloques. La compactación y los subagentes inician una conversación nueva y evitan el problema.
¿Es más barato que GPT-6 Luna con el mismo precio de lista?
No en nuestras pruebas: con una precisión equivalente costó cerca del doble. GPT-6 Luna tiene los mismos precios de lista, $0.10 y $0.50, sin cambios según la longitud del prompt.
Los resultados publicados por Anthropic sitúan a Claude Haiku 5.5 por delante de GPT-6 Luna en benchmarks de agentes y muy por delante de Claude Haiku 4.5:
| Benchmark (anuncio de Anthropic) | Qué evalúa | Haiku 5.5 | GPT-6 Luna | Haiku 4.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | tareas de trabajo intelectual, puntuación Elo | 1620 | 1437 | 735 |
| OSWorld 2.1, subconjunto offline | manejo de un ordenador | 72.4% | 48.9% | 15.7% |
| Terminal-Bench 4.0 | tareas de programación en terminal | 39.2% | 16.4% | 0.0% |
Probamos los tres modelos con su configuración por defecto, además de Haiku 5.5 con thinking desactivado, en dos conjuntos más pequeños con respuestas verificables: 96 casos de clasificación, extracción y selección de herramientas, tareas para las que Anthropic recomienda este modelo, y 14 tareas de varios pasos ejecutadas tres veces cada una.
| Modelo | Casos breves correctos, de 96 | Coste por 1,000 llamadas | Tareas de varios pasos correctas, de 42 | Coste por respuesta correcta |
|---|---|---|---|---|
| Claude Haiku 5.5 | 95 | $0.107 | 39 | $0.00103 |
| Claude Haiku 5.5, thinking desactivado | 94 | $0.069 | 33 | $0.00036 |
| GPT-6 Luna | 95 | $0.049 | 38 | $0.00043 |
| Claude Haiku 4.5, sin thinking extendido | 94 | $0.679 | 10 | $0.01053 |
El coste por respuesta correcta es el gasto total dividido entre el número de aciertos. Haiku 5.5 y GPT-6 Luna tienen una precisión similar en ambos conjuntos (39 y 38 de 42 equivalen al mismo resultado), pero Haiku 5.5 cuesta algo más del doble. En los casos breves contó 482 tokens de entrada frente a los 231 de GPT-6 Luna; en las tareas de varios pasos generó 1,902 tokens de salida por llamada frente a 759. Frente a Haiku 4.5, ejecutado con su configuración por defecto sin thinking extendido, cuesta un 84% menos en los casos breves y resuelve correctamente unas cuatro veces más tareas de varios pasos.
Thinking usa por defecto el nivel de esfuerzo medium. El esfuerzo controla cuánto razona el modelo, desde low hasta max, y thinking: {"type": "disabled"} lo desactiva. Sin thinking, los casos breves obtuvieron la misma puntuación por dos tercios del coste, pero en las tareas de varios pasos se perdieron 6 de 42 respuestas correctas. Además, el modelo incluyó su razonamiento en cada respuesta que solo pedía un número. Con esfuerzo max obtuvo los mismos 39 aciertos que con la configuración por defecto, al doble de coste.
En resumen, es el modelo económico de la familia Claude y supone un gran salto respecto a Haiku 4.5 por una décima parte del precio por token. En nuestras pruebas, GPT-6 Luna hizo el mismo trabajo en llamadas breves y numerosas por la mitad de dinero. Haiku 5.5 tiene más sentido para tareas de agentes: los benchmarks de Anthropic lo sitúan claramente por delante, aunque nosotros no comparamos ambos modelos en ese tipo de tareas. Eso sí, el prompt debe mantenerse por debajo de 100,000 tokens. Antes de migrar una carga de trabajo de Haiku 4.5, vuelve a contar sus prompts con el modelo nuevo. Según la guía de migración, también debes eliminar lo que Haiku 5.5 rechaza con un error 400: un presupuesto de thinking manual, valores no predeterminados de temperature, top_p o top_k, y un turno de assistant iniciado de antemano.
Preguntas frecuentes
¿Cuánto cuesta Claude Haiku 5.5?
Con prompts de hasta 100,000 tokens, Claude Haiku 5.5 cuesta $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida. Si el prompt supera los 100,000 tokens, cuesta $0.50 y $2.50, aplicados a toda la petición. Las lecturas de caché cuestan $0.01 y $0.05. La API Batch reduce a la mitad los precios de entrada y salida en ambas tarifas.
¿Cuentan los tokens en caché para el límite de 100,000 tokens de Claude Haiku 5.5?
Sí. Un prompt de 102,011 tokens enviado a Claude Haiku 5.5, con 96,045 tokens leídos de caché, se cobró a la tarifa alta: $0.0078 frente a $0.0016 con la baja. La longitud del prompt suma la entrada sin caché, las lecturas de caché y las escrituras en caché. La tabla de precios de Anthropic no lo indica, pero diez peticiones de este tipo enviadas directamente a su API se cobraron a la tarifa alta en nuestra factura de Anthropic. Los tokens de salida no cuentan.
¿Es Claude Haiku 5.5 más barato que Claude Haiku 4.5?
Sí, tanto por debajo como por encima del límite, aunque el ahorro es menor de lo que sugiere la tabla de precios porque el mismo texto ocupa más tokens en el modelo nuevo. En prosa inglesa medimos 1.48 veces más tokens. Eso hace que Claude Haiku 5.5 cueste alrededor de un 85% menos que Claude Haiku 4.5 por debajo de 100,000 tokens y cerca de un 26% menos por encima.
¿Es Claude Haiku 5.5 más barato que GPT-6 Luna?
No en nuestras pruebas, aunque sus precios de lista son iguales. En 96 tareas breves, Claude Haiku 5.5 costó $0.107 por 1,000 llamadas con su configuración por defecto, frente a $0.049 de GPT-6 Luna, con la misma precisión. Haiku 5.5 contó aproximadamente el doble de tokens de entrada para los mismos casos y generó más tokens de salida.
¿Cómo mantengo las peticiones a Claude Haiku 5.5 por debajo de 100,000 tokens?
Cuenta los tokens antes de enviar cada petición y, en bucles de agentes, evita que se acumulen los resultados antiguos de las herramientas. Resume la conversación en una nota antes de alcanzar el límite, o usa una petición independiente para leer cada entrada grande y devolver solo el resultado. En nuestra prueba con Claude Haiku 5.5, estos métodos redujeron el coste de una tarea de $0.082 a $0.026 y $0.016, respectivamente, con la respuesta correcta en todas las ejecuciones.
Lecturas relacionadas
- Tarifas para prompts de contexto largo: otros modelos cuyo precio cambia según la longitud del prompt.
- Claude Sonnet 5.5 frente a Sonnet 5: esfuerzo y coste por tarea en la gama superior.
- GPT-6 Luna: cuánto cuesta ajustar el razonamiento: el modelo con el mismo precio de lista.
- El tokenizer de Claude Sonnet 5: el tokenizer que ahora también usa Haiku 5.5.