
Gemini 4 Argon vs GPT-6.1 Sol: igual tarifa, 3x por acierto
Contenido
- ¿Cuánto cuesta Gemini 4 Argon?
- ¿Con qué modelos de OpenAI y Claude compite Gemini 4 Argon?
- ¿Cómo se compara el coste por respuesta de Argon con GPT-6.1 Sol, GPT-6 Astra y Opus 5.5?
- ¿Qué hace cada nivel de razonamiento?
- ¿Qué deja de funcionar al migrar a Gemini 4 Argon?
- ¿Qué nivel de razonamiento conviene para cada carga de trabajo?
- Preguntas frecuentes
- Lecturas relacionadas
Gemini 4 Argon cobra los mismos $2 por millón de tokens de entrada y $10 por millón de tokens de salida que GPT-6.1 Sol. Sin embargo, en nuestro conjunto de 13 tareas de razonamiento, el coste por respuesta correcta fue 3.1x mayor ($0.0063 frente a $0.0020, calculado dividiendo el gasto total entre los aciertos). Generó 3.3x más tokens de salida para obtener la misma puntuación: 38 llamadas correctas de 39. Frente a los modelos de gama alta con los que Google lo compara, el orden se invierte: Argon costó 0.76x lo que Claude Opus 5.5 y 0.6x lo que GPT-6 Astra, hasta que su precio se duplique el 1 de diciembre. El principal control de costes es thinking_level, un parámetro de la petición que determina cuánto razona gemini-4-argon antes de responder (low, medium por defecto, high). Los tokens de razonamiento se facturan como salida aunque no aparezcan en la respuesta. Medimos los tres niveles dos días después del lanzamiento de la API; ejecutamos los modelos de comparación y Gemini 3.1 Pro ese mismo día.
TL;DR
- Gemini 4 Argon cuesta $2/$10 por millón de tokens hasta el 30 de noviembre de 2026; después, $4/$20.
- Google compara Argon con GPT-6 Astra, Claude Fable 5.1 y Claude Opus 5.5; Argon lidera 13 de las 19 filas publicadas.
- En
medium, Argon costó $0.0063 por respuesta correcta, GPT-6.1 Sol $0.0020 y Opus 5.5 $0.0083; con los precios de diciembre, Argon pasa a $0.0125. - El nivel
lowde Argon no reportó razonamiento y acertó 1 de 15 llamadas en las cinco tareas más difíciles, frente a 14 de 15 enmedium.
¿Cuánto cuesta Gemini 4 Argon?
El precio de la API de Gemini 4 Argon se duplica el 1 de diciembre de 2026. La página de precios de Google publica una tarifa hasta el 30 de noviembre y el precio de lista posterior, sin nivel gratuito. La entrada en caché es texto que el servidor ya recibió en una petición anterior, como un prompt de sistema repetido, y se factura al 5% del precio de entrada. Los precios se expresan en dólares por millón de tokens:
| Modalidad | Entrada | Salida (incluye razonamiento) | Entrada en caché |
|---|---|---|---|
| Standard, hasta el 30 de noviembre | $2.00 | $10.00 | $0.10 |
| Standard, desde el 1 de diciembre | $4.00 | $20.00 | $0.20 |
| Batch y Flex, hasta el 30 de noviembre | $1.00 | $5.00 | $0.05 |
| Priority, hasta el 30 de noviembre | $3.60 | $18.00 | $0.18 |
Batch (se envía como un trabajo y devuelve resultados en unas horas) y Flex (capacidad según disponibilidad) seguirán costando la mitad de la tarifa Standard después del 1 de diciembre; Priority (capacidad reservada), 1.8x. Hay tres diferencias respecto a Gemini 3.1 Pro, el anterior modelo de gama alta de Google, con tarifa de $2/$12:
- Sin recargo por contexto largo. Gemini 3.1 Pro cobra $4/$18 cuando el prompt supera los 200K tokens; Argon mantiene $2/$10 hasta su ventana de contexto de 1,048,576 tokens, el máximo que cabe en una petición entre entrada, razonamiento y respuesta. A precio de lista, nuestro prompt de 709K tokens costó $1.42 en Argon y $2.84 en 3.1 Pro.
- Solo caché implícita. Desaparece la caché explícita, que permitía crear un objeto de caché y pagar por su almacenamiento. Los prefijos de prompt repetidos se almacenan automáticamente y se facturan a la tarifa de entrada en caché.
- Las salidas de más de 64K necesitan otro modo. Una petición normal devuelve como máximo 65,536 tokens de salida. Para generar más hay que usar el modo de ejecución en segundo plano de Google, en el que el servidor sigue generando en bloques de 64K hasta llegar a 1M tokens.
¿Con qué modelos de OpenAI y Claude compite Gemini 4 Argon?
Por capacidad, Google compara Gemini 4 Argon con el mejor modelo de cada laboratorio: GPT-6 Astra, Claude Fable 5.1 y Claude Opus 5.5. Por precio, se sitúa un nivel por debajo: comparte la tarifa de $2/$10 de GPT-6.1 Sol hasta el 30 de noviembre y la de $4/$20 de Opus 5.5 desde el 1 de diciembre. GPT-6 Astra y Fable 5.1 tienen un precio de lista de $10/$50.
El índice de inteligencia de Artificial Analysis combina pruebas de agentes, programación, conocimiento y ciencia que ejecuta la propia Artificial Analysis. También publica cuánto cuesta ejecutar una tarea del índice con cada modelo. Argon está al nivel de GPT-6 Astra y Fable 5.1; Opus 5.5 les saca entre cuatro y cinco puntos:
| Modelo | Precio de lista, $ por millón de tokens | En la tabla de pruebas de Google | Puntuación del índice (con el ajuste máximo del proveedor) | Coste por tarea del índice |
|---|---|---|---|---|
| Gemini 4 Argon | 2/10, después 4/20 | Modelo evaluado | 52.6 | $1.99 |
| GPT-6 Astra | 10/50 | Sí | 52.7 | $3.26 |
| Claude Fable 5.1 | 10/50 | Sí | 53.4 | $7.63 |
| Claude Opus 5.5 | 4/20 | Sí | 57.6 | $5.98 |
| GPT-6.1 Sol | 2/10 | No | 51.8 | $0.72 |
La tabla de Google, publicada en la ficha del modelo Argon, contiene 19 filas. Argon lidera 13 y empata en una; GPT-6 Astra lidera tres y Opus 5.5 dos. A continuación aparecen diez de esas 19 filas: las mayores diferencias, en trabajo basado en conocimiento y contexto largo, y las cinco pruebas en las que pierde Argon, centradas en programación de varias horas, trabajo en terminal y uso de un equipo de escritorio. Las puntuaciones son porcentajes; cuanto más altas, mejor:
| Prueba | Qué evalúa | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|---|
| Vals Index | Índice compuesto de Vals AI sobre trabajo basado en conocimiento | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey Legal Agent | Tareas jurídicas realizadas de principio a fin por el modelo | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | Resolución de incidencias en repositorios reales | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | Tareas de ingeniería y optimización de varias horas | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | Tareas en una terminal Linux | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | Entrenar un modelo en una GPU en 10 horas | 45.3% | 44.3% | 40.2% | 49.3% |
| Terminal-Bench Science 0.1 | Computación científica en una terminal | 57.6% | 68.1% | 52.6% | 63.3% |
| RiemannBench | Problemas matemáticos de nivel investigador | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks, 256K a 1M | Recorrer enlaces de un grafo en un contexto largo | 84.2% | 71.8% | 65.0% | 66.8% |
| OSWorld 2.0, sin conexión | Uso de un equipo de escritorio | 69.2% | 72.6% | no publicado | no publicado |
La tabla recoge las afirmaciones de Google, no una comparación controlada. Según su nota metodológica, Argon se ejecutó con el nivel máximo de razonamiento. La mayoría de los resultados de sus competidores proceden de informes de evaluación de los propios proveedores o de clasificaciones públicas, con el ajuste de razonamiento máximo o el mejor disponible. Google obtuvo varias puntuaciones de Argon (DeepSWE, las dos filas de Terminal-Bench y OSWorld) con su propio entorno de pruebas, el código que ejecuta y puntúa las tareas, mientras que las de sus competidores procedían de otras fuentes. En Terminal-Bench Science, el programa de evaluación dispuso de seis veces más tiempo para Argon.
¿Cómo se compara el coste por respuesta de Argon con GPT-6.1 Sol, GPT-6 Astra y Opus 5.5?
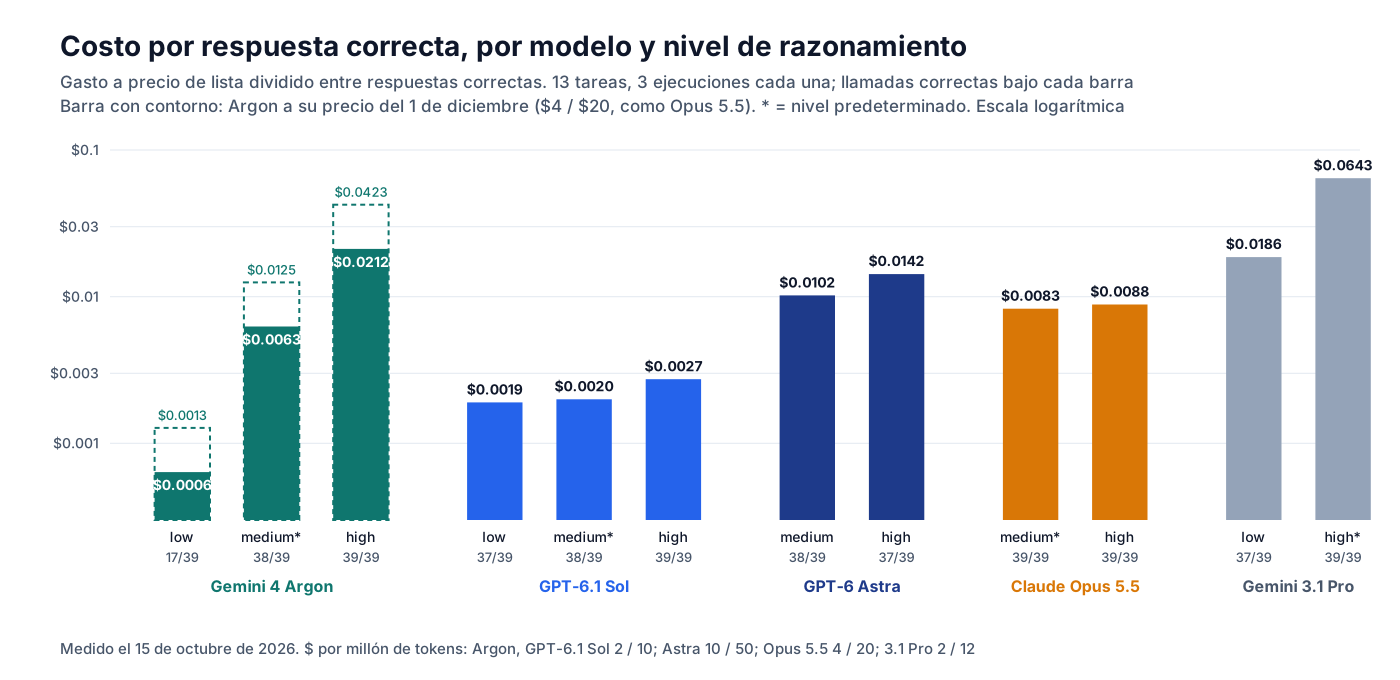
Con el mismo precio por token, Gemini 4 Argon costó 3.1x lo que GPT-6.1 Sol por respuesta correcta en medium, el nivel por defecto de ambos, y 7.7x en high. Los dos obtuvieron 38/39 en medium. Frente a los modelos de gama alta, de momento resulta más barato: su coste por respuesta correcta es 0.6x el de GPT-6 Astra y 0.76x el de Claude Opus 5.5.
Ejecutamos 13 tareas de razonamiento cuyas respuestas habíamos verificado con un programa corto, con tres ejecuciones por tarea. Cada combinación de modelo y nivel de la tabla tiene, por tanto, 39 llamadas. Una llamada cuenta como correcta si el entero final coincide. Las ocho tareas más sencillas fueron: sumar los primos menores de 60, contar las apariciones del dígito 7 entre 1 y 500, resolver un horario de trenes, calcular 7 elevado a 222 módulo 1000, aplicar una regla 40 veces seguidas, contar números de cuatro cifras distintas y no nulas divisibles por 11, contar caminos en una cuadrícula con una casilla bloqueada y contar formas de reunir 47 céntimos. Las cinco más difíciles, que denominamos conjunto difícil, fueron: aplicar la misma regla 200 veces, calcular el resto de dividir 13 elevado a 1001 entre 10007, recorrer una cuadrícula de 8x8 con tres casillas bloqueadas, elegir cuáles de 10 objetos caben bajo un límite de peso y reunir 187 céntimos con cinco tipos de monedas.
Usamos con cada modelo el formato de petición que admite su control de razonamiento: Argon y Gemini 3.1 Pro mediante el formato de chat antiguo de OpenAI, que muchos proveedores replican y cuyo control es reasoning_effort; los modelos GPT mediante el formato más reciente, Responses; y Opus 5.5 mediante el formato propio de Anthropic, cuyo control es output_config.effort. Probamos medium y high de cada proveedor, además de low cuando el modelo lo admite.
| Modelo y nivel | Llamadas correctas (de 24 fáciles / de 15 difíciles) | Mediana de tokens de salida (incluye razonamiento) | Coste por respuesta correcta | Con el precio de Argon en diciembre |
|---|---|---|---|---|
Argon low | 16/24, 1/15 | 7 | $0.0006 | $0.0013 |
Argon medium (por defecto) | 24/24, 14/15 | 383 | $0.0063 | $0.0125 |
Argon high | 24/24, 15/15 | 1,455 | $0.0212 | $0.0423 |
GPT-6.1 Sol low | 24/24, 13/15 | 90 | $0.0019 | |
GPT-6.1 Sol medium (por defecto) | 24/24, 14/15 | 81 | $0.0020 | |
GPT-6.1 Sol high | 24/24, 15/15 | 192 | $0.0027 | |
GPT-6 Astra medium (por defecto) | 24/24, 14/15 | 90 | $0.0102 | |
GPT-6 Astra high | 24/24, 13/15 | 134 | $0.0142 | |
Claude Opus 5.5 medium (por defecto) | 24/24, 15/15 | 188 | $0.0083 | |
Claude Opus 5.5 high | 24/24, 15/15 | 223 | $0.0088 | |
Gemini 3.1 Pro low | 24/24, 13/15 | 1,091 | $0.0186 | |
Gemini 3.1 Pro high (por defecto) | 24/24, 15/15 | 3,272 | $0.0643 |
La diferencia con GPT-6.1 Sol se debe a la longitud de la salida. En las 39 llamadas en medium, Argon generó un total de 22,980 tokens de salida y GPT-6.1 Sol, 7,032. En la tarea más difícil, 13 elevado a 1001 módulo 10007, la mediana de Argon fue de 1,523 tokens en medium y 6,108 en high; las de GPT-6.1 Sol fueron de 524 y 901. Las puntuaciones del conjunto difícil fueron iguales: 14/15 para ambos en medium y 15/15 para ambos en high. Desde el 1 de diciembre, la diferencia en medium se duplica hasta 6.3x, porque el precio de Argon se duplica y el de GPT-6.1 Sol no.
Diciembre también cambia la comparación con Opus 5.5. Ambos tendrán un precio de lista de $4/$20, y en nuestro conjunto Opus 5.5 generó menos tokens (15,414 frente a los 22,980 de Argon en medium) y acertó las 39 respuestas. Con el precio de diciembre, Argon cuesta $0.0125 por respuesta correcta frente a $0.0083 de Opus 5.5, es decir, 1.5x más; frente a GPT-6 Astra, pasa de 0.6x a 1.2x. Con 15 llamadas del conjunto difícil por nivel, ninguna diferencia de puntuación entre Argon, Opus 5.5 y GPT-6 Astra es estadísticamente distinguible (comprobamos estas parejas por separado del grupo de comparaciones con corrección de la siguiente sección). Los costes por tarea de Artificial Analysis ordenan los modelos del mismo modo: GPT-6.1 Sol $0.72 con su ajuste máximo, Argon $1.99 en high y con el precio actual, GPT-6 Astra $3.26 y Opus 5.5 $5.98.
Frente a Gemini 3.1 Pro, el modelo al que sustituye, Argon tiene un coste por respuesta correcta unas 10x menor con el nivel por defecto de cada modelo: $0.0063 frente a $0.0643. Parte de la diferencia se debe al precio: 3.1 Pro cobra $12 por millón de tokens de salida en lugar de $10. A igualdad de precios, la diferencia es de 8.6x y se debe a la mediana de 3,272 tokens de salida por llamada de 3.1 Pro frente a los 383 de Argon. Después del 1 de diciembre, Argon sigue siendo 5.1x más barato en este conjunto. También comprobamos cuántos tokens consume cada modelo al admitir que no conoce un dato inventado: preguntamos por cinco entidades ficticias (la cotización de una empresa, un instituto de investigación, una carta municipal, una aleación y un premio). Ambos se abstuvieron de responder en los cinco casos, con una mediana de 146 tokens de salida en Argon y 1,014 en 3.1 Pro.
¿Qué hace cada nivel de razonamiento?
En Gemini 4 Argon, low equivalió en la práctica a desactivar el razonamiento. Google documenta tres niveles y describe low como el que usa “menos tokens”, con la advertencia de que “la calidad puede bajar en tareas difíciles”. En las 39 llamadas en low, Argon no registró tokens de razonamiento, y su salida completa, que en esta ruta incluye cualquier razonamiento, fue de entre 5 y 11 tokens. Una segunda ruta de API que reenvía las peticiones a los servidores de Google registró explícitamente 0 tokens de razonamiento en las cuatro llamadas en low que enviamos. En cambio, el nivel low de Gemini 3.1 Pro generó una mediana de 1,091 tokens de salida, casi todos de razonamiento.
Sin razonamiento, Argon siguió resolviendo las tareas de un solo paso y falló en las que requerían pasos intermedios:
- Correctas también en
low: la suma de primos, el recuento de dígitos, el horario, la cuadrícula con una casilla bloqueada y los 47 céntimos (15 de 15 llamadas). - Incorrectas en
low: la regla de 40 pasos (0/3), el recuento de números de cuatro cifras (0/3), 7 elevado a 222 (1/3) y 14 de las 15 llamadas del conjunto difícil.
La caída se mantiene cuando cada tarea cuenta una sola vez, lo cual importa porque tres ejecuciones de la misma tarea no son independientes: medium superó a low en 8 de las 13 tareas y no perdió en ninguna (prueba de los signos, p = 0.008, una probabilidad inferior al 1% de que una diferencia de este tamaño se deba al azar). Solo en el conjunto difícil, low no resolvió ninguna de las cinco tareas en al menos dos de tres ejecuciones y medium resolvió las cinco (prueba exacta de Fisher, p = 0.008; 0.047 tras la corrección de Holm para las seis comparaciones que realizamos). Trata low como un modo sin razonamiento para consultas de datos y conversión de formatos. En el otro extremo, high costó 3.4x lo que medium por respuesta correcta y acertó una llamada más de las 15 del conjunto difícil, una diferencia que esta muestra no permite distinguir del azar.
El nivel por defecto se adapta al prompt. En prompts sencillos enviados sin especificar nivel, Argon, cuyo valor por defecto es medium, a menudo consumió cero tokens de razonamiento; Gemini 3.1 Pro, cuyo valor por defecto es high, razonó en todos ellos. En las llamadas a herramientas, el modelo pide a tu código que ejecute una función y tú le devuelves el resultado:
| Tipo de prompt (mediana de 3 ejecuciones) | Tokens de razonamiento de Argon | Tokens de razonamiento de Gemini 3.1 Pro |
|---|---|---|
| Consulta con respuesta de una palabra | 0 | 145 |
| Extracción a JSON | 0 | 353 |
| Salida con esquema JSON estricto | 0 | 309 |
| Problema de enunciado de dos pasos | 41 | 137 |
| Cadena aritmética de cinco pasos | 68 | 373 |
| Bucle de llamadas a herramientas, primer turno (elegir herramienta) | 0 (31 tokens de salida) | 173 |
| Bucle de llamadas a herramientas, segundo turno (usar el resultado) | 0 (32 tokens de salida) | 67 |
Ambos modelos respondieron correctamente a todos los prompts y llamaron a las herramientas adecuadas. En la API nativa de Google, el nivel se indica en generation_config y el recuento de razonamiento se devuelve en usage:
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Compute 13 raised to the power 1001, modulo 10007. Reply with a single integer.",
    generation_config={"thinking_level": "medium", "max_output_tokens": 32768},
)
print(interaction.output_text)
print("thinking tokens:", interaction.usage.total_thought_tokens)  # billed at the output rate
print("output tokens:", interaction.usage.total_output_tokens)
En el formato de chat compatible con OpenAI que usamos para las mediciones, el gateway convierte reasoning_effort en esos mismos tres niveles y devuelve el recuento en usage.completion_tokens_details.reasoning_tokens.
¿Qué deja de funcionar al migrar a Gemini 4 Argon?
Los prompts que terminan con un turno del asistente prerrellenado ahora fallan con HTTP 400, desaparece la caché explícita y se ignoran los ajustes de aleatoriedad (temperature, top_p, top_k). Prerrellenar consiste en iniciar tú mismo la respuesta del modelo, por ejemplo con una llave de apertura para forzar JSON. La mayoría de estos cambios aparecen en la lista de comprobación de Google para la migración; el error de prerrelleno, los tokens adicionales del prompt y el comportamiento al superar el límite no aparecen:
| Cambio | Documentación de Google | Qué medimos |
|---|---|---|
| Turno del asistente prerrellenado | No figura | HTTP 400 en Gemini 4 Argon: “No se admiten peticiones que terminen con un turno del modelo”; Gemini 3.1 Pro lo acepta |
Caché explícita (cachedContents) | Eliminada | No probada; la caché implícita funcionó |
| Caché implícita | 95% de descuento, prompts de 4,096+ tokens | Al repetir un prompt de 6,935 tokens 4 segundos después, 4,881 tokens se sirvieron desde caché a $0.10 por millón; un prompt de 3,006 tokens también obtuvo 952 tokens en caché |
temperature, top_p, top_k | Se ignoran | Se aceptaron con HTTP 200 (sin error) |
| Sobrecoste fijo de tokens del prompt | No figura | Unos 30 tokens de entrada más por petición que Gemini 3.1 Pro para el mismo texto; una segunda ruta de API a Google devuelve el mismo recuento |
| Prompt que supera la ventana de 1M | No figura | HTTP 400 que indica el límite, sin truncamiento silencioso |
max_output_tokens | Aumentar a 32,768 o más | La respuesta más larga de Argon fue de 6,391 tokens en high; la de Gemini 3.1 Pro, de 21,362 |
Para resolver el error de prerrelleno, mueve la instrucción al prompt. Los tokens adicionales cuestan $0.00006 por petición al precio actual y su cantidad es constante: 27 tokens más en un prompt de una línea y 31 en un documento de 709K tokens respecto a Gemini 3.1 Pro. Por tanto, no ha cambiado el tokenizador, que divide el texto en tokens. Ese prompt de 709K tokens contenía 60,000 elementos numerados y, al final, una pregunta sobre el elemento 42; Argon aceptó la petición y respondió 529, el valor que habíamos insertado.
¿Qué nivel de razonamiento conviene para cada carga de trabajo?
Empieza con medium, no uses nunca low para tareas de varios pasos y calcula el presupuesto con el precio de diciembre.
| Carga de trabajo | Riesgo principal | Nivel y modelo | Cifras que lo respaldan |
|---|---|---|---|
| Pasos de agentes, llamadas a herramientas, extracción, salida JSON | Pagar por razonamiento en pasos sencillos | Gemini 4 Argon medium; ya consume casi nada en razonamiento en estos casos | 0 tokens de razonamiento en consultas, extracción, salida con esquema y pasos de herramientas |
| Matemáticas difíciles, algoritmos, código de varios pasos | Respuestas incorrectas | Argon medium; prueba high en tus propias evaluaciones antes de pagar por él | 14/15 frente a 15/15 llamadas del conjunto difícil, con un coste 3.4x mayor en high |
| Razonamiento a gran escala donde prima el coste por respuesta | Volumen de razonamiento | GPT-6.1 Sol, misma puntuación en este conjunto de 13 tareas | $0.0020 frente a $0.0063 por respuesta correcta, 6.3x desde el 1 de diciembre |
| Trabajo de gama alta con presupuesto más allá de diciembre | Duplicación del precio de Argon | Repite tus evaluaciones con Claude Opus 5.5, con el mismo precio de lista de $4/$20 | $0.0083 frente a $0.0125 por respuesta correcta con los precios de diciembre; Argon lidera más filas de trabajo basado en conocimiento en las pruebas de Google |
| Documentos largos de más de 200K tokens | Recargo por contexto largo | Argon en lugar de Gemini 3.1 Pro | $1.42 frente a $2.84 para un prompt de 709K tokens |
| Solo consultas de datos y conversión de formatos | Razonamiento innecesario | Argon low | 15/15 en tareas de un paso, 7 tokens de salida |
Después del 1 de diciembre, Batch y Flex costarán lo mismo que Standard ahora ($2/$10). Mover allí los trabajos que no requieren respuesta inmediata permite mantener los precios de octubre.
Preguntas frecuentes
¿Se puede desactivar el razonamiento en Gemini 4 Argon?
Gemini 4 Argon no tiene un ajuste documentado para desactivarlo, pero thinking_level: "low" funcionó como tal en nuestras pruebas: no se notificó ningún token de razonamiento en las 39 llamadas, cuya salida completa fue de entre 5 y 11 tokens, y un 0 explícito en las cuatro llamadas realizadas mediante una segunda ruta de API a Google. En low acertó 1 de las 15 llamadas de las cinco tareas más difíciles, frente a 14 de 15 en el nivel por defecto, medium.
¿Gemini 4 Argon cobra más por los prompts largos? Gemini 4 Argon cobra la misma tarifa de $2/$10 para cualquier prompt que quepa en su ventana de 1,048,576 tokens hasta el 30 de noviembre de 2026, y $4/$20 después. Gemini 3.1 Pro cobra $4/$18 por encima de 200K tokens, así que, a precio de lista, un prompt de 709K tokens cuesta $1.42 en Argon y $2.84 en 3.1 Pro.
¿Funciona la caché implícita en Gemini 4 Argon? La caché implícita de Gemini 4 Argon sirvió desde caché 4,881 tokens de un prompt repetido de 6,935 tokens, 4 segundos después de la primera llamada, a $0.10 por millón de tokens (un 95% de descuento sobre la entrada). También almacenó parte de un prompt de 3,006 tokens, por debajo del mínimo de 4,096 tokens que indica la documentación de Google.
Lecturas relacionadas
- GPT-6.1 Sol frente a Claude Sonnet 5.5: el mismo conjunto de 13 tareas con la misma tarifa de $2/$10
- Comparación de los controles de razonamiento de los LLM: qué hace el parámetro de esfuerzo de cada proveedor
- Mínimos de caché de prompts: mediciones: umbrales documentados frente a los reales
- Coste de la API de Gemini 3.7 Flash: el anterior lanzamiento de Gemini con precio introductorio
Mediciones realizadas el 15 de octubre de 2026, dos días después de la disponibilidad general de la API. Niveles de razonamiento: 13 tareas con respuestas verificadas por programa, 3 ejecuciones por modelo y nivel, significación comprobada contando cada tarea una sola vez; cada prompt llevaba un ID aleatorio para impedir que se sirviera una respuesta desde caché. Los costes se calcularon a precio de lista a partir de los recuentos de tokens. Pruebas de sobrecoste de razonamiento, salida estructurada y herramientas: 3 ejecuciones por caso; pruebas de migración, caché, contexto largo y datos inventados: llamadas individuales. El resultado de low y los tokens adicionales del prompt se confirmaron mediante una segunda ruta de API que reenvía las peticiones a Google. Cifras de Artificial Analysis consultadas el 14 de octubre de 2026; tabla de pruebas de Google tomada de la ficha del modelo Gemini 4 Argon.