
HTTP ヘッダー 3 つで LLM エージェントをトレース、SDK 不要
エージェントのモデル呼び出しに3つのリクエストヘッダーを追加して、実行ごとの処理の流れをウォーターフォールで表示します。並列で行われたモデル呼び出し、自前コード内で費やした時間、失敗した呼び出し、コストを確認し、各実行の内訳を把握できます。
推奨モデル
リアルタイム価格| モデル | 評価 | 価格 |
|---|---|---|
| GPT-6 Luna デモの関数呼び出しループを処理します。このページに示す実行では、ターンごとの2回の呼び出し(計画と回答)の合計コストは$0.0002です。 | デモのメインエージェント | $0.1/100万〜 |
| DeepSeek V4.1 Flash 推論をオフにして、各1文の3つのチェックを並列実行します。このページに示すセッションでは、6回の呼び出しのコストは$0.0004で、7回目のサブエージェント呼び出しは失敗し、コストは$0でした。 | デモのサブエージェント | $0.3/100万〜 |
目次
1 件のメッセージに答えるまでにモデルを 5 回呼び出すエージェントは、リクエストを並べただけのログではデバッグしづらいものです。同じ実行に属する呼び出しも、並列に動いた呼び出しも、待ち時間のうち自前のコードが占める割合もわかりません。この記事では、小さなサポート用エージェントにリクエストヘッダーを 3 つ追加します。その結果を Synthorai コンソールで、トレース(1 回の実行を時系列で描いたもの)とセッション(コストを含む 1 件の会話)として確認します。トレーシング SDK のインストールも、collector(トレースを受け取る別サービス)の運用も不要です。ソースは github.com/synthorai-io/use-cases の agent-tracing/ にあります。Python 3.10 以降と、コンソールで発行した API キーが必要です。
TL;DR
- モデル呼び出しごとに 3 つのリクエストヘッダー(
X-Trace-Id、X-Span-Id、X-Session-Id)を付けると、Synthorai コンソールでリクエストログをトレースとセッションとして確認できます。トレーシング SDK は不要です。 - デモのトレースでは、実経過時間 8.5 s のうち約 7.0 s がモデル呼び出し、その外側の 1.6 s がエージェント自身のコードとネットワークにかかった時間でした。
- 404 で失敗した呼び出しもトレースに残り、コストは $0 でした。
- モデルを 21 回呼び出したデモの実行コストは $0.0017 でした。
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd agent-tracing
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --fail
2026 年 10 月 11 日に実行したときは、1 分以内にモデルを 21 回呼び出し、コストは $0.0017 でした。実行するとセッション ID が 2 つ、トレース ID が 4 つ出力されます。コンソールのトレースを開くと、同じ ID が一覧に表示されます。コンソールの時刻はブラウザーのタイムゾーンで表示されるため、この記事のスクリーンショットでは 11:24 UTC が 19:24 になっています。
トレースを表示するために送るもの
モデル呼び出しごとに 3 つのヘッダーを送ります。値には任意の文字列を使えます。ゲートウェイはもともとすべてのリクエストを記録しています。ヘッダーは、どのリクエストをまとめるかを伝えるだけです。
| ヘッダー | 同じ値を送る範囲 | 表示されるもの |
|---|---|---|
X-Trace-Id | 1 回の実行に含まれるすべての呼び出し(1 件のユーザーメッセージを最初から最後まで処理する単位) | 呼び出しをまとめた 1 つのウォーターフォール |
X-Span-Id | 1 回の呼び出しだけ | ウォーターフォール内のその呼び出しの行名 |
X-Session-Id | 1 件の会話に含まれるすべての呼び出し | 実行のまとまりと会話全体の集計 |
スパンは、トレース内の 1 つの処理ステップです。この記事では、各スパンが 1 回のモデル呼び出しに対応します。各 ID は最大 128 文字の印字可能な ASCII 文字で指定できます。ゲートウェイはレスポンスに ID を返しますが、モデルプロバイダーには転送しません。
ほかに 3 つの任意ヘッダーがあります。X-Agent-Id は呼び出し元のサブエージェント、X-Parent-Agent-Id はそのサブエージェントを起動したエージェントを示します。X-Synthorai-Metadata には機能名やエンドユーザーなどのラベルを入れます。すべてリクエストヘッダーのリファレンスに記載されています。デモでは X-Agent-Id とラベルを送り、X-Parent-Agent-Id は送りません。サブエージェントは 1 つだけで、メインエージェントから起動するため、入れ子構造を示す必要がないからです。
デモでは、1 つの関数で呼び出し用のヘッダーを組み立てます。この関数がトレーシング層のすべてです。
@dataclass
class Run:
    """One agent run, which the gateway shows as one trace."""
    session_id: str
    labels: dict = field(default_factory=dict)
    trace_id: str = field(default_factory=lambda: new_id("trace"))

    def headers(self, span: str, agent: str | None = None, parent: str | None = None) -> dict:
        h = {
            "X-Session-Id": self.session_id,
            "X-Trace-Id": self.trace_id,
            "X-Span-Id": span,
        }
        if agent:
            # Only sub-agents need an id. Calls without one belong to the main agent.
            h["X-Agent-Id"] = agent
        if parent:
            h["X-Parent-Agent-Id"] = parent
        if self.labels:
            h["X-Synthorai-Metadata"] = json.dumps(self.labels, separators=(",", ":"))
        return h
エージェント内のすべてのモデル呼び出しは、ヘッダーを付ける共通のラッパーを通します。OpenAI Python SDK では、リクエストごとのヘッダーを extra_headers に渡します。
raw = await client.chat.completions.with_raw_response.create(
    model=model, messages=messages,
    extra_headers=run.headers(span, agent, parent), **kwargs)
resp = raw.parse()
request_id = raw.headers.get("x-request-id")   # the gateway's id for this call
with_raw_response を使うのは、レスポンスヘッダーを読むためだけです。リクエスト ID が不要なら、通常の create(..., extra_headers=...) で十分です。
デモのエージェントが行う処理
顧客のメッセージに、4 段階、5 回のモデル呼び出しで回答します。トレースで確認できる処理があるように、この構成にしています。メインエージェントは GPT-6 Luna、サブエージェントは DeepSeek V4.1 Flash を使い、どちらも環境変数で指定します。サブエージェントの呼び出しでは reasoning_effort="none" を設定しています。1 文のチェックに、回答前の推論は必要ないためです。この値を受け付けないモデルをサブエージェントに指定する場合は、ANALYST_REASONING を変更するか、設定を解除してください。
| スパン | 実行主体 | 処理 |
|---|---|---|
plan | メインエージェント | メッセージを読み、ツールを要求する(function calling:モデルが関数名と引数を返し、自前のコードが実行する) |
| なし | 自前のコード | 注文検索(1.2 s)とポリシー検索(0.6 s)の 2 つのツールをローカルで並列実行する |
sentiment、policy-check、risk | サブエージェント analyst | 1 文で答える 3 つのチェックを同時に送る |
answer | メインエージェント | ツールの結果と 3 つのチェックをもとに返信を書く |
ツールは sleep を入れた普通の Python 関数で、データベースと検索インデックスの代わりです。--fail を指定すると、1 回の policy-check 呼び出しが最初に存在しないモデルを要求し、404 を受け取ってから、policy-check.retry というスパン名で再試行します。
run.py は、それぞれ 2 ターンの会話を 2 件実行します。会話ごとにセッション ID を 1 つ割り当て、ターンごとに新しいトレース ID を割り当てます。
session_id, history = new_id("support"), []
for text in turns:
    run = Run(session_id, labels={"feature": "support-agent", "release": "v2", "_user": user})
    reply = await handle(run, history, text)
ウォーターフォールの読み方
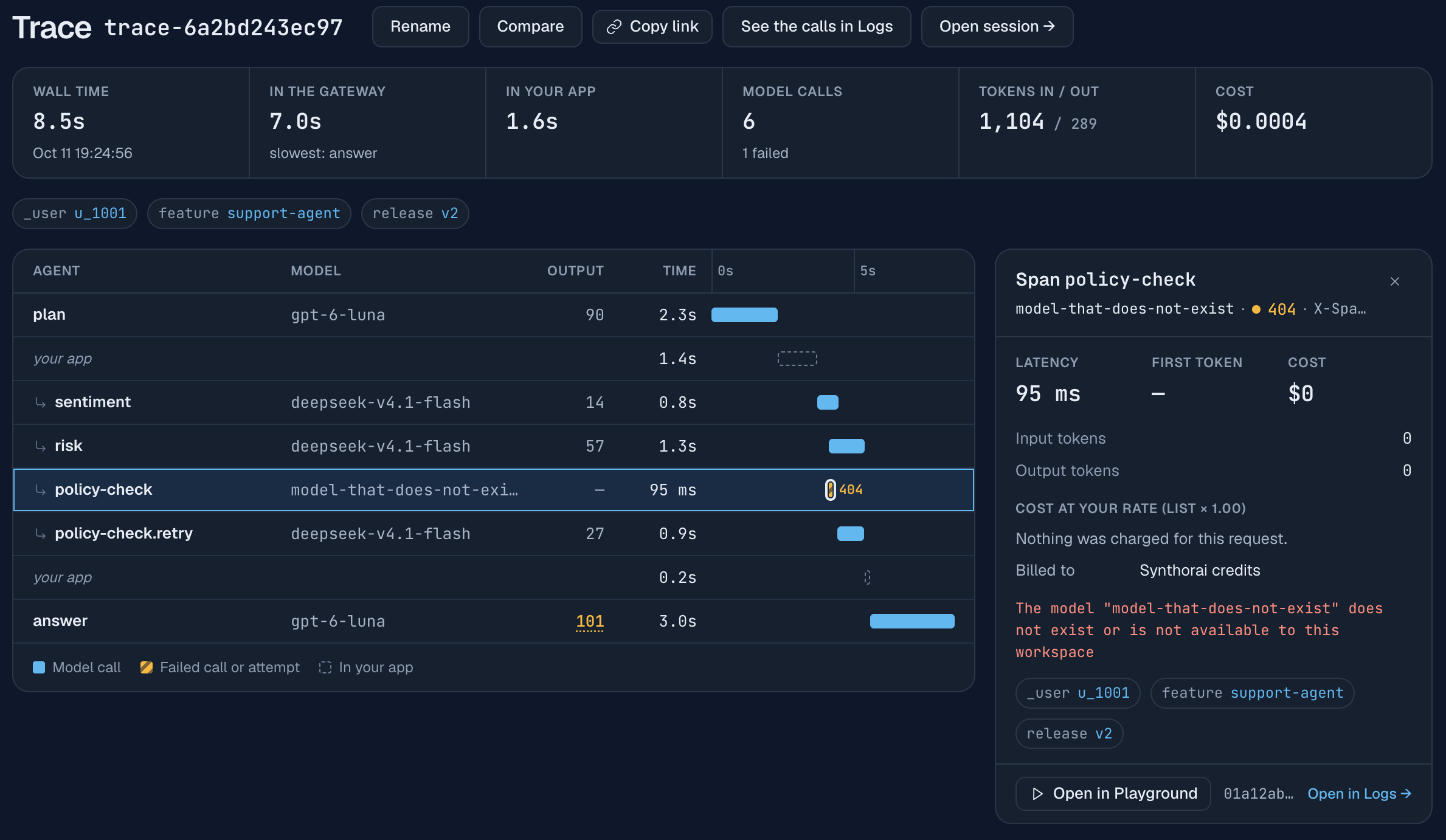
各行は、1 回のモデル呼び出し、または自前のコードを実行していた空白区間です。実行の最初の呼び出しがゲートウェイに到着した時点を起点とする時間軸に配置されます。上のスクリーンショットは、最初の会話の 2 ターン目です。上から順に見ていきます。
planは 2.3 s。バーは、ゲートウェイがリクエストを受信してからレスポンスを返し終えるまでの時間です。your appは 1.4 s。この区間では処理中のリクエストがないため、時間を使ったのはゲートウェイの外側です。自前のコードと、コードからゲートウェイまでのネットワーク時間が含まれます。ここでは 2 つのローカルツールを実行しており、遅い方は 1.2 s 待機します。実際のエージェントでは、遅いデータベースクエリやベクトル検索がこの行に現れます。sentiment、risk、policy-check.retryは重なっています。エージェントはasyncio.gatherで 3 つのチェックを送っています。バーの重なりが並列呼び出しを表します。名前の前の矢印は、サブエージェントによる呼び出しを示します。policy-checkは404が付いた 95 ms の斜線付きの印です。失敗した呼び出しも、コードが受け取ったステータスコードとともにトレースに残ります。answerは 3.0 s で、最も遅い呼び出しです。ウォーターフォール上部のサマリーにもそう表示されています。- 「Output」列は各呼び出しの出力トークン数です。呼び出し時間は出力に使われるため、この列を見ると、隣のバーの長さを説明できることが多くあります。
answerは 101 トークン、3 つのチェックはそれぞれ 14 から 57 トークンを出力しました。出力が多く、その大半を推論が占める場合、コンソールはトークン数に下線を付けます。ここでは 101 に下線が付いています。
サマリーでは、実経過時間 8.5 s をゲートウェイ内の 7.0 s とアプリ側の 1.6 s に分けています。この内訳で、レイテンシ調査の最初の判断、モデル呼び出しを見るべきか、自前のコードを見るべきかができます。この実行では待ち時間の 82% がモデルにかかった時間です。そのうち 5.3 s をメインエージェントの plan と answer が占めています。3 つのチェックを高速化するより、メインエージェントに速いモデルを使う方が効果があります。
ゲートウェイからコード内部は見えません。リクエスト間の空白から your app の行を推定するため、自前のコードがどれだけの時間動いたかはわかっても、何をしたかはわかりません。自前の関数にもスパンが必要なら、トレーシングのオープン標準である OpenTelemetry の SDK を使います。両者で ID を共有することもできます。X-Trace-Id を送らない場合、ゲートウェイはトレース ID を運ぶ標準ヘッダー traceparent を読み取ります。
セッションでわかること
セッションは、1 件の会話に含まれる実行をまとめて集計します。トレース一覧から開くか、いずれかのトレースで「セッションを開く」を選びます。
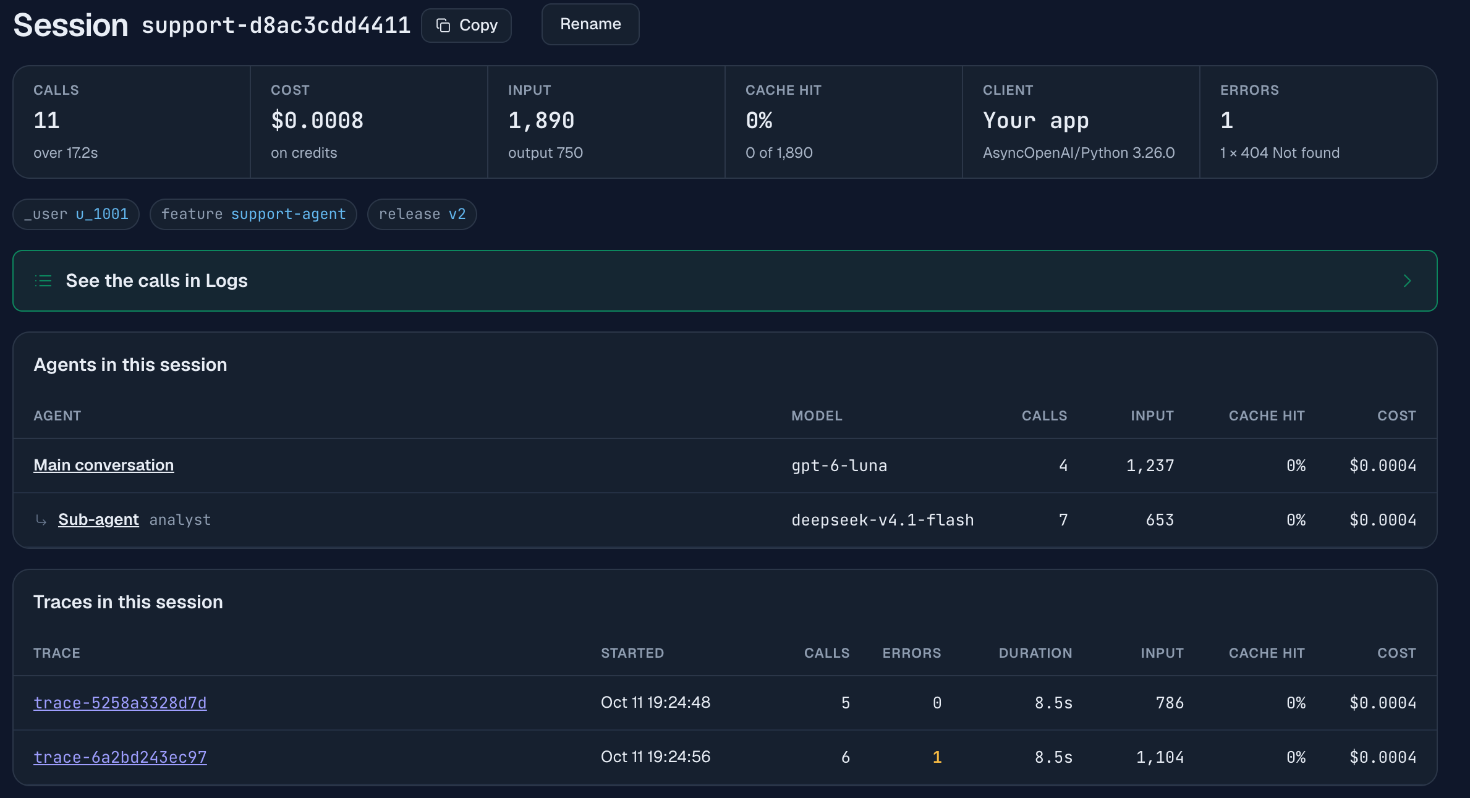
上のセッションは、2 ターンからなる 1 件の顧客との会話です。呼び出しは 11 回、入力は 1,890 トークン、出力は 750 トークン、コストは $0.0008、エラーは 1 件です。ページは 3 つの部分に分かれています。
- 「このセッションのエージェント」 は、呼び出し数とコストをエージェント別に集計します。メインエージェントは GPT-6 Luna を 4 回呼び出し、コストは $0.0004 でした。
analystサブエージェントは 7 回で $0.0004、そのうち 6 回が DeepSeek V4.1 Flash、1 回が失敗した呼び出しです。この表が表示されるのは、サブエージェントの呼び出しにX-Agent-Id: analystが付いているためです。このヘッダーがない呼び出しは、メインの会話として集計されます。 - 「このセッションのトレース」 は、各ターンのエラー、所要時間、入力トークン数、キャッシュヒット率、コストを一覧にします。長い会話でもログをスクロールせずに、遅いターン、失敗したターン、コストの高いターンを見つけられます。
- 「キャッシュヒット率」 は、入力トークンのうちプロバイダーの prompt cache から読み込んだ割合です。ここでは 0% です。プロンプトが数百トークンしかなく、プロバイダーがキャッシュするのは最低長を超えたプレフィックスだけだからです。多くのプロバイダーでは 1,024 トークンが最低長です。プロンプトキャッシュを参照してください。
セッション ID にはもう 1 つ役割があります。プロンプトがキャッシュ対象になる長さに達すると、この役割が重要になります。会話内のすべての呼び出しで同じ X-Session-Id を送ってください。ゲートウェイはこの値を使って、会話内で prompt cache のヒットが安定するようにします。これにより、2 ターン目で 1 ターン目に書き込んだキャッシュを読み込めます。フレームワークでヘッダーを設定しづらい場合、/v1/chat/completions と /v1/responses ではリクエストボディの session_id に値を指定できます。
機能別、ユーザー別にコストを集計する方法
文字列の値を持つフラットな JSON オブジェクトを X-Synthorai-Metadata で送り、その値でグループ化や絞り込みを行います。デモでは、すべての呼び出しに機能、リリース、エンドユーザーのラベルを付けています。
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}ラベルは、トレースとセッションに小さなタグとして表示されます。集計を見るには「分析」を開き、「内訳」タブの「メタデータ別コスト」カードを探します。キーを選ぶと、そのキーの各値について、リクエスト数、エラー数、入力トークン数、コストが表示されます。
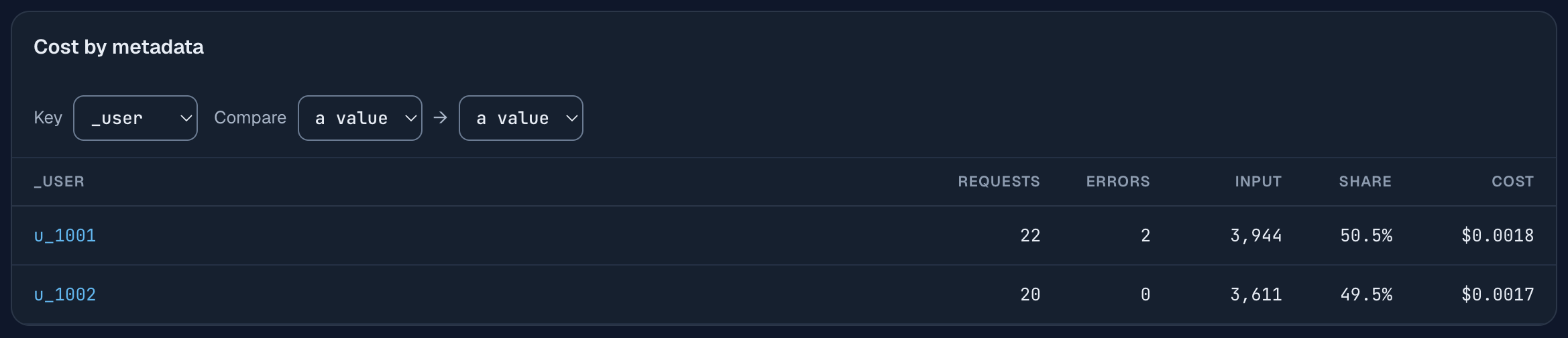
上のカードは、デモを 2 回実行した 1 時間分です。2 回の失敗を含む u_1001 は 22 リクエストで $0.0018、u_1002 は 20 リクエストで $0.0017 です。1 回実行した直後なら、11 と 10 が表示されます。機能ごとの料金を見るなら feature、プロンプト変更によるコストへの影響を見るなら release を選びます。同じキーの 2 つの値を並べて比較することもできます。同じタブには「エージェント別コスト」カードもあり、セッションをまたいで各 X-Agent-Id を集計します。
数値のもとになった実行を探すときは、ラベルで検索できます。トレース一覧の検索欄に metadata._user = u_1002 と入力して Enter を押すと、そのユーザーのセッションとトレースだけが残ります。「ログ」のフィルター欄でも、同じ式で個々のリクエストを絞り込めます。
ラベルのルールは次のとおりです。
- 1 リクエストにつき最大 10 個です。キーは
a-z、0-9、_、.、-からなる 1 から 32 文字です。値は最大 128 バイトの文字列です。 _userは、そのリクエストの対象となるエンドユーザーを示すラベルです。ほかのアンダースコアで始まるキーは予約されています。- ルールに違反するラベルは除外されますが、リクエストは実行されます。レスポンスヘッダー
X-Synthorai-Metadata-Droppedに除外されたキーが入るため、設定時にはこのヘッダーをログに残してください。確認のためにBad?Keyというキーを送ったところ、レスポンスヘッダーにBad?Keyが返りました。 - プロンプト本文、個人情報、シークレットをラベルに入れないでください。
_userにはメールアドレスではなく、内部のユーザー ID を使います。
呼び出しが失敗した場合
失敗した呼び出しは、ステータスコード付きの斜線の印としてトレースに残り、コストはかかりません。デモで失敗した policy-check は、存在しないモデル ID を要求しています。ウォーターフォールで選択すると、上のスクリーンショットの右側にパネルが開きます。コードが受け取ったエラー The model "model-that-does-not-exist" does not exist or is not available to this workspace、レイテンシ 95 ms、コスト $0、課金されていないことを示す注記が表示されます。
デモでは、再試行に別のスパン名を付けています。
try:
    await call(run, span, model=BROKEN_MODEL, messages=messages, agent="analyst")
except APIStatusError:
    span = f"{span}.retry"      # the retry is its own span, so both show in the waterfall
resp = await call(run, span, model=ANALYST_MODEL, messages=messages, agent="analyst", max_tokens=400,
                  **analyst_options())   # reasoning_effort="none" unless ANALYST_REASONING says otherwise
トレース ID を維持してスパン名を変えることで、失敗と再試行を 1 つの画面に並べられます。再試行を行うライブラリが同じヘッダーを再利用しても、両方の試行が同名の 2 行として表示されます。
エラーも集計されます。トレースのサマリーには「モデル呼び出し 6 回、失敗 1 回」、セッションにはステータスコード別のエラー(1 × 404 Not found)が表示されます。トレース一覧の「エラー」列で並べ替えると、確認が必要な実行を見つけられます。
各呼び出しのコストをコードで取得する方法
レスポンスで返されたリクエスト ID を使って、ゲートウェイにそのリクエストの課金レコードを問い合わせます。GET /v1/generation?id=<request id> は、1 リクエストのコスト、トークン数、レイテンシ、ステータスを返します。
async def cost_of(http: httpx.AsyncClient, request_id: str) -> float | None:
    """The billing record of one request. It is written a moment after the call returns."""
    if not request_id:
        return None                                  # a call that got no response has no record
    for _ in range(6):
        try:
            r = await http.get(f"{BASE_URL}/generation", params={"id": request_id})
            if r.status_code == 200:
                return r.json()["data"]["total_cost"]
        except (httpx.HTTPError, KeyError, TypeError, ValueError):
            pass                                     # a dropped connection or a half-written record: try again
        await asyncio.sleep(2)
    return None
レコードはレスポンス完了の少し後に書き込まれるため、この関数は 200 を受け取るまで再試行します。呼び出し側で Authorization ヘッダーを設定した httpx.AsyncClient を一度だけ作り、すべての問い合わせに渡します。20 件の呼び出しを 1 つのクライアントで調べれば、少数の接続を再利用できます。問い合わせごとにクライアントを作ると 20 接続が同時に開かれ、今回の実行ではそのうち 1、2 接続が切断されました。デモは、自前で計測した時間とこれらのレコードを使って、呼び出しごとに 1 行を出力します。次はスクリーンショットにあるセッションの 1 ターン目です。
trace trace-5258a3328d7d  session support-d8ac3cdd4411
  plan                 main     gpt-6-luna                 200   1878 ms    153 in   22 out  $0.000026
  sentiment            analyst  deepseek-v4.1-flash        200   1431 ms     91 in   28 out  $0.000061
  risk                 analyst  deepseek-v4.1-flash        200   1877 ms     96 in   33 out  $0.000068
  policy-check         analyst  deepseek-v4.1-flash        200   1885 ms     96 in   39 out  $0.000076
  answer               main     gpt-6-luna                 200   4142 ms    350 in  339 out  $0.000205
ここでの時間はクライアント側の計測で、ネットワーク時間を含みます。そのため、ゲートウェイ内部のリクエスト時間を測るコンソールのバーより長くなります。上のウォーターフォールにある 2 ターン目では、plan はクライアント側で 2,499 ms、ゲートウェイ内で 2.3 s、answer はそれぞれ 3,161 ms と 3.0 s でした。並列に送った呼び出しでは、差がさらに大きくなることがあります。失敗した呼び出しはクライアント側で 694 ms、ゲートウェイ内で 95 ms でした。
各呼び出しの課金額を自前のログに残したい場合は、この関数をコピーして使ってください。使いすぎている実行を止める用途には向きません。レコードが届くのは呼び出しの少し後で、関数が数秒待つこともあるためです。実行中に予算を管理するなら、各レスポンスの usage からその都度コストを計算し、後から課金レコードで計算を照合します。
すでにトレースヘッダーを送っている場合
何も追加しなくてよい場合があります。3 種類の ID のうちリクエストに含まれていないものについて、ゲートウェイは一般的なツールが送る対応ヘッダーを読み取ります。
| 使用するツール | 送信するヘッダー | 読み取り先 |
|---|---|---|
| OpenTelemetry の HTTP 計装 | traceparent | トレース、親 ID をスパンとして使用 |
| LiteLLM SDK | X-Litellm-Trace-Id、X-Litellm-Session-Id | トレース、セッション |
| Langfuse SDK | baggage: langfuse_trace_id=…、langfuse_session_id=… | トレース、セッション |
| Open WebUI | X-OpenWebUI-Chat-Id | セッション |
| Claude Code | X-Claude-Code-Session-Id | セッション |
| OpenAI Codex CLI | Session-Id | セッション |
両方がある場合は、自分で指定した X-Trace-Id、X-Span-Id、X-Session-Id が優先されます。全一覧はリクエストヘッダーのリファレンスにあります。これらを一切送らないエージェントフレームワークでは、そのフレームワークのカスタムヘッダー設定を使って追加してください。
取得したトレースの使い方
最もよく使うのは、別のトレースとの比較です。各トレースページには「比較」ボタンがあります。2 つ目のトレースを選ぶと、コンソールが両方を 1 ページに表示します。各指標は A、B、差分で表示され、同じ名前の呼び出しが対応付けられます。2 つのウォーターフォールも同じ時間軸に並びます。これで、プロンプト、モデル、自前のコードの変更が実行にどう影響したかを確認できます。
次の 3 本の記事でも、同じエージェントとヘッダーを使います。それぞれ問題を再現し、修正して、この方法で比較します。
- LLM エージェントが遅い原因を調べる 直列の呼び出し、自前コードの遅いツール、1 行の回答に使われる推論。
- LLM エージェントのコストが高い原因を調べる キャッシュを無効にするタイムスタンプ、増え続けるコンテキスト、再試行ループ、モデルの選択ミス。
- LLM エージェントをデバッグする ユーザーからの問い合わせを起点に、問題のあった呼び出しを特定する。
さらに 3 本の記事では、同じログを別の角度から見ます。
- Claude Code のコストをサブエージェント別に確認する 自分で書いていないコーディングエージェントを、同じセッション画面とエージェント画面で確認する。
- LLM のログについて Claude に質問する 読み取り専用の MCP 接続を通じて、これらのセッションに関する質問にチャット画面で答える。
- エージェントにログを調べるツールを渡す 同じツールを自分のプログラムで使う方法と、モデルのトークンにかかるコスト。
このデモで扱わないこと
デモの対象はモデル呼び出しです。本番環境では通常、次の 4 点も検討します。
- 自前コードのスパン。ゲートウェイはモデル呼び出し間の空白を表示しますが、その間の処理内容は表示しません。ツール、検索、キューを OpenTelemetry で計装し、
traceparentを引き継げば、1 つのトレース ID で両方の画面を関連付けられます。 - プロンプトとレスポンスの本文。この記事では、各呼び出しの時間、トークン数、コストのレコードを使います。モデルに送った内容の確認は扱いません。
- 予算。
cost_ofで得られるのは、実行後の課金額です。上限に達したら実行を止めるには、レスポンスが届くたびにusageからコストを計算します。エージェントのループに数行追加する処理ですが、デモには含めていません。 - サンプリング。トレースはゲートウェイがもともと保持するリクエストログから作るため、すべての呼び出しが記録されます。サンプリングするものはなく、エージェント側の追加負荷も数個のヘッダーだけです。
FAQ
LLM エージェントのトレーシングに OpenTelemetry は必要ですか?
必要ありません。モデル呼び出しごとに 3 つのリクエストヘッダー(X-Trace-Id、X-Span-Id、X-Session-Id)を付ければ、モデル呼び出しのウォーターフォールを表示でき、呼び出し間の時間はアプリ側の時間として表示されます。自前の関数にもスパンが必要になったら、OpenTelemetry が役立ちます。
トレースとセッションの違いは何ですか?
トレースは、エージェントの 1 回の実行です。1 件のユーザーメッセージやタスクを処理するために行ったすべてが含まれます。セッションは、複数の実行からなる 1 件の会話です。デモでは、顧客との会話ごとに 2 つのトレースを持つセッションを作り、各トレースに 5 回または 6 回のモデル呼び出しが含まれます。
トレースヘッダーはルーティング、課金、モデルに渡る内容を変えますか?
X-Trace-Id と X-Span-Id は何も変えません。X-Session-Id は、会話内の prompt cache のヒットを安定させます。どのヘッダーもモデルプロバイダーには転送されず、課金はゲートウェイ自身のリクエスト ID を基準に行われます。
トレースはどれくらい保存されますか?
トレースとセッションはリクエストログから作られ、同じ 90 日間が対象です。トレース一覧を開くと、直近 7 日間が表示されます。
失敗した呼び出しにもコストはかかりますか?
デモで失敗した呼び出しは、未知のモデル ID に対する 404 です。コスト $0 と、課金されていないことを示す注記が記録されました。
関連記事
- LLM チャットボットを作る:単一エージェントでのコンテキスト管理、メモリ、プロンプトキャッシュ。
- リクエストヘッダーのリファレンス:この記事のすべてのヘッダーと、ほかのツールから読み取る別名。
- コンソールのトレースとセッション:一覧、ウォーターフォール、セッションページ。
- LLM のトークン使用量の内訳:各レコードのトークン数が何を表すかを、プロバイダー別に解説。