
LLM エージェントが遅い理由:トレースで見つかる 3 つの原因
エージェントが遅くなる3つの原因を、それぞれ再現して修正します。モデル呼び出しの直列実行では、処理時間が3.7秒から1.8秒に短縮。自前のコード内で動く遅いツールと、1行で済む回答に推論を使うケースも取り上げ、原因ごとに修正の内容を確認します。
推奨モデル
リアルタイム価格| モデル | 評価 | 価格 |
|---|---|---|
| GPT-6 Luna 一文の回答を五回生成した際の所要時間の中央値は、デフォルトの推論設定では25.6 s、reasoning_effortをnoneに設定した場合は10.2 sで、出力トークン数は1,150から190に減少しました。 | デモのメインエージェント | $0.1/100万〜 |
| DeepSeek V4.1 Flash 同じ127入力トークンで、一文のチェックを三件実行した際の所要時間の中央値は、順次送信した場合は3.7 s、まとめて送信した場合は1.8 sでした。 | デモのサブエージェント | $0.3/100万〜 |
目次
エージェントが遅い原因は、たいてい 3 つのどれかです。並列に実行できるモデル呼び出しが互いの完了を待っている、呼び出しの間に動く自前のコードが遅い、あるいは 1 回のモデル呼び出しがその処理に必要な量を超えて仕事をしている。トレースを見れば、数秒で切り分けられます。すべての呼び出しが時間軸上に並び、その間の空白も見えるからです。この記事では、小さなサポート用エージェントで各問題を再現して修正し、修正前後の実行を Synthorai コンソールで並べて比較します。
TL;DR
- 独立した 3 回のモデル呼び出しを
asyncio.gatherで同時に実行すると、コストを変えずに所要時間の中央値が 3.7 s から 1.8 s に短縮しました。 - それぞれ 1.1 s かかるデータベース検索を模した 4 つの処理を同時に実行すると、エージェント自身のコードにかかる時間が 4.6 s から 1.3 s に短縮しました。モデルを変えても、この部分は改善しません。
- GPT-6 Luna で 1 文の回答を 5 件生成する際、推論を無効にする(
reasoning_effort="none")と、所要時間が 25.6 s から 10.2 s に、出力 token 数が 1,150 から 190 に減りました。
この記事は、モデル呼び出しをトレースにまとめる 3 つのリクエストヘッダーを解説した LLM エージェントのトレース の続きです。その手順でデモを準備し(Python 3.10 以降、virtualenv を有効化)、github.com/synthorai-io/use-cases の同じディレクトリから 3 つのケースを実行してください。
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
各ケースは修正前、修正後の順に 2 回実行されます。実行ごとに、トレース ID を含む 1 行が出力されます。
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
モデルのレイテンシは呼び出しごとに変わるため、2026 年 10 月 11 日に各ケースを 5 回ずつ実行しました。表には中央値を示し、括弧内に最短と最長の値を記載しています。3 番目のケースでは修正後の実行が 1 回失敗したため、中央値は 4 回分です。上の出力例とスクリーンショットの比較ペアは、各ケースをさらに 1 回実行したもので、集計した 5 回には含まれません。時間はスクリプトが計測した実経過時間、つまり開始から終了までの時間です。
| ケース | トレースで見える状態 | 修正方法 | 修正前 | 修正後 |
|---|---|---|---|---|
serial-checks | バーが階段状に並び、重ならない | 独立した呼び出しを同時に実行する | 3.7 s(3.5 から 4.5) | 1.8 s(1.7 から 2.0) |
slow-tool | your app の行が長い | 自前のコードを修正する | 11.0 s(9.5 から 12.2) | 9.2 s(6.7 から 11.0) |
reasoning | 出力数が実際の回答よりはるかに多い | 推論の強度を下げる | 5 件の回答で 25.6 s(19.0 から 31.8) | 10.2 s(7.9 から 12.1) |
エージェントの実行が遅いとき、どこから調べるか?
まず、トレース上部のサマリーを見ます。実経過時間が、ゲートウェイ内の時間とアプリ内の時間に分けて表示されています。実経過時間は、ユーザーが待った時間です。「In the gateway」は、少なくとも 1 件のモデルリクエストが処理中だった時間です。「In your app」はそれ以外、つまりリクエストの間に自分のコードだけが動いていた時間です。コードとゲートウェイ間の通信時間もここに含まれます。このページの実行では、呼び出しごとに数十分の 1 秒かかっています。
この内訳で、次に調べる場所が決まります。
- 大半がゲートウェイ内で、バーが階段状に並ぶ:呼び出しが互いの完了を待っています。最初のケースを参照してください。
- アプリ内の時間が大きな割合を占める:問題はモデルではありません。2 番目のケースを参照してください。
- 大半がゲートウェイ内で、1 本のバーが長い:1 回の呼び出しが全体の時間を占めています。サマリーでは「slowest」として名前が表示されます。3 番目のケースを参照してください。
変更の効果を見るには、修正前のトレースを開き、Compare を選んで修正後のトレースを指定します。コンソールに両方の実行が同じページで表示されます。各指標には A、B、差分が並び、同じ名前の呼び出しが対になり、2 つのウォーターフォールが同じ時間軸に表示されます。このページの画像はすべて、この比較画面です。
並列に実行できる呼び出しが直列になっていると、どう見えるか?
ウォーターフォールが階段状になります。各バーは、直前のバーが終わったところから始まります。デモのエージェントは、顧客メッセージに対して感情、ポリシー、リスクの 3 つを DeepSeek V4.1 Flash で確認し、それぞれ 1 文で回答させます。どの確認も他の結果を必要としませんが、修正前はループ内で順番に await しています。
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
修正は 1 行です。
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))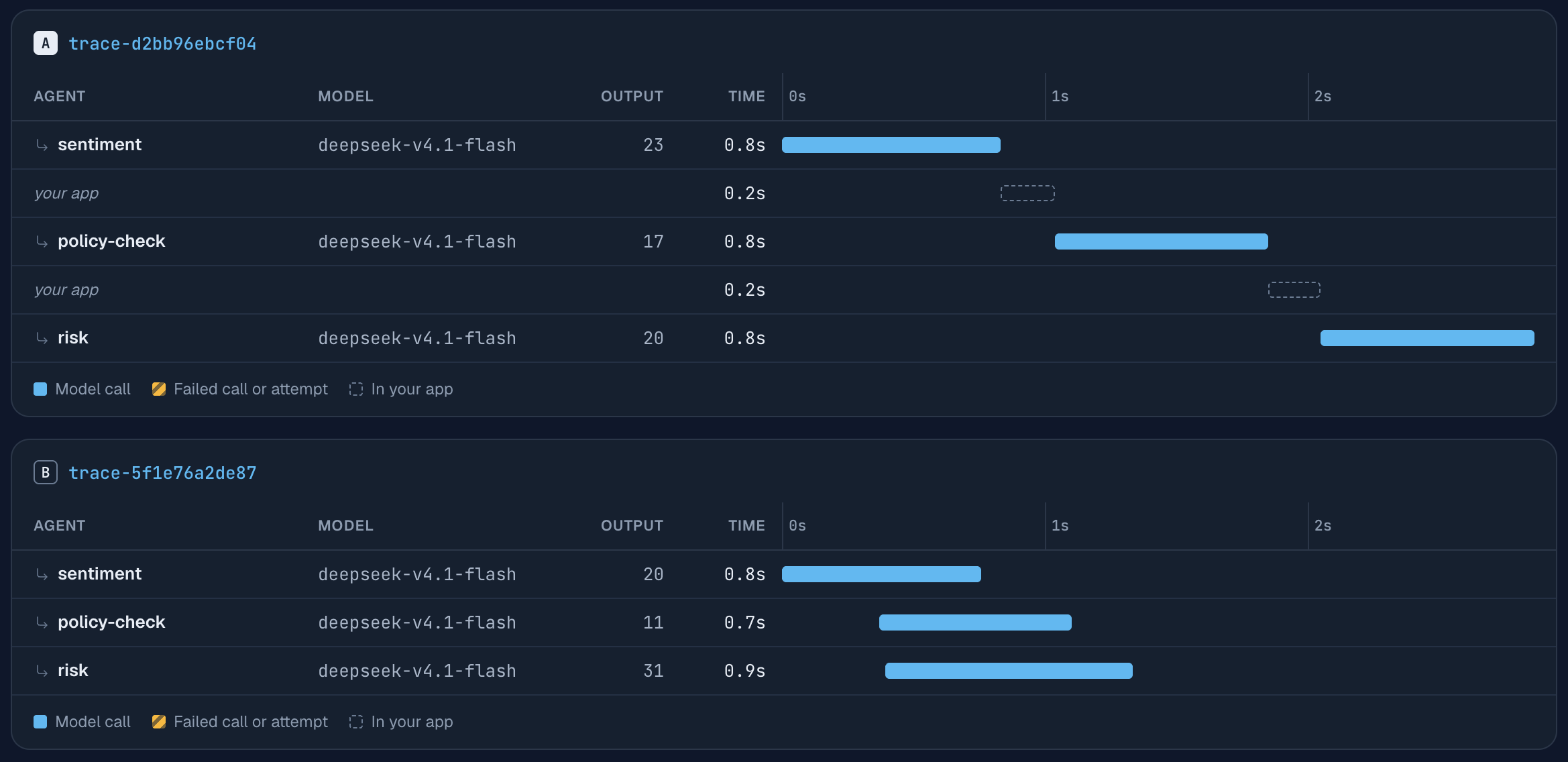
トレース A の実経過時間は 2.9 s です。各 0.8 s の呼び出しが 3 回、順番に実行され、その間に 0.2 s の空白があります。トレース B ではバーが重なり、実経過時間は 1.3 s です。同じコンソールページの、画像に写っている部分より上にある比較表では、実経過時間が 2.9 s から 1.3 s になり、53.4% 減ったと表示されます。割合は丸める前の時間から計算しています。同じペアをスクリプトで測ると 3.5 s と 1.5 s でした。スクリプトには接続の開始と各呼び出しの通信時間も含まれるためです。
入力は両方とも同じ 127 token です。コストは出力に応じて変わり、出力の長さは実行ごとに少し変動します。このペアのコストは $0.000110 と $0.000112 でした。5 回の中央値は、直列版が $0.000105、並列版が $0.000109 です。並列化しても送受信する token は同じなので、それ自体でコストが増えることはありません。
自分のエージェントでは、隣り合うバーの各ペアについて、後の呼び出しが前の呼び出しの出力を使っているか確認してください。使っていなければ、並列に実行できます。計画を立ててから、その計画に沿った処理を行うような依存関係のある呼び出しは、順番に実行する必要があります。
自前のコードが遅いと、どう判断できるか?
your app の行が長くなります。このケースの修正前のコードは、4 つのテーブルから顧客情報を検索してから質問に回答します。クエリは 1 件ずつ実行します。各クエリでは、データベース呼び出しの代わりに 1.1 s の sleep を使っています。
rows = [await lookup(t) for t in tables] # four queries, one at a time4 件のクエリを同時に実行する修正も、1 行です。
rows = await asyncio.gather(*(lookup(t) for t in tables))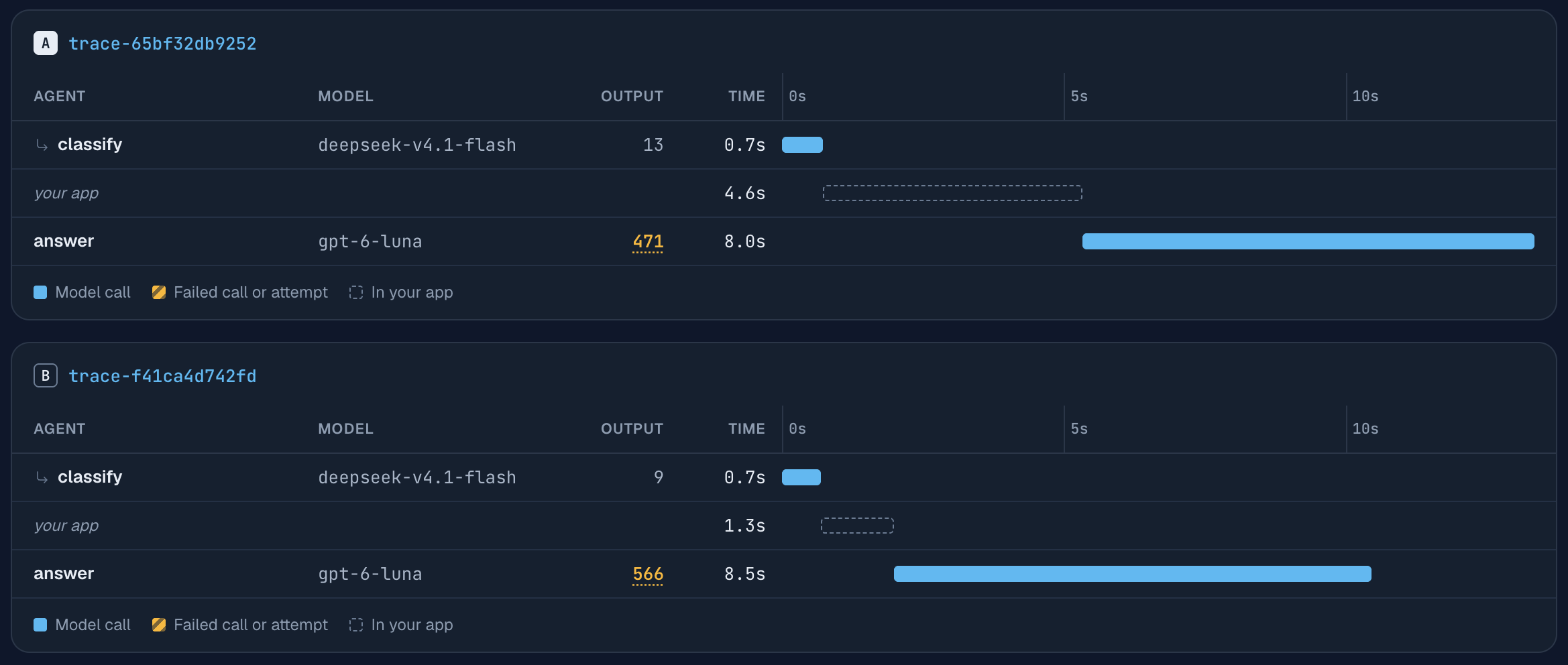
修正した行の時間は 4.6 s から 1.3 s になり、比較表では「In your app」が 71.8% 減っています。これも丸める前の時間から計算した値です。モデルや prompt を変えても、この部分は改善しません。モデルリクエストは処理中ではなく、エージェントが自身の検索処理を待っていたからです。
合計時間では、効果がそのまま表れるわけではありません。このペアの実経過時間は 13.3 s から 10.5 s になりました。修正した部分では 3.3 s 短縮していますが、全体の短縮は 2.8 s です。差の 0.5 秒は、GPT-6 Luna の answer 呼び出しによるものです。最初の実行では出力が 471 token で 8.0 s、次の実行では 566 token で 8.5 s かかりました。表にまとめた 5 回では、修正前後の時間の範囲が重なっています。修正後は 6.7 から 11.0 s、修正前は 9.5 から 12.2 s なので、1 回だけ比べると修正後のほうが遅いこともあります。
そのため、1 回の合計時間ではなく、変更した行を比較します。比較画面の呼び出し別の表なら、対応する呼び出しが並び、時間、出力、コストを A と B で確認できます。エンドツーエンドで速くなったと言うには、各バージョンの多数のトレースで所要時間を比較してください。Logs の p95 レイテンシ、つまり 95% のリクエストが完了するまでの時間には、この修正の効果は表れません。これは個々のリクエストを測る指標であり、今回短縮したのはリクエスト間の時間だからです。
ゲートウェイに見えるのは空白の長さだけで、その間にコードが何をしていたかはわかりません。空白が長く、理由がわからない場合は、OpenTelemetry で自前の関数に span を追加する箇所です。
1 回のモデル呼び出しが遅い場合は?
その呼び出しの出力 token 数を確認します。時間がかかるのは出力の生成だからです。推論モデルは回答する前に推論します。見える回答が 1 文でも、推論は出力 token として課金され、生成時間にも含まれます。このケースの修正前のコードでは、GPT-6 Luna にポリシーに関する短い質問を 5 件送り、「1 文で回答する」と指示し、推論の強度はデフォルトのままにしています。修正後はパラメーターを 1 つ追加します。
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")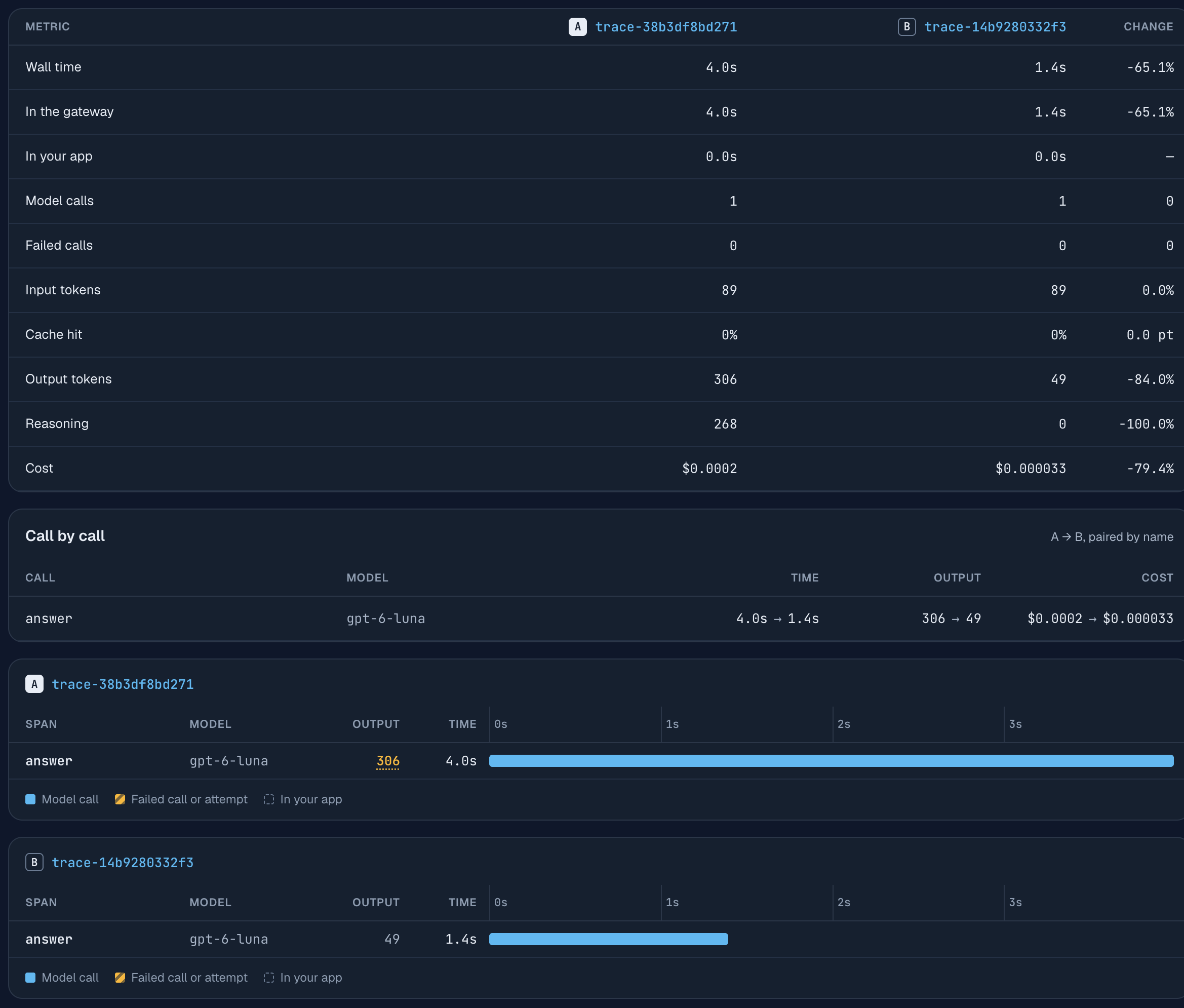
これは 5 件の質問のうち、最初の質問の修正前後です。どちらも回答は 1 文です。デフォルトの推論強度では、モデルは回答を生成するために 306 token を出力しました。そのうち 268 token が推論で、所要時間は 4.0 s でした。推論を無効にすると、出力は 49 token、所要時間は 1.4 s になりました。呼び出しのコストは $0.00016 から $0.000033 に下がりました。コンソールでは $0.00016 を丸めて $0.0002 と表示しています。
| 1 文の回答 5 件(5 回の中央値、2 行目は 4 回) | 時間 | 出力 token 数 | コスト |
|---|---|---|---|
| デフォルトの推論強度 | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
この状態は、比較画面を開かなくても見つけられます。ウォーターフォールには Output 列があり、出力が多く、その大半が推論だった呼び出しには、上の 306 のように数値に下線が付きます。呼び出しを選ぶと、パネル内の出力 token 数の下に、推論 token 数が別の行で表示されます。
検索、分類、ツールの結果の言い換えといった処理では、推論を無効にするのが適切です。複数段階の推論が必要な処理には適しません。このデモでは、そのような処理は検証していません。GPT-6 Luna の計測結果 には、設定ごとの推論 token 数と回答あたりのコストを掲載しています。推論強度の設定ガイド には、各モデルが受け付ける値をまとめています。処理ごとに設定を変え、変更前後の回答を確認してください。
このページで扱っていないことは?
2 つあります。1 つ目は、回答がどれだけ速く感じられるかです。streaming は呼び出し自体を短くしませんが、ユーザーは早くテキストを見られます。チャットの回答では、こちらが重要なことも多いでしょう。呼び出しのパネルには、そのための First token 欄があります。このデモは streaming を使わないため、今回のトレースでは空欄です。
2 つ目は、エージェントの外にある原因です。その時間帯にプロバイダーが遅い場合や、レート制限によってクライアントが待機してリトライする場合などです。これらは 1 本の長いバー、または失敗した呼び出しとそれに続くリトライとして現れます。コードの構造を変えても解決しません。
FAQ
LLM エージェントで最も遅い処理を見つけるには?
実行のトレースを開き、サマリーを確認します。最も遅い呼び出しの名前と、ゲートウェイ内、アプリ内に分けた実経過時間が表示されます。その下のウォーターフォールには各呼び出しがバーで表示されるので、最も長いバーか、最も長い your app の行を調べます。
LLM 呼び出しを並列にすると、直列よりコストが増える?
増えません。デモの 3 つの確認処理では、コストの中央値が直列で $0.000105、並列で $0.000109 でした。入力はどちらも同じ 127 token で、差は実行ごとの出力の長さによるものです。コストは token 数で決まり、並列化しても送受信する token は同じです。並列実行では呼び出しが一度に到着するため、注意すべきなのはレート制限です。
回答が短いのに、モデル呼び出しが遅いのはなぜ?
よくある原因は、モデルが先に推論していることです。推論は、回答には見えない出力 token として生成されます。GPT-6 Luna で 1 文の回答を 5 件生成したとき、出力 token 数の中央値はデフォルトの推論強度で 1,150、reasoning_effort="none" では 190 でした。
修正でエージェントが速くなったか、どう測る?
1 回の合計時間ではなく、変更した部分を比較します。デモでは、4 件の検索を同時に実行することで、自前のコードにかかる時間が 4.6 s から 1.3 s に短縮しました。一方、修正後の各実行の実経過時間は 6.7 s から 11.0 s まで変動しました。1 回のモデル呼び出しの時間にばらつきがあったためです。各バージョンを何度も実行し、トレースの所要時間で比較してください。
2 回のモデル呼び出しの間にコードが何をしたか、ゲートウェイで確認できる?
空白の長さは your app の行で確認できますが、その間の処理内容はわかりません。自前のコード内に span を追加するには OpenTelemetry SDK を使い、traceparent ヘッダーを引き継いで、両方の画面で同じトレース ID を共有できるようにしてください。
関連記事
- LLM エージェントのトレース:このページで使うヘッダーとウォーターフォール。
- LLM エージェントのコストが高い理由:同じ方法で料金を調べる。
- LLM エージェントのデバッグ:ユーザーの不具合報告から、問題のある呼び出しを特定する。
- サブエージェント別に見る Claude Code のコスト:自分で実装していないコーディングエージェントにも、同じ画面を使う。
- LLM ログについて Claude に質問する:MCP を通じてリクエストログへの質問に答える。
- エージェントにログ用ツールを渡す:自前のプログラムで同じログを読み、モデルの token コストを確認する。
- GPT-6 Luna と GPT-5.6 Luna の比較:推論強度ごとの推論 token 数と回答あたりのコスト。