
LLM エージェントの料金が高い理由:トレースで見る 4 つの原因
エージェントの料金が高くなる4つの原因を、それぞれ再現して修正します。キャッシュを無効にするタイムスタンプを修正すると、キャッシュヒット率は0%から73%に改善。増え続けるコンテキスト、繰り返されるリトライループ、誤ったモデル選択についても、料金増加の原因として検証します。
推奨モデル
リアルタイム価格| モデル | 評価 | 価格 |
|---|---|---|
| GPT-6 Luna タイムスタンプをプロンプトの先頭行から移動すると、コールドスタート時でも4ターンにわたる入力トークン5,729のうち4,157がキャッシュから読み込まれた。タイムスタンプが先頭にある場合、5,579のうちキャッシュから読み込まれたものはなかった。 | デモのメインエージェント | $0.1/100万〜 |
| DeepSeek V4.1 Flash 1文ずつのチェックを3回実行したコストは、GPT-6.1 Solでは$0.0010、このモデルでは$0.0001だった。 | デモのサブエージェント | $0.3/100万〜 |
目次
エージェントの料金が増える原因には、リクエスト単体では見えないものがあります。キャッシュに一度もヒットしないプロンプト、ターンごとに再送量が増える会話、同じ処理を繰り返すループ、安いモデルで済む仕事への高価なモデルの使用です。呼び出しをセッションとトレースにまとめると、どれもはっきり見えてきます。この記事では、小さなサポートエージェントで 4 つの問題を再現し、Synthorai コンソールの確認箇所、修正方法、修正前後のコストを示します。
TL;DR
- プロンプトの先頭行にタイムスタンプを置くと、キャッシュヒット率は 0% のままでした。末尾に移すと 73% になり、GPT-6 Luna の入力コストが 66% 減りました。
- ツールの結果を毎回すべて再送する履歴では、入力トークン数が 3 倍になりました。ただし 71% がキャッシュから読み込まれたため、入力コストの増加は 21% でした。
- リトライループによって、2 回で済むモデル呼び出しが 10 回になりました。ステータスはすべて 200 でした。
- GPT-6.1 Sol を使ったサブエージェントの 3 回の呼び出しが、あるセッションのコストの 81% を占めました。
この記事は、呼び出しをセッションとトレースにまとめるリクエストヘッダーを説明した LLM エージェントのトレース の続編です。その手順に従ってデモを準備し(Python 3.10 以降、virtualenv を有効化)、github.com/synthorai-io/use-cases の同じディレクトリから 4 つのケースと、別の原因でキャッシュが効かなくなる replay-mismatch を実行します。
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
各ケースは問題のある版、修正版の順に 2 回実行され、呼び出しに case と variant のラベルが付きます。掲載した数値は、2026 年 10 月 11 日に各ケースを 1 回ずつ実行した結果です。小さなデモなので、金額は 1 セント未満です。実際のワークロードでも参考になるのは、その比率です。
| ケース | 確認箇所 | 修正前 | 修正後 |
|---|---|---|---|
cache-miss | セッションページのターンごとのキャッシュヒット率 | キャッシュ利用率 0%、$0.0015 | コールドスタート(キャッシュが空の状態)からキャッシュ利用率 73%、$0.0011 |
context-growth | セッションページでターンごとに増える入力 | 入力 24,546 トークン、入力コスト $0.0011 | 入力 8,053 トークン、入力コスト $0.0009 |
replay-mismatch | セッションページで 0% のままのキャッシュヒット率 | キャッシュ利用率 0%、$0.0038 | キャッシュ利用率 76%、$0.0015 |
retry-loop | 1 ターンに必要な数を大きく超える呼び出しがあるトレース | 10 回、$0.0004 | 2 回、$0.0001 |
wrong-model | セッションページの Agents テーブル | $0.0012 | $0.0003 |
料金が想定より高いとき、どこから調べるか
まず Traces 一覧をコスト順に並べます。各行はセッションまたはトレースで、呼び出し回数、所要時間、コストが表示されるため、最もコストの高い会話が上に来ます。開いてみると、以下のどのパターンに当てはまるかを確認できます。
X-Synthorai-Metadata でリクエストにラベルを付けているなら、先に一覧を絞り込みます。Traces 一覧の検索欄ではラベルを指定できます。metadata.feature = support-agent なら特定機能のセッションとトレースだけが残り、metadata.case = cache-miss ならこの記事のケースの修正前後を検索できます。集計値を見るには、Analytics の Breakdown タブにある Cost by metadata カードを使います。キーを選ぶと、値ごとのリクエスト数、入力トークン数、コストが表示されます。
キャッシュヒット率がゼロになる理由
プロンプトの先頭付近がリクエストごとに変わると、キャッシュヒット率はゼロになります。プロンプトキャッシュでは、繰り返し送るプロンプトの先頭部分を通常の入力料金より安く処理できます。ただし、対象になるのは前のリクエストと異なる最初のトークンまでです。このケースの問題のある版では、約 1,300 トークンのシステムプロンプトの先頭行に現在時刻を置いています。
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
GPT-6 Luna で 4 ターンの会話を実行すると、セッションページの Cache hit は 0% で、入力 5,579 トークンのうちキャッシュから読んだのは 0 トークンでした。修正版では、変わる部分を末尾に移します。
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"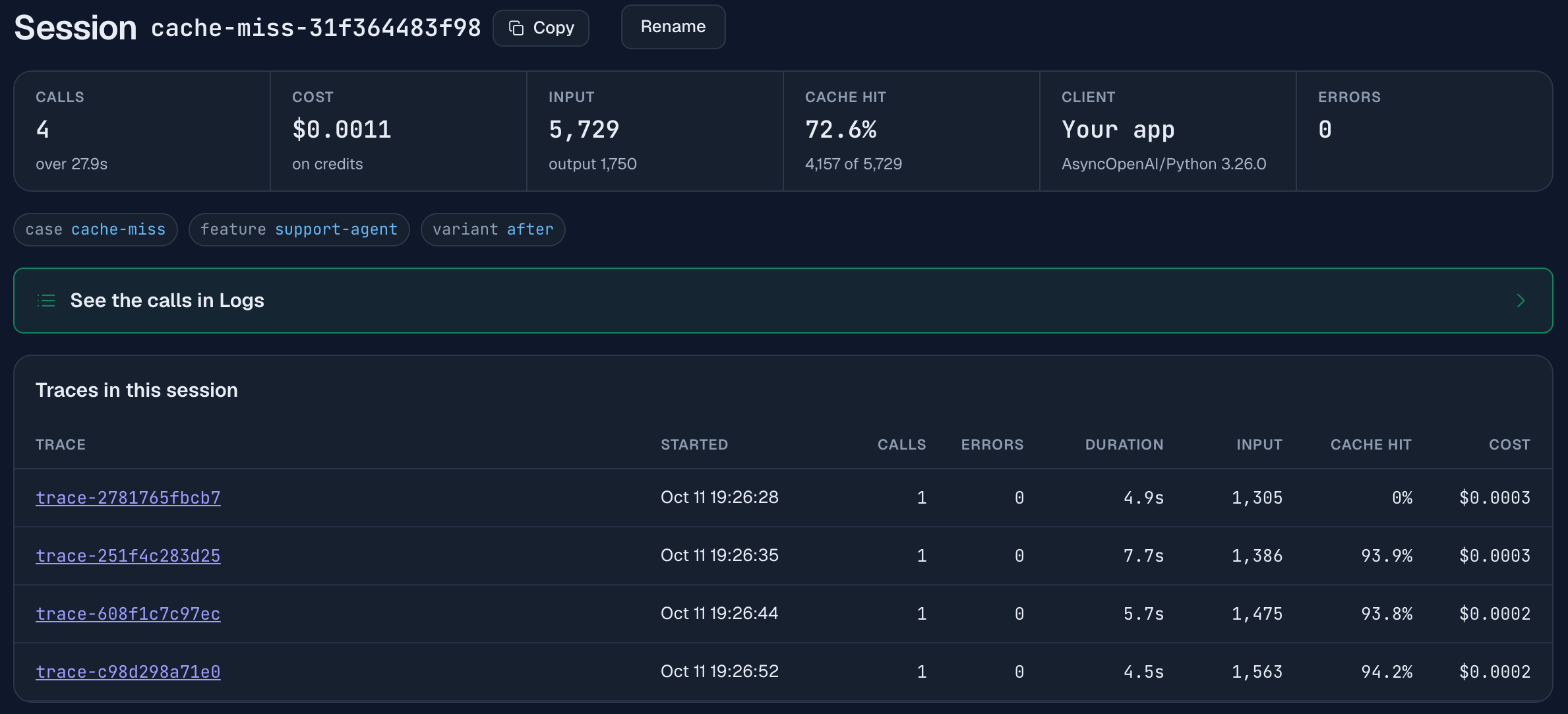
セッションページには、各ターンの入力とキャッシュヒット率が並び、最初の行は 0% です。まだどのリクエストも書き込んでいないエントリは読めないため、最初のターンはキャッシュに書き込むだけで、読み込みはありません。続く 3 ターンでは、それぞれ 1,302、1,383、1,472 トークンをキャッシュから読み込みます。これは直前のターンが送ったほぼすべてに相当し、各ターンの入力の約 94% です。会話全体では入力 5,729 トークン中 4,157 トークン、73% になります。
削減されるのは入力コストです。このモデルの料金は 100 万トークンあたり、通常の入力が $0.10、キャッシュ書き込みが $0.125、キャッシュ読み込みが $0.01 です。長いプロンプトのほぼ全体が、書き込みか読み込みのどちらかになります。
問題のある実行では 5,567 トークンをキャッシュに書き込み、読み込みはありませんでした。修正版では書き込みが 1,560 トークン、読み込みが 4,157 トークンになり、入力コストは $0.00070 から $0.00024 へ、66% 減りました。セッション全体のコストは $0.0015 から $0.0011 になりました。入力だけほど下がらなかったのは、この実行では出力が料金の大部分を占め、修正版の出力がたまたま多かったためです(1,599 トークンに対して 1,750 トークン)。
削減量は、会話開始時にキャッシュに何が残っているかで変わります。この実行はコールドスタートだったため、最初のターンでは何も読み込めませんでした。継続的にリクエストを受けるエージェントなら、73% より高い値を期待できます。すべての会話が同じシステムプロンプトで始まり、有効期限が切れる前にリクエストが来続ければ、前の会話が作ったエントリが残っているためです。1 つの会話でしか送られないプロンプトは、最初のターンで書き込み料金がかかります。
タイムスタンプは典型的な原因です。リクエスト ID、ランダムな挨拶、最初の段落に埋め込んだユーザー名、順序が変わるツール定義でも同じことが起きます。ヒットには、さらに 2 つの条件があります。変化しないプレフィックス(プロンプトの先頭部分)がプロバイダーの最小長を超えること(多くは 1,024 トークン。プロンプトキャッシュ を参照)、そして同じ会話の呼び出しに同じ X-Session-Id を付けることです。ゲートウェイはこの ID を使い、会話内のキャッシュヒットを安定させます。
ターンごとに送信量が増える理由
会話履歴を毎回再送するため、ターンごとに送信量が増えます。履歴が長くなる以上、ある程度の増加は正常です。このケースの問題のある版では、増加がずっと速くなります。毎ターン顧客情報を検索し、約 1,100 トークンの注文履歴を JSON で受け取り、その結果を履歴に残します。そのため 6 ターン目には、ほぼ同じデータが 6 個入ります。
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]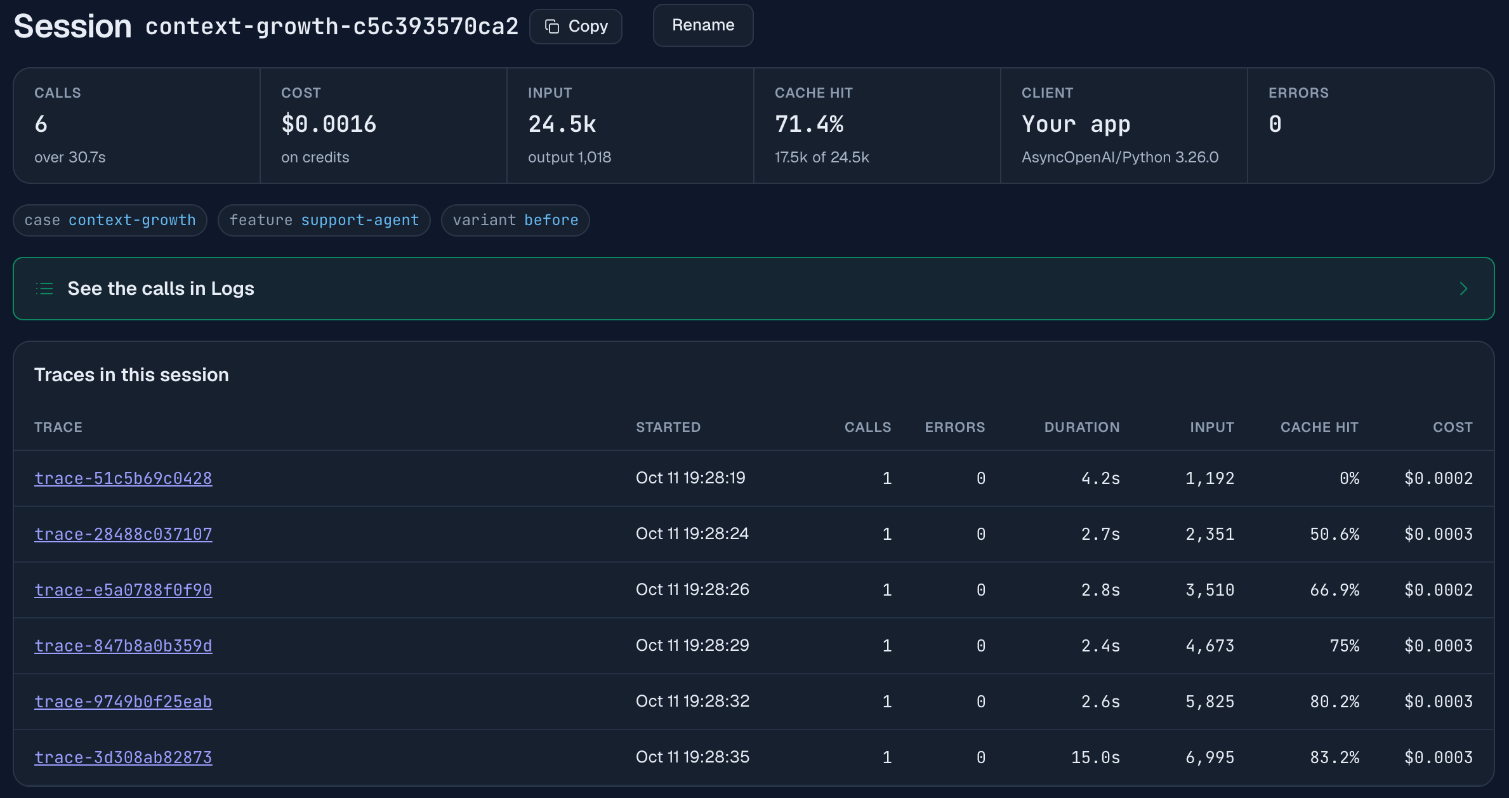
手がかりは「Traces in this session」テーブルの Input 列です。返信はずっと 2 文なのに、入力はターンごとに約 1,160 トークン増え、最初の 1,192 から 6 ターン目の 6,995 になります。6 ターンで入力は 24,546 トークンでした。修正版でも現在のターンには最新の検索結果を渡しますが、過去の検索結果は残しません。必要な情報はすでにアシスタントの返信に記録されているためです。これで 6 ターンの入力は 8,053 トークン、3 分の 1 になります。
この問題が見えにくい理由は、Input の隣の 2 列にあります。入力とともに Cache hit が上がり、ターンあたりのコストは $0.0002 から $0.0003 のままです。各ターンの先頭には前のターンのプロンプト全体があるため、プロバイダーはその部分をキャッシュから読み込みます。入力 24,546 トークン中 17,536 トークン、71% です。問題のあるセッションの入力コストは $0.0011、修正版は $0.0009 でした。入力トークン数は 3 倍でも、入力コストの増加は 21% です。
この 2 回のセッションでは、合計コストだけを見ると修正の効果がまったく見えません。問題のあるセッションは $0.0016、修正版は $0.0017 でした。修正版の出力がたまたま多かったためです(1,018 トークンに対して 1,756 トークン)。出力増加で約 $0.0004 が加算され、入力で節約した $0.0002 を上回りました。比較すべきなのは、修正で変わる Input 列と Cache hit 列であり、1 回のセッションの合計ではありません。
プロンプトキャッシュは、増え続ける履歴の料金の大部分を抑えられます。ただし、次の 3 つはできません。
- コンテキストは小さくなりません。6 ターン目でも 6,995 トークンを送ります。長いセッションは同じようにモデルのコンテキスト上限に達しますし、キャッシュされたトークンにもキャッシュ料金がかかります。
- 履歴を送信時と完全に同じ形で再送する場合にしか機能しません。デモの
replay-mismatchはこのケースです。送信時には各ユーザーメッセージに指示を追加するのに、保存時にはその指示を除いています。すると毎ターン、前のターンでは送っていないプロンプトを再構築することになります。この会話では入力 24,557 トークン中、キャッシュ読み込みは 0 トークンで、コストは $0.0038 でした。送信した形のまま保存すると、24,702 トークン中 18,844 トークン、76% がキャッシュから読み込まれ、コストは $0.0015 になりました。 - すべてのモデルで使えるわけではありません。このケースで使った GPT-6 Luna の通常の入力料金では、24,546 トークンは $0.0025 です。キャッシュを使った実際の請求は約 $0.0011 でした。キャッシュを前提にする前に、Cache hit 列を確認してください。
自分のエージェントでは、まずツールの結果を見直してください。通常、履歴の中で最も大きく、再送する価値が最も低いのがツールの結果です。それを使って生成した返信か 1 行の要約を残し、生のペイロードは削除します。これならキャッシュの有無にかかわらず、どのモデルでも節約できます。チャットボットのガイド では、過去のターンを要約に圧縮する一般的な方法を説明しています。
リトライループはどう見えるか
1 ターンに必要な数を大きく超える呼び出しが 1 つのトレースに並び、同じ span 名が繰り返されます。このケースでは配送業者の追跡 API が停止しています。エージェントはツールを呼び出してタイムアウトを受け取り、荷物の状況を確認できないと返信します。その後、コードが返信に荷物の所在が含まれているかを確認し、含まれていないためターン全体を最大 5 回実行し直します。
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused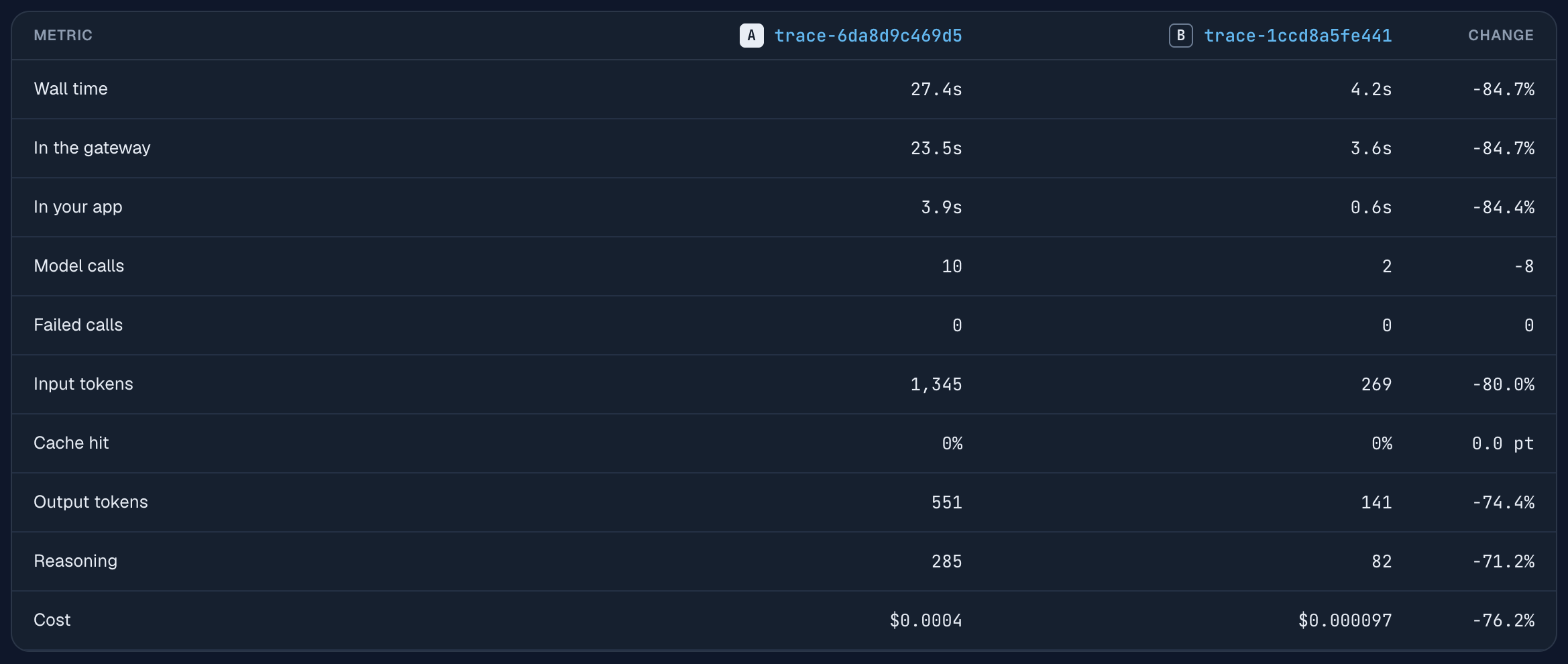
これは 2 回の実行を並べた Compare ビューです。一方のトレースを開き、Compare を選び、もう一方を指定します。問題のある実行では、27.4 秒間にモデルを 10 回呼び出して $0.0004 かかりましたが、顧客への最終回答は変わりませんでした。「Failed calls」は両方とも 0 です。ループ内の呼び出しはすべてステータス 200 で成功しているため、エラーとしては何も表示されません。修正版ではツールの失敗と不適切な返信を区別し、ツールに問題がある場合はリトライしません。結果は 2 回、4.2 秒、$0.0001 でした。
問題のある実行のウォーターフォールには、plan-1、answer-1、plan-2、answer-2 といった名前の呼び出しが並びます。このようにステップ名と試行回数で span に名前を付ければ、ループがひと目でわかります。まだ気づいていないループを探すには、Traces 一覧を呼び出し回数順に並べます。
安いモデルで済む仕事に高価なモデルを使っていないか
「Agents in this session」テーブルを確認します。ここには、セッションの呼び出し回数とコストがエージェント別に表示されます。このケースの問題のある版では、サブエージェントの 1 文ずつのチェック 3 回を GPT-6.1 Sol で実行します。料金は 100 万トークンあたり入力 $2、出力 $10 です。一方、メインエージェントの回答には GPT-6 Luna を使います。
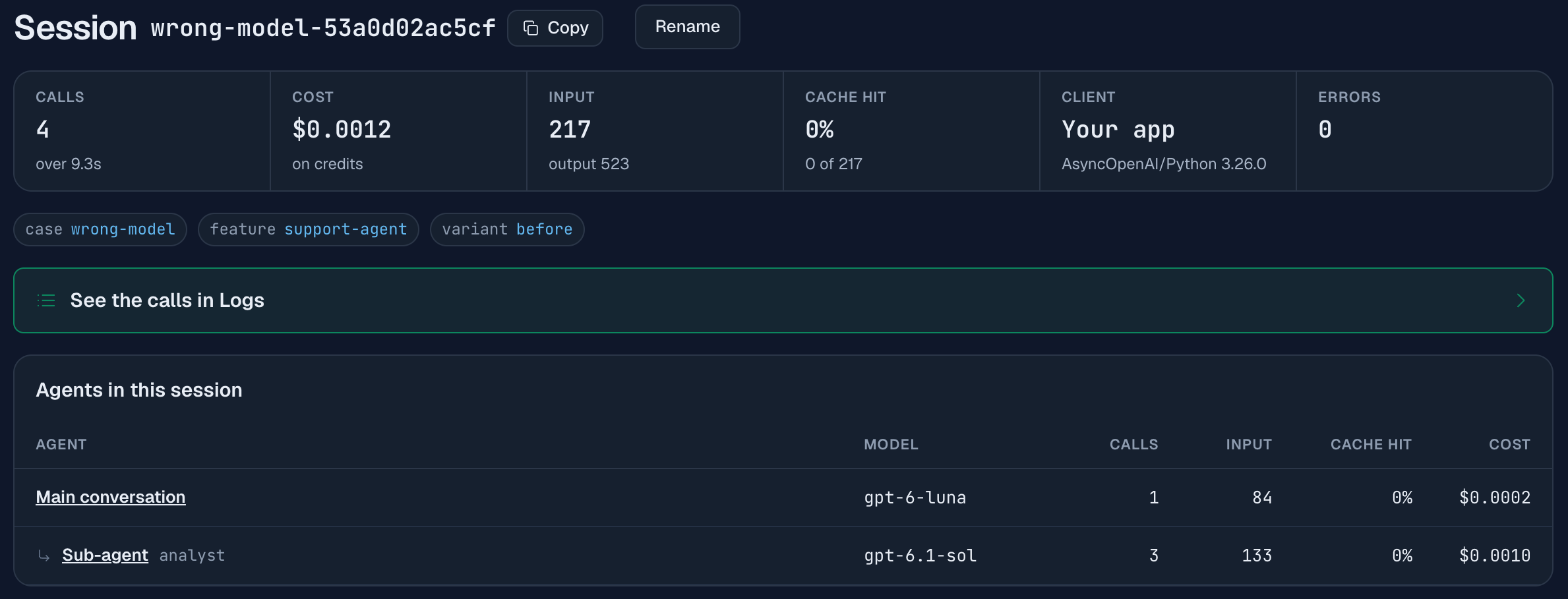
サブエージェントの 3 回の呼び出しは、セッション全体の $0.0012 のうち $0.0010、81% を占めました。この実行で最も簡単な仕事に、料金の大半を使っています。同じ 3 回のチェックを DeepSeek V4.1 Flash で実行すると $0.0001、セッション全体では $0.0003 でした。どちらも reasoning を無効にしてチェックするため、差はモデルの料金によるものです。
このケースで測定しているのはコストだけです。チェックの品質は採点していません。安いモデルが適切なのは、そのステップに十分な回答品質を満たす場合だけです。テーブルで費用の内訳を確認すれば、どのステップで安いモデルを試す価値があるかがわかります。
この内訳は、サブエージェントの呼び出しに X-Agent-Id を付けると表示されます。付けていない場合は「Models in this session」テーブルでモデル別の内訳を確認できます。ただし、エージェント別の内訳と一致するのは、各エージェントが別々のモデルを使う場合だけです。すべてのセッションを通して特定のエージェントを調べるには、Analytics の Breakdown タブにある Cost by agent カードを使います。
よくある質問
LLM エージェントのどの部分に最もコストがかかっているか調べるには?
リクエストヘッダーで呼び出しをセッションとトレースにまとめ、Traces 一覧をコスト順に並べて先頭の項目を開きます。セッションページではエージェント別、モデル別、ターン別にコストが分かれるので、キャッシュ、コンテキスト、モデル選択のどこに問題があるかを判別できます。
プロンプトキャッシュのヒット率が 0% になるのはなぜ?
最もよくある原因は、タイムスタンプなど、プロンプトの先頭付近で変わる値です。キャッシュが使われるのは、最初に異なるトークンまでです。デモでは、システムプロンプトの先頭行にあったタイムスタンプをユーザーメッセージの末尾に移すと、コールドスタートでのキャッシュヒット率が 0% から 73% になりました。
会話の最初のターンがキャッシュにヒットしないのはなぜ?
キャッシュエントリを書き込むのはリクエストであり、最初のターンがそのリクエストだからです。デモの 4 ターンでは、入力の 0%、93.9%、93.8%、94.2% をキャッシュから読み込みました。最初のターンでキャッシュを読めるのは、過去の会話が同じプレフィックスを送信し、そのエントリがまだ残っている場合だけです。
プロンプトキャッシュを使えば長い会話履歴は無料になる?
無料にはなりませんが、コストの大部分が見えにくくなることはあります。デモでは、過去のツール結果をすべて再送する会話の入力トークン数は、履歴を削った版の 3 倍でした(8,053 に対して 24,546)。それでも入力コストの増加は 21% でした。入力の 71% がキャッシュから読み込まれたためです。トークンは依然としてコンテキストウィンドウを占有し、再送する履歴が送信時の内容と異なった瞬間に割引は失われます。デモの replay-mismatch では、メッセージを送信時と異なる形で保存したため、キャッシュ利用率が 0% になり、コストは 2 倍以上になりました。
プロンプトキャッシュでどれくらい節約できる?
モデルのキャッシュ入力料金と、請求額に占める入力の割合によります。GPT-6 Luna のデモでは、会話の入力の 73% をキャッシュから読むことで入力コストが 66% 減り、セッション全体のコストはキャッシュなしの $0.0015 に対して $0.0011 になりました。料金の大部分は出力トークンで、キャッシュはその部分には影響しません。
リトライループはエラーとして表示される?
必ずしもエラーにはなりません。デモでは、ループ内のすべての呼び出しがステータス 200 を返しました。2 回で済むはずの呼び出しが 1 つのトレースに 10 回並んでいたため、ループを見つけられました。エラー率だけでなく、トレースごとの呼び出し回数を確認してください。
関連記事
- LLM エージェントのトレース:この記事で使うヘッダー、セッション、ラベル。
- LLM エージェントが遅い理由:同じ手法でレイテンシを調べる。
- LLM エージェントのデバッグ:ユーザーからの問題報告をもとに、原因となった呼び出しを特定する。
- Claude Code のサブエージェント別コスト:同じセッションビューでコーディングエージェントを分析。キャッシュ書き込みが 1 回の実行の 77% を占めるケース。
- LLM のログを Claude に質問する:MCP を通じて、これらのセッションの中で最も高額なものを見つける。
- エージェントにログツールを持たせる:同じログを自作プログラムで読み取る方法と、モデルのトークンにかかるコスト。
- プロンプトキャッシュ:プロバイダー別の最小プレフィックス長と料金。
- 用途別のおすすめ LLM:各ステップのモデル選択に役立つ、ワークロードの特性別のコスト。