
LLM エージェントのデバッグ:トレースで見つける 3 つの障害、1 つはステータス 200
ラベルを手がかりに、特定ユーザーのエージェント実行を見つけ、その実行トレースに記録された3つの障害を確認します。404エラーとそのリトライ、ステータス200にもかかわらず途中で切れる応答、2ターン目に発生する400エラーをそれぞれ読み解きます。
推奨モデル
リアルタイム価格| モデル | 評価 | 価格 |
|---|---|---|
| GPT-6 Luna 保存された履歴からツール呼び出しが欠落していた場合、会話の第2ターンを0.5 sで400エラーとして拒否し、料金は発生しなかった。 | デモのメインエージェント | $0.1/100万〜 |
| DeepSeek V4.1 Flash max_tokensを40に設定すると、3回連続の呼び出しでステータス200とちょうど40の出力トークンが返されたが、使える応答はなかった。上限を引き上げて推論をオフにすると、1回の呼び出しで49トークンの回答が得られた。 | デモのサブエージェント | $0.3/100万〜 |
目次
エージェントの不具合報告は、たいてい「昨日の午後、アシスタントから役に立たない回答が返ってきた」という形で届きます。わかるのはユーザーとおおよその時刻だけで、リクエスト ID はありません。実行を探すにはリクエストに付けたラベルが、原因を調べるにはトレースが必要です。問題があるのは複数の呼び出しのうち 1 つだけということが多く、エラーに見えない場合もあるからです。この記事では、ユーザーの報告から問題の呼び出しを特定する手順を紹介します。その後、小さなサポートエージェントで 3 つの障害を再現し、Synthorai コンソールでそれぞれがどう見えるかを確認します。
TL;DR
- すべてのリクエストに
_userラベルを付ければ、Traces 一覧で 1 回検索するだけで、そのユーザーのエージェント実行を見つけられます。 - リトライ時に同じトレース ID を使うと、失敗した呼び出しとリトライが並んで表示されます。デモの 404 でかかった時間は 95 ms、料金は $0 でした。
- 推論モデルに
max_tokens=40を指定すると、3 回の呼び出しすべてがステータス 200、出力 40 トークンで返りましたが、回答は空でした。 - 保存した履歴からツール呼び出しが抜けると、2 ターン目が 400 で失敗しました。料金はかかりませんでした。
この記事は、ここで使うリクエストヘッダーを説明した LLM エージェントのトレースの続編です。そちらの手順でデモを準備してください。Python 3.10 以降を使い、virtualenv を有効にした状態で、github.com/synthorai-io/use-cases の同じディレクトリから次を実行します。
cd use-cases/agent-tracing
python run.py --fail                    # a failed call with a retry
python incidents.py cut-off bad-history
この記事の数値は、2026 年 10 月 11 日に各ケースを 1 回ずつ実行した結果です。
| トレース上の表示 | 意味 | ケース |
|---|---|---|
| ステータスコード付きの斜線マークの後に、似た呼び出しが続く | 呼び出しが失敗し、リトライされた | run.py --fail |
| 同じ span が何度も現れ、すべて 200、Output 列が設定した上限と一致する | 回答が使える形になる前に打ち切られている | cut-off |
| セッションの 2 ターン目で 400、0 トークン、$0 | コードが組み立てたリクエストが不正 | bad-history |
特定ユーザーの実行をどう探すか
リクエストに付けたラベルで探します。すべてのリクエストで X-Synthorai-Metadata に _user キーを含めていれば、フィルターを 1 つ指定するだけで、そのユーザーのリクエストを絞り込めます。
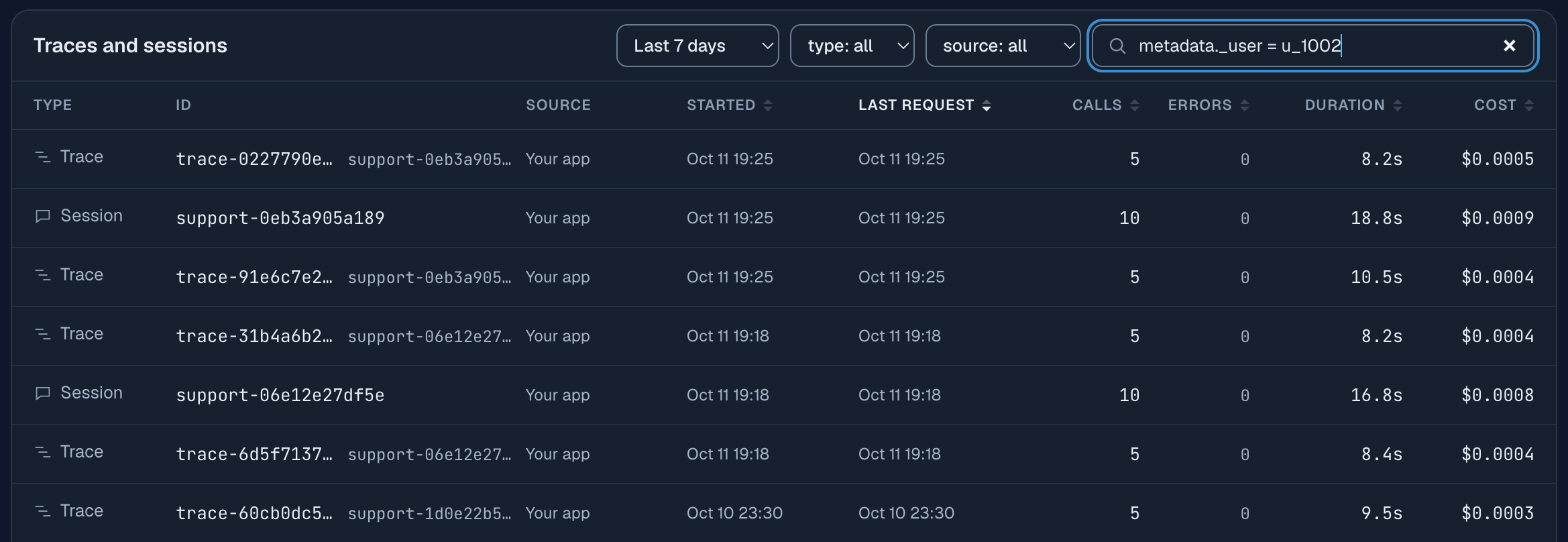
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}- Traces を開き、検索欄に
metadata._user = u_1002と入力して Enter を押します。報告のあった時刻が含まれるように期間を設定します。 - 一覧を確認します。そのユーザーのセッションとトレースだけが表示され、それぞれの呼び出し数、エラー数、所要時間、料金を確認できます。Calls、Errors、Duration、Cost の各列で並べ替えもできます。まずはエラーがあるトレースや、前後のトレースに比べて呼び出し数が極端に多いものから調べます。
- 該当するトレースを開きます。実行全体が表示されます。「Open session」では前後の会話を、「See the calls in Logs」では個々のリクエストを確認できます。
実行単位ではなく個々のリクエストを探す場合は、Logs のフィルター欄で同じラベルを使えます。ほかに status(error、success、4xx、5xx またはコード)、latency、cost、model、session、trace も指定できます。
ラベルがなくても、手元の情報から検索できます。自分たちのログにあるトレース ID は Traces の検索欄に、レスポンスヘッダーにあるリクエスト ID は Logs のフィルターに request_id として指定します。そのため、レスポンスヘッダーの x-request-id は、自分たちのユーザー ID や会話 ID と一緒にログへ記録しておきます。
_user にはメールアドレスや名前ではなく、内部のユーザー ID を使ってください。ラベルはリクエストとともに保存されます。
失敗した呼び出しとリトライはどう表示されるか
ステータスコード付きの斜線マークと、その代わりに実行された呼び出しが並びます。トレースの解説では、並列に行う 3 つのチェックのうち 1 つが、存在しないモデル ID を指定しています。トレースでは policy-check が 404 と記された 95 ms のマークになり、その隣に policy-check.retry が通常のバーとして表示されます。トレースの概要は「6 model calls, 1 failed」、セッションページのエラー一覧は「1 × 404 Not found」です。失敗した呼び出しの料金は $0 でした。
この表示を読みやすくするポイントは 2 つあり、どちらもコード側で決まります。まず、リトライでもトレース ID を引き継ぐことで、失敗とリトライが同じ画面に収まります。次に、リトライに別の span 名を付けることで、各試行を区別できます。リトライで新しいトレースを作ると、無関係な 2 つの実行に見えてしまい、片方が失敗した理由も画面からはわかりません。
トレースに失敗があっても、必ずしも対処が必要とは限りません。この実行はリトライで復旧し、ユーザーには回答が届きました。トレースを見れば、失敗によって何がかかったかがわかります。このケースでは 95 ms で、料金はかかっていません。リトライで十分か、原因を修正すべきかを判断するための情報です。
すべて成功したのに回答が空になるのはなぜか
ステータス 200 が示すのは、リクエストの処理が完了したことだけです。このケースでは、DeepSeek V4.1 Flash を使うサブエージェントに、メッセージがどのポリシー項目に関係するかを尋ねています。以前の単純な prompt で使っていた max_tokens=40 が、そのまま残っていました。デモのほかのサブエージェント呼び出しとは違い、不具合のある版では推論設定をモデルのデフォルトのままにしています。コード内では think に当たります。モデルは回答前に推論を行い、その推論で 40 トークンを使い切ります。そのため、finish_reason が length の空の回答が返ってきます。コードは空の回答を検知して再試行し、合計 3 回呼び出します。
for attempt in range(1, 4):
    resp = await check(run, f"policy-check-{attempt}", prompt, think=variant == "before", max_tokens=limit)
    choice = resp.choices[0]
    if choice.finish_reason != "length" and (choice.message.content or "").strip():
        break                                    # a usable reply; otherwise try again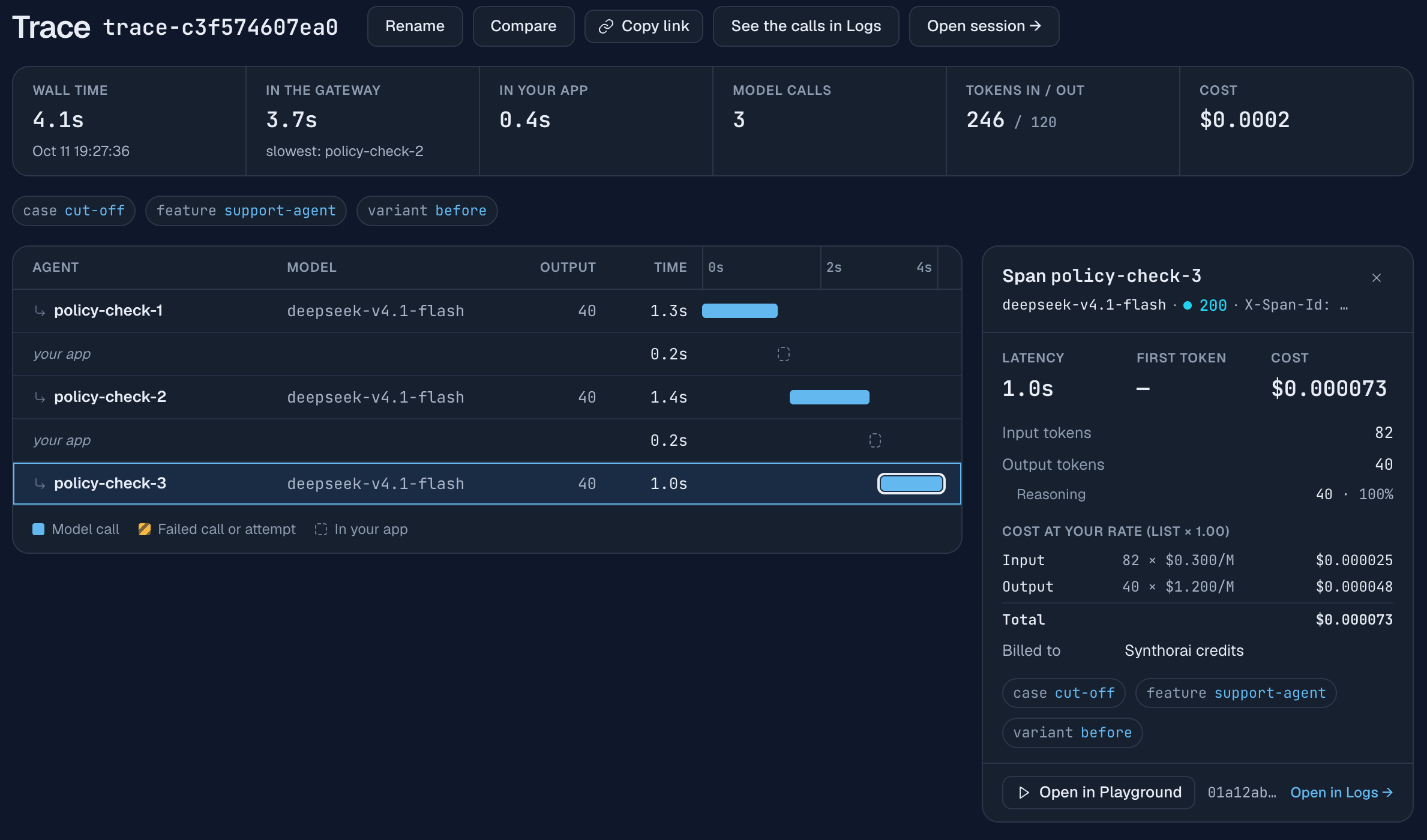
ウォーターフォール上に失敗のマークはありません。手がかりは、繰り返される span と Output 列です。40、40、40 と、すべて上限に一致しています。呼び出しを選択すると右側にパネルが開き、ステータス 200、出力 40 トークン、その下の行に「Reasoning 40 · 100%」と表示されます。
出力トークン数が設定した上限と一致していたら、回答が途中で打ち切られたと考えられます。修正版では上限を 2,000 に増やし、このチェックには不要な推論を無効にします。すると 1 回の呼び出しで 49 出力トークンの回答が返り、トレースのバーも 3 本から 1 本になります。上限を増やすだけでもリトライは止まりましたが、その 1 回で推論に 1,876 出力トークンを使い、22 秒かかりました。
自分たちのエージェントでは、次を確認してください。
- すべての呼び出しで
finish_reasonを確認する。lengthは回答が打ち切られたことを示します。ステータスが 200 でも、自分たちのログでは失敗として扱います。 - 推論と回答の両方を含めて
max_tokensを設定する。推論モデルでは、上限は両方に適用されます。画面に出る回答だけを想定した上限では、回答に使えるトークンが残らないことがあります。 - 打ち切られた回答を同じ上限でリトライしない。2 回目も同じ上限に達します。上限を増やすか、推論の強度を下げるか、その両方を行います。
1 ターン目は動いたのに 2 ターン目で失敗するのはなぜか
よくある原因は、ターン間でコードが保存した内容です。モデルへのリクエストには会話全体を含めるため、履歴の保存や再構築のバグは 2 ターン目以降に初めて現れます。このケースの 1 ターン目は、メモリ上のメッセージを使って処理されます。GPT-6 Luna がツールを呼び出し、結果を受け取って回答するところまでは正常です。その後、コードがターンを保存します。このとき assistant のメッセージをテキストだけで保存するため、ツール呼び出しが失われます。一方、ツールの結果はその隣に保存されます。
# What the app stores for the next turn.
saved = msg.model_dump(exclude_none=True)
if variant == "before":
    saved.pop("tool_calls", None)                # the bug: the assistant message is saved as text only
    saved["content"] = saved.get("content") or ""
history = [saved, *results, {"role": "assistant", "content": answer.choices[0].message.content or ""}]
ユーザーが次のメッセージを送ると、保存した履歴から 2 ターン目のリクエストが組み立てられます。そこにはツールの結果があるのに、対応する呼び出しがありません。そのため、次のエラーで拒否されます。「function call output」は、プロバイダーがツールの結果を指すときの名称です。
400 No tool call found for function call output with call_id call_Nqc1zUFvwLLuF5oGMEE9WheQ.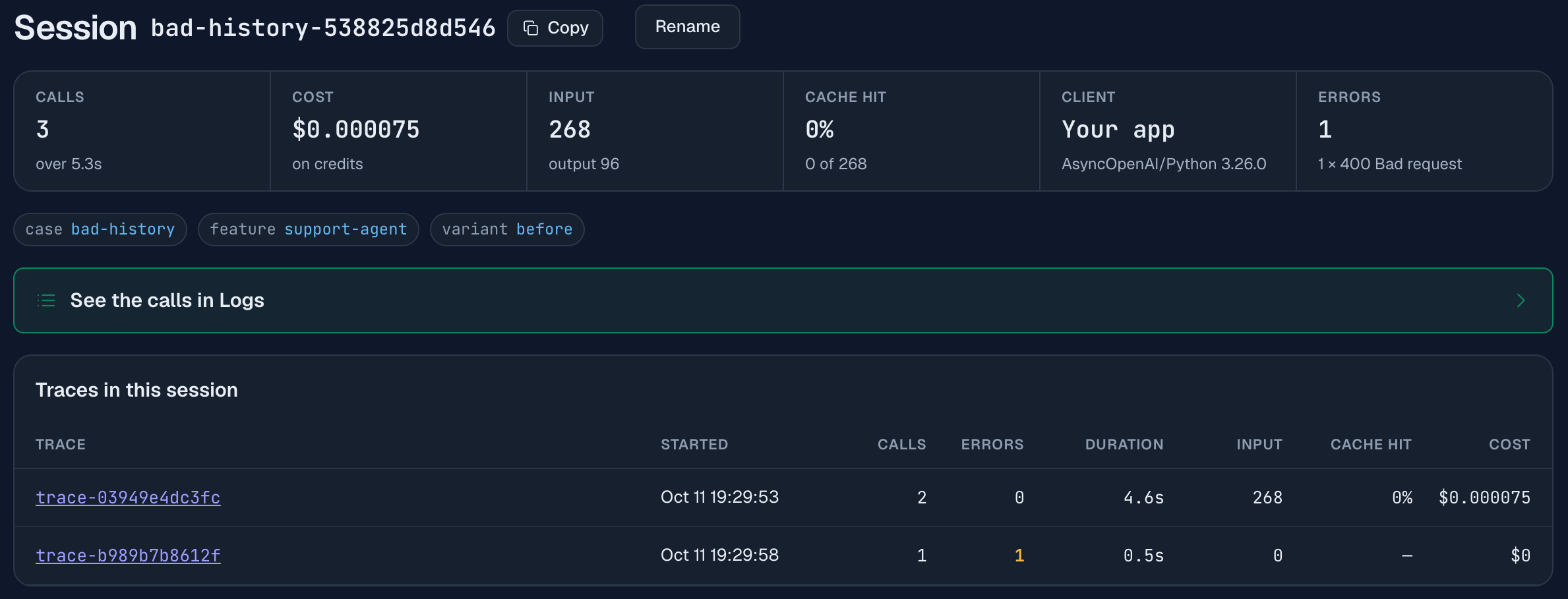
セッションページを見ると、このパターンがわかります。トレースは 2 つあり、1 つ目は呼び出し 2 回でエラーなし、2 つ目は呼び出し 1 回でエラー 1 件です。エラーのカードには「1 × 400 Bad request」と表示されます。失敗したトレースは入力 0 トークン、所要時間 0.5 秒、料金 $0 です。この 3 つの値から、モデルは一度も実行されず、リクエストが不正として拒否されたとわかります。モデルやプロバイダー側の問題であれば、トークンが使われている、所要時間が長い、ステータスが 5xx といった違いが現れます。
400 はリクエストのバグなので、リトライしても解決しません。修正箇所はエラー文に示されています。assistant のメッセージを丸ごと保存すれば、2 ターン目も成功します。
同じパターン、つまり 1 ターン目は正常で後のターンが拒否される症状は、ほかの履歴バグでも起きます。ツールの結果を呼び出し ID なしで保存した場合、メッセージの順序を誤って保存した場合、ツールのやり取りの途中で履歴を削り、結果だけ残して呼び出しを落とした場合などです。料金を抑えるために履歴を削るなら、ターンの境界で切り、ターンの途中では切らないでください。
調査できるようにするには何をログに残すべきか
記録するのは次の 5 つです。
- 実行ごとのトレース ID と会話ごとのセッション ID。
X-Trace-IdとX-Session-Idで送信し、自分たちのログにも記録します。 - 処理ステップと試行回数がわかる、呼び出しごとの span 名。たとえば
plan-2やpolicy-check.retryです。 - ユーザー、機能、リリースのラベル。
X-Synthorai-Metadataで送信します。 - 各呼び出しのレスポンスヘッダー
x-request-id。自分たちの ID と一緒に記録します。 - 各呼び出しの
finish_reasonと出力トークン数。lengthは失敗として扱います。
すべての呼び出しにクライアントのタイムアウトと max_tokens も設定し、どちらにも十分な余裕を持たせます。両方とも未設定だと、モデルが出力し続ける限り呼び出しが続き、コードも待ち続けます。ただし、画面に出る回答だけを想定して上限を決めると、2 つ目のケースと同じ不具合になります。また、長い生成処理より短いタイムアウトを設定すると、正常に動いている呼び出しを途中で止めてしまいます。推論モデルでは、1 回の呼び出しに数分かかることもあります。デモでは待ち時間を 300 秒とし、呼び出し側で個別に指定しない限り、出力上限を 2,000 トークンにしています。
FAQ
本番環境の LLM エージェントをどうデバッグするか
まず実行を特定します。リクエストログをユーザーや会話のラベルで絞り込み、一致するリクエストのトレースを開きます。トレースには、その実行で行われたすべてのモデル呼び出しが順番に表示され、失敗した呼び出しにはマークが付きます。コードを読む前に、どのステップで問題が起きたかを確認できます。
LLM がステータス 200 で空の応答を返すのはなぜか
よくある原因は、モデルが回答を書く前に出力上限に達したことです。推論モデルの max_tokens には、推論と回答の両方が含まれます。finish_reason を確認してください。length で、出力トークン数が上限と一致していれば、回答は打ち切られています。デモでは 3 回連続でステータス 200、出力はちょうど 40 トークンでしたが、使える回答はありませんでした。
「No tool call found for function call output」の原因は何か
会話履歴にツールの結果があるのに、対応するツール呼び出しがありません。呼び出しを行った assistant のメッセージを tool_calls なしで保存した場合や、呼び出しと結果の間で履歴を削った場合に起きます。assistant のメッセージは丸ごと保存し、履歴を削るときはターンの境界だけで切ってください。
失敗した LLM 呼び出しはリトライすべきか
ステータスによります。429(レート制限)や 5xx(サーバーエラー)は、リトライで成功する可能性があります。400 はリクエストの問題なので、同じように失敗します。max_tokens で打ち切られた回答も、上限を変えなければ再び打ち切られます。リトライする場合はトレース ID を引き継ぎ、両方の試行が 1 つのトレースに表示されるようにします。
関連記事
- LLM エージェントのトレース:ヘッダー、ウォーターフォール、失敗した呼び出しの例。
- LLM エージェントが遅い理由:同じトレースからレイテンシを調べる。
- LLM エージェントの料金が高い理由:セッションから料金を調べる。
- サブエージェント別に見る Claude Code の料金:自分で実装していないコーディングエージェントを、同じ画面で調べる。
- LLM のログについて Claude に質問する:「このユーザーのリクエストで失敗したものはあるか」に MCP 経由で答える。
- エージェントにログを調べるツールを持たせる:自作プログラムで同じログを読み、モデルのトークン料金を確認する。
- リクエストヘッダーのリファレンス:ID、ラベル、それぞれの制限。