
Meilleures API LLM Flash 2026 : GLM rentable, Gemini puissant
Sommaire
- Comment les neuf modèles se comparent-ils, et comment les avons-nous testés ?
- Quels modèles entrent dans la gamme Flash, et faut-il passer au plus récent ?
- Combien coûtent les neuf modèles ?
- Quels types d’entrée acceptent-ils, et peut-on désactiver le raisonnement ?
- Combien coûte une tâche complète, plutôt qu’un token ?
- Quel modèle Flash choisir ?
- Quels modèles Flash échouent avec leur réglage par défaut ?
- Un modèle Flash suffit-il, ou faut-il un modèle plus gros ?
- Qu’est-ce qui casse en production avec un modèle Flash ?
- Gestion par Synthorai
- FAQ
En septembre 2026, le choix de la meilleure API LLM Flash dépend du besoin : GLM 5.3 Flash offre le meilleur score par dollar, Gemini 3.8 Flash est le plus polyvalent et le seul choix solide pour l’audio et la vidéo, Claude Sonnet 5 invente le moins de réponses mais coûte le plus cher, et Seed 2.0 Mini est le modèle le moins cher à avoir réussi tous nos tests. Par gamme Flash, nous entendons le petit modèle rapide de chaque fournisseur. Nous avons évalué seize modèles. Chez chaque fournisseur, le modèle actuel surpasse son prédécesseur. Nous comparons ici les neuf modèles actuels selon leur tarif public, le prix du cache, les types d’entrée, les réglages de raisonnement, les benchmarks indépendants, le coût par tâche et les problèmes rencontrés en production.
TL;DR
- Passez au modèle actuel de chaque fournisseur : Claude Sonnet 5, GPT-5.6 Terra et Gemini 3.8 Flash coûtent plus cher par token que Haiku 4.5, GPT-5.4 mini et Gemini 3.5 Flash-Lite, mais 2.5 à 3.9 fois moins cher par réponse correcte.
- Meilleur rapport qualité-prix : GLM 5.3 Flash, avec un indice Artificial Analysis de 41.9 pour $0.25 par tâche.
- Le plus puissant et le meilleur en multimodal : Gemini 3.8 Flash.
- Le moins de réponses inventées : Claude Sonnet 5, au coût par tâche le plus élevé.
- Le moins cher : Seed 2.0 Mini à $0.10 / $0.40.
Comment les neuf modèles se comparent-ils, et comment les avons-nous testés ?
Les prix et les fonctionnalités viennent des pages des fournisseurs. Les benchmarks proviennent de classements indépendants qui exécutent tous les modèles avec le même protocole. Notre propre batterie de tests sert de seuil d’admission, pas de classement. Nous utilisons l’Intelligence Index v4.3 d’Artificial Analysis (AA) et son taux de non-hallucination (la fréquence à laquelle un modèle refuse de répondre plutôt que de deviner), LiveBench, le Vals Index, ainsi que les votes texte et WebDev d’Arena. Notre test comprend 11 tâches dont la réponse numérique est vérifiable (comptage de chiffres, sommes de nombres premiers, chemins dans une grille, rendu de monnaie, puissance modulaire, sac à dos et exercices similaires), avec 3 exécutions chacune. Nous ajoutons cinq questions sur une entreprise, un institut, une ville, un alliage et un prix qui n’existent pas, puis lisons les réponses en entier pour vérifier si le modèle refuse ou invente. Le raisonnement correspond aux tokens produits avant la réponse. Ils sont facturés comme des tokens de sortie et configurés pour chaque requête via un champ tel que reasoning_effort. Chaque modèle a été testé avec son réglage par défaut et avec tous les niveaux de raisonnement qu’il accepte.
| Modèle | Indice AA | Non-hallucination AA | LiveBench | Vals Index | Arena texte / WebDev | Notre test : défaut / meilleur | Réponses inventées par défaut |
|---|---|---|---|---|---|---|---|
| GPT-5.6 Terra | 42.3 au niveau max | 12.1 | 77.9 | 59.6 | 1466 / 1521 | 31 / 33 | 2 sur 5 |
| GLM 5.3 Flash | 41.9 | 72.4 | 71.6 | 47.2 | 1475 / 1607 | 31 / 31 | 0 sur 5 |
| Gemini 3.8 Flash | 41.2 au niveau high | 44.8 | 75.8 | 62.3 | 1493 / 1568 | 32 / 33 | 0 sur 5 |
| Qwen3.8 Flash | 39.9 | 54.7 | 76.2 | non répertorié | non répertorié / 1635 | 33 / 33 | 2 sur 5 |
| DeepSeek V4.1 Flash | 39.5 au niveau max | 3.5 | 81.1 | 57.9 | non répertorié / 1614 | 33 / 33 | 4 sur 5 |
| Claude Sonnet 5 | 38.4 au niveau max | 60.6 | 76.0 | 59.6 | 1461 / 1537 | 33 / 33 | 0 sur 5 |
| GPT-5.6 Luna | 37.5 au niveau max | 7.4 | 73.6 | 59.9 | 1453 / 1519 | 31 / 32 | 4 sur 5 |
| Hy3 | 25.8 | 25.9 | non répertorié | non répertorié | 1456 / 1513 | 33 / 33 | 0 sur 5 |
| Seed 2.0 Mini | non répertorié | non répertorié | non répertorié | non répertorié | non répertorié | 33 / 33 | 0 sur 5 |
Sources consultées le 2026-09-17 : Artificial Analysis, LiveBench, Vals Index, Arena texte et Arena WebDev. Les scores Arena suivent un système de type Elo, où un écart de 20 points reste faible. Qwen3.8 Flash y figure sous le nom Qwen3.8-Flash-Next, le modèle à poids ouverts qui sous-tend l’API. Les mesures ont été effectuées les 2026-09-16 et 17. Deux modèles ont été relancés le deuxième jour pour confirmer que les résultats des deux journées étaient comparables.
Aucun modèle ne domine tous les classements : Terra arrive en tête de l’indice, DeepSeek de LiveBench, Gemini 3.8 Flash de Vals et d’Arena texte, et Qwen3.8 Flash d’Arena WebDev. Le taux de non-hallucination AA et nos cinq questions fictives désignent les mêmes modèles comme les plus enclins à deviner : DeepSeek V4.1 Flash, Luna et Terra refusent rarement de répondre, tandis que GLM 5.3 Flash et Sonnet 5 refusent généralement. Seed 2.0 Mini n’apparaît dans aucun classement indépendant. Notre test est donc le seul élément disponible pour l’évaluer.
Quels modèles entrent dans la gamme Flash, et faut-il passer au plus récent ?
Le petit modèle le plus récent de chaque fournisseur entre dans cette catégorie, et il faut passer à la dernière version. Google, DeepSeek, Alibaba, Z.ai, ByteDance et Tencent utilisent les appellations Flash, Mini ou ne proposent qu’un seul modèle économique. La génération actuelle d’Anthropic comprend Fable, Opus et Sonnet. Haiku 4.5 appartient à la génération précédente (octobre 2025, retrait au plus tôt le 15 octobre 2026). Nous considérons donc Claude Sonnet 5 comme le modèle Flash de Claude. La documentation d’OpenAI place GPT-5.6 Terra dans l’ancienne gamme mini et GPT-5.6 Luna dans la gamme nano. Sonnet 5 ($2 / $10) et Terra ($2 / $12) coûtent plusieurs fois plus cher par token que les sept autres modèles. Ils forment donc leur propre tranche tarifaire ci-dessous.
Nous avons aussi évalué le petit modèle précédent de quatre fournisseurs, en calculant pour chacun le coût par réponse correcte : toutes les dépenses des 33 exécutions divisées par le nombre de bonnes réponses. Un modèle correct une fois sur deux paie donc deux fois pour chaque réponse juste. Le modèle actuel gagne dans chaque comparaison. Dans les trois cas cités dans le TL;DR, son prix par token est plus élevé, mais son coût par réponse correcte est inférieur :
- Claude Sonnet 5 plutôt que Claude Haiku 4.5. Haiku n’a atteint 32 sur 33 qu’avec le raisonnement au maximum. Sonnet 5 a obtenu 33 sur 33 avec tous les réglages où le raisonnement était activé, pour un coût par réponse correcte 2.9 fois inférieur avec
max, son réglage le moins cher. Les deux ont refusé les cinq questions fictives. - GPT-5.6 Terra plutôt que GPT-5.4 mini. Mini a obtenu 9 sur 33 avec son réglage par défaut et a eu besoin de
highpour atteindre 33. Terra a obtenu 33 aveclow, pour un coût 2.5 fois inférieur. Terra a inventé deux réponses, alors que mini a refusé les cinq questions. - Gemini 3.8 Flash plutôt que Gemini 3.5 Flash-Lite et Gemini 3.7 Flash. Par rapport à Flash-Lite, son coût par réponse correcte est 3.9 fois inférieur. Il a aussi refusé les trois questions fictives auxquelles Flash-Lite a répondu. Flash-Lite ne conserve un intérêt que pour l’extraction en une seule étape. Face à 3.7 Flash, le tarif public reste identique et 3.8 coûte environ 10% de plus par appel. Cette mise à niveau apporte donc plus de capacités, pas des économies.
- GPT-5.6 Luna plutôt que GPT-5.4 nano, avec environ un tiers du coût par réponse correcte pour le même score de 31 sur 33, et Qwen3.8 Flash plutôt que Qwen3.6 Flash et Qwen3.5 Flash, qui utilisent environ dix fois plus de tokens de raisonnement et coûtent 6 à 27 fois plus cher par réponse correcte.
La suite de cet article ne porte que sur les neuf modèles actuels.
Combien coûtent les neuf modèles ?
Nous les répartissons en trois tranches selon le tarif public des tokens de sortie. La barre représente notre coût mesuré par réponse correcte avec le meilleur réglage de chaque modèle. Elle combine donc le prix catalogue et les habitudes de raisonnement coûteuses. L’étiquette indique le tarif public et le prix de lecture du cache, c’est-à-dire le coût d’un préfixe de prompt répété en proportion du prix d’entrée.
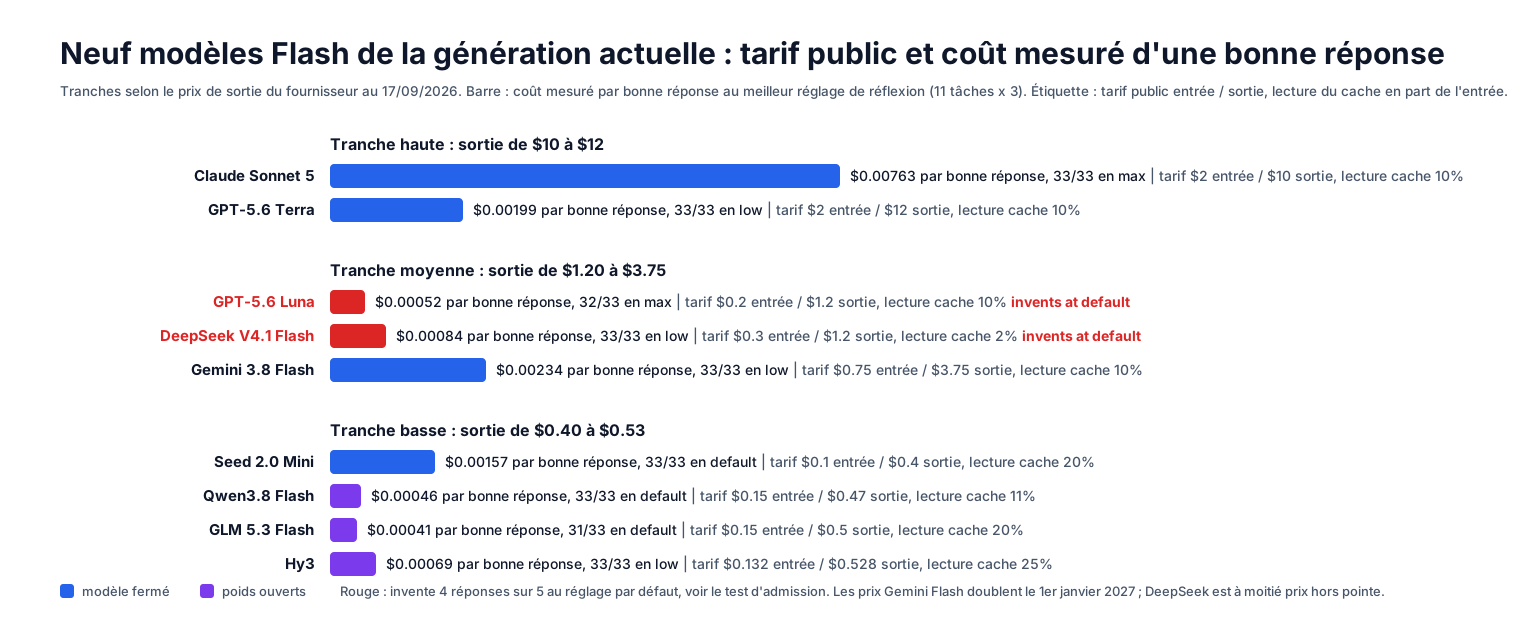
La tranche tarifaire prédit mal la facture. GPT-5.6 Terra, pourtant dans la tranche la plus chère, a coûté moins cher par réponse correcte que Gemini 3.8 Flash et seulement environ un quart de plus que Seed 2.0 Mini. Les tokens de raisonnement pèsent autant sur le coût que le tarif public. Les prix changent aussi souvent et varient selon l’heure et la région : les tarifs des modèles Flash 3.x de Google doubleront le 1er janvier 2027 (Gemini 3.8 Flash passera à $1.50 / $7.50), DeepSeek facture moitié prix en dehors des créneaux 01:00 à 04:00 et 06:00 à 10:00 UTC en semaine, OpenAI a réduit le prix de GPT-5.6 Luna de 80% en juillet, et Qwen3.8 Flash coûte 19 à 25% moins cher hors de la région Singapore d’Alibaba. Trois petits modèles actuels n’étaient pas disponibles sur Synthorai les jours du test et n’ont pas été mesurés : Mistral Small 4 ($0.15 / $0.60), StepFun Step 3.7 Flash ($0.20 / $1.15) et Amazon Nova 2 Lite ($0.30 / $2.50).
Quels types d’entrée acceptent-ils, et peut-on désactiver le raisonnement ?
Huit modèles sur neuf acceptent les images, quatre la vidéo et deux l’audio. Hy3, le Hunyuan 3 de Tencent, ne traite que le texte. La dernière colonne indique si une extraction JSON soumise à un schéma strict a renvoyé les bonnes valeurs lors de 8 extractions de facture.
| Modèle | Entrée | Contexte / sortie max | Poids ouverts | Désactivation du raisonnement | Raisonnement par défaut | JSON avec schéma |
|---|---|---|---|---|---|---|
| Claude Sonnet 5 | texte, image | 1M / 128K | non | oui | adaptatif, high | 8/8 via appel d’outil |
| GPT-5.6 Terra | texte, image | 1.05M / 128K | non | oui | medium | 8/8 |
| Gemini 3.8 Flash | texte, image, audio, vidéo, PDF | 1M / 64K | non | non | medium | 8/8 |
| GPT-5.6 Luna | texte, image | 1.05M / 128K | non | oui | medium | 8/8 |
| DeepSeek V4.1 Flash | texte, image | 1M / 384K | MIT | oui | high | json_object uniquement, 8/8 |
| Seed 2.0 Mini | texte, image, audio, vidéo | 256K / 128K | non | oui | medium | 8/8 |
| Qwen3.8 Flash | texte, image, vidéo | 1M / 128K | licence Qwen | oui | xhigh | 3/8, entiers erronés |
| GLM 5.3 Flash | texte, image, vidéo, fichier | 1M / 128K | MIT | non | max | json_object uniquement, 8/8 |
| Hy3 | texte | 256K / 128K | Apache 2.0 | oui | high | json_object uniquement, 7/8 |
« Via appel d’outil » signifie que le schéma a été fourni comme entrée d’un outil et que Claude a été forcé à l’appeler. « json_object uniquement » signifie qu’un schéma strict n’a pas donné le bon résultat via notre chemin de requête, contrairement à {"type": "json_object"} avec les noms des clés indiqués dans le prompt. Pour l’entrée audio, choisissez Gemini 3.8 Flash ou Seed 2.0 Mini. Pour une sortie supérieure à 128K, choisissez DeepSeek V4.1 Flash. Pour des poids déployables sur votre propre infrastructure, choisissez DeepSeek, GLM, Hy3 ou Qwen3.8 Flash.
Combien coûte une tâche complète, plutôt qu’un token ?
Le coût d’un appel dépend du tarif et du nombre de tokens que le modèle décide d’utiliser. Dans cette gamme, le second facteur varie davantage que le premier. La mesure publique la plus équitable est le coût calculé par Artificial Analysis pour exécuter une tâche de son indice, tokens de raisonnement compris. Elle est disponible pour huit des neuf modèles.
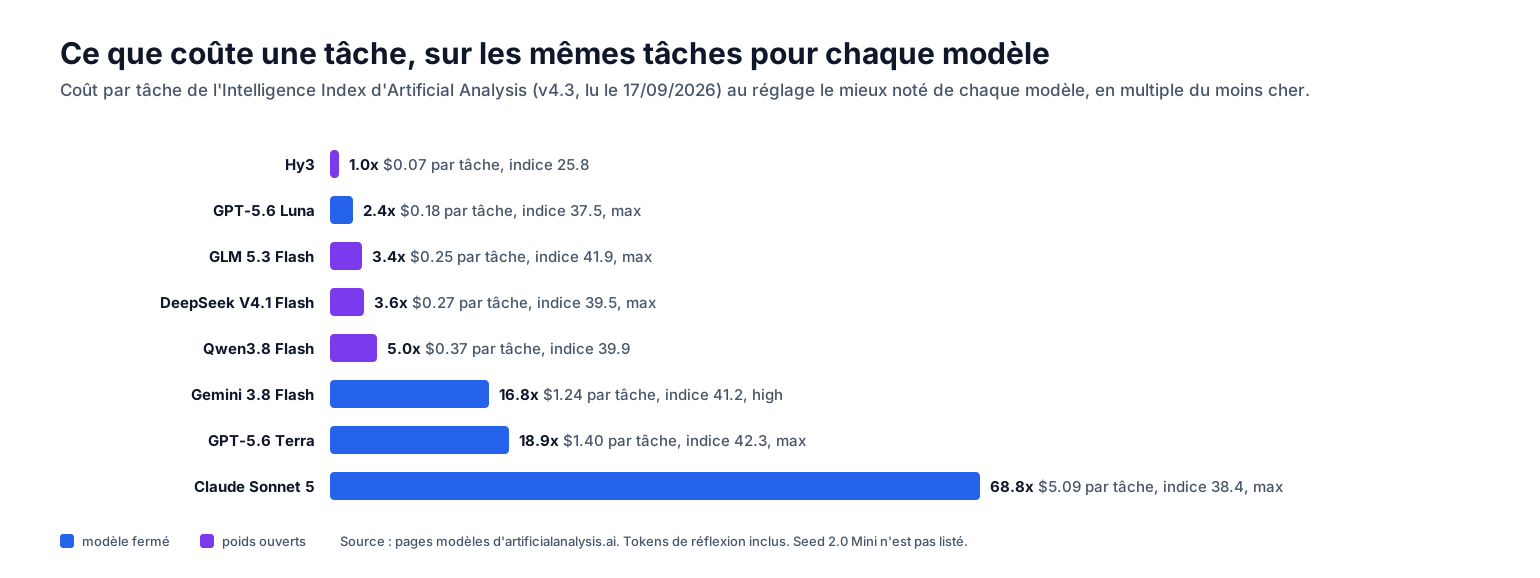
GLM 5.3 Flash termine à moins d’un demi-point de GPT-5.6 Terra pour un cinquième du coût par tâche. Qwen3.8 Flash affiche presque le même tarif public que GLM, mais coûte 50% de plus par tâche, car il a produit 240 millions de tokens de sortie pour exécuter l’indice, contre 180 millions pour GLM. Avec max, Claude Sonnet 5 coûte $5.09 par tâche, contre $1.79 avec son réglage high par défaut, pour six points d’indice supplémentaires. Nos appels isolés montrent le même phénomène : Seed 2.0 Mini affiche un tarif public inférieur à Qwen3.8 Flash, mais coûte 3.4 fois plus cher par réponse correcte. Il utilise une médiane de 2,810 tokens de raisonnement par tâche, contre 530 pour Qwen.
La lecture du cache coûte 2% du tarif d’entrée chez DeepSeek, environ 10% chez Google, OpenAI, Anthropic et Alibaba, 20% chez Z.ai et ByteDance, et 25% chez Tencent. Pour les agents et le trafic RAG (génération augmentée par récupération, où les documents récupérés sont ajoutés à chaque prompt), le tarif de lecture détermine l’essentiel de la facture : un préfixe en cache de 100K tokens coûte $0.0006 par appel avec DeepSeek V4.1 Flash, contre $0.02 avec Sonnet 5 ou Terra. OpenRouter a signalé que, sur une journée après le lancement, 90% des tokens servis par V4.1 Flash provenaient de lectures du cache (publication). Les offres batch, traitées en quelques heures, divisent par deux les prix de Gemini 3.8 Flash, GPT-5.6 Luna, Terra et Sonnet 5. Qwen3.8 Flash, GLM 5.3 Flash et Hy3 n’en proposent pas.
Quel modèle Flash choisir ?
GLM 5.3 Flash pour le rapport qualité-prix, Gemini 3.8 Flash pour la puissance et les entrées multimodales, Claude Sonnet 5 pour limiter les réponses inventées, Seed 2.0 Mini pour le prix.
| Besoin | Choix | Pourquoi |
|---|---|---|
| Meilleur rapport qualité-prix | GLM 5.3 Flash | indice de 41.9, juste derrière Terra, à $0.25 par tâche ; meilleur taux de non-hallucination des neuf (72.4) ; $0.15 / $0.50 ; entrées image, vidéo et fichier ; poids MIT |
| Le plus polyvalent | Gemini 3.8 Flash | premier des neuf sur Vals et Arena texte, à 1.1 point d’indice de Terra pour 11% de moins par tâche ; 33 sur 33 avec low, refus de toutes les questions fictives |
| Meilleur en multimodal | Gemini 3.8 Flash | entrées audio, vidéo et PDF, audio facturé comme le texte ; JSON avec schéma réussi 8 fois sur 8 |
| Le moins de réponses inventées, avec une faible latence | Claude Sonnet 5 | 33 sur 33 avec tous les réglages où le raisonnement est activé, refus des cinq questions fictives avec ou sans raisonnement, premier token de réponse en 2.2 secondes ; coût par tâche le plus élevé, à réserver aux cas où une réponse inventée coûte plus cher que l’appel |
| Le moins cher | Seed 2.0 Mini | $0.10 / $0.40 ; 33 sur 33 par défaut, JSON avec schéma réussi 8 fois sur 8, refus des cinq questions fictives, entrées audio et vidéo |
Trois modèles ne reçoivent pas de recommandation, chacun pour une raison précise. GPT-5.6 Terra arrive en tête de l’indice et obtient 33 sur 33 avec low pour $0.00199 par réponse correcte, mais il a inventé deux réponses sur cinq alors que ses tokens de sortie coûtent $12 par million. DeepSeek V4.1 Flash domine LiveBench et propose le cache le moins cher, mais n’accepte que le texte et les images, et a inventé quatre réponses sur cinq avec le raisonnement activé. Qwen3.8 Flash a obtenu le score parfait le moins cher de notre test, à $0.00046 par réponse correcte, et domine Arena WebDev. Il a toutefois inventé deux réponses, produit des entiers erronés sous un schéma strict et mis presque trois minutes à générer une explication de 400 mots.
Mieux vaut router les requêtes que choisir un seul modèle : envoyez les tâches fermées à réponse vérifiable au modèle le moins cher qui les réussit (GLM 5.3 Flash, Qwen3.8 Flash, Hy3), les questions factuelles ouvertes à un modèle qui sait refuser (GLM 5.3 Flash, Sonnet 5, Gemini 3.8 Flash), et les longues exécutions d’agents au modèle le plus puissant compatible avec votre budget.
Quels modèles Flash échouent avec leur réglage par défaut ?
Deux modèles sur neuf. Tous deux passent si les questions ouvertes sont envoyées à un réglage qui sait refuser. Avec le réglage livré par défaut, le seuil d’admission est fixé à au moins 30 bonnes réponses sur 33 et au plus deux réponses inventées sur cinq.
| Modèle | Avec son réglage par défaut | Modification | Après modification |
|---|---|---|---|
| DeepSeek V4.1 Flash | 4 réponses inventées sur 5 (« 50 employés », « 1790 °C », un personnage des Simpsons présenté comme lauréat) | désactiver le raisonnement pour les questions ouvertes | refus des 5 questions sur 5, mais 21 bonnes réponses sur 33 pour les tâches ; ne lui envoyer que les questions ouvertes avec ce réglage |
| GPT-5.6 Luna | 4 réponses inventées sur 5 (« environ 20 employés », « 1974 », « 1,400 °C ») | désactiver le raisonnement pour les questions ouvertes | refus de 4 questions sur 5, mais 7 bonnes réponses sur 33 pour les tâches ; appliquer le même routage |
GPT-5.6 Terra et Qwen3.8 Flash sont exactement au seuil avec deux réponses inventées chacun (« 0 employé » et « environ 1,455 °C » pour Terra). Appliquez-leur la même règle pour les questions ouvertes.
Un modèle Flash suffit-il, ou faut-il un modèle plus gros ?
Pour les tâches bien délimitées, oui. Sur les benchmarks d’agents les plus courts, où le modèle travaille dans un shell sur de vrais dépôts, DeepSeek V4.1 Flash dépasse DeepSeek V4 Pro sur Terminal-Bench 2.1 (90.6 contre 87.9) et DeepSWE (74.2 contre 62.7). Gemini 3.8 Flash obtient 89.4 sur Terminal-Bench 2.1, contre 89.1 pour Claude Opus 5. Les neuf modèles ont aussi terminé notre boucle d’appel d’outils en deux tours 3 fois sur 3.
L’écart réapparaît sur les tâches longues et les contextes étendus. Dans le tableau de Google pour Terminal-Bench 4.0, Gemini 3.8 Flash obtient 19.1 contre 51.8 pour Opus 5. Sur le test d’OpenAI qui consiste à retrouver plusieurs informations dispersées dans des contextes de 512K à 1M tokens, GPT-5.6 Luna obtient 41.3 contre 72.5 pour GPT-5.6 Terra. Une fenêtre de 1M ne garantit donc pas un rappel fiable sur 1M tokens avec les plus petits modèles. Réservez les modèles Flash à l’extraction, à la classification, aux courtes étapes d’appel d’outils et aux modifications de code dont la forme est connue. Utilisez un modèle plus gros pour planifier de longues exécutions d’agents et répondre à des questions sur de très longs documents.
Qu’est-ce qui casse en production avec un modèle Flash ?
Les problèmes viennent davantage des réglages par défaut et de la forme des requêtes que des capacités du modèle.
- Deux modèles ne permettent pas de désactiver le raisonnement. Gemini 3.8 Flash et GLM 5.3 Flash ont renvoyé une erreur 400 pour tous les réglages de désactivation testés.
- Les réglages par défaut se trouvent aux deux extrêmes. GLM 5.3 Flash utilise
maxpar défaut et Qwen3.8 Flash utilisexhigh(Alibaba). Sur nos cinq questions fictives, Qwen3.8 Flash a consommé une médiane de 11,680 tokens de raisonnement. Google inclut le raisonnement dansmax_output_tokens. Une limite trop basse peut donc produire une réponse tronquée ou vide qui reste facturée (guide sur le raisonnement). - Claude utilise ses propres paramètres. Claude Sonnet 5 règle la profondeur du raisonnement avec
output_config.effortet rejette l’ancien paramètrebudget_tokens(effort).reasoning_effortne fait pas partie de ses paramètres. - Les boucles d’outils doivent renvoyer le raisonnement. Le mode raisonnement de DeepSeek attend le
reasoning_contentdes tours précédents (mode raisonnement), tandis que Gemini associe des signatures de pensée aux parties contenant les appels de fonction. Les frameworks qui reconstruisent l’historique des messages suppriment les deux. - Le JSON strict n’est pas uniforme. Qwen3.8 Flash a respecté les types du schéma, mais a produit des entiers erronés dans 5 exécutions sur 8 (postes de facture à
-561994). Utilisezjson_objecten nommant les clés dans le prompt pour Qwen, GLM, Hy3 et DeepSeek, et un appel d’outil pour Claude. - Le raisonnement modifie la propension à inventer. DeepSeek V4.1 Flash a inventé quatre réponses sur cinq avec le raisonnement activé, et aucune avec le raisonnement désactivé.
- Les identifiants de modèle changent.
deepseek-v4-flashsert V4.1 Flash depuis le 10 septembre (tarifs) et Claude Haiku 4.5 peut être retiré à partir du 15 octobre (retraits). Épinglez une version datée quand elle existe, par exempleseed-2-0-mini-260428. - Les hébergeurs tiers de poids ouverts ne se valent pas. DeepSeek, GLM, Qwen et Hy3 sont proposés par de nombreux fournisseurs avec des quantifications et des comportements de cache différents. En septembre, il a été découvert qu’un revendeur routait des requêtes payantes vers un modèle moins cher (Hacker News). Comparez les réponses de votre fournisseur à celles de l’API officielle.
La vitesse dépend davantage du réglage de raisonnement par défaut que de la taille du modèle. Voici les résultats de 3 exécutions en streaming d’une explication de 400 mots avec les réglages par défaut, le 2026-09-17 :
| Modèle, réglage par défaut | Premier token de réponse | Durée totale | Tokens de sortie par seconde |
|---|---|---|---|
| Claude Sonnet 5 | 2.2 s | 10.5 s | 70 |
| Gemini 3.8 Flash | 10.7 s | 14.3 s | 114 |
| GPT-5.6 Luna | 24.9 s | 26.1 s | 89 |
| GPT-5.6 Terra | 33.3 s | 34.2 s | 63 |
| GLM 5.3 Flash | 36.7 s | 39.3 s | 128 |
| DeepSeek V4.1 Flash | 40.4 s | 40.6 s | 158 |
| Seed 2.0 Mini | 61.3 s | 61.5 s | 81 |
| Hy3 | 123.0 s | 134.5 s | 35 |
| Qwen3.8 Flash | 159.9 s | 165.8 s | 72 |
Le nombre de tokens par seconde inclut le raisonnement et la réponse sur l’ensemble de l’appel. Le raisonnement adaptatif de Sonnet 5 n’a consommé aucun token sur une tâche de rédaction, et la réponse a commencé immédiatement. Qwen3.8 Flash a utilisé une médiane de 10,697 tokens de raisonnement pour la même tâche. Un prompt ouvert peut donc prendre plusieurs minutes sur un modèle pourtant économique pour les tâches fermées.
Le réglage tient dans un seul champ d’une requête compatible OpenAI, et la consommation du raisonnement revient dans usage :
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key="sk-syn-...")
r = client.chat.completions.create(
    model="gemini-3.8-flash",          # or glm-5.3-flash, gpt-5.6-terra, ...
    reasoning_effort="low",
    max_tokens=32768,
    messages=[{"role": "user", "content": "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer."}],
)
u = r.usage
print(r.choices[0].message.content, u.completion_tokens, u.completion_tokens_details.reasoning_tokens)
Pour Claude Sonnet 5, envoyez la même requête à l’API Messages avec output_config: {"effort": "low"}.
Gestion par Synthorai
Tous les modèles ci-dessus sont accessibles avec un seul identifiant model sur le même endpoint, compatible OpenAI ou Anthropic. La page de comparaison des modèles permet de comparer deux modèles sur les prix, le cache, les types d’entrée, le contexte et les benchmarks des fournisseurs. Les tarifs actuels des neuf modèles figurent dans le comparatif des prix des modèles.
FAQ
Claude Sonnet 5 est-il un modèle Flash ? Anthropic ne le présente pas ainsi, mais c’est le plus petit modèle de la génération Claude actuelle. Claude Haiku 4.5 date d’octobre 2025 et peut être retiré à partir du 15 octobre 2026. Claude Sonnet 5 coûte $2 / $10 contre $1 / $5 pour Haiku, mais son coût par réponse correcte a été 2.9 fois inférieur dans notre test.
L’API Gemini Flash est-elle gratuite ? Gemini 3.8 Flash propose une offre gratuite dans Google AI Studio. Google utilise toutefois le contenu de cette offre pour améliorer ses produits (tarifs), et seules les offres payantes peuvent servir des applications destinées à l’EEE, à la Suisse ou au Royaume-Uni (conditions). L’offre payante coûte $0.75 / $3.75 jusqu’au 31 décembre 2026, puis $1.50 / $7.50.
Faut-il choisir Gemini Flash ou Flash-Lite ? Choisissez Gemini 3.8 Flash, sauf si chaque requête est une extraction en une seule étape. Il obtient 41.2 à l’indice Artificial Analysis contre 23 pour Gemini 3.5 Flash-Lite, a coûté 3.9 fois moins cher par réponse correcte dans notre test, et a refusé les cinq questions fictives alors que Flash-Lite a répondu à trois. Flash-Lite coûte $0.30 / $2.50 et répond en environ 4 secondes.
GPT-5.6 Luna ou GPT-5.6 Terra ?
Choisissez GPT-5.6 Luna pour le volume et GPT-5.6 Terra pour les raisonnements plus difficiles. Luna coûte $0.20 / $1.20 et a obtenu 31 sur 33 avec son réglage par défaut, pour $0.00030 par réponse correcte. Terra coûte $2 / $12, a obtenu 33 sur 33 avec low pour $0.00199, et affiche le meilleur indice des neuf. Les deux ont inventé des réponses avec leur réglage par défaut : quatre sur cinq pour Luna et deux pour Terra.
Quel modèle Flash choisir pour le code ? Qwen3.8 Flash, DeepSeek V4.1 Flash et GLM 5.3 Flash dominent Arena WebDev (1635, 1614 et 1607). DeepSeek arrive en tête de la catégorie agentic coding de LiveBench (77.3). DeepSeek et Claude Sonnet 5 dominent le Vibe Code Bench de Vals (84.7 et 81.3).
À lire aussi : coût de l’API DeepSeek V4.1 Flash, coût de l’API GLM 5.3, coût de l’API Gemini 3.7 Flash, comparaison du prompt caching selon les fournisseurs, meilleur LLM selon le cas d’usage.