
Coût API GLM 5.3 : raisonne toujours, 2.5x moins cher que 5.2
Sommaire
- Qu’est-ce que GLM 5.3 et combien coûte-t-il ?
- Peut-on encore désactiver le raisonnement ?
- Quel niveau d’effort donne les bonnes réponses ?
- Invente-t-il une réponse quand il n’y en a pas ?
- GLM 5.3 respecte-t-il un schéma JSON ?
- Combien coûte une image avec GLM 5.3 Flash ?
- Qu’est-ce qui a changé depuis GLM 5.2 ?
- Prise en charge par Synthorai
- FAQ
GLM 5.3 coûte, comme GLM 5.2, $1.40 par million de tokens en entrée et $4.40 par million en sortie. Il n’est plus possible de désactiver le raisonnement : toutes les méthodes renvoient une erreur 400, et l’effort par défaut est max. Nous avons exécuté trois fois 11 tâches dont la réponse était vérifiable. Seul max a obtenu 33 bonnes réponses sur 33, à $0.00468 par bonne réponse. C’est 2.5x moins cher que GLM 5.2 avec max, car GLM 5.3 utilise environ deux fois moins de raisonnement. low réduit le coût par bonne réponse de 63%, mais rate 5 réponses sur 33. GLM 5.3 Flash atteint 31 sur 33 pour un dixième du prix. reasoning_effort, le paramètre qui détermine combien de temps un modèle raisonne avant de répondre, influe désormais autant sur la précision que sur le coût. Nous avons mesuré les deux versions face à GLM 5.2 et DeepSeek V4.1 Flash dans une même série de tests.
TL;DR
- GLM 5.3 et GLM 5.3 Flash refusent
thinking: disabled,reasoning_effort: noneetmediumavec l’erreur 1210. Seulslow,highetmax(la valeur par défaut) fonctionnent. - Avec
max, GLM 5.3 obtient 33 sur 33 à $0.00468 par bonne réponse. GLM 5.2 avecmaxcoûte $0.01173. - Avec
low, GLM 5.3 obtient 28 sur 33 et GLM 5.3 Flash 24 sur 33. - Les deux versions de GLM 5.3 ignorent un
json_schemastrict.json_objecta renvoyé les bonnes valeurs 8 fois sur 8.
Qu’est-ce que GLM 5.3 et combien coûte-t-il ?
Un GLM 5.2 réentraîné au même prix, accompagné d’un modèle plus petit dix fois moins cher. D’après le guide de Z.ai, GLM 5.3 « utilise le même modèle de base que GLM-5.2, toutes les améliorations venant du post-entraînement ». Il n’accepte que du texte. GLM 5.3 Flash compte « 320B paramètres au total, dont 18B activés » (seuls 18B travaillent sur chaque token, d’où son faible coût) et accepte les images, les vidéos et les fichiers. Les deux disposent d’une fenêtre de contexte de 1M tokens et d’une sortie maximale de 128K. Voici les tarifs par million de tokens indiqués sur la page de tarification de Z.ai :
| Modèle | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| GLM 5.3 | $1.40 | $0.26 | $4.40 |
| GLM 5.3 Flash | $0.15 | $0.03 | $0.50 |
| GLM 5.2 | $1.40 | $0.26 | $4.40 |
| DeepSeek V4.1 Flash | $0.30 en période de pointe | $0.006 en période de pointe | $1.20 en période de pointe |
La fiche du modèle et le guide de Flash de Z.ai attribuent les progrès aux tâches d’agent et de développement :
| Benchmark | Ce qu’il mesure | GLM 5.2 | GLM 5.3 | GLM 5.3 Flash |
|---|---|---|---|---|
| Terminal Bench 3.0 | tâches d’agent dans un terminal | 4.6 | 28.3 | non indiqué |
| DeepSWE v1.1 | correction de vrais dépôts | 46.2 | 66.9 | 63.4 |
| AutomationBench | automatisation de workflows | 26.2 | 48.2 | 48.8 |
| CyberGym | tâches liées aux vulnérabilités de sécurité | 77.2 | 84.5 | non indiqué |
| HLE with tools | questions difficiles avec accès à des outils | 54.7 | 62.5 | non indiqué |
Nous avons testé ce que nous pouvions vérifier nous-mêmes : des tâches avec une seule réponse contrôlable, et non des benchmarks d’agents.
Peut-on encore désactiver le raisonnement ?
Non. GLM 5.2 acceptait thinking: {"type": "disabled"}. GLM 5.3 et GLM 5.3 Flash renvoient une réponse HTTP 400 avec le code d’erreur 1210 (« ce modèle raisonne toujours, la désactivation du raisonnement n’est pas prise en charge ; utilisez low, high ou max ») pour thinking: disabled, enable_thinking: false et pour reasoning_effort défini sur none, minimal, medium ou xhigh. Sans reasoning_effort, la valeur utilisée est max. thinking_budget, qui plafonne le nombre de tokens de raisonnement chez certains fournisseurs, est accepté mais ignoré par GLM 5.3 : sur une même question, toutes les valeurs de 0 à 1,024 ont produit environ 101 tokens de raisonnement.
resp = client.chat.completions.create(
    model="glm-5.3",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="high",   # "low" | "high" | "max"; omitted means "max"
    max_tokens=8192,           # GLM 5.3 Flash rejects anything above 131,072
)
reasoning_tokens = resp.usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content                # the thinking itself, as text
L’ancienne option économique n’était de toute façon pas très bonne : sans raisonnement, GLM 5.2 n’a répondu correctement qu’à 10 de nos 33 tâches, et DeepSeek V4.1 Flash à 22.
Quel niveau d’effort donne les bonnes réponses ?
Pour GLM 5.3, seul max y parvient. Pour GLM 5.3 Flash, aucun. Nous avons exécuté trois fois 11 tâches dont la réponse est un nombre unique et vérifiable : sommes de nombres premiers, comptages de chiffres, chemins dans une grille, combinaisons de pièces, application d’une règle 40 fois, reste de la division de 7 à la puissance 222 par 1000, conversion de base, problème de sac à dos et comptage de nombres à quatre chiffres soumis à trois contraintes. Les tokens de raisonnement correspondent au raisonnement interne produit avant la réponse et sont facturés comme des tokens de sortie. Le coût par bonne réponse correspond à la dépense totale divisée par le nombre de bonnes réponses, aux tarifs publics :
| Modèle | Effort | Bonnes réponses | Tokens de raisonnement, médiane (maximum) | Coût par bonne réponse |
|---|---|---|---|---|
| GLM 5.3 | low | 28/33 | 143 (1,826) | $0.00173 |
| GLM 5.3 | high | 29/33 | 226 (1,950) | $0.00197 |
| GLM 5.3 | max (par défaut) | 33/33 | 538 (7,733) | $0.00468 |
| GLM 5.3 Flash | low | 24/33 | 120 (467) | $0.00012 |
| GLM 5.3 Flash | high | 29/33 | 196 (1,582) | $0.00021 |
| GLM 5.3 Flash | max (par défaut) | 31/33 | 419 (5,024) | $0.00040 |
| GLM 5.2 | max | 33/33 | 1,129 (21,917) | $0.01173 |
| DeepSeek V4.1 Flash | low | 33/33 | 337 (6,797) | $0.00102 |
| DeepSeek V4.1 Flash | max | 33/33 | 386 (10,769) | $0.00138 |
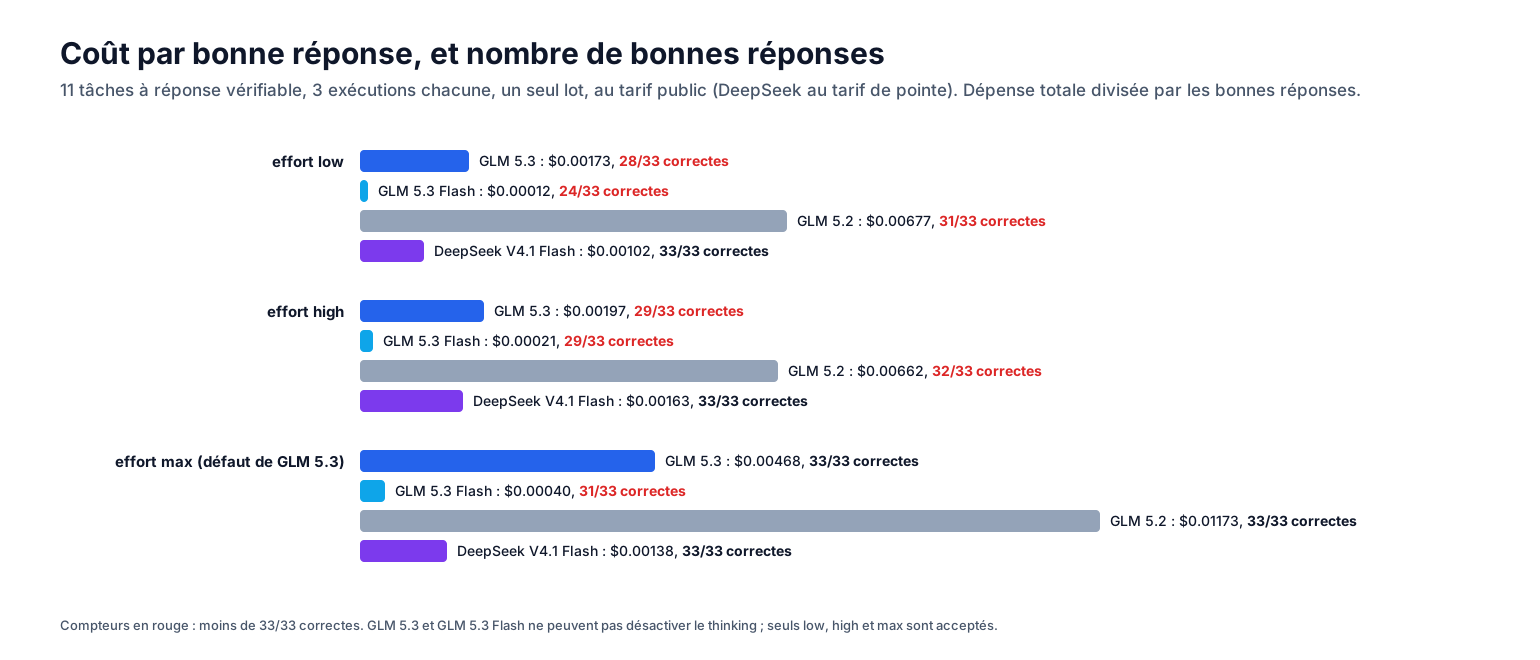
L’écart de 2.5x avec GLM 5.2 vient du volume de raisonnement : une médiane de 538 tokens de raisonnement contre 1,129, et une exécution maximale de 7,733 contre 21,917. Les niveaux inférieurs économisent de l’argent en sautant des vérifications. Avec low, GLM 5.3 a répondu deux fois 216 au problème des chemins dans une grille (une case bloquée ramène le résultat à 132), puis s’est trompé une fois sur les combinaisons de pièces, le sac à dos et la conversion de base. Avec low, GLM 5.3 Flash a échoué à chaque fois sur la règle en 40 étapes et le comptage sous contraintes. À l’inverse, DeepSeek V4.1 Flash a obtenu 33 sur 33 avec tous les niveaux.
Pour tout problème arithmétique ou à plusieurs étapes, conservez la valeur par défaut sur GLM 5.3. N’utilisez low que si une mauvaise réponse est facile et peu coûteuse à détecter. Avec max, GLM 5.3 coûte 3.4x plus cher que DeepSeek V4.1 Flash par bonne réponse. GLM 5.3 Flash coûte moins d’un tiers de ce prix, mais rate 2 réponses sur 33.
Invente-t-il une réponse quand il n’y en a pas ?
Non, même lorsque le raisonnement est obligatoire. Nous avons posé cinq questions sur des entités inventées, pour lesquelles la seule bonne réponse était « je ne sais pas » : le cours de l’action Verantis Dynamics, le point de fusion de Oridium-7 et le gagnant du 1987 Pan-Continental Robotics Prize. Les tests utilisaient l’effort par défaut avec une limite de 16,384 tokens :
| Modèle | A refusé de répondre | A inventé une réponse | A atteint la limite sans répondre | Tokens de raisonnement | Coût par question |
|---|---|---|---|---|---|
| GLM 5.3 | 5/5 | 0/5 | 0/5 | 230 à 542 | $0.0022 |
| GLM 5.3 Flash | 5/5 | 0/5 | 0/5 | 238 à 625 | $0.0003 |
| GLM 5.2 | 5/5 | 0/5 | 0/5 | 134 à 1,559 | $0.0035 |
| DeepSeek V4.1 Flash | 1/5 | 3/5 | 1/5 | 7,021 à 16,384 | $0.0139 |
Les deux versions de GLM 5.3 ont indiqué ne pas disposer de l’information après quelques centaines de tokens de raisonnement. DeepSeek V4.1 Flash a raisonné pendant 7,000 à 16,000 tokens, puis a généralement inventé une réponse (Andrew Martin, the robot protagonist of Isaac Asimov's The Bicentennial Man, won). Dans notre étude du modèle publiée la veille, davantage d’exécutions avaient plutôt atteint la limite, mais le modèle refusait rarement de répondre. Pour les recherches qui peuvent légitimement ne rien renvoyer, c’est la plus grande différence que nous ayons mesurée entre les deux modèles Flash.
GLM 5.3 respecte-t-il un schéma JSON ?
Pas un schéma strict. Utilisez json_object. Avec response_format défini sur un json_schema strict pour extraire une facture, GLM 5.3 et GLM 5.3 Flash ont renvoyé une réponse HTTP 200 tout en ignorant le schéma lors des 16 exécutions sur 16. Le JSON était entouré d’un bloc de code Markdown et contenait des clés absentes du schéma (invoice_date, reference). Aucun résultat n’a donc pu être interprété comme l’objet demandé. La documentation de référence de l’API de Z.ai ne mentionne que text et json_object. Le piège vient de l’acceptation silencieuse du schéma.
Avec {"type": "json_object"} et les champs nommés dans le prompt, les deux versions ont renvoyé toutes les bonnes valeurs lors des 8 exécutions sur 8. GLM 5.2 et DeepSeek V4.1 Flash ont fait de même. Comme le raisonnement reste actif, l’extraction consomme une médiane de 240 tokens de sortie sur GLM 5.3 et de 140 sur Flash, contre 25 sur V4.1 Flash sans raisonnement. Validez vous-même le résultat par rapport à votre schéma.
Combien coûte une image avec GLM 5.3 Flash ?
Le nombre de tokens augmente avec la surface en pixels et n’est toujours pas plafonné à 2048x2048. Les grandes images coûtent donc plus cher qu’avec DeepSeek V4.1 Flash malgré un tarif inférieur. Nous avons envoyé des PNG générés à GLM 5.3 Flash (GLM 5.3 n’accepte que du texte), puis soustrait le coût du prompt sans image :
| Image | Tokens GLM 5.3 Flash | Coût à $0.15/M | Tokens DeepSeek V4.1 Flash | Coût à $0.30/M |
|---|---|---|---|---|
| 512x512 | 363 | $0.000054 | 184 | $0.000055 |
| 1024x1024 | 1,371 | $0.000206 | 652 | $0.000196 |
| 2048x2048 | 5,478 | $0.000822 | 994 | $0.000298 |
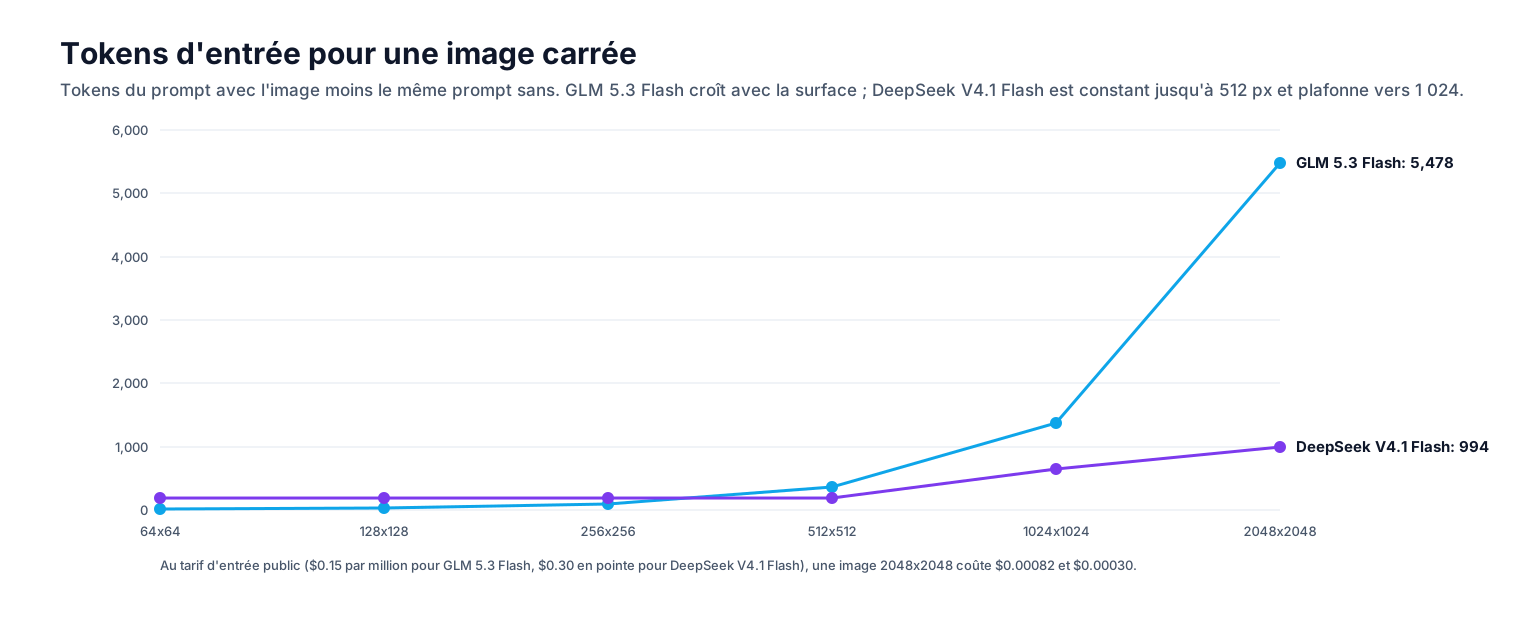
Au-delà de 512 pixels, GLM 5.3 Flash consomme environ un token pour 766 pixels. detail, le contenu de l’image et le format du fichier n’ont pas modifié le nombre de tokens. Les chiffres de DeepSeek V4.1 Flash viennent de l’étude publiée la veille. Réduisez la résolution des captures d’écran et des pages de document avant de les envoyer : à 2048x2048, GLM 5.3 Flash coûte 2.8x plus cher par image.
Qu’est-ce qui a changé depuis GLM 5.2 ?
La vitesse, mais peu de choses dans l’intégration. En streaming sur le même créneau, avec low, GLM 5.3 a généré 59 à 64 tokens de sortie par seconde, GLM 5.3 Flash 70 à 82, GLM 5.2 51 à 55 et DeepSeek V4.1 Flash 124 à 161. Dans une boucle de function calling sur deux tours, chaque modèle a effectué un appel par tour. Les trois versions GLM comptent exactement le même nombre de tokens sur des textes en anglais, en chinois et en Python (737, 484 et 488). Les budgets de tokens restent donc valables.
Le préfixe réutilisé d’un prompt est facturé au tarif du cache, par tranches de 64 tokens (sur un prompt de 1,153 tokens, 1,024 ont été lus dans le cache). Les deux versions acceptent des prompts proches de la limite de 1M tokens, même si la fiche du modèle Flash mentionne 300,000 tokens : un prompt de 990,000 tokens contenant une valeur cachée vers le début a permis de récupérer cette valeur (nous n’avons pas testé le rappel vers la fin). Un prompt d’environ 1.07M tokens a renvoyé une erreur 400, Prompt exceeds max length, au lieu d’être tronqué. Une incompatibilité à prévoir lors de la migration : GLM 5.3 Flash refuse les valeurs de max_tokens supérieures à 131,072.
Prise en charge par Synthorai
GLM 5.3, GLM 5.3 Flash et GLM 5.2 sont disponibles sur la gateway sous les identifiants glm-5.3, glm-5.3-flash et glm-5.2, aux tarifs publics de Z.ai, via /v1/chat/completions et /v1/responses. L’erreur 1210 est transmise sans modification. Un client qui envoie encore l’option de désactivation de GLM 5.2 reçoit donc une erreur explicite, au lieu de lancer silencieusement le raisonnement avec max. Le texte de raisonnement est renvoyé dans reasoning_content. Les images sont envoyées à GLM 5.3 Flash sous forme de parties de contenu image_url.
FAQ
Peut-on désactiver le raisonnement sur GLM 5.3 ?
Non. GLM 5.3 et GLM 5.3 Flash renvoient une erreur 400 avec le code 1210 pour toutes les méthodes de désactivation. Seuls low, high et max sont acceptés, avec max par défaut. Dans notre série de tests, low a réduit le coût par bonne réponse de 63%, mais n’a obtenu que 28 bonnes réponses sur 33 au lieu de 33.
GLM 5.3 est-il moins cher que GLM 5.2 ?
Pas par token : les deux coûtent $1.40 en entrée et $4.40 en sortie. Oui par bonne réponse : avec max, GLM 5.3 coûte $0.00468 contre $0.01173 pour GLM 5.2, car il utilise environ deux fois moins de raisonnement.
GLM 5.3 Flash peut-il remplacer GLM 5.3 ?
Oui lorsqu’une erreur numérique occasionnelle est détectée en aval, pour un dixième du prix. Avec max, GLM 5.3 Flash obtient 31 bonnes réponses sur 33 à $0.00040 par bonne réponse, contre 33 sur 33 à $0.00468 pour GLM 5.3. Évitez Flash avec low pour les calculs en plusieurs étapes, où il n’a obtenu que 24 bonnes réponses sur 33.
À lire aussi : effort de raisonnement de GLM 5.2, appels d’outils avec GLM 5.2, coût de DeepSeek V4.1 Flash, contrôle du raisonnement des LLM, sorties structurées des LLM.