
Coût API DeepSeek V4.1 Flash: V4 Pro pour 3 à 6x moins
Sommaire
- Qu’est-ce qui a changé le 10 septembre, et combien coûte V4.1 Flash?
- V4.1 Flash égale-t-il vraiment V4 Pro et dépasse-t-il V4 Flash?
- Que fait le réglage d’effort, et peut-on désactiver le thinking?
- Que se passe-t-il si la question porte sur quelque chose qui n’existe pas?
- La corruption JSON de V4 Flash est-elle corrigée?
- Combien coûte une image sur V4.1 Flash?
- Gestion par Synthorai
- FAQ
DeepSeek V4.1 Flash coûte $0.30 par million de tokens en entrée et $1.20 par million en sortie aux heures pleines, moitié moins aux heures creuses. Sur 11 tâches dont la réponse était vérifiable, exécutées trois fois chacune, il a obtenu 33 bonnes réponses sur 33, comme V4 Pro, pour un coût par bonne réponse 3 à 6x inférieur et un débit en sortie 2.9x supérieur. Par rapport au V4 Flash qu’il remplace, il coûte 26% de moins par bonne réponse, va 1.5x plus vite et devient le premier Flash capable de lire des images. Deux comportements sont à prendre en compte dans la conception: sans thinking, il répond aux calculs multi-étapes par un unique token erroné; avec thinking, il consomme toute la fenêtre de sortie, soit 16,384 tokens dans trois exécutions sur cinq, pour des questions portant sur des éléments inexistants. Nous avons mesuré deepseek-v4.1-flash et deepseek-v4-pro-0813 dans un même lot, à la même heure et via la même gateway, quatre jours après la sortie. Nous avons testé deepseek-v4-flash-0731 le même soir.
TL;DR
- V4.1 Flash coûte $0.30/$1.20 par million aux heures pleines, moitié moins aux heures creuses; V4 Pro coûte $1.32/$3.96.
- Avec thinking, les trois builds ont obtenu 33 bonnes réponses sur 33; chaque bonne réponse de V4.1 Flash a coûté entre $0.00097 et $0.00149, soit 3 à 6x moins que V4 Pro et 26% de moins que V4 Flash.
- Sans thinking, les trois builds tombent à 21 bonnes réponses sur 33; V4.1 Flash répond alors avec un seul token erroné.
- Sur cinq entités fictives, V4.1 Flash avec thinking a atteint la limite de 16,384 tokens trois fois et inventé une réponse deux fois; sans thinking, il a refusé de répondre aux cinq questions.
Qu’est-ce qui a changé le 10 septembre, et combien coûte V4.1 Flash?
Une nouvelle architecture, un nouveau tarif et un retrait. V4.1 Flash est « le plus petit modèle de notre nouvelle famille d’architectures »: 552B paramètres dans un encodeur-décodeur causal, avec une pile de 20 couches pour lire le prompt et une autre pour rédiger la réponse. Il active 8B paramètres par token en entrée et 16B en sortie, accepte nativement les images, dispose d’un contexte de 1M tokens et d’une limite de sortie de 384K, le tout sous licence MIT. La page des tarifs de DeepSeek indique $0.30 par million de tokens en entrée et $1.20 par million en sortie aux heures pleines, de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi. Aux heures creuses, les tarifs passent à $0.15 et $0.60, avec des cache hits facturés $0.006 et $0.003. Ce prix se situe entre les deux grilles qu’a connues V4 Flash: $0.14/$0.28 sans variation lors de son lancement en juillet, puis $0.44/$1.32 aux heures pleines à partir du 2026-08-16. Il reste largement inférieur aux $1.32/$3.96 de V4 Pro aux heures pleines.
V4 Flash et le build Vision Exp sont retirés, et leurs noms redirigent vers V4.1 Flash au tarif Flash. DeepSeek prévoyait aussi de rediriger le trafic de V4 Pro vers V4.1 Flash à partir du 14 septembre. Le journal des modifications a abandonné ce projet le jour même, « en réponse à la demande des utilisateurs ». Pro reste donc disponible au tarif Pro.
La plomberie a moins changé que le prix. Le tokenizer est identique sur les trois builds, avec respectivement 729, 452 et 528 tokens pour les mêmes corpus en anglais, en chinois et en Python. Les budgets de tokens restent donc valables. Les pages de cache sont passées de 1,024 à 512 tokens: sur un prompt de 549 tokens, 512 sont désormais mis en cache. Un prompt de 902K tokens contenant une valeur insérée l’a correctement restituée. Au-delà de la fenêtre de 1M tokens, l’API renvoie une erreur 400 au lieu de tronquer silencieusement le prompt.
D’après les chiffres publiés par DeepSeek dans la fiche du modèle, le nouveau Flash surpasse l’ancien partout. Il dépasse aussi Pro pour les tâches agentiques et le code, mais pas pour les connaissances:
| Benchmark | Ce qu’il mesure | V4 Flash | V4.1 Flash | V4 Pro |
|---|---|---|---|---|
| GPQA Diamond | questions scientifiques de niveau universitaire avancé | 89.9 | 90.9 | 92.4 |
| HLE | questions difficiles couvrant plusieurs disciplines | 37.8 | 36.8 | 42.7 |
| Codeforces | classement en programmation compétitive | 3289 | 3471 | 3348 |
| MathArena Apex | mathématiques de compétition | 58.6 | 65.6 | 65.3 |
| Terminal-Bench 2.1 | tâches agentiques dans un terminal | 82.7 | 90.6 | 87.9 |
| Terminal-Bench 4.0 | tâches agentiques plus difficiles dans un terminal | 7.0 | 31.2 | 12.4 |
| DeepSWE v1.1 | correction de dépôts réels | 54.4 | 74.2 | 62.7 |
| CyberGym | tâches portant sur des failles de sécurité | 76.7 | 88.1 | 83.3 |
| AutomationBench | automatisation de workflows | 37.7 | 54.8 | 43.2 |
La suite de cet article porte sur les résultats que nous avons pu vérifier nous-mêmes, c’est-à-dire la première moitié du tableau, où les réponses sont vérifiables, et non les lignes consacrées aux connaissances.
V4.1 Flash égale-t-il vraiment V4 Pro et dépasse-t-il V4 Flash?
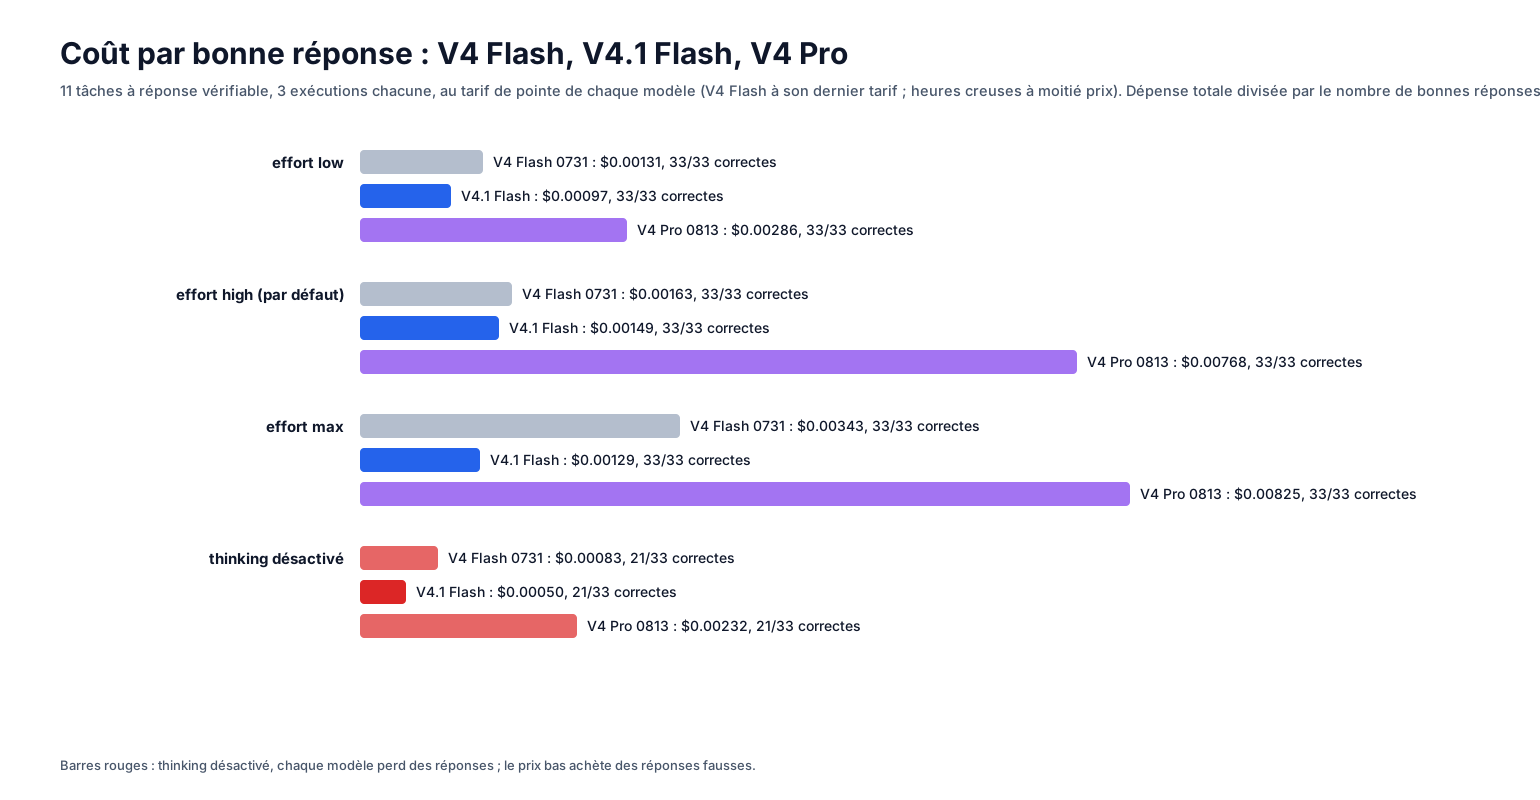
Sur les tâches dont la réponse est vérifiable, les trois builds obtiennent le même score. Les différences portent donc sur le prix, la vitesse et leurs modes d’échec. Nous avons exécuté trois fois 11 tâches dont la réponse est un nombre unique que nous pouvons vérifier: sommes de nombres premiers, comptages de chiffres, chemins dans une grille, combinaisons de pièces, application d’une règle 40 fois, reste de la division de 7 à la puissance 222 par 1000, conversion de base, problème de sac à dos et comptage des nombres à quatre chiffres respectant trois contraintes. Chaque tâche a été exécutée avec reasoning_effort réglé sur low, high et max, puis sans thinking. Les reasoning tokens correspondent à la réflexion masquée que le modèle produit avant sa réponse et sont facturés comme tokens de sortie. Pour chaque modèle, le coût par bonne réponse correspond au coût total divisé par le nombre de bonnes réponses, selon son tarif aux heures pleines. Pour V4 Flash, nous avons utilisé le tarif de $0.44/$1.32 appliqué jusqu’à son retrait. Aux heures creuses, le coût est divisé par deux:
| Modèle | Effort | Bonnes réponses | Reasoning tokens, médiane (maximum) | Coût par bonne réponse, heures pleines |
|---|---|---|---|---|
| V4 Flash 0731 | low | 33/33 | 492 (6,444) | $0.00131 |
| V4 Flash 0731 | high (par défaut) | 33/33 | 433 (9,172) | $0.00163 |
| V4 Flash 0731 | max | 33/33 | 453 (24,010) | $0.00343 |
| V4 Flash 0731 | sans thinking | 21/33 | 0 | $0.00083 |
| V4.1 Flash | low | 33/33 | 316 (6,153) | $0.00097 |
| V4.1 Flash | high (par défaut) | 33/33 | 391 (13,300) | $0.00149 |
| V4.1 Flash | max | 33/33 | 391 (11,037) | $0.00129 |
| V4.1 Flash | sans thinking | 21/33 | 0 | $0.00050 |
| V4 Pro | low | 33/33 | 309 (6,398) | $0.00286 |
| V4 Pro | high (par défaut) | 33/33 | 548 (18,247) | $0.00768 |
| V4 Pro | max | 33/33 | 644 (15,920) | $0.00825 |
| V4 Pro | sans thinking | 21/33 | 0 | $0.00232 |
Avec thinking, aucun build n’a échoué sur la moindre tâche, quel que soit le niveau d’effort. Cette suite ne permet donc pas de les départager sur la précision, mais elle fait ressortir les écarts de coût et de vitesse. Par rapport à Pro, V4.1 Flash coûte 2.9x moins avec low, 5.2x moins avec le réglage high par défaut et 6.4x moins avec max. Par rapport à V4 Flash, il coûte 26% de moins avec low. En streaming et sans thinking, pour mesurer la génération de la réponse plutôt que la réflexion, V4.1 Flash a produit entre 121 et 134 tokens de sortie par seconde, avec 1.4 s entre la requête et le premier token. V4 Flash a atteint 86 à 94 tokens par seconde, avec 2.3 s avant le premier token, et Pro 46 à 49 tokens par seconde, avec 1.9 s avant le premier token. Dans une boucle de function calling sur deux tours, chaque build a effectué exactement un appel par tour. Sur les deux étapes, V4.1 Flash a utilisé 27 puis 13 reasoning tokens, V4 Flash 30 puis 19, et Pro 61 puis 29, pour un coût par étape de $0.00019, $0.00030 et $0.00103. Cette suite ne couvre pas l’écart de connaissances visible dans le tableau de DeepSeek, notamment sur HLE et GPQA.
Que fait le réglage d’effort, et peut-on désactiver le thinking?
Le réglage modifie le coût sur quelques tâches, mais jamais la réponse. Désactiver le thinking fait perdre 12 réponses sur 33 à chaque build. V4.1 Flash accepte les valeurs low, high et max pour reasoning_effort. DeepSeek associe minimal à low, et medium ainsi que xhigh à high. Sur neuf des onze tâches, les trois réglages restent à quelques centaines de reasoning tokens les uns des autres. Seule la tâche de comptage, qui porte sur des nombres à quatre chiffres soumis à trois contraintes, creuse l’écart: 5,650 tokens avec low, 9,714 avec high et 6,763 avec max, avec une réponse correcte dans tous les cas. Toutes les valeurs de thinking_budget comprises entre 0 et 1,024 ont été acceptées puis ignorées. Le réglage « continuously controllable reasoning effort setting (integer 1-100) » mentionné dans la fiche du modèle n’est pas disponible dans l’API: les entiers sont rejetés. V4 Pro et V4 Flash se comportent de la même façon, avec leurs propres volumes de tokens. C’est sur la tâche de comptage que max devient coûteux pour les anciens builds: 12,729 à 15,920 reasoning tokens sur Pro et 17,866 à 24,010 sur V4 Flash, pour obtenir la même bonne réponse que V4.1 Flash avec 6,763 tokens.
Voici les deux contrôles, ainsi que l’emplacement des valeurs mesurées dans la réponse:
resp = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="low",                    # "low" | "high" | "max"; default "high"
    extra_body={"thinking": {"type": "enabled"}},  # {"type": "disabled"} turns it off
    max_tokens=4096,                           # always set one: see the next section
)
usage = resp.usage
reasoning_tokens = usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content            # returned on every thinking call
Désactiver le thinking est le réglage le moins cher, mais aussi le plus risqué. Chaque build échoue sur un ensemble de tâches différent:
| Sans thinking, 11 tâches x 3 | V4 Flash 0731 | V4.1 Flash | V4 Pro |
|---|---|---|---|
| Bonnes réponses | 21/33 | 21/33 | 21/33 |
| Échec total (0 sur 3) | sac à dos, somme de nombres premiers, horaires de train | combinaisons de pièces, règle en 40 étapes, sac à dos | sac à dos, tâche de comptage |
| Mode d’échec | un nombre erroné au bon format (17, 1043; 10:40) | un seul token erroné (83 pour une chaîne de cinq étapes dont la réponse est 168) | affiche son raisonnement, puis donne une réponse erronée |
La chaîne en cinq étapes de notre jeu de tests standard est le cas le plus clair. Sans thinking, V4.1 Flash a répondu correctement 1 fois sur 3, puis 0 fois sur 3 lors d’une seconde série. V4 Flash a réussi 2 fois sur 3 et Pro 3 fois sur 3, car Pro écrit les étapes avant la réponse, contrairement aux builds Flash. Deux autres éléments ont un impact sur le budget. Le mode thinking ajoute un préfixe de template masqué facturé en entrée: 26 tokens de prompt sur V4.1 Flash et 79 sur V4 Flash et Pro, pour un texte identique qui compte 729 tokens sans thinking sur les trois modèles. Le reasoning_content renvoyé au tour suivant n’est pas facturé une seconde fois: 81 tokens de prompt avec ou sans ce contenu sur V4.1 Flash, et 134 sur Pro.
Que se passe-t-il si la question porte sur quelque chose qui n’existe pas?
Avec thinking, V4.1 Flash épuise la limite de sortie ou invente une réponse. Sans thinking, il refuse de répondre, avec plus de fiabilité que les deux autres builds. Nous avons posé cinq questions sur des entités que nous avions inventées. La seule bonne réponse était donc « je ne sais pas ». Les questions portaient sur le cours de l’action de « Verantis Dynamics », l’effectif du « Kessler-Fanning Institute », le point de fusion de « Oridium-7 » et le lauréat d’un « 1987 Pan-Continental Robotics Prize ». La limite était fixée à 16,384 tokens:
| Modèle, réglage | Refus de répondre | Réponse inventée | Limite de 16,384 tokens atteinte, aucune réponse | Reasoning tokens |
|---|---|---|---|---|
| V4.1 Flash, avec thinking | 0/5 | 2/5 (« Professor Frink des Simpsons a remporté le prix de 1987 »; « Oridium-7 a un point de fusion de 1815 °C ») | 3/5 | 2,610; 11,905; 16,384 x3 |
| V4.1 Flash, sans thinking | 5/5 | 0/5 | 0/5 | 0 (69 à 248 tokens de sortie) |
| V4 Flash 0731, avec thinking | 1/5 | 3/5 (« 0 employé »; « Oridium-7 est à environ 1065 °C »; « Montblanc, le robot suisse du manga Pluto, a gagné ») | 1/5 | 4,080 à 16,384 |
| V4 Flash 0731, sans thinking | 4/5 | 1/5 (« Oridium-7 a un point de fusion de… ») | 0/5 | 0 |
| V4 Pro, avec thinking | 1/5 | 3/5 (« Andrew Martin a gagné »; « 0 employé »; une plage de fusion de 899 à 949 °C) | 1/5 | 754 à 16,384 |
| V4 Pro, sans thinking | 3/5 | 2/5 (According to reference 844476, the Kessler-Fanning Institute had 247…) | 0/5 | 0 |
Trois des cinq exécutions de V4.1 Flash avec thinking ont coûté $0.0197 chacune aux heures pleines et renvoyé un message vide. Avec la limite de 2,048 tokens utilisée dans nos autres tests, les cinq ont fait de même, ainsi que quatre exécutions sur cinq avec Pro. Si une recherche peut légitimement ne produire aucune réponse, exécutez-la sans thinking, ou limitez max_tokens et traitez un message vide comme « inconnu ». L’échec de Pro sans thinking est différent et mérite sa propre regex: il écrit Let me check that reference for you. According to reference, puis invente un nombre.
La corruption JSON de V4 Flash est-elle corrigée?
Avec json_object, aucun build ne présente de problème à corriger. Nous n’avons pas pu le vérifier avec le mode strict json_schema. V4 Flash 0731 avait été lancé avec un défaut: l’association du thinking et d’un json_schema strict corrompait les champs entiers dans 8 exécutions sur 13. Sur V4.1 Flash, un json_schema strict a renvoyé une erreur 400 via notre chemin d’accès. Le guide JSON de DeepSeek documente uniquement {"type": "json_object"}.
Avec json_object, la même facture, comprenant le fournisseur, la date, le total et les lignes de facturation, a été renvoyée avec toutes les valeurs correctes dans 8 exécutions sur 8 avec thinking et 8 sur 8 sans thinking, sur les trois builds. En mode strict json_schema, V4 Pro continue à corrompre les données lorsque le thinking est activé: aucune des 8 exécutions n’avait le bon nombre de lignes de facturation, avec les valeurs 45, 12, 47, 1 et 2026, contre 8 sur 8 sans thinking. Pour l’extraction, json_object sans thinking a toujours produit le bon résultat sur chaque build. Sur V4.1 Flash, cette opération coûte 25 tokens de sortie.
Combien coûte une image sur V4.1 Flash?
184 tokens en entrée pour toute image jusqu’à 512x512, 652 pour un mégapixel et 994 pour quatre mégapixels. L’entrée image est une nouveauté dans la gamme Flash. Le build Vision Exp retiré était un modèle distinct, et V4 Flash 0731 accepte uniquement du texte. Nous avons donc envoyé des PNG générés à V4.1 Flash, puis soustrait le nombre de tokens du prompt texte seul:
| Image | Tokens de l’image | Coût aux heures pleines |
|---|---|---|
| 64x64, 128x128, 256x256, 512x512 | 184 | $0.000055 |
| 1024x1024 | 652 | $0.000196 |
| 2048x512 (même surface que 1024x1024) | 652 | $0.000196 |
| 512x2048 | 688 | $0.000206 |
| 2048x2048 | 994 | $0.000298 |
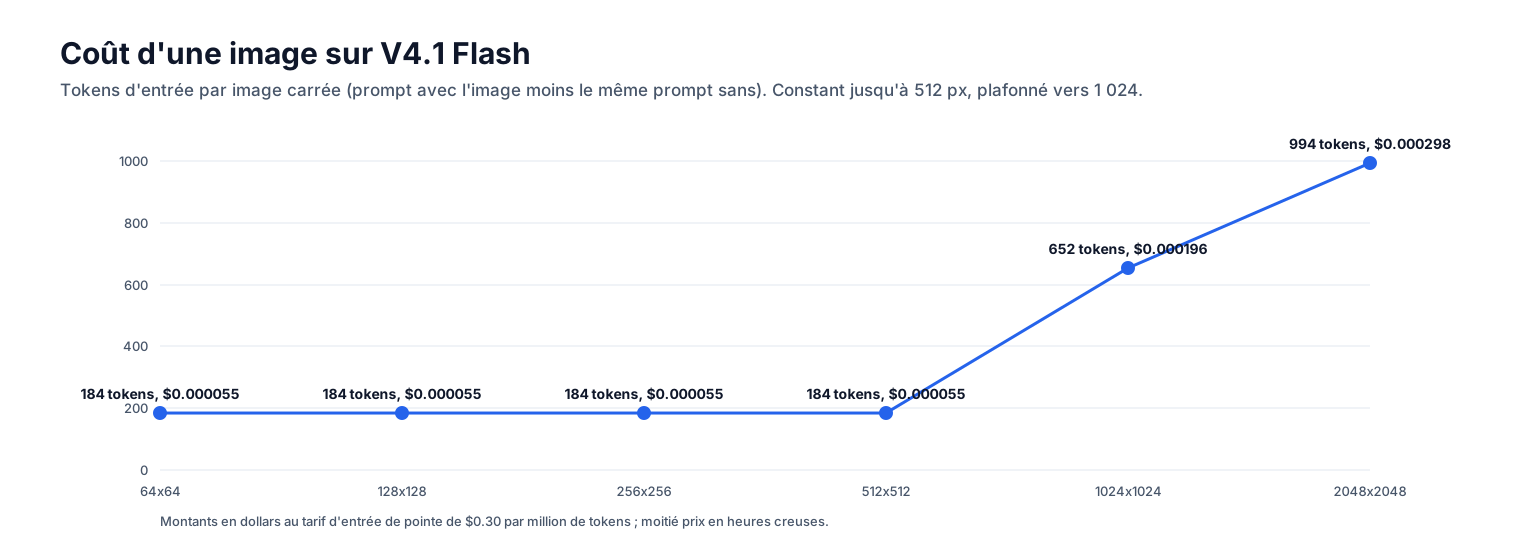
Le plancher correspond au guide de vision: « les images dont le nombre total de pixels est inférieur à environ 544x544 sont agrandies ». Les images plus grandes sont réduites « à une taille proche de celle d’une image de 1300x1300 », et la limite documentée est de 1,024 tokens par image. Le contenu, qu’il s’agisse d’un aplat, de bruit ou de texte rendu, et le format, PNG, JPEG ou WebP entre 174 et 243 KB, n’ont pas modifié le nombre de tokens. La facturation dépend donc de la géométrie, pas du nombre d’octets. Mille images d’un mégapixel coûtent $0.20 en tokens d’image aux heures pleines, avant de compter la question et la réponse.
Gestion par Synthorai
V4.1 Flash est exposé sous le nom deepseek-v4.1-flash sur la gateway, tandis que l’identifiant de DeepSeek est deepseek-flash. Il est facturé en permanence $0.30 par million de tokens en entrée et $1.20 par million en sortie, avec les lectures du cache à $0.03 par million et sans tarif aux heures creuses. Tous les chiffres de cet article utilisent le tarif catalogue de DeepSeek afin que vous puissiez appliquer vos propres horaires. V4 Flash 0731 et V4 Pro 0813 restent disponibles sous les noms deepseek-v4-flash-0731 et deepseek-v4-pro-0813, à leurs tarifs respectifs. Le modèle est accessible via /v1/chat/completions et /v1/responses. Sur ce chemin, thinking: {"type": "disabled"} désactive bien le thinking, et chaque appel avec thinking renvoie le texte de raisonnement dans reasoning_content. Les images sont transmises sous forme de parties de contenu image_url.
FAQ
DeepSeek V4.1 Flash est-il moins cher que V4 Flash?
Il est moins cher que le tarif d’août qu’il remplace, mais pas que le tarif de lancement de juillet. V4.1 Flash coûte $0.30/$1.20 par million aux heures pleines et $0.15/$0.60 aux heures creuses. V4 Flash coûtait $0.44/$1.32 aux heures pleines à partir de la mi-août, contre $0.14/$0.28 auparavant. Sur notre suite, chaque bonne réponse de V4.1 Flash avec low a coûté $0.00097, contre $0.00131 pour V4 Flash à son dernier tarif.
Peut-on désactiver le thinking sur DeepSeek V4.1 Flash?
Oui, avec thinking: {"type": "disabled"}. DeepSeek documente aussi reasoning_effort: "none". La précision baisse sur les tâches multi-étapes: V4.1 Flash est passé de 33 bonnes réponses sur 33 à 21 sur 33 dans notre suite, et a répondu à une chaîne de cinq étapes par un seul token erroné. Gardez le thinking activé pour l’arithmétique et la planification. Désactivez-le pour l’extraction et pour les recherches susceptibles de ne produire aucune réponse.
DeepSeek V4.1 Flash accepte-t-il les images, et combien coûte une image?
Oui, nativement. Sur V4.1 Flash, une image consomme 184 tokens en entrée jusqu’à 512x512, 652 à 1024x1024 et 994 à 2048x2048, quels que soient son contenu et son format. Cela représente entre $0.000055 et $0.000298 par image au tarif catalogue des heures pleines.
À lire aussi: coût de DeepSeek V4 Flash, DeepSeek V4 Pro GA face à la preview, contrôles du thinking des LLM, coût en tokens des images en entrée, sorties structurées des LLM.