
Prompt-A/B-Test: 10% Rollout deckt 1.9x höhere Kosten auf
10% des Produktivtraffics nach Session auf eine neue Prompt-Version verteilen. Gemessen: 8.0% von 200 Sessions, kein Versionswechsel und 1.94x Kosten pro Aufruf.
Unsere Empfehlungen
Live-Preise| Modell | Fazit | Preis |
|---|---|---|
| GPT-6 Luna v1 von support-answer kostete bei den 1,272 Aufrufen des Rollouts $0.000110 pro Aufruf, bei einer medianen Latenz von 4.9 s. Mit reasoning_effort none kostete es $0.000034. | Produktionsversion in der Demo | ab $0.1/Mio. |
| DeepSeek V4.1 Flash v3, derselbe Prompt auf diesem Modell, antwortete schneller (Median 3.1 s), kostete aber $0.000213 pro Aufruf, das 1.94-Fache von v1, weil es 1.6-mal so viele Ausgabe-Tokens zu einem höheren Preis pro Token erzeugte. | Kandidatenversion in der Demo | ab $0.3/Mio. |
Inhalt
- Wie gehen 10% des Produktivtraffics an eine neue Version?
- Welche Aufrufe gehen an den Kandidaten?
- Wie lassen sich die beiden Versionen vergleichen?
- Ändert sich das Ergebnis ohne Reasoning?
- Verfälschen Testläufe den Vergleich?
- Was wurde nicht untersucht?
- FAQ
- Wie teste ich einen Prompt per A/B-Test im Produktivbetrieb?
- Bleibt jede Unterhaltung während des Rollouts bei einer Version?
- Kann eine Prompt-Änderung die Kosten erhöhen, obwohl der Text gleich bleibt?
- Weiterführende Artikel
Bei der schrittweisen Einführung einer Prompt-Version geht ein Teil der Aufrufe einer Prompt-ID an einen neuen Kandidaten. Die übrigen Aufrufe bleiben bei der produktiven Version. So lassen sich beide mit echtem Traffic vergleichen, bevor alle Nutzer umgestellt werden. In der Prompt-Bibliothek von Synthorai wird dieser Rollout am Label production konfiguriert („v1, mit v3 bei 10%“). Das Gateway weist jedem Aufruf anhand der Session-ID eine Version zu. Eine Unterhaltung wechselt dadurch nicht mittendrin die Version. In unserem Durchlauf landeten bei eingestellten 10% insgesamt 16 von 200 Sessions (8.0%) beim Kandidaten. Jede Session blieb bei einer Version. Der Kandidat verwendete ein anderes Modell für denselben Prompt. Die Kosten dieser Änderung hatte vorher niemand gemessen. Schon beim Anteil von 10% zeigten die Summen pro Version, dass ein Aufruf dort 1.92-mal so viel kostete.
TL;DR
- Bei einem Rollout mit 10% erhielten 16 von 200 Sessions (8.0%, 95%-Intervall 5.0 bis 12.6%) den Kandidaten; bei 50% waren es 111 von 200 (55.5%).
- Alle 400 Sessions mit je drei Gesprächsrunden blieben bei einer Prompt-Version. Das galt auch für alle Endnutzer, die über
_user,userim Body odersafety_identifieridentifiziert wurden. - Der Kandidat nutzte denselben Prompt auf DeepSeek V4.1 Flash statt auf GPT-6 Luna. Er kostete $0.000213 statt $0.000110 pro Aufruf, bei einer medianen Latenz von 3.1 s statt 4.9 s.
- Aufrufe mit fest vorgegebenem
prompt_version=1landeten nie beim Kandidaten: 0 von 40.
Diese Anleitung baut auf Prompt-Versionierung auf. Dort werden die beiden Prompts und ihre Versionen eingerichtet. Im selben Verzeichnis von github.com/synthorai-io/use-cases:
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
Der Rollout lief am 19. Oktober 2026 und umfasste 1,840 Aufrufe. Die Verteilung nach Endnutzern wurde am 20. Oktober geprüft. Produktiv läuft v1 von support-answer auf GPT-6 Luna. Der Kandidat ist v3: derselbe Systemtext und dieselben Nachrichten auf DeepSeek V4.1 Flash. Nur das Modell ändert sich.
Wie gehen 10% des Produktivtraffics an eine neue Version?
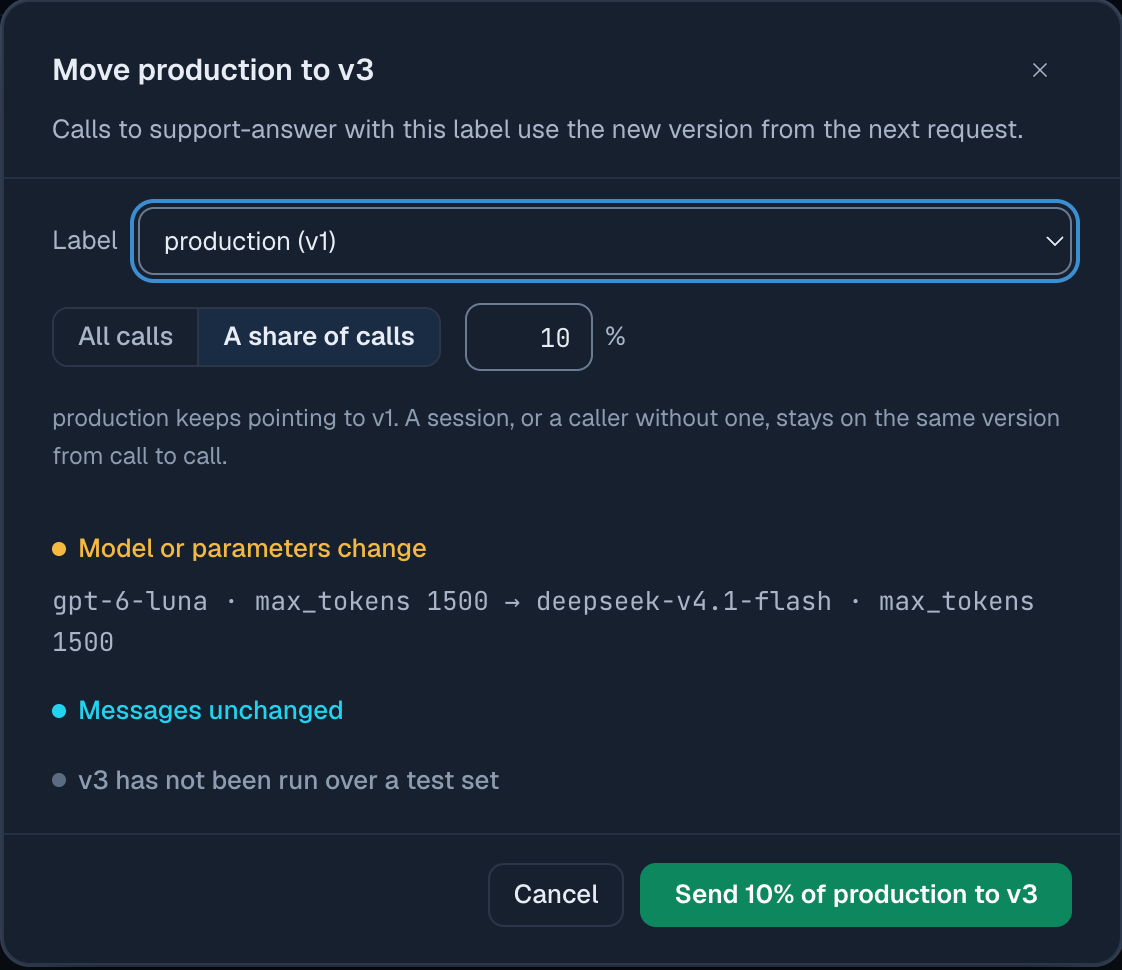
Dem Label production wird eine zweite Version mit einem Anteil zugewiesen. Mit einem Admin-Key genügt dafür ein Aufruf. Ein weiterer beendet den Rollout:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
Für aufrufende Clients ändert sich nichts: Sie rufen weiterhin support-answer ohne Versionsangabe auf. Der Response-Header X-Synthorai-Prompt-Version zeigt, welche Version den jeweiligen Aufruf beantwortet hat. Soll der Kandidat vollständig produktiv gehen, wird production auf ihn gesetzt. Damit endet der Rollout. In der Konsole heißt dieselbe Einstellung auf der Seite des Kandidaten „Schrittweise ausrollen“. Die Prompt-Liste zeigt das Label dann als „production v1 · v3 10%“.
Welche Aufrufe gehen an den Kandidaten?
Das Gateway wählt die Version für jeden Aufruf anhand eines stabilen Schlüssels. Solange der Anteil unverändert bleibt, erhält derselbe Schlüssel immer dieselbe Version. Verwendet wird der erste im Aufruf vorhandene Wert aus dieser Liste:
- die Session-ID (
X-Session-Id, der Header aus LLM-Agenten per Trace untersuchen); - der Endnutzer: das Label
_userinX-Synthorai-Metadata, andernfallsuserodersafety_identifierim Body oder Anthropicsmetadata.user_id; - fehlt all das: der Request selbst. Dann wird jeder Aufruf einzeln zugewiesen.
rollout.py prüfte jeden Fall mit 10% und 50% Anteil. Eine Session umfasste 3 Gesprächsrunden, ein Endnutzer 2 Aufrufe:
| Aufrufe | Bei 10%: auf v3 | Bei 50%: auf v3 | Bei einer Version geblieben |
|---|---|---|---|
200 Sessions, X-Session-Id | 16 = 8.0% (5.0 bis 12.6%) | 111 = 55.5% (48.6 bis 62.2%) | 400 von 400 Sessions |
50 Endnutzer, Label _user | 6 | 27 | 100 von 100 Nutzern |
| 100 Aufrufe ohne beides | 11 = 11.0% (6.3 bis 18.6%) | 49 = 49.0% (39.4 bis 58.7%) | nicht anwendbar |
20 Aufrufe mit festem prompt_version=1 | 0 | 0 |
Die Bereiche in Klammern sind 95%-Konfidenzintervalle. Sie geben an, in welchem Bereich der tatsächliche Anteil bei dieser Anzahl von Versuchen wahrscheinlich liegt. Jedes Intervall enthält den eingestellten Anteil. Ein separater Durchlauf mit 50% prüfte die beiden Body-Felder: 50 Nutzer wurden ausschließlich über user im Body identifiziert, 20 ausschließlich über safety_identifier, mit je 2 Aufrufen. Alle 70 blieben bei einer Version. Von den 50 Nutzern landeten 25 auf v3, von den 20 waren es 8.
Für den eigenen Rollout folgen daraus zwei Punkte. Eine Session-ID hält mehrteilige Unterhaltungen konsistent. Sie sollte deshalb bei jedem Aufruf einer Unterhaltung mitgeschickt werden. Ohne einen solchen Schlüssel kann derselbe Nutzer bei einem Aufruf v1 und beim nächsten v3 erhalten. Außerdem nehmen Aufrufe mit einer festen Version über prompt_version nicht am Rollout teil. Ein Test oder Batch-Job mit fester Versionsangabe erhält weiterhin genau diese Version.
Wie lassen sich die beiden Versionen vergleichen?
Die Prompts-Seite aggregiert Aufrufe, Fehler, Ausgaben, Token und Latenz pro Version. Die Requests API liefert dieselben Kennzahlen mit den Filtern prompt_id und prompt_version. Die Demo hat sie nach dem Rollout abgerufen:
| Version | Requests | Ausgaben | Ausgaben pro Aufruf | Mediane Latenz | Ausgabe-Token pro Aufruf, Mittelwert | Reasoning-Token pro Aufruf, Mittelwert |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3, DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
Reasoning-Token erzeugt ein Modell beim Nachdenken vor seiner Antwort. Sie werden als Ausgabe abgerechnet, erscheinen aber nicht in der Antwort.
Der Tab „Aufrufe“ des Prompts zeigt dieselben Arten von Summen. Im Zeitraum von 7 Tagen zählt er sämtliche Demo-Aufrufe jeder Version, nicht nur die des Rollouts. Seine Werte sind deshalb höher als die in der Tabelle.
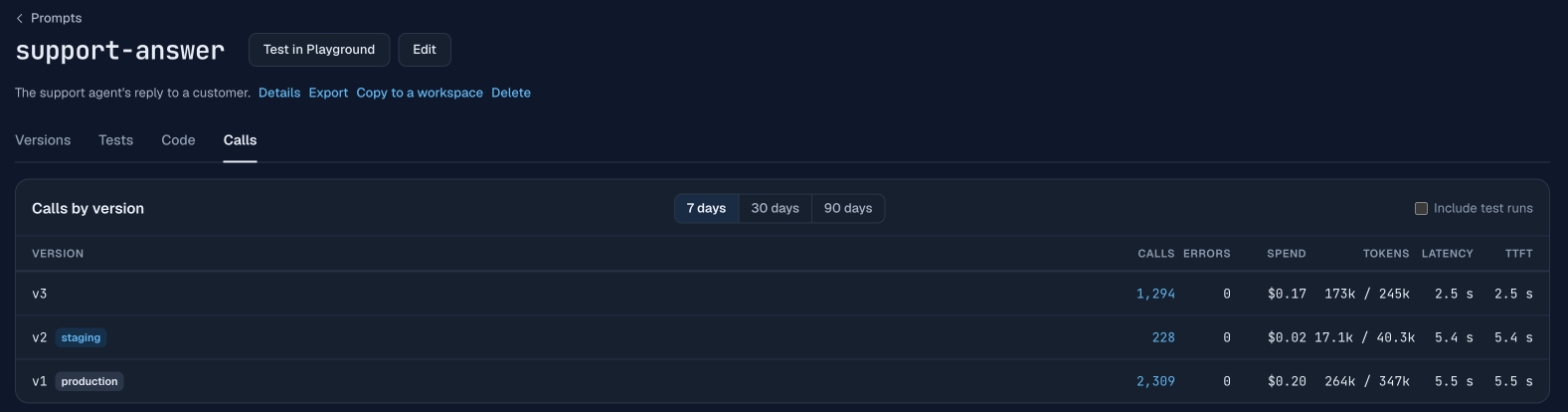
v3 ist schneller und kostet über den gesamten Durchlauf pro Aufruf 1.94-mal so viel. Dafür gibt es zwei Gründe. DeepSeek V4.1 Flash kostet auf diesem Gateway pro Token mehr als GPT-6 Luna: Im Nebentarif liegen die Preise pro Million Token bei $0.15 für die Eingabe und $0.60 für die Ausgabe, gegenüber $0.10 und $0.50. Außerdem erzeugte v3 1.6-mal so viele Ausgabe-Token. Der Unterschied entfiel fast vollständig auf Reasoning: 256 Reasoning-Token pro Aufruf gegenüber 149. Die eigentlichen Antworten waren dagegen 65 und 48 Token lang (Median). Keine dieser Zahlen ist dem Prompt-Text anzusehen. Der Unterschied zeigte sich schon beim Anteil von 10%: Die 71 von v3 beantworteten Aufrufe kosteten jeweils $0.000212, gegenüber $0.000111 für die 749 Aufrufe von v1, also 1.92-mal so viel.
Der Preis hängt auch von der Uhrzeit ab. Alle DeepSeek-Aufrufe des Rollouts liefen im Nebentarif des Gateways für dieses Modell (22:00 bis 08:00 Uhr Pekinger Zeit). Berechnet wurde die Hälfte des Haupttarifs von $0.30 und $1.20. Der Durchlauf mit 140 Aufrufen am 20. Oktober lag im Haupttarif. Dort kostete v3 bei 66 Aufrufen $0.000394 pro Aufruf, v1 bei 74 Aufrufen $0.000107. Das entspricht dem 3.7-Fachen.
Von den 1,840 Aufrufen lieferten 1,839 den Status 200 zurück. Bei einem Aufruf trat im Client nach 300 s ein Timeout auf; er zählt als Fehler. Die übrigen Gesprächsrunden seiner Session wurden trotzdem ausgeführt.
Ändert sich das Ergebnis ohne Reasoning?
Ohne Reasoning sinken die Kosten beider Versionen um mindestens zwei Drittel. v3 wird dadurch aber nicht zur günstigeren Version. effort.py rief jede Version 50-mal ohne reasoning_effort und 50-mal mit vom Client gesetztem reasoning_effort: "none" auf. Als Eingaben dienten die Kundennachrichten aus dem Testdatensatz in Prompts vor dem Produktiveinsatz testen. Sie enthalten alle eine Bestellnummer (40 Nachrichten, davon 10 doppelt):
| Version | reasoning_effort | Kosten pro Aufruf | Ausgabe-Token, Mittelwert | Mediane Latenz | Antwort enthält Bestellnummer | Als Beantwortung der Frage bewertet |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | Standard | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1, GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3, DeepSeek V4.1 Flash | Standard | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3, DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
„none“ schaltete Reasoning bei beiden Modellen vollständig ab. Die Kosten pro Aufruf sanken bei v1 um 68% und bei v3 um 75%. Soweit sich das mit 50 Aufrufen beurteilen lässt, blieb die Antwortqualität erhalten: Jede Antwort enthielt weiterhin die Bestellnummer. Bei der modellgestützten Prüfung änderte sich das Ergebnis um 2 beziehungsweise 4 von 50 Antworten. Diese Prüfung nutzt einen Aufruf von Claude Sonnet 5.5, um zu bewerten, ob die Antwort auf die Kundenfrage eingeht. Der exakte Test nach Fisher ergab p = 0.82 und 0.44. Er liefert die Wahrscheinlichkeit für einen mindestens so großen Unterschied, wenn „none“ keinen Einfluss hätte. Bei so hohen Werten lässt sich die Änderung durch Zufall erklären. Mit „none“ auf beiden Versionen kostete v3 pro Aufruf weiterhin 1.44-mal so viel wie v1 ($0.000049 gegenüber $0.000034). Auch diese Aufrufe liefen im DeepSeek-Nebentarif des Gateways.
Während eines Rollouts weiß der Client nicht, welche Version antworten wird. Ein mitgesendetes reasoning_effort gilt deshalb für beide. Die Einstellung kann stattdessen in der Version hinterlegt werden: Eine Version kann reasoning_effort speichern. Das Gateway übernimmt den Wert in Requests an Chat Completions und Responses, sofern der Aufruf selbst keine Reasoning-Einstellung vorgibt. Ein so gespeicherter Kandidat bringt seine eigene Einstellung in den Rollout mit. Die Kennzahlen pro Version vergleichen dann die Versionen so, wie sie produktiv eingesetzt würden.
Verfälschen Testläufe den Vergleich?
Standardmäßig nicht, denn die Kennzahlen einer Version auf der Prompts-Seite schließen Testtraffic aus. Dazu zählen Playground-Aufrufe einschließlich der Testläufe in der Konsole sowie Aufrufe mit source: prompt-test oder source: eval in X-Synthorai-Metadata. Über „Testläufe einbeziehen“ werden sie mitgezählt. Bei support-answer kamen dadurch für v1 und v2 jeweils 150 Aufrufe hinzu: je 110 aus einem entsprechend markierten Evaluationslauf und je 40 aus einem Testlauf in der Konsole. v3 blieb unverändert. Logs und Requests API führen weiterhin jeden Aufruf auf. Falls während des Rollouts eine Evaluation lief, muss dort nach dem Label gefiltert werden:
X-Synthorai-Metadata: {"source":"eval"}Was wurde nicht untersucht?
- Statistische Tests für Kosten und Latenz. Die Tabelle oben vergleicht Summen und Mittelwerte pro Version. Die Unterschiede haben wir nicht statistisch getestet. Bevor aus einem Unterschied Konsequenzen gezogen werden, sollte er getestet werden, besonders wenn er klein ist.
- Antwortqualität im Live-Traffic. Ein Rollout zeigt, was eine Version kostet und wie schnell sie ist. Ob ihre Antworten richtig sind, lässt sich vor dem Rollout leichter mit festen Eingaben prüfen. Prompts vor dem Produktiveinsatz testen zeigt das für v2.
- Automatischer Abbruch. Die Demo beendet keinen Rollout automatisch, wenn Fehlerrate oder Kosten des Kandidaten einen Grenzwert überschreiten. Ein Admin ändert den Anteil, setzt das Label auf den Kandidaten oder stoppt den Rollout.
FAQ
Wie teste ich einen Prompt per A/B-Test im Produktivbetrieb?
Dem produktiven Label werden eine Kandidatenversion und ein Anteil zugewiesen. Die Prompt-ID wird wie bisher aufgerufen. Anschließend werden die aggregierten Kennzahlen beider Versionen verglichen. In der Demo gingen bei einem Anteil von 10% insgesamt 16 von 200 Sessions an den Kandidaten. Nach einigen Hundert Aufrufen waren seine Kosten in den Summen sichtbar.
Bleibt jede Unterhaltung während des Rollouts bei einer Version?
Wenn die Aufrufe eine Session-ID enthalten, bleibt die Unterhaltung bei einer Version. Alle 400 Sessions der Demo nutzten über ihre drei Gesprächsrunden hinweg dieselbe Version. Ohne Session-ID wird die Endnutzerkennung verwendet. Fehlt auch diese, wird jeder Aufruf einzeln zugewiesen.
Kann eine Prompt-Änderung die Kosten erhöhen, obwohl der Text gleich bleibt?
Ein Modellwechsel bei unverändertem Text kann das, wie die Demo zeigt. Der Kandidat auf DeepSeek V4.1 Flash kostete pro Aufruf 1.94-mal so viel wie die Version auf GPT-6 Luna. Auf diesem Gateway war der Preis pro Token höher, und das Modell verbrauchte mehr Token für Reasoning. Verglichen werden sollten die Kosten pro Aufruf der gesamten Version, nicht nur der Modellpreis.
Weiterführende Artikel
- Prompt-Versionierung: Prompts per ID aufrufen und Labels umsetzen.
- Prompts vor dem Produktiveinsatz testen: Testdatensätze und Prüfungen, mit v2 im Vergleich zu v1.
- Warum ist mein LLM-Agent so teuer?: vier weitere Ursachen für hohe Kosten, anhand von Traces gefunden.
- Anleitung zur Prompt-Bibliothek: Rollout, Statistiken pro Version und sämtliche Felder.