
Prompt-Versionierung: Änderungen in unter 10 s, ohne Redeploy
LLM-Prompts in einer Bibliothek verwalten, per prompt_id aufrufen und per Label umschalten. Gemessen: 8 bis 9 s bis zum Live-Aufruf, dieselben 114.5 Prompt-Tokens wie inline.
Unsere Empfehlungen
Live-Preise| Modell | Fazit | Preis |
|---|---|---|
| GPT-6 Luna v1 und v2 von support-answer bereitgestellt. Ein Aufruf per Prompt-ID sendete dieselben 114.5 Prompt-Tokens (Median aus 20 Paaren) wie die inline gesendete gerenderte Anfrage. | Modell für den Antwort-Prompt der Demo | ab $0.1/Mio. |
| DeepSeek V4.1 Flash policy-check v1 mit einem in der Version gespeicherten Ausgabeschema ausgeführt: eine JSON-Antwort mit 18 Ausgabe-Tokens für $0.000033, wobei reasoning_effort auf none gesetzt war. | Modell für die JSON-Prüfung der Demo | ab $0.3/Mio. |
Inhalt
- Wie ruft man einen Prompt per ID auf?
- Kostet ein Aufruf per ID mehr als ein Prompt im Code?
- Wie schnell kommt eine Label-Änderung bei den Aufrufen an?
- Was passiert, wenn ein Aufruf nicht ausgeführt werden kann?
- Was kann eine Version außer dem Text speichern?
- Wo sieht man, welche Version einen Aufruf beantwortet hat?
- Was wird hier nicht behandelt?
- FAQ
- Was ist Prompt-Versionierung?
- Verursacht der Aufruf per ID zusätzliche Latenz oder Tokens?
- Wie schnell erreicht eine Prompt-Änderung die Produktion?
- Kann ich das OpenAI SDK oder Anthropic SDK weiterverwenden?
- Weiterführende Artikel
Bei der Prompt-Versionierung liegen Prompts außerhalb des Codes als nummerierte, unveränderliche Versionen. Aufgerufen werden sie über eine ID. Welche Version in Produktion läuft, bestimmt ein Label. Ein Label ist ein benannter Zeiger wie production oder staging, der jeweils auf genau eine Version verweist. In der Prompt-Bibliothek von Synthorai gibt ein Request den Prompt über prompt_id an. Das Gateway ergänzt die Nachrichten, das Modell und die Parameter der Version. Wird das Label production verschoben, verwenden die nächsten Aufrufe die neue Version. In unseren Tests kam die Änderung bei gleichmäßigem Traffic nach 8 bis 9 Sekunden an, nach einer Ruhephase schon beim ersten Aufruf. Ein Aufruf per ID sendete exakt so viele Prompt-Tokens wie derselbe Request mit direkt im Code hinterlegtem Prompt.
TL;DR
- Ein Aufruf per
prompt_idan das Synthorai-Gateway sendete über 20 Messpaare hinweg im Median 114.5 Prompt-Tokens, genauso viele wie der Inline-Request. - Bei gleichmäßigem Traffic erreichte eine Änderung am Label
productiondie Aufrufe nach 8.0 bis 8.5 s (Median), nach 15 s ohne Aufrufe dagegen sofort. - Bei 20 Label-Änderungen erhielt kein Aufruf mehr die alte Version, nachdem erstmals die neue Version ausgeliefert worden war.
- Nicht ausführbare Aufrufe scheiterten mit 400 oder 404, bevor ein Modell lief. Sie wurden nicht berechnet.
Diese Anleitung verschiebt die Prompts des Support-Agenten aus LLM-Agenten nachvollziehen in die Bibliothek und ruft sie auf allen vom Gateway unterstützten Wegen auf. Der Code liegt unter github.com/synthorai-io/use-cases im Verzeichnis prompt-library/. Benötigt werden Python 3.10 oder neuer, ein Inference-Key und ein Admin-Key mit prompts.write aus der Konsole.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put both keys in it
cd prompt-library
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python setup.py         # saves the prompts and their versions; safe to run again
python call.py          # every way to call a prompt
python ship.py          # moves production and times it
python errors.py        # what a call that cannot be served answers
Die Messungen auf dieser Seite stammen vom 19. Oktober 2026. setup.py speichert zwei Prompts. support-answer übernimmt den Antwortschritt des Agenten und hat vier Versionen mit jeweils einer praxisnahen Änderung. policy-check ist eine Prüfung durch einen Subagenten, der JSON zurückgibt:
| Prompt | Version | Änderung | Modell |
|---|---|---|---|
support-answer | v1 | Ausgangsversion: Bestellnummer nennen, niemals ein Erstattungsdatum zusagen | GPT-6 Luna |
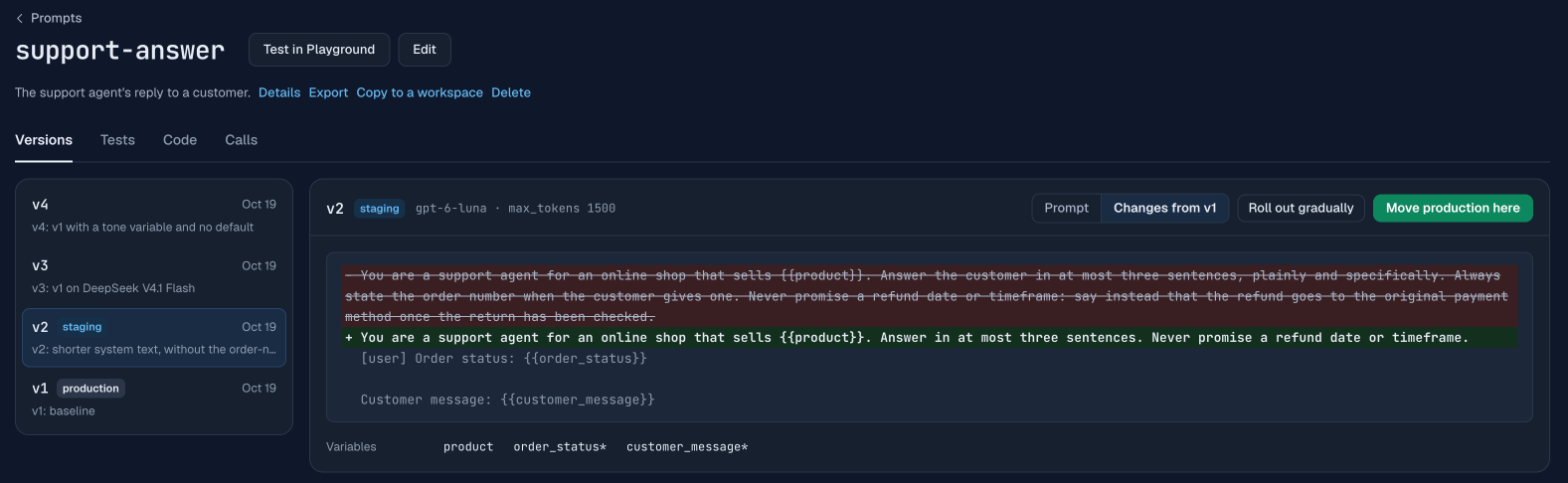
support-answer | v2 | kürzerer Systemtext ohne die Regel zur Bestellnummer | GPT-6 Luna |
support-answer | v3 | Text aus v1 mit einem anderen Modell | DeepSeek V4.1 Flash |
support-answer | v4 | v1 mit zusätzlicher Variable {{tone}} ohne Standardwert | GPT-6 Luna |
policy-check | v1 | Themen und Risikostufe als schemakonformes JSON | DeepSeek V4.1 Flash |
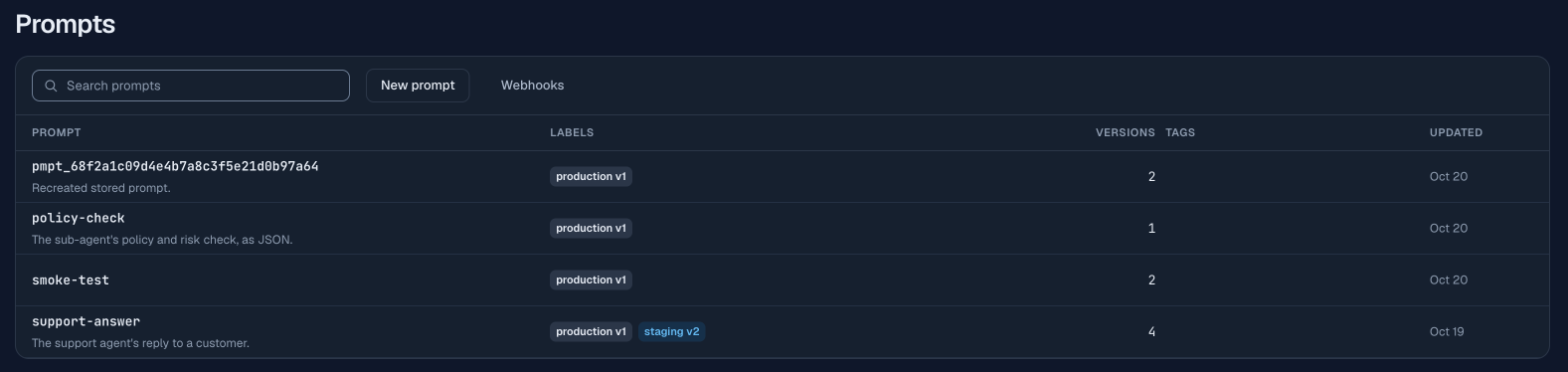
production zeigt auf v1, staging auf v2. Um v2 und v3 geht es in den beiden Folgeanleitungen: Eine Version vor der Freigabe testen und Eine Version für einen Teil des Produktionstraffics ausrollen. Die Konsole zeigt jede Version im Vergleich zur vorherigen:
Wie ruft man einen Prompt per ID auf?
An einen normalen Request an /v1/chat/completions, /v1/responses oder /v1/messages werden im Body prompt_id und prompt_variables angehängt. Eine Variable ist ein Platzhalter wie {{name}} im Text der Version. prompt_variables liefert für jeden Platzhalter den Wert für diesen Aufruf. Die SDKs verlangen ein Modell und eine Nachricht. Deshalb sendet man einen beliebigen Modellnamen und eine leere Nutzernachricht: Das Gateway verwendet das Modell der Version und entfernt die leere Nachricht. Beim OpenAI Python SDK kommen die zusätzlichen Felder in extra_body:
import os
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key=os.environ["SYNTHORAI_API_KEY"])

raw = client.chat.completions.with_raw_response.create(
    model="any",                                   # the version's model is used
    messages=[{"role": "user", "content": ""}],    # required by the SDK; dropped
    extra_body={
        "prompt_id": "support-answer",
        "prompt_variables": {
            "customer_message": "Where is order A-50977? It has been a week.",
            "order_status": "in transit, shipped on 2026-10-01",
        },
    },
)
print(raw.headers["x-synthorai-prompt-version"])   # which version answered
print(raw.parse().choices[0].message.content)
product fehlt im Aufruf, weil die Version dafür den Standardwert „home electronics“ vorgibt. Der Response-Header X-Synthorai-Prompt-Version gibt an, welche Version geantwortet hat. Bei einem Aufruf per Label ist das für den Aufrufer die einzige Möglichkeit, die verwendete Version festzustellen.
Ohne Versionsangabe verwendet ein Aufruf die Version, auf die production zeigt. Über zwei Felder lässt sich eine andere auswählen. Ein Aufruf darf eines davon senden, nicht beide:
| Feld | Beispiel | In der Demo verwendete Version |
|---|---|---|
| keines | v1 (production) | |
prompt_label | "staging" | v2 |
prompt_version | 1 | v1 |
Derselbe Aufruf per ID funktionierte an allen drei Endpoints: Chat Completions und Responses über das OpenAI SDK, Messages über das Anthropic SDK mit demselben extra_body. Alle drei verwendeten v1 mit GPT-6 Luna. Bei Responses landen die Nachrichten der Version in input. Die Anleitung zur Prompt-Bibliothek beschreibt die Zuordnung aller Felder je Endpoint.
Kostet ein Aufruf per ID mehr als ein Prompt im Code?
Ein Aufruf per ID kostet genauso viel wie der vollständig im Code formulierte Request, denn das Gateway sendet einen normalen Request an den Anbieter. Wir haben das mit 20 Messpaaren geprüft. Für jedes Paar wurde der Prompt gerendert und der daraus entstandene Request inline gesendet. Anschließend wurden dieselben Werte per ID gesendet, wobei die Reihenfolge abwechselte. Beide Aufrufe eines Paars verwendeten denselben Salt, eine kurze zufällige Kennung in der Nachricht, damit keine zwei Paare denselben Request enthielten:
| Prompt-Tokens, Median | Client-Latenz, Median | |
|---|---|---|
Per prompt_id | 114.5 | 4.1 s |
| Inline | 114.5 | 4.6 s |
Die Token-Zahlen sind identisch. Der Aufruf per ID war schneller. Zusätzlicher Overhead kann diesen Unterschied nicht erklären, deshalb werten wir ihn als Schwankung zwischen einzelnen Aufrufen von GPT-6 Luna. Der Aufruf per ID verursachte somit keinen messbaren Zeitaufwand. Den Latenzunterschied haben wir nicht statistisch geprüft.
Um zu sehen, was ein Aufruf senden würde, ohne ein Modell aufzurufen, lässt sich der Prompt rendern. POST /v1/prompts/{id}/render nimmt dieselben Variablen entgegen und liefert den Request sowie die aufgelöste Version zurück:
curl https://synthorai.io/v1/prompts/support-answer/render \
  -H "Authorization: Bearer $SYNTHORAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"format": "chat", "prompt_variables": {"customer_message": "Where is order A-50977?", "order_status": "in transit"}}'
Das Rendern wird nicht berechnet und erscheint nicht in den Logs: Nach dem Render-Aufruf der Demo gab es dort keinen Request mit dessen Session-ID. Es zählt aber gegen das Rate-Limit des Keys.
Wie schnell kommt eine Label-Änderung bei den Aufrufen an?
In weniger als 10 Sekunden: In unseren Tests waren es bei laufendem Traffic 8 bis 9 s, nach einer Ruhephase gab es keine Wartezeit. Zum Freigeben einer Version reicht ein Aufruf mit einem Admin-Key, der ein Label auf eine Versionsnummer setzt:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})
admin.put("/prompts/support-answer/labels/production", json={"version": 3}).raise_for_status()
Für einen Rollback wird derselbe Aufruf mit der alten Versionsnummer ausgeführt. Der Code ruft weiter dieselbe ID auf, ein Redeploy ist nicht nötig. Nur Admins oder der Workspace-Eigentümer können ein Label verschieben. Jede Änderung wird im Audit-Log des Workspaces erfasst.
ship.py hat die Dauer gemessen. Das Skript sendete alle 0.5 s einen Aufruf, verschob production über die API und rief den Prompt weiter auf, bis der Header die neue Version zeigte, sowie weitere 10 s danach. Das geschah 5-mal von v1 auf v3 und 5-mal zurück. Anschließend wurden die 10 Änderungen jeweils nach 15 s ohne Aufrufe wiederholt:
| Fall | Sendezeit des letzten Aufrufs mit Antwort der alten Version | Sendezeit des ersten Aufrufs mit Antwort der neuen Version |
|---|---|---|
| Aufrufe alle 0.5 s, v1 auf v3 | Median 8.02 s nach der Änderung (7.53 bis 8.53) | Median 8.52 s (8.03 bis 9.03) |
| Aufrufe alle 0.5 s, v3 auf v1 | Median 7.52 s (7.52 bis 8.52) | Median 8.02 s (8.02 bis 9.02) |
| Nach 15 s ohne Aufrufe, beide Richtungen | keiner | 0.0 s bei allen 10 Änderungen |
Die Zeitmessung beginnt, sobald der API-Aufruf zur Label-Änderung zurückkehrt. Laut Dokumentation erreicht eine Änderung die Aufrufe in „etwa 10 Sekunden“. Die beiden Fälle passen dazu, dass das Gateway den gelesenen Label-Wert ab dem letzten Lesen einige Sekunden lang vorhält. Bei gleichmäßigem Traffic wird die Änderung sichtbar, sobald diese Kopie abläuft. Der erste Aufruf nach einer Pause liest das Label neu. Bei keiner der 20 Änderungen erhielt ein Aufruf noch die alte Version, nachdem erstmals die neue ausgeliefert worden war. Während der Verbreitung wechselten die Antworten also nicht zwischen den Versionen hin und her.
Was passiert, wenn ein Aufruf nicht ausgeführt werden kann?
Er scheitert vor jedem Modellaufruf mit 400 oder 404 im Fehlerformat des verwendeten Endpoints. Es wird nichts berechnet. errors.py hat fünf solche Aufrufe gesendet:
| Aufruf | Status | Code | Meldung |
|---|---|---|---|
v4 ohne tone | 400 | prompt_variable_missing | „prompt_variables: tone fehlt (weder Wert noch Standardwert vorhanden)“ |
| Version und Label zugleich | 400 | prompt_invalid | „prompt_version oder prompt_label senden, nicht beide“ |
| eine nicht vorhandene ID | 404 | prompt_not_found | „prompt_id: kein Prompt \“support-answer-missing\” in diesem Workspace“ |
| Version 99 | 404 | prompt_not_found | „Prompt \“support-answer\” hat keine Version 99“ |
| ein Label ohne Zielversion | 404 | prompt_not_found | „Das Label \“development\” des Prompts \“support-answer\” zeigt noch auf keine Version“ |
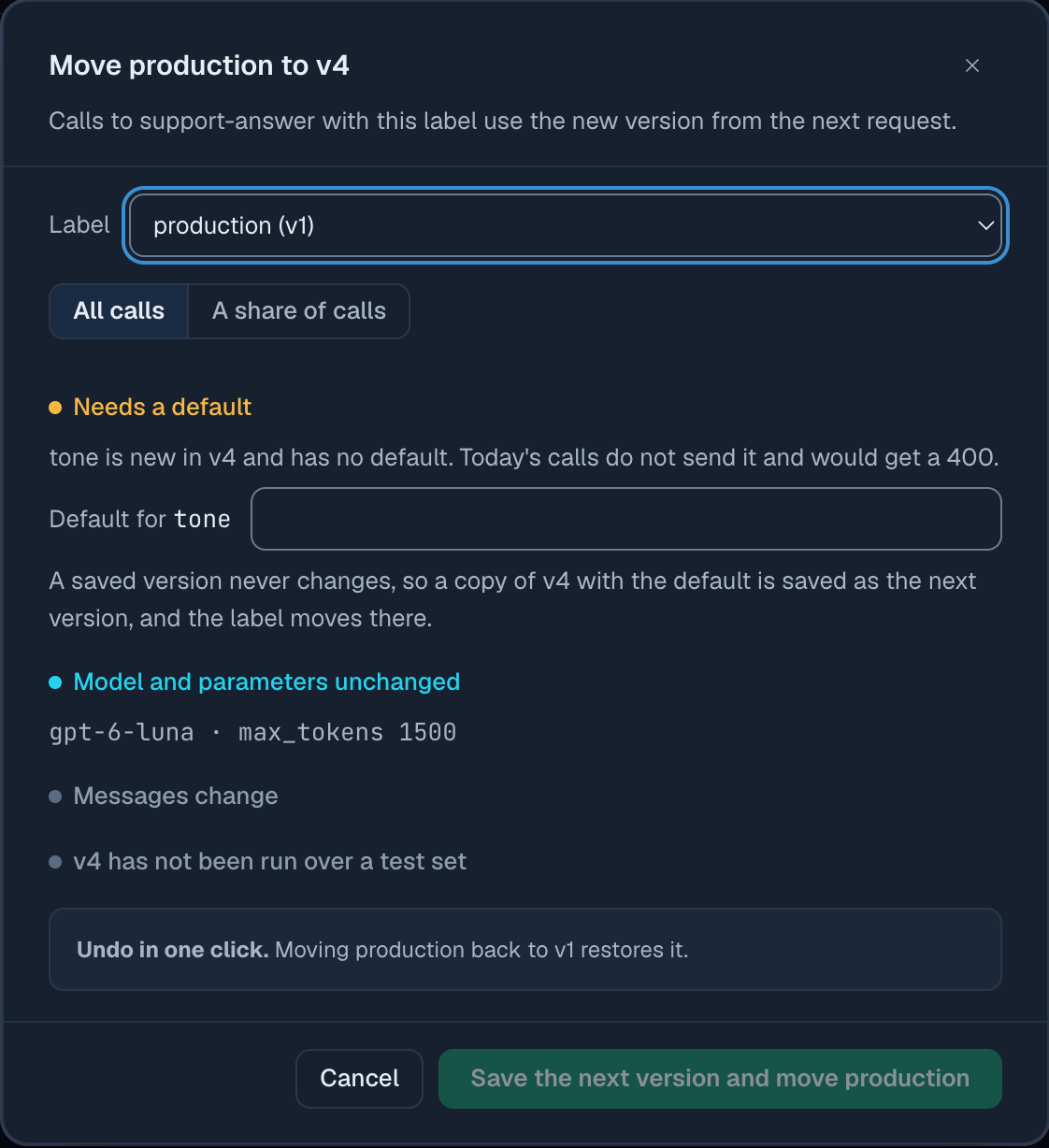
Für keinen der fünf Aufrufe gibt es einen Abrechnungseintrag. Die erste Zeile zeigt eine Änderung, die bestehende Aufrufe brechen würde: v4 fügt eine Variable ohne Standardwert hinzu. Jeder Aufruf ohne tone schlägt deshalb fehl. Die Konsole fängt das vor der Freigabe ab. Wer production auf v4 verschiebt, bekommt einen Dialog, der die Auswirkungen auf bestehende Aufrufe prüft und einen Standardwert verlangt. Mit diesem wird die nächste Version gespeichert.
Ist die Bibliothek vorübergehend nicht lesbar, verwendet das Gateway bis zu 24 Stunden lang die zuletzt gelesene Kopie und ergänzt die Antwort um X-Synthorai-Prompt-Stale: 1. Für einen Prompt ohne ausreichend aktuelle Kopie kommt 503 prompt_unavailable zurück; der Aufruf sollte wiederholt werden. Keiner der beiden Fälle trat in der Demo auf.
Was kann eine Version außer dem Text speichern?
Eine Version enthält den Systemtext, die Nachrichten, das Modell, fünf Parameter, ein Ausgabeschema und Function-Tools. Bei Parametern haben die Werte des Aufrufers Vorrang: temperature, max_tokens, top_p, response_format und reasoning_effort aus der Version gelten nur, wenn der Request das jeweilige Feld nicht selbst setzt.
policy-check speichert sein JSON-Schema in der Version. Aufrufer erhalten dadurch schemakonformes JSON, ohne ein Format mitsenden zu müssen. Beim Speichern über die API steht das Format in params und das Schema in schema:
version = {
    "model": "deepseek-v4.1-flash",
    "system": "You review messages to an online electronics shop's support desk. ...",
    "messages": [{"role": "user", "content": "{{customer_message}}"}],
    "params": {"max_tokens": 300, "response_format": "json_schema"},
    "schema": {"name": "policy_check", "strict": True, "schema": {
        "type": "object",
        "properties": {"topics": {"type": "array", "items": {"type": "string"}},
                       "risk": {"type": "string", "enum": ["low", "medium", "high"]}},
        "required": ["topics", "risk"], "additionalProperties": False}},
}
admin.post("/prompts/policy-check/versions", json={"body": version, "note": "v1: JSON check"}).raise_for_status()
Ein Schema ohne response_format: "json_schema" wird mit 400 und einer entsprechenden Meldung abgelehnt. Ein Aufruf von policy-check auf DeepSeek V4.1 Flash lieferte {"topics": ["shipping", "refunds"], "risk": "medium"} mit 151 Eingabe- und 18 Ausgabe-Tokens für $0.000033. Dabei sendete der Aufrufer reasoning_effort: "none", weil die Demo-Versionen gespeichert worden waren, bevor Versionen diesen Parameter aufnehmen konnten. Inzwischen lässt er sich in params speichern: Wir haben eine Testversion mit reasoning_effort: "none" gespeichert und gerendert. Der Request enthielt bei Chat Completions reasoning_effort und bei Responses reasoning.effort. Bei Messages wird der Wert aus der Version weggelassen, weil Claude-Modelle Thinking-Einstellungen in einer anderen Form erwarten. Dort müssen sie vom Aufrufer kommen.
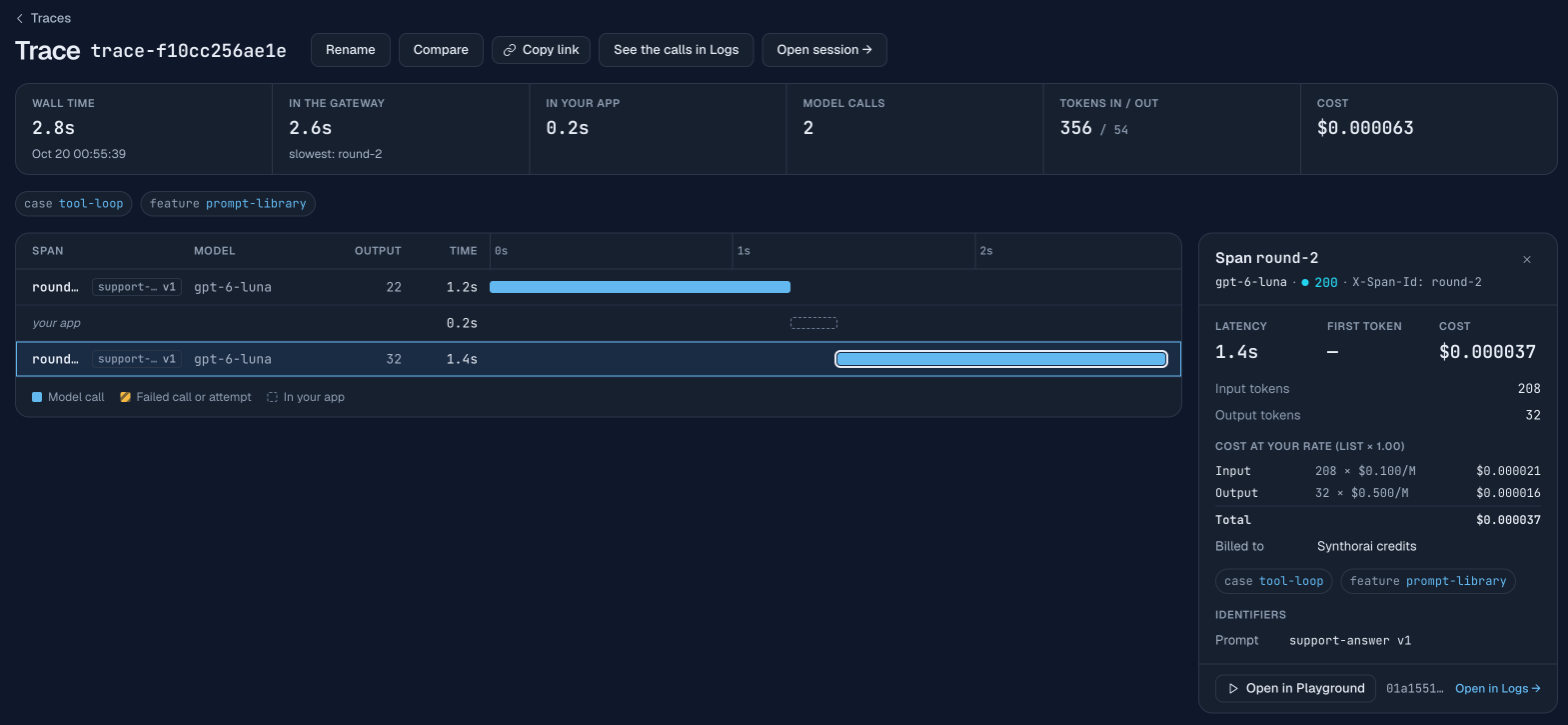
Tool-Aufrufe und mehrstufige Chats funktionieren genauso wie ohne Bibliotheks-Prompt. Zuerst kommen die Nachrichten der Version, danach die mitgesendete Konversation. In Runde 1 der Tool-Schleife der Demo forderte das Modell lookup_order({"order_id": "A-50977"}) an. Runde 2 sendete den Tool-Aufruf des Modells und das Tool-Ergebnis als normale Nachrichten unter derselben ID. v1 beantwortete die Anfrage anhand des Ergebnisses.
Wo sieht man, welche Version einen Aufruf beantwortet hat?
Zu jedem Aufruf werden Prompt und Version erfasst. Sie lassen sich an drei Stellen nachschlagen:
- In der Antwort: im Header
X-Synthorai-Prompt-Version, den die Demo in ihren Ergebnissen neben jedem Aufruf ausgibt. - In den Logs: Der Filter
prompt = support-answermitprompt_version = 3listet die Aufrufe dieser Version auf. Die Detailansicht eines Requests nennt Prompt und Version.GET /api/v1/requestsunterstützt dieselben Filterprompt_idundprompt_version. - In einem Trace: Jede Modellaufruf-Zeile im Wasserfalldiagramm trägt ein Badge „prompt vN“. Das Detailpanel des Aufrufs führt Prompt und Version auf. Die Tracing-Header aus LLM-Agenten nachvollziehen funktionieren bei Aufrufen per ID unverändert.
Die Prompts-Seite aggregiert Aufrufe, Fehler, Kosten, Tokens und Latenz pro Version über 7, 30 oder 90 Tage. Diese Ansicht verwendet die Rollout-Anleitung, um zwei Versionen im Live-Traffic zu vergleichen.
Was wird hier nicht behandelt?
- Rollouts und Tests. Wie ein Kandidat einen Teil des Produktionstraffics erhält, zeigt Eine Prompt-Änderung per A/B-Test prüfen. Tests mit einem festen Satz von Eingaben behandelt Einen Prompt vor der Freigabe testen.
- Partials. Ein einmal gespeicherter Textblock, der per
{{>id}}in mehrere Prompts eingebunden wird. Jede gespeicherte Version bindet die verwendete Version des Partials fest ein. - Webhooks für Änderungen. Ein signierter POST, sobald ein Prompt eine neue Version erhält oder ein Label verschoben wird, etwa zum Synchronisieren mit Git oder einem Chat-Kanal.
webhook.pyaus der Demo prüft eine Signatur, wir haben aber keine Live-Zustellung erhalten. - Idempotenz beim Anlegen. Der Header
Idempotency-Keymacht Wiederholungen sicher: Bei demselben Key liefert die API 24 Stunden lang die erste Antwort zurück, statt den Prompt doppelt anzulegen. Das gilt auch nach dem Löschen des Prompts. Zum erneuten Anlegen eines gelöschten Prompts ist deshalb ein neuer Key nötig.
FAQ
Was ist Prompt-Versionierung?
Bei der Prompt-Versionierung werden Prompts als nummerierte Versionen gespeichert, die sich nach dem Speichern nicht mehr ändern. Welche Version in Produktion verwendet wird, bestimmt ein Label statt einer Codeänderung. Für einen Rollback wird das Label auf die vorherige Version gesetzt.
Verursacht der Aufruf per ID zusätzliche Latenz oder Tokens?
In unseren 20 Messpaaren weder noch: Der Median lag auf beiden Wegen bei 114.5 Prompt-Tokens, und der Aufruf per ID war nicht langsamer. Das Gateway löst die Version auf und sendet einen normalen Request an den Anbieter.
Wie schnell erreicht eine Prompt-Änderung die Produktion?
Innerhalb von etwa 10 Sekunden. Bei laufendem Traffic wurde in unseren Tests der erste Aufruf mit Antwort der neuen Version 8.0 bis 8.5 s (Median) nach der Label-Änderung gesendet. Nach 15 s ohne Traffic war es sofort der nächste Aufruf.
Kann ich das OpenAI SDK oder Anthropic SDK weiterverwenden?
Beide SDKs funktionieren unverändert. Sie senden die Prompt-Felder über extra_body. Ein beliebiger Modellname und eine leere Nutzernachricht erfüllen dabei die Pflichtargumente der SDKs.
Weiterführende Artikel
- Anleitung zur Prompt-Bibliothek: alle Felder, Fehler und Response-Header dieser Seite.
- Prompts in der Konsole: Editor, Versionsvergleich und Dialog zum Verschieben von Labels.
- Eine Prompt-Änderung per A/B-Test prüfen: ein Rollout auf 10% des Traffics und der Vergleich pro Version.
- Einen Prompt vor der Freigabe testen: Testdatensätze, Prüfungen und die Aussagekraft eines einzelnen Testlaufs.
- LLM-Agenten nachvollziehen: die Session- und Trace-Header, die die Demo weiterhin mitsendet.