
Warum ist mein LLM-Agent teuer? Vier Ursachen im Trace
Vier Ursachen hoher Agent-Kosten, reproduziert und behoben: ein Timestamp ohne Cache-Treffer (0% auf 73%), wachsender Kontext, eine Retry-Schleife und das falsche Modell.
Unsere Empfehlungen
Live-Preise| Modell | Fazit | Preis |
|---|---|---|
| GPT-6 Luna Nachdem der Zeitstempel aus der ersten Zeile des Prompts verschoben wurde, wurden bei einem Kaltstart über vier Dialogrunden 4,157 von 5,729 Eingabetokens aus dem Cache gelesen. Mit dem Zeitstempel an erster Stelle wurde keines von 5,579 aus dem Cache gelesen. | Hauptagent in der Demo | ab $0.1/Mio. |
| DeepSeek V4.1 Flash Drei Prüfungen mit jeweils einem Satz kosteten $0.0010 auf GPT-6.1 Sol und $0.0001 auf diesem Modell. | Unteragent in der Demo | ab $0.3/Mio. |
Inhalt
- Wo fängt man an, wenn die Kosten höher sind als erwartet?
- Warum liegt die Cache-Trefferrate bei null?
- Warum sendet jede Runde mehr als die vorherige?
- Wie sieht eine Retry-Schleife aus?
- Wie erkennt man ein teures Modell bei einer einfachen Aufgabe?
- FAQ
- Wie finde ich heraus, welcher Teil meines LLM-Agenten am meisten kostet?
- Warum liegt meine Prompt-Cache-Trefferrate bei 0%?
- Warum trifft die erste Runde einer Unterhaltung den Cache nicht?
- Macht Prompt-Caching einen langen Gesprächsverlauf kostenlos?
- Wie viel spart Prompt-Caching?
- Wird eine Retry-Schleife als Fehler angezeigt?
- Weiterführende Artikel
Die Kosten eines Agenten steigen oft aus Gründen, die in einem einzelnen Request nicht auffallen: Ein Prompt trifft nie den Cache, eine Unterhaltung sendet mit jeder Runde mehr Daten, eine Schleife wiederholt dieselbe Arbeit oder ein teures Modell übernimmt eine Aufgabe, die auch ein günstiges erledigen könnte. Sobald die Aufrufe in Sessions und Traces gruppiert sind, werden diese Muster sichtbar. Dieser Leitfaden reproduziert alle vier in einem kleinen Support-Agenten, zeigt sie in der Synthorai-Konsole und stellt jeweils die Korrektur samt Kosten vorher und nachher vor.
TL;DR
- Ein Timestamp in der ersten Zeile des Prompts hielt die Cache-Trefferrate bei 0%. Am Ende des Prompts stieg sie auf 73%, und die Input-Kosten auf GPT-6 Luna sanken um 66%.
- Ein Verlauf, der jedes Tool-Ergebnis erneut mitsendete, verbrauchte dreimal so viele Input-Tokens. Die Input-Kosten stiegen nur um 21%, weil 71% aus dem Cache gelesen wurden.
- Eine Retry-Schleife verursachte 10 Modellaufrufe statt der nötigen 2, alle mit Status 200.
- Drei Sub-Agent-Aufrufe auf GPT-6.1 Sol machten 81% der Kosten einer Session aus.
Dieser Leitfaden baut auf LLM-Agenten mit Traces untersuchen auf. Dort werden die Request-Header erklärt, die Aufrufe zu Sessions und Traces zusammenfassen. Richte die Demo wie dort beschrieben ein (Python 3.10 oder neuer, virtualenv aktiviert). Führe anschließend die vier Fälle sowie replay-mismatch (eine weitere Ursache für ausbleibende Cache-Treffer) im selben Verzeichnis von github.com/synthorai-io/use-cases aus:
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
Jeder Fall läuft zweimal, erst mit dem Fehler und dann mit der Korrektur. Die Aufrufe erhalten die Labels case und variant. Die Zahlen stammen aus jeweils einem Durchlauf am 11. Oktober 2026. Weil die Demo so klein ist, liegen die Kosten im Bereich von Bruchteilen eines Cents. Auf reale Workloads lassen sich vor allem die Verhältnisse übertragen.
| Fall | Wo er sichtbar wird | Vorher | Nachher |
|---|---|---|---|
cache-miss | Cache-Trefferrate pro Runde auf der Session-Seite | 0% aus dem Cache, $0.0015 | 73% aus dem Cache bei einem Kaltstart (Cache noch leer), $0.0011 |
context-growth | Steigender Input pro Runde auf der Session-Seite | 24,546 Input-Tokens, $0.0011 Input-Kosten | 8,053 Input-Tokens, $0.0009 Input-Kosten |
replay-mismatch | Cache-Trefferrate bleibt auf der Session-Seite bei 0% | 0% aus dem Cache, $0.0038 | 76% aus dem Cache, $0.0015 |
retry-loop | Ein Trace mit deutlich mehr Aufrufen als für eine Runde nötig | 10 Aufrufe, $0.0004 | 2 Aufrufe, $0.0001 |
wrong-model | Agent-Tabelle auf der Session-Seite | $0.0012 | $0.0003 |
Wo fängt man an, wenn die Kosten höher sind als erwartet?
Öffne die Traces-Liste und sortiere sie nach Kosten. Jede Zeile zeigt eine Session oder einen Trace mit Anzahl der Aufrufe, Dauer und Kosten. Die teuersten Unterhaltungen stehen damit oben. Öffnest du einen Eintrag, kannst du erkennen, welches der folgenden Muster vorliegt.
Wenn du Requests mit X-Synthorai-Metadata kennzeichnest, grenze die Liste zuerst ein. Das Suchfeld der Traces-Liste unterstützt Labels: metadata.feature = support-agent zeigt nur die Sessions und Traces eines Features, metadata.case = cache-miss findet beide Durchläufe des entsprechenden Falls auf dieser Seite. Für aggregierte Zahlen gibt es im Tab „Breakdown“ von „Analytics“ die Karte „Cost by metadata“: Wähle einen Schlüssel aus, und sie zeigt Requests, Input-Tokens und Kosten für jeden seiner Werte.
Warum liegt die Cache-Trefferrate bei null?
Die Cache-Trefferrate liegt bei null, wenn sich bei jedem Request etwas am Anfang des Prompts ändert. Beim Prompt-Caching berechnet der Anbieter den wiederholten Anfang eines Prompts nur zu einem Bruchteil des Input-Preises. Das gilt aber nur bis zum ersten Token, das vom vorherigen Request abweicht. Die fehlerhafte Variante dieses Falls setzt die aktuelle Uhrzeit in die erste Zeile eines System-Prompts mit etwa 1,300 Tokens:
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
Bei einer Unterhaltung mit vier Runden auf GPT-6 Luna meldet die Session-Seite „Cache hit 0%“: 0 von 5,579 Input-Tokens. Die Korrektur verschiebt den veränderlichen Teil ans Ende:
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"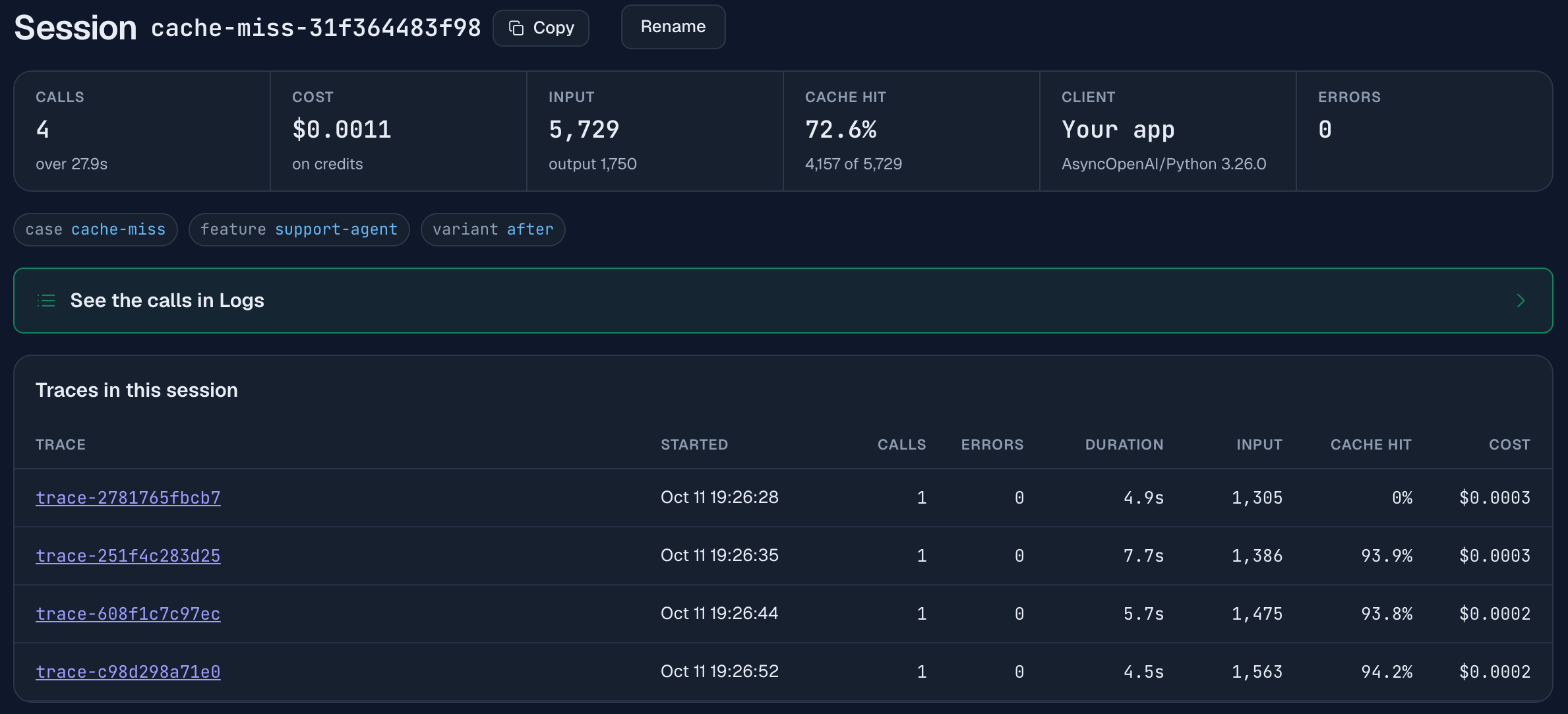
Die Session-Seite zeigt für jede Runde den Input und die Cache-Trefferrate. In der ersten Zeile steht 0%. Die erste Runde einer Unterhaltung kann keinen Eintrag lesen, den noch kein Request geschrieben hat. Sie schreibt also den Eintrag, liest aber nichts aus dem Cache. Die nächsten drei Runden lesen 1,302, 1,383 und 1,472 Tokens aus dem Cache. Das ist jeweils fast alles, was die vorherige Runde gesendet hat, und entspricht etwa 94% des jeweiligen Inputs. Über die gesamte Unterhaltung sind es 4,157 von 5,729 Input-Tokens, also 73%.
Die Einsparung betrifft den Input. Dieses Modell berechnet pro Million Tokens $0.10 für Input, $0.125 für Cache-Schreibvorgänge und $0.01 für Cache-Lesevorgänge. Bei einem langen Prompt wird fast alles entweder in den Cache geschrieben oder daraus gelesen.
Der fehlerhafte Durchlauf schrieb 5,567 Tokens in den Cache und las keine. Der korrigierte schrieb 1,560 und las 4,157. Dadurch sank der Input-Anteil der Rechnung von $0.00070 auf $0.00024, also um 66%. Die Session-Kosten gingen von $0.0015 auf $0.0011 zurück. Dieser Rückgang ist kleiner als beim Input allein, weil der Output den größeren Teil der Rechnung ausmacht und der korrigierte Durchlauf zufällig mehr Output erzeugte (1,750 Tokens gegenüber 1,599).
Wie viel du sparst, hängt davon ab, was beim Start einer Unterhaltung bereits im Cache liegt. Dieser Durchlauf begann mit leerem Cache, daher las die erste Runde nichts daraus. Ein Agent mit kontinuierlichem Traffic sollte mehr als 73% erreichen: Jede Unterhaltung beginnt mit demselben System-Prompt, und der Eintrag der vorherigen Unterhaltung ist noch vorhanden, solange die Requests vor seinem Ablauf eintreffen. Ein Prompt, den nur eine einzige Unterhaltung sendet, wird in der ersten Runde zum Schreibpreis berechnet.
Ein Timestamp ist der klassische Auslöser. Eine Request-ID, eine zufällige Begrüßung, ein in den ersten Absatz eingesetzter Benutzername oder anders angeordnete Tool-Definitionen haben denselben Effekt. Für einen Cache-Treffer müssen zwei weitere Bedingungen erfüllt sein: Das stabile Präfix, also der unveränderte Anfang des Prompts, muss länger sein als das Minimum des Anbieters (meist 1,024 Tokens, siehe Prompt-Caching). Außerdem sollten die Aufrufe einer Unterhaltung dieselbe X-Session-Id tragen. Damit sorgt das Gateway für konsistente Cache-Treffer innerhalb der Unterhaltung.
Warum sendet jede Runde mehr als die vorherige?
Jede Runde sendet mehr, weil sie den bisherigen Verlauf erneut überträgt. Ein gewisses Wachstum ist normal, denn der Verlauf wird länger. In der fehlerhaften Variante wächst er deutlich schneller: Jede Runde fragt die Kundendaten ab, erhält etwa 1,100 Tokens Bestellhistorie als JSON und speichert das Ergebnis im Verlauf. In Runde sechs werden dadurch sechs Kopien nahezu identischer Daten mitgesendet.
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]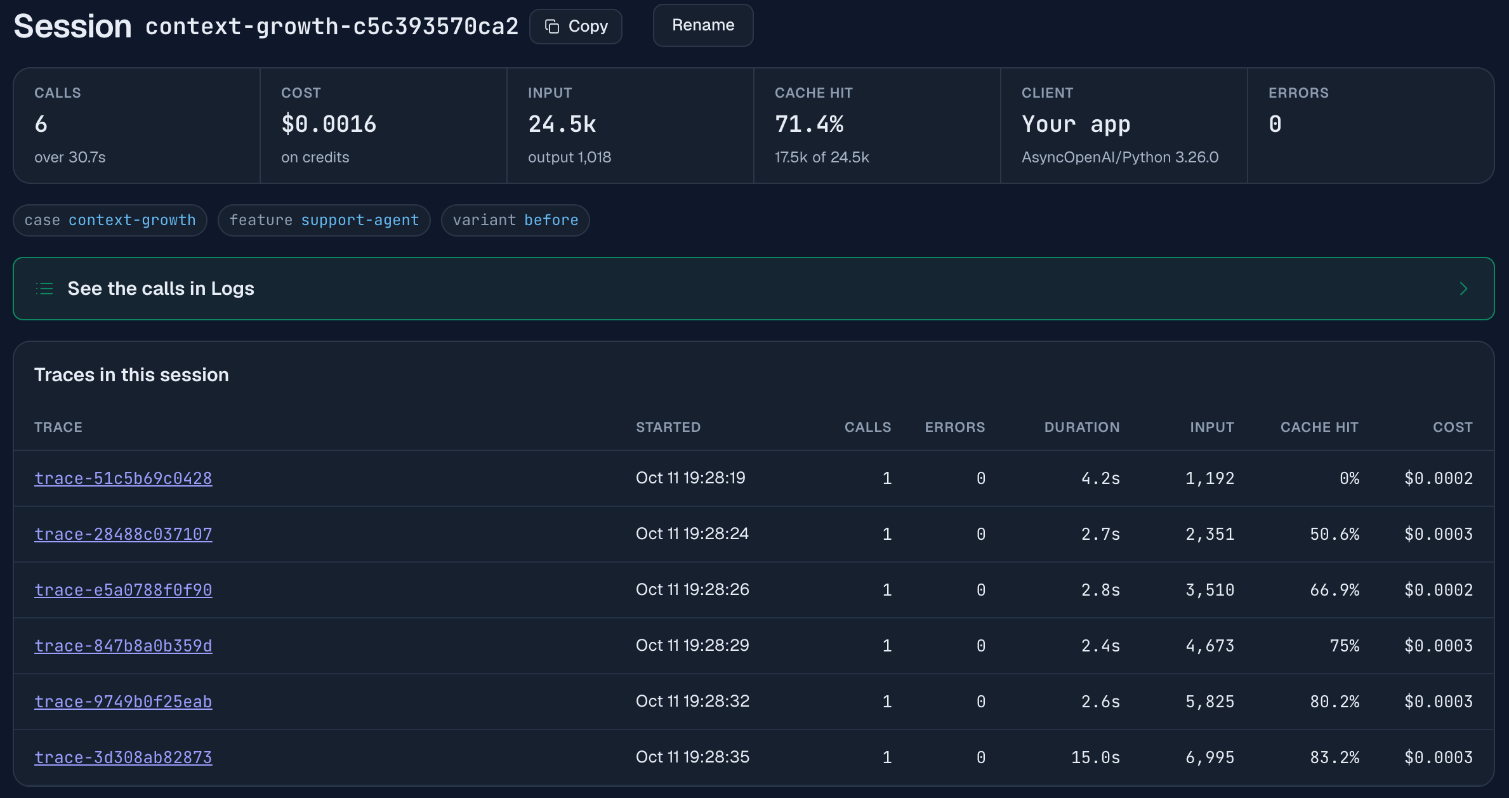
Erkennbar ist das an der Spalte „Input“ in der Tabelle „Traces in this session“: Pro Runde kommen etwa 1,160 Tokens hinzu, von 1,192 in der ersten Runde auf 6,995 in der sechsten. Die Antworten bleiben dagegen zwei Sätze lang. Die sechs Runden verbrauchten 24,546 Input-Tokens. In der korrigierten Variante erhält die aktuelle Runde weiterhin frische Kundendaten. Alte Abfrageergebnisse werden aber nicht gespeichert, weil die Antwort des Assistenten die relevanten Informationen bereits enthält. Damit benötigen die sechs Runden nur noch 8,053 Input-Tokens, also ein Drittel.
Die beiden Spalten neben „Input“ erklären, warum das Problem leicht unbemerkt bleibt. Die Cache-Trefferrate steigt mit dem Input, und die Kosten pro Runde bleiben bei $0.0002 bis $0.0003. Jede Runde beginnt mit dem vollständigen Prompt der vorherigen Runde. Diesen Teil liest der Anbieter aus dem Cache: 17,536 von 24,546 Input-Tokens, also 71%. Der Input der fehlerhaften Session kostete $0.0011, der der korrigierten $0.0009: dreimal so viele Input-Tokens für 21% höhere Input-Kosten.
Die Gesamtkosten dieser beiden Sessions lassen die Korrektur überhaupt nicht erkennen. Die fehlerhafte Session kostete $0.0016, die korrigierte $0.0017, weil der korrigierte Durchlauf zufällig mehr Output erzeugte (1,756 Tokens gegenüber 1,018). Der zusätzliche Output kostete etwa $0.0004, mehr als die beim Input eingesparten $0.0002. Vergleiche die Spalten „Input“ und „Cache hit“, auf die sich die Korrektur auswirkt, nicht die Gesamtkosten einer einzelnen Session.
Prompt-Caching kann also einen Großteil der Kosten eines wachsenden Verlaufs abfangen. Drei Dinge leistet es nicht:
- Es verkleinert den Kontext nicht. Runde sechs sendet weiterhin 6,995 Tokens. Eine lange Session erreicht trotzdem das Kontextlimit des Modells. Auch ein gecachtes Token wird berechnet, nur zum Cache-Preis.
- Es funktioniert nur, wenn der Verlauf exakt so erneut gesendet wird wie zuvor. Die Demo enthält dazu den Fall
replay-mismatch: Beim Senden wird an jede Benutzernachricht eine Anweisung angehängt, gespeichert wird die Nachricht aber ohne diese Anweisung. So entsteht in jeder Runde ein Prompt, den die vorherige Runde nie gesendet hat. Diese Unterhaltung las 0 von 24,557 Input-Tokens aus dem Cache und kostete $0.0038. Nachdem die Nachricht so gespeichert wurde, wie sie gesendet worden war, waren es 18,844 von 24,702 Tokens, also 76%, und $0.0015. - Es ist nicht bei jedem Modell verfügbar. Zum vollen Input-Preis von GPT-6 Luna, dem Modell in diesem Fall, kosten 24,546 Tokens $0.0025. Mit Cache wurden etwa $0.0011 berechnet. Prüfe die Spalte „Cache hit“, bevor du dich darauf verlässt.
Für deinen eigenen Agenten gilt: Tool-Ergebnisse sind meist der größte Teil des Verlaufs und bringen beim erneuten Senden am wenigsten. Behalte die darauf basierende Antwort oder eine einzeilige Zusammenfassung und entferne die Rohdaten. So sparst du bei jedem Modell, mit oder ohne Cache. Unser Chatbot-Leitfaden beschreibt die allgemeine Variante: ältere Runden zu einer Zusammenfassung verdichten.
Wie sieht eine Retry-Schleife aus?
Sie erscheint als einzelner Trace mit deutlich mehr Aufrufen, als eine Runde benötigen sollte, und wiederkehrenden Span-Namen. In diesem Fall ist die Tracking-API des Paketdienstes ausgefallen. Der Agent ruft sein Tool auf, erhält einen Timeout und antwortet, dass er den Standort des Pakets nicht abrufen kann. Anschließend prüft der Code, ob die Antwort einen Paketstandort nennt. Weil das nicht der Fall ist, führt er die gesamte Runde erneut aus, bis zu fünfmal:
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused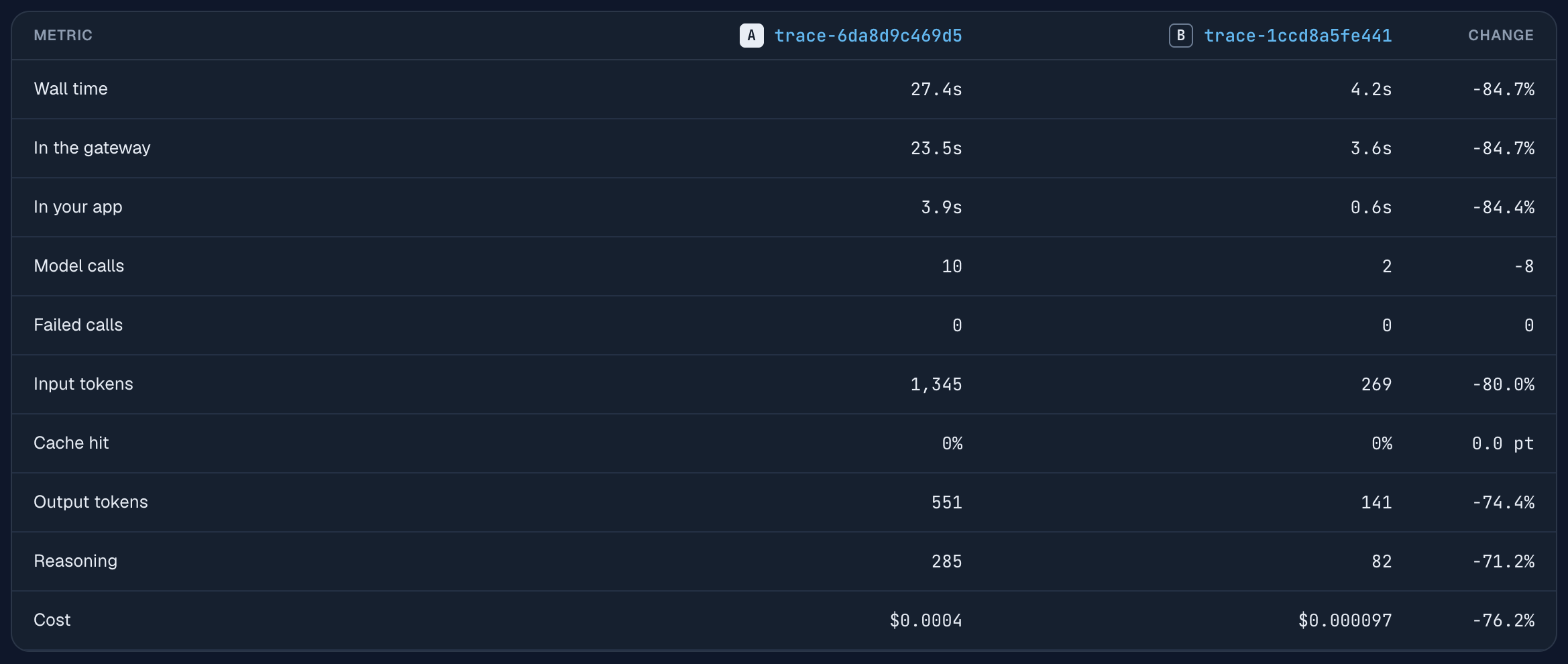
Das ist die Compare-Ansicht der beiden Durchläufe: Öffne einen Trace, wähle „Compare“ und dann den anderen Trace. Der fehlerhafte Durchlauf führte in 27.4 s insgesamt 10 Modellaufrufe für $0.0004 aus. Der Kunde bekam am Ende trotzdem dieselbe Antwort. „Failed calls“ steht auf beiden Seiten bei 0. Jeder Aufruf der Schleife war mit Status 200 erfolgreich, daher erscheint hier nichts als Fehler. Die korrigierte Variante unterscheidet einen Tool-Fehler von einer unzureichenden Antwort und wiederholt die Runde nicht, wenn das Tool das Problem ist: 2 Aufrufe, 4.2 s, $0.0001.
In der Waterfall-Ansicht des fehlerhaften Durchlaufs heißen die Aufrufe plan-1, answer-1, plan-2, answer-2 und so weiter. Benenne Spans wie hier nach Schritt und Versuch. Dann ist eine Schleife auf einen Blick erkennbar. Um unbekannte Schleifen zu finden, sortiere die Traces-Liste nach Anzahl der Aufrufe.
Wie erkennt man ein teures Modell bei einer einfachen Aufgabe?
Sieh dir die Tabelle „Agents in this session“ an. Sie schlüsselt Aufrufe und Kosten einer Session nach Agent auf. Die fehlerhafte Variante führt die drei Prüfungen des Sub-Agenten, jeweils mit einer Antwort von einem Satz, auf GPT-6.1 Sol aus. Dieses Modell kostet $2 pro Million Input-Tokens und $10 pro Million Output-Tokens. Der Hauptagent antwortet dagegen auf GPT-6 Luna:
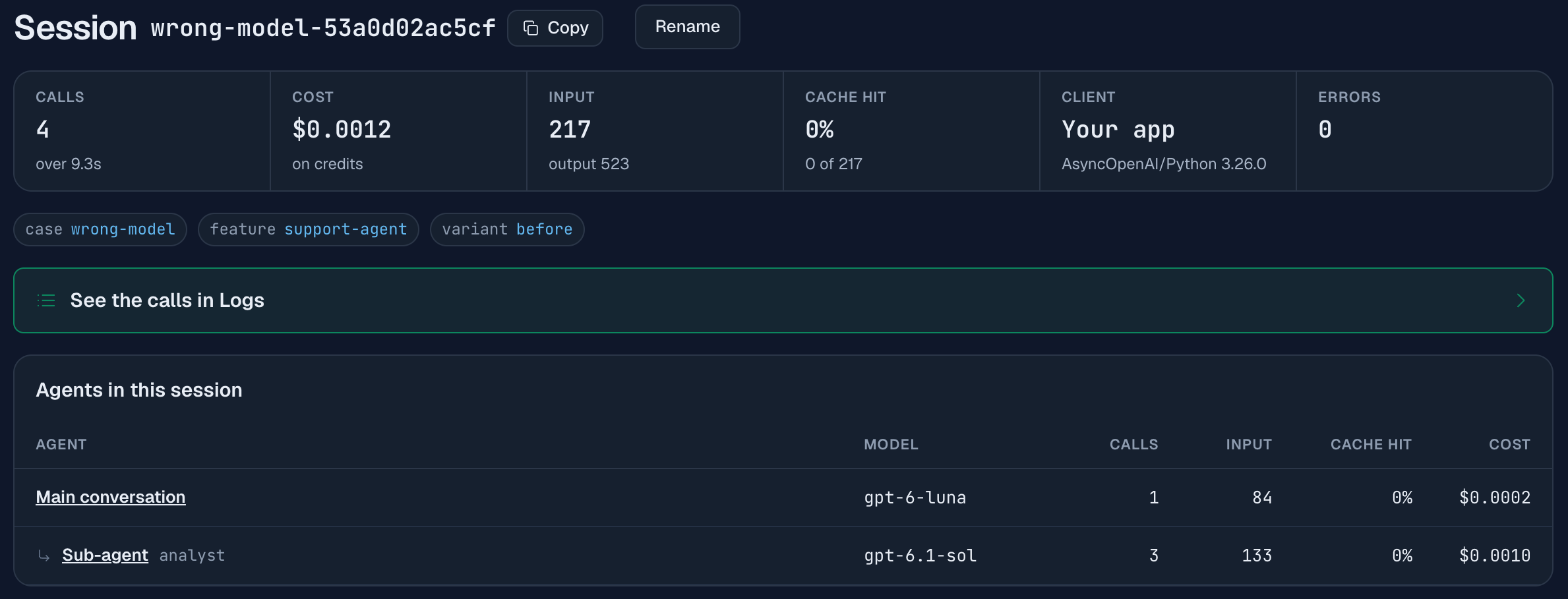
Die drei Aufrufe des Sub-Agenten kosteten $0.0010 von insgesamt $0.0012. Damit entfielen 81% der Rechnung auf die anspruchsloseste Arbeit des Durchlaufs. Dieselben drei Prüfungen auf DeepSeek V4.1 Flash kosteten $0.0001, die gesamte Session $0.0003. Beide Varianten führen die Prüfungen mit deaktiviertem Reasoning aus. Der Unterschied liegt also im Modellpreis.
Dieser Fall misst nur die Kosten. Wir haben die Qualität der Prüfungen nicht bewertet. Ein günstigeres Modell ist nur dann die richtige Wahl, wenn seine Antworten für den jeweiligen Schritt gut genug sind. Die Tabelle zeigt, wohin das Geld fließt und bei welchem Schritt sich ein Test mit einem günstigeren Modell lohnt.
Die Aufschlüsselung erscheint, wenn die Sub-Agent-Aufrufe X-Agent-Id tragen. Ohne diesen Header liefert die Tabelle „Models in this session“ eine Aufschlüsselung nach Modell. Diese entspricht nur dann der Aufschlüsselung nach Agent, wenn jeder Agent sein eigenes Modell verwendet. Für die Kosten eines Agenten über alle Sessions hinweg gibt es im Tab „Breakdown“ von „Analytics“ die Karte „Cost by agent“.
FAQ
Wie finde ich heraus, welcher Teil meines LLM-Agenten am meisten kostet?
Gruppiere seine Aufrufe mit Request-Headern in Sessions und Traces. Sortiere dann die Traces-Liste nach Kosten und öffne den obersten Eintrag. Die Session-Seite schlüsselt die Kosten nach Agent, Modell und Runde auf. Damit lässt sich ein Cache-Problem von einem Kontextproblem oder einer ungeeigneten Modellwahl unterscheiden.
Warum liegt meine Prompt-Cache-Trefferrate bei 0%?
Die häufigste Ursache ist ein veränderlicher Wert am Anfang des Prompts, etwa ein Timestamp. Das Caching reicht nur bis zum ersten abweichenden Token. In der Demo stieg die Cache-Trefferrate bei einem Kaltstart von 0% auf 73%, nachdem der Timestamp aus der ersten Zeile des System-Prompts ans Ende der Benutzernachricht verschoben wurde.
Warum trifft die erste Runde einer Unterhaltung den Cache nicht?
Die erste Runde trifft den Cache nicht, weil erst ein Request den Cache-Eintrag schreibt. Die erste Runde ist dieser Request. In der Demo lasen die vier Runden einer Unterhaltung 0%, 93.9%, 93.8% und 94.2% ihres Inputs aus dem Cache. Die erste Runde kann nur dann aus dem Cache lesen, wenn eine frühere Unterhaltung dasselbe Präfix gesendet hat und deren Eintrag noch nicht abgelaufen ist.
Macht Prompt-Caching einen langen Gesprächsverlauf kostenlos?
Nein, aber es kann einen Großteil der Kosten verbergen. In der Demo verbrauchte eine Unterhaltung, die alle alten Tool-Ergebnisse erneut sendete, dreimal so viele Input-Tokens wie die gekürzte Variante (24,546 gegenüber 8,053). Ihre Input-Kosten lagen nur 21% höher, weil 71% des Inputs aus dem Cache kamen. Die Tokens belegen weiterhin Platz im Kontextfenster. Der Rabatt entfällt, sobald der erneut gesendete Verlauf vom ursprünglich gesendeten abweicht: Im Demo-Fall replay-mismatch führte eine anders gespeicherte Nachricht zu 0% Cache-Treffern und mehr als doppelt so hohen Kosten.
Wie viel spart Prompt-Caching?
Das hängt vom Cache-Lesepreis des Modells und vom Input-Anteil der Rechnung ab. In der Demo auf GPT-6 Luna wurden 73% des Inputs einer Unterhaltung aus dem Cache gelesen. Dadurch sank der Input-Anteil der Rechnung um 66%, und die Session kostete $0.0011 statt $0.0015 ohne Cache. Output-Tokens machten den größten Teil dieser Rechnung aus. Auf sie hat das Caching keinen Einfluss.
Wird eine Retry-Schleife als Fehler angezeigt?
Eine Retry-Schleife muss nicht als Fehler erscheinen. In der Demo lieferte jeder Aufruf der Schleife Status 200 zurück. Sichtbar war die Schleife als einzelner Trace mit 10 Aufrufen statt der nötigen 2. Prüfe deshalb die Anzahl der Aufrufe pro Trace, nicht nur die Fehlerrate.
Weiterführende Artikel
- LLM-Agenten mit Traces untersuchen: die Header, Sessions und Labels, auf denen diese Seite aufbaut.
- Warum ist mein LLM-Agent langsam?: dieselbe Methode zur Untersuchung der Latenz.
- LLM-Agenten debuggen: von der Nutzerbeschwerde zum fehlerhaften Aufruf.
- Claude-Code-Kosten nach Sub-Agent: dieselbe Session-Ansicht für einen Coding-Agenten, bei dem Cache-Schreibvorgänge 77% eines Durchlaufs ausmachen.
- Claude zu deinen LLM-Logs befragen: die teuersten dieser Sessions über MCP finden.
- Deinem Agenten Log-Tools geben: dieselben Logs mit einem eigenen Programm auslesen und die Kosten der Modell-Tokens bestimmen.
- Prompt-Caching: Mindestlängen für Präfixe und Preise je Anbieter.
- Das beste LLM für jeden Anwendungsfall: Kosten nach Workload-Struktur als Grundlage für die Modellwahl pro Schritt.