
Prompt-Test vor dem Release: 16% Regression erkannt
Im kürzeren Prompt fehlte eine Regel. Bei 110 neuen Nachrichten ließ er 18-mal (16%) die Bestellnummer weg, der alte nie. Ein Lauf mit 40 Fällen blieb fehlerfrei.
Unsere Empfehlungen
Live-Preise| Modell | Fazit | Preis |
|---|---|---|
| GPT-6 Luna v1 von support-answer nannte die Bestellnummer in 275 von 275 Testaufrufen. v2 mit einem kürzeren System-Prompt tat dies in 92 von 110 Aufrufen im vorab festgelegten Testlauf. | Modell für beide getesteten Versionen | ab $0.1/Mio. |
| Claude Sonnet 5.5 Bewertete mit PASS oder FAIL, ob jede Antwort auf die Frage des Kunden eingeht. Seine Aufrufe machten $0.12 der $0.14 aus, die sechs Testläufe kosteten. | Bewertungsmodell in der Demo | ab $2/Mio. |
Inhalt
- Was gehört zu einem Prompt-Test?
- Wie führt man einen Prompt-Test per Code oder in der CI aus?
- Hat der Test die Regression erkannt?
- Warum kann ein bestandener Lauf eine Regression verbergen?
- Hat der kürzere Prompt noch etwas verschlechtert?
- Was kostet ein Prompt-Test?
- Wie hilft ein Test bei der Release-Entscheidung?
- Was ist nicht abgedeckt?
- FAQ
- Wie teste ich einen LLM-Prompt vor dem Deployment?
- Wie viele Testfälle brauche ich für einen Prompt-Regressionstest?
- Kann ein LLM als Bewertungsmodell Musterprüfungen ersetzen?
- Weiterführende Artikel
Einen Prompt vor dem Release zu testen heißt: Die neue und die aktuelle Version bekommen dieselben festgelegten Eingaben. Jede Antwort wird anhand vorher formulierter Regeln geprüft. Genau das haben wir mit v2 eines Support-Prompts gemacht. Der Systemtext war kürzer, enthielt aber die Regel „Bestellnummer immer angeben“ nicht mehr. Diese Regression, also eine Änderung, die die Ausgabe verschlechtert, sollte der Test erkennen. Bei 110 Nachrichten, die in keinem früheren Lauf verwendet worden waren, ließ v2 die Bestellnummer in 18 Antworten (16%) weg, v1 dagegen nie. Der Unterschied lässt sich kaum durch Zufall erklären (exakter Fisher-Test, p = 3.6 × 10⁻⁶). Ein früherer Lauf mit 40 Nachrichten war komplett fehlerfrei geblieben. Ein einziger bestandener Lauf reicht also nicht aus, um eine Version freizugeben.
TL;DR
- In einem vorab festgelegten Test ließ v2 von support-answer die Bestellnummer in 18 von 110 Antworten weg, v1 in 0 von 110 (p = 3.6 × 10⁻⁶).
- In einem von drei früheren Läufen mit jeweils 40 Zeilen bestand v2 alle 40 Fälle. Auch einer der drei abschließenden Testsätze hätte den Fehler allein nicht erkannt.
- v1 nannte die Bestellnummer in allen 275 Testaufrufen des Demo-Skripts.
- Sechs Testläufe mit 15 bis 20 Zeilen kosteten $0.14, davon entfielen $0.12 auf das Bewertungsmodell.
Dieser Artikel baut auf Prompt-Versionierung auf. Dort werden support-answer und seine Versionen eingerichtet. v1 und v2 verwenden beide GPT-6 Luna; nur der Systemtext unterscheidet sich. Im selben Verzeichnis von github.com/synthorai-io/use-cases:
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
Die hier gezeigten Läufe stammen vom 19. Oktober 2026. Als Bewertungsmodell dient Claude Sonnet 5.5, nicht eines der Modelle unter Test.
Was gehört zu einem Prompt-Test?
Ein Testsatz besteht aus einer Tabelle mit Eingaben und einer Liste von Prüfungen. Jede Zeile enthält Werte für die Variablen des Prompts, optional auch eine Nutzernachricht und eine erwartete Antwort. Ein Testlauf ruft für jede Zeile die neue Version und eine Referenzversion auf und prüft jede Antwort anhand aller Prüfungen. Diese Prüfungstypen gibt es:
| Prüfung | Bestanden, wenn die Antwort |
|---|---|
contains / not_contains | eine feste Zeichenfolge enthält bzw. nicht enthält |
regex / not_regex | einem Muster entspricht bzw. nicht entspricht (RE2-Syntax von Go) |
equals_expected | mit der erwarteten Antwort der Zeile übereinstimmt |
json / schema | gültiges JSON ist bzw. dem Ausgabeschema der Version entspricht |
max_latency_ms / max_cost_usd | innerhalb der Zeit- und Kostengrenzen liegt |
judge | von einem Modell anhand eines selbst formulierten Kriteriums mit PASS bewertet wird |
Ein Testsatz umfasst bis zu 50 Zeilen. Jede Prüfung gilt für alle Zeilen des Satzes. Davon hängt ab, wie man den Test aufteilt. „Die Antwort enthält eine Bestellnummer“ ist nur für Nachrichten sinnvoll, die eine Bestellnummer nennen. Die Demo hält solche Nachrichten deshalb in eigenen Testsätzen:
| Testsatz | Zeilen | Prüfungen |
|---|---|---|
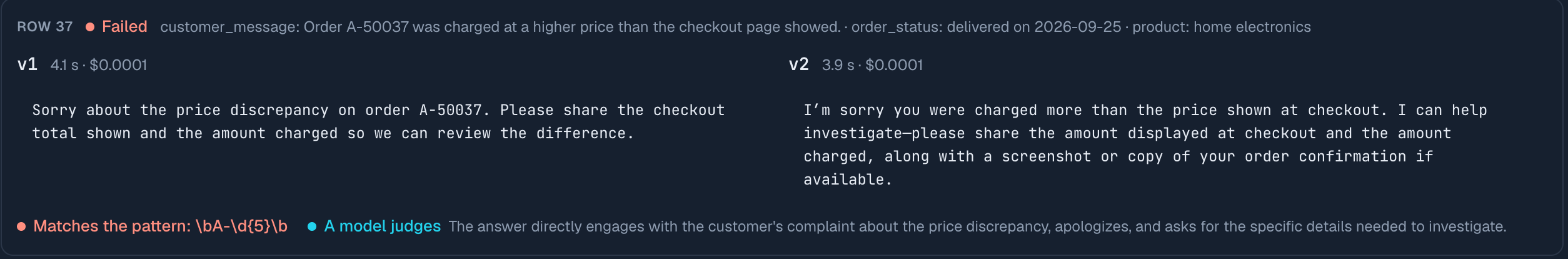
| orders (15 Zeilen, dann 40) | Nachrichten mit jeweils einer Bestellnummer zu Lieferung, Rücksendung, falschen oder beschädigten Artikeln und Abrechnung | Bestellnummer vorhanden (regex \bA-\d{5}\b); Modellbewertung: beantwortet die Kundenfrage |
| fresh orders 1 bis 3 | 110 weitere solche Nachrichten, die in keinem anderen Testsatz vorkommen, aufgeteilt in 40, 35 und 35 | dieselben zwei |
| general (20 Zeilen) | Nachrichten ohne Bestellnummer, mehrere davon zum Zeitpunkt einer Erstattung | not_contains “refund by” und “business days”; Latenz unter 20 s; Modellbewertung: beantwortet die Frage; Modellbewertung: verspricht kein Erstattungsdatum |
Die Prüfung per Bewertungsmodell benötigt einen Modellaufruf pro Antwort und liefert PASS oder FAIL. Sie kostet Geld und kann falschliegen. Die Demo nutzt sie deshalb nur für Kriterien, die sich nicht als Muster ausdrücken lassen, und weist ihre Ergebnisse getrennt von den Musterprüfungen aus.
Wie führt man einen Prompt-Test per Code oder in der CI aus?
Die CI (Continuous Integration, also die Prüfungen, die bei jeder Änderung vor dem Merge laufen) kann einen Prompt-Test über die API ausführen. Den eigentlichen Test führt der eigene Code aus: Er legt einen Lauf an, ruft für jede Zeile beide Versionen über prompt_version auf, bewertet die Antworten und schreibt die Ergebnisse in den Lauf zurück. Die Konsole zeigt diesen Lauf anschließend wie jeden anderen an. Die Schleife der Demo, gekürzt:
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
                    "results": {"rows": results}})
call_by_version ruft den Prompt über seine ID mit gesetztem prompt_version auf, wie unter Prompt-Versionierung beschrieben. judge ruft das Bewertungsmodell auf und fordert PASS oder FAIL an. Die Kennzeichnung source: eval ist beim Rollout wichtig: Auf der Prompts-Seite werden so markierte Aufrufe aus den Gesamtwerten pro Version herausgerechnet. Der Test verzerrt damit nicht den Vergleich des Live-Traffics.
Die Demo wertet ihre Musterprüfungen in Python aus. Für exakt dieselbe Auswertung wie in der Konsole schickt man Prüfungen und Antworten an POST /api/v1/prompt-checks/grade. Der Server wendet contains, not_contains, regex, not_regex, equals_expected und json mit RE2 an und liefert für jede Kombination aus Prüfung und Antwort bestanden oder nicht bestanden zurück. Ein kurzer Test ergab das erwartete Ergebnis: (?i)refund bestand für „REFUND by Friday“, not_regex (?i)refund.{0,40}\bby\b bestand für dieselbe Antwort nicht.
Der Run-Button in der Konsole arbeitet genauso, nur im Browser: Er ruft pro Zeile beide Versionen auf und speichert die Ergebnisse. Ein Konsolenlauf des orders-Satzes mit 40 Zeilen (Lauf 10 unten) bewertete nur die neue Version. Die Antworten von v1 wurden daneben angezeigt, aber nicht geprüft.
Hat der Test die Regression erkannt?
Ja. Wir haben den Test vor der Ausführung festgelegt: 110 neue Nachrichten, die in keinem früheren Lauf vorkamen, ein Aufruf pro Version und Zeile sowie ein einzelner exakter Fisher-Test für die Bestellnummernprüfung über alle 110 Zeilen, mit einem Schwellenwert von 0.05. Der exakte Fisher-Test gibt an, wie wahrscheinlich ein mindestens so großer Unterschied wäre, wenn sich beide Versionen tatsächlich gleich verhielten. Zweiseitig bedeutet, dass Unterschiede in beide Richtungen zählen. Die Zeilen und diese Regel haben wir vor dem ersten Aufruf im Repository eingecheckt. Das Ergebnis:
| Testsatz | v2 nennt die Bestellnummer | v1 nennt die Bestellnummer | Fisher-p nur für diesen Satz |
|---|---|---|---|
| fresh orders 1 (40 Zeilen) | 33/40 | 40/40 | 0.012 |
| fresh orders 2 (35 Zeilen) | 27/35 | 35/35 | 0.005 |
| fresh orders 3 (35 Zeilen) | 32/35 | 35/35 | 0.239 |
| Alle 110 Zeilen | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
v2 lässt die Bestellnummer in 16% der Antworten weg. Die Fehler verteilen sich über die Themen und betreffen nicht nur eine Nachrichtenart: jeweils 4 von 22 zu Lieferung, Rücksendung, falschen Artikeln und beschädigten Artikeln sowie 2 von 22 zur Abrechnung. Ein typischer Fall ist die Antwort auf „Für Bestellung A-50918 zeigt meine Banking-App zwei vorgemerkte Belastungen an.“ Die Antwort erklärte, dass es sich um zwei ausstehende Autorisierungen statt um zwei Abbuchungen handeln könnte. Das Bewertungsmodell akzeptierte sie, die Bestellnummer fehlte aber vollständig.
Die p-Werte pro Satz beschreiben die drei Testsätze; sie sind nicht der vorab festgelegte Test. Zwei der drei Sätze hätten v2 auch allein als auffällig erkannt, der dritte nicht.
Warum kann ein bestandener Lauf eine Regression verbergen?
Wenn eine Version eine Regel nur gelegentlich verletzt, kann ein ganzer Lauf ohne Verstoß bleiben. Vor dem obigen Test ließ die Demo v2 dreimal gegen v1 auf einem Satz mit 40 Zeilen antreten:
| Lauf | v2 nennt die Bestellnummer | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10 (Konsole) | 39/40 | 40/40 laut Auswertung der gespeicherten Antworten durch die Demo |
In Lauf 9 bestand v2 alle 40 Zeilen. Ein Team, das nur diesen einen Lauf ausgeführt hätte, hätte v2 ausgeliefert. Auch ist keiner dieser Läufe für sich genommen signifikant: Gegen eine fehlerfreie Referenz braucht ein Lauf mit 40 oder mehr Zeilen mindestens 6 Fehler, um unter 0.05 zu kommen (34 von 40 ergeben p = 0.026; 35 von 40 ergeben 0.055). Bei kleineren Sätzen reichen weniger: 5 Fehler bei 20 Zeilen ergeben bereits p = 0.047.
Daraus ergibt sich eine Regel für die Testgröße: Genügend Zeilen verwenden, damit 6 Fehler wahrscheinlich sind, nicht nur im Erwartungswert auftreten. Bei einer Fehlerrate von 16% liefern 48 Zeilen eine Chance von 80% auf mindestens 6 Fehler. Bei 38 Zeilen sind es nur 58%, obwohl der Erwartungswert bei 6 liegt. Bei 6.25%, der Rate im obigen Satz mit 40 Zeilen (10 Fehler in 160 Antworten), braucht es für eine Chance von 80% insgesamt 126 Zeilen. Für eine wichtige Regel sollte man mehr Zeilen verwenden, als in einen Testsatz passen, sie auf mehrere Sätze verteilen und vorab festlegen, wie die Ergebnisse zusammengeführt werden. Dieselben Zeilen erneut auszuführen liefert nicht denselben zusätzlichen Erkenntnisgewinn wie neue Zeilen: Die Läufe testen dieselben Nachrichten erneut und sind deshalb keine unabhängigen Stichproben. In der Demo ließ v2 bei drei Zeilen die Bestellnummer sowohl in einem als auch in einem zweiten Lauf weg.
Hat der kürzere Prompt noch etwas verschlechtert?
Die übrigen Prüfungen fanden keine weiteren Verschlechterungen. Auf dem general-Satz gab es jeweils drei Läufe:
- Kein Erstattungsdatum: Keine der Versionen schrieb jemals „refund by“ oder „business days“. Die Modellprüfung schlug je Version und Lauf bei höchstens 2 von 20 Antworten fehl, ohne Unterschied zwischen den Versionen.
- Latenz: v1 überschritt in einem Lauf bei 2 Zeilen die Grenze von 20 s, v2 nie.
- Beantwortet die Frage (Modellbewertung): v2 wurde in jedem Satz besser bewertet, auf den neuen Testsätzen mit 88 von 110 gegenüber 75 von 110. Diesen Vergleich hatten wir nicht vorab festgelegt. Er bleibt deshalb ein Hinweis auf eine Tendenz: Nach Einschätzung des Bewertungsmodells antwortet der kürzere Prompt direkter.
Das Bewertungsmodell in der Konsole und das der Demo verwenden unterschiedliche Prompts; das der Konsole gibt zusätzlich eine Begründung aus. Für dieselben 40 Nachrichten, aber mit Antworten aus unterschiedlichen Läufen, akzeptierte die Konsole v2 in 40 von 40 Fällen, das Bewertungsmodell der Demo in 32 bis 35. Ergebnisse von Modellbewertungen sollte man nur innerhalb desselben Bewertungsverfahrens vergleichen.
Was kostet ein Prompt-Test?
Mit den Modellen dieser Demo etwa ein Zehntelcent pro Zeile für zwei Versionen und eine Modellprüfung:
| Läufe | Zeilen pro Lauf | Aufrufe | Kosten |
|---|---|---|---|
| 6 Läufe der Sätze mit 15 und 20 Zeilen | 15 oder 20 | Antworten plus Modellbewertung | $0.1400, davon $0.1198 für Bewertungsaufrufe |
| 3 Läufe des Satzes mit 40 Zeilen | 40 | 240 Antworten + 240 Modellbewertungen | $0.115 |
| der vorab festgelegte Test | 110 | 220 Antworten + 220 Modellbewertungen | $0.1076 |
Der größte Kostenanteil entfällt auf das Bewertungsmodell, weil jede Antwort einen eigenen Aufruf an ein größeres Modell erfordert. Ein Lauf mit 40 Zeilen dauerte bei sequenziellen Aufrufen 10 Minuten. Parallele Aufrufe würden die Dauer verkürzen, aber das Rate Limit stärker beanspruchen.
Wie hilft ein Test bei der Release-Entscheidung?
Wenn man production in der Konsole verschiebt, zeigt der Dialog neben der Änderung den letzten Testlauf der Version an. Er liefert eine Entscheidungsgrundlage, blockiert den Wechsel aber nicht. Testsätze und die Antworten eines Laufs werden verschlüsselt gespeichert. Antworten bleiben 30 Tage erhalten.
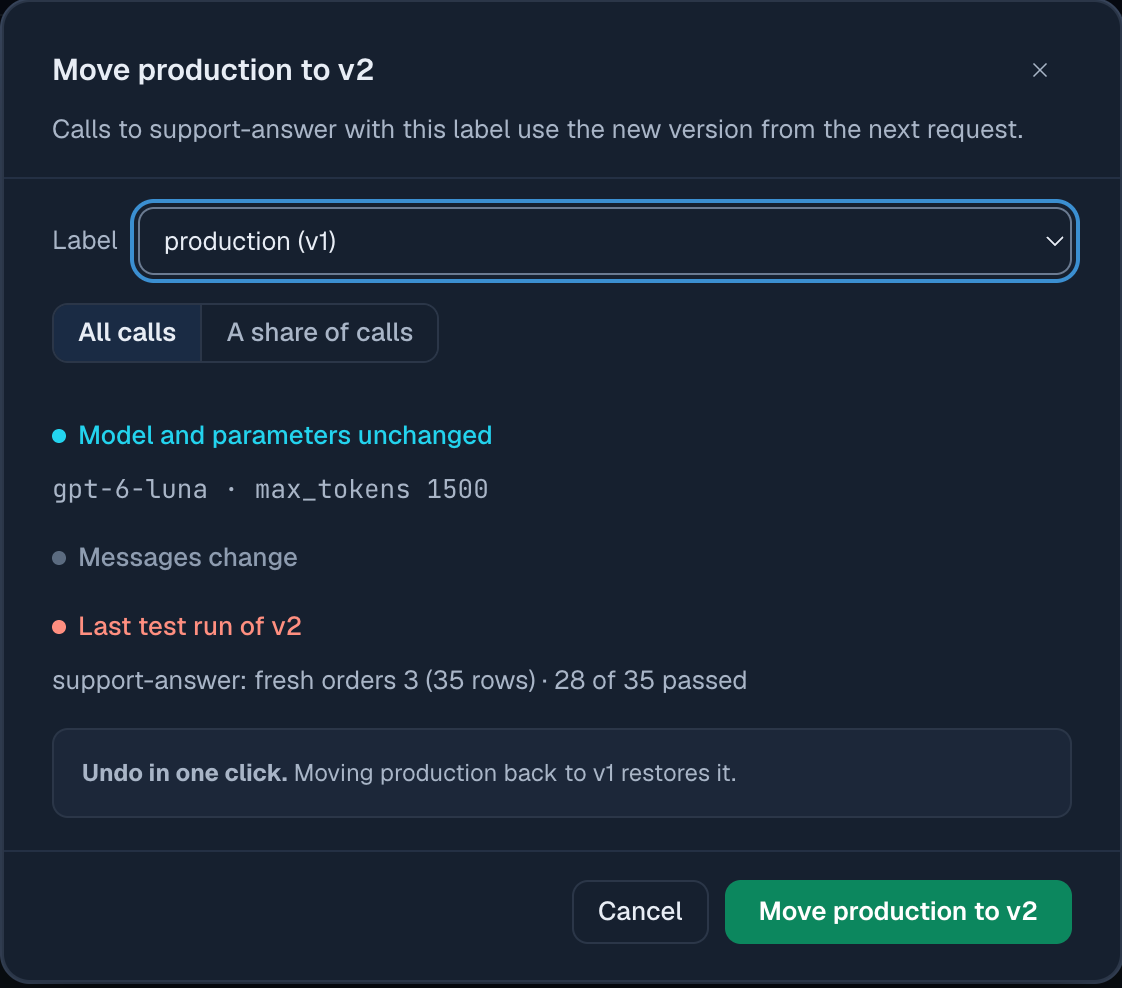
Der Dialog zählt eine Zeile nur dann als bestanden, wenn alle Prüfungen des Satzes bestanden wurden. Die 28 von 35 kombinieren also die Musterprüfung und die Modellbewertung.
Was ist nicht abgedeckt?
- Prüfungen pro Zeile. Eine Prüfung gilt für jede Zeile ihres Testsatzes. Deshalb verwendet die Demo getrennte Sätze für Nachrichten mit und ohne Bestellnummer.
- Serverseitig ausgeführte Tests. Sowohl bei der API als auch beim Run-Button der Konsole erfolgen die Modellaufrufe auf der aufrufenden Seite. Es gibt keinen Endpunkt, der einen vollständigen Test auf dem Server ausführt und auf dessen Abschluss wartet.
- Genauigkeit des Bewertungsmodells. Wir haben das Modell nicht mit menschlichen Bewertungen abgeglichen. Seine Zahlen zeigen deshalb nur Tendenzen. Eine belastbare Feststellung trifft dieser Artikel nur für die Musterprüfung.
FAQ
Wie teste ich einen LLM-Prompt vor dem Deployment?
Die neue und die aktuelle Version mit denselben festgelegten Eingaben ausführen, jede Antwort anhand schriftlich festgehaltener Regeln prüfen und die Anzahl bestandener Fälle mit einem vorab festgelegten Signifikanztest vergleichen. In der Demo konnten 110 neue Nachrichten und ein einzelner exakter Fisher-Test eine Fehlerrate von 16% von 0% unterscheiden.
Wie viele Testfälle brauche ich für einen Prompt-Regressionstest?
Genügend Zeilen verwenden, damit bei einer tatsächlichen Regression mindestens 6 Regelverstöße wahrscheinlich sind. Für eine Chance von 80% sind das 48 Zeilen bei einer Fehlerrate von 16% und 126 Zeilen bei 6.25%. In der Demo bestand eine Version einen Lauf mit 40 Zeilen, obwohl sie im Haupttest bei 16% der Antworten gegen die Regel verstieß.
Kann ein LLM als Bewertungsmodell Musterprüfungen ersetzen?
Ein Bewertungsmodell sollte keine Prüfung ersetzen, die sich als Muster ausdrücken lässt. In der Demo verwendeten Konsole und Skript unterschiedliche Bewertungs-Prompts. Für dieselben Nachrichten akzeptierten sie v2 in 40 von 40 bzw. 32 bis 35 von 40 Fällen. Eine Musterprüfung liefert dagegen für denselben Text jedes Mal dasselbe Ergebnis.
Weiterführende Artikel
- Prompt-Versionierung: einen Prompt per ID aufrufen und ein Label verschieben.
- A/B-Test einer Prompt-Änderung: was eine Version im Live-Traffic kostet.
- Leitfaden zur Prompt-Bibliothek: Testsätze, Prüfungen und Evaluierungsläufe.
- Prompts in der Konsole: der Testeditor und der Dialog zum Verschieben von Labels.