
LLM-Agenten mit 3 HTTP-Headern tracen, ohne Tracing-SDK
Drei Request-Header pro Modellaufruf liefern einen Wasserfall für jeden Agentenlauf: parallele Aufrufe, Zeit im eigenen Code, Fehler und Kosten.
Unsere Empfehlungen
Live-Preise| Modell | Fazit | Preis |
|---|---|---|
| GPT-6 Luna Verarbeitet die Function-Calling-Schleife der Demo. Seine zwei Aufrufe pro Runde (Planung und Antwort) kosten im auf dieser Seite gezeigten Durchlauf zusammen $0.0002. | Hauptagent in der Demo | ab $0.1/Mio. |
| DeepSeek V4.1 Flash Führt die drei parallelen Ein-Satz-Prüfungen mit deaktiviertem Reasoning aus. Seine sechs Aufrufe in der auf dieser Seite gezeigten Sitzung kosten $0.0004, und ein siebter Subagent-Aufruf schlug bei Kosten von $0 fehl. | Subagent in der Demo | ab $0.3/Mio. |
Inhalt
- Welche Angaben braucht ein Trace?
- Was macht der Demo-Agent?
- Wie liest man den Wasserfall?
- Was ergänzt eine Session gegenüber einem Trace?
- Wie lassen sich Kosten nach Feature oder Nutzer aufschlüsseln?
- Was passiert bei einem fehlgeschlagenen Aufruf?
- Wie bekommt man die Kosten jedes Aufrufs im Code?
- Was ist, wenn der Agent bereits Trace-Header sendet?
- Wofür nutzt man einen Trace?
- Was fehlt noch?
- FAQ
- Brauche ich OpenTelemetry für das Tracing eines LLM-Agenten?
- Was ist der Unterschied zwischen einem Trace und einer Session?
- Ändern Trace-Header das Routing, die Abrechnung oder die Daten, die das Modell sieht?
- Wie lange werden Traces aufbewahrt?
- Kostet ein fehlgeschlagener Aufruf etwas?
- Weiterführende Artikel
Wenn ein Agent für die Antwort auf eine Nachricht fünf Modellaufrufe braucht, hilft ein einfaches Request-Log beim Debuggen nur begrenzt. Es zeigt nicht, welche Aufrufe zum selben Lauf gehören, welche parallel liefen und wie viel der Wartezeit auf den eigenen Code entfiel. In dieser Anleitung ergänzen wir einen kleinen Support-Agenten um drei Request-Header. Das Ergebnis sehen wir in der Synthorai-Konsole als Trace (ein Lauf auf einer Zeitachse) und als Session (ein Gespräch samt Kosten). Dafür muss weder ein Tracing-SDK installiert noch ein Collector betrieben werden, also ein separater Dienst, der Traces entgegennimmt. Der Quellcode liegt unter agent-tracing/ in github.com/synthorai-io/use-cases. Voraussetzungen sind Python 3.10 oder neuer und ein API-Key aus der Konsole.
TL;DR
- Drei Request-Header (
X-Trace-Id,X-Span-Id,X-Session-Id) pro Modellaufruf machen aus dem Request-Log Traces und Sessions in der Synthorai-Konsole, ohne Tracing-SDK. - Im Demo-Trace verteilen sich 8.5 s Gesamtdauer auf etwa 7.0 s in Modellaufrufen und 1.6 s außerhalb davon, im eigenen Agentencode und im Netzwerk.
- Ein fehlgeschlagener Aufruf mit Status 404 blieb im Trace sichtbar und kostete $0.
- Der Demo-Lauf mit 21 Modellaufrufen kostete $0.0017.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd agent-tracing
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --fail
Bei unserem Test am 11. Oktober 2026 führte das Programm in weniger als einer Minute 21 Modellaufrufe aus und kostete $0.0017. Es gibt zwei Session-IDs und vier Trace-IDs aus. Unter Traces in der Konsole sind dieselben IDs aufgeführt. Die Konsole zeigt Zeiten in der Zeitzone des Browsers an. Deshalb steht in den Screenshots auf diesen Seiten 19:24 statt 11:24 UTC.
Welche Angaben braucht ein Trace?
Bei jedem Modellaufruf werden drei Header mitgeschickt. Ihre Werte sind frei wählbare Strings. Das Gateway protokolliert bereits jeden Request. Die Header geben lediglich an, welche Requests zusammengehören.
| Header | Denselben Wert senden für | Ergebnis |
|---|---|---|
X-Trace-Id | alle Aufrufe eines Laufs (die vollständige Bearbeitung einer Nutzernachricht) | die Aufrufe als gemeinsamer Wasserfall |
X-Span-Id | genau einen Aufruf | der Name der zugehörigen Zeile im Wasserfall |
X-Session-Id | alle Aufrufe eines Gesprächs | gruppierte Läufe mit Summen für das Gespräch |
Ein Span ist ein einzelner Schritt innerhalb eines Traces. In dieser Anleitung entspricht jeder Span einem Modellaufruf. Jede ID darf bis zu 128 druckbare ASCII-Zeichen enthalten. Das Gateway gibt die IDs in der Response zurück und leitet sie nicht an den Modellanbieter weiter.
Drei weitere Header sind optional. X-Agent-Id gibt an, welcher Subagent einen Aufruf ausgeführt hat. X-Parent-Agent-Id benennt den Agenten, der diesen Subagenten gestartet hat. X-Synthorai-Metadata enthält Labels, etwa für das Feature oder den Endnutzer. Alle stehen in der Referenz der Request-Header. Die Demo sendet X-Agent-Id und Labels, aber kein X-Parent-Agent-Id: Der einzige Subagent wird vom Hauptagenten gestartet, weitere Verschachtelungen gibt es nicht.
In der Demo stellt eine Funktion die Header für einen Aufruf zusammen. Diese Funktion ist die gesamte Tracing-Schicht:
@dataclass
class Run:
    """One agent run, which the gateway shows as one trace."""
    session_id: str
    labels: dict = field(default_factory=dict)
    trace_id: str = field(default_factory=lambda: new_id("trace"))

    def headers(self, span: str, agent: str | None = None, parent: str | None = None) -> dict:
        h = {
            "X-Session-Id": self.session_id,
            "X-Trace-Id": self.trace_id,
            "X-Span-Id": span,
        }
        if agent:
            # Only sub-agents need an id. Calls without one belong to the main agent.
            h["X-Agent-Id"] = agent
        if parent:
            h["X-Parent-Agent-Id"] = parent
        if self.labels:
            h["X-Synthorai-Metadata"] = json.dumps(self.labels, separators=(",", ":"))
        return h
Alle Modellaufrufe des Agenten laufen durch einen gemeinsamen Wrapper, der die Header anhängt. Im OpenAI Python SDK werden Header pro Request über extra_headers übergeben:
raw = await client.chat.completions.with_raw_response.create(
    model=model, messages=messages,
    extra_headers=run.headers(span, agent, parent), **kwargs)
resp = raw.parse()
request_id = raw.headers.get("x-request-id")   # the gateway's id for this call
with_raw_response dient hier nur dazu, die Response-Header auszulesen. Wer die Request-ID nicht braucht, kann einfach create(..., extra_headers=...) verwenden.
Was macht der Demo-Agent?
Er beantwortet eine Kundennachricht in vier Schritten mit fünf Modellaufrufen. Der Ablauf ist so gewählt, dass sich am Trace etwas ablesen lässt. Der Hauptagent nutzt GPT-6 Luna, der Subagent DeepSeek V4.1 Flash. Beide Modelle werden über Umgebungsvariablen festgelegt. Die Aufrufe des Subagenten setzen reasoning_effort="none", weil das Modell für eine Prüfung mit einem Satz Antwort nicht erst einen Reasoning-Schritt braucht. Falls das gewählte Subagenten-Modell diesen Wert ablehnt, muss ANALYST_REASONING geändert oder geleert werden.
| Span | Wer | Ablauf |
|---|---|---|
plan | Hauptagent | liest die Nachricht und fordert Tools an (Function Calling: Das Modell liefert einen Funktionsnamen und Argumente, die der eigene Code ausführt) |
| keiner | eigener Code | führt zwei Tools lokal und parallel aus: eine Bestellabfrage (1.2 s) und eine Suche in Richtlinien (0.6 s) |
sentiment, policy-check, risk | Subagent analyst | drei gleichzeitig gestartete Prüfungen mit jeweils einem Satz als Ergebnis |
answer | Hauptagent | formuliert die Antwort aus den Tool-Ergebnissen und den drei Prüfungen |
Die Tools sind einfache Python-Funktionen mit einem sleep, die eine Datenbank und einen Suchindex simulieren. Mit --fail fordert ein policy-check-Aufruf zunächst ein nicht existierendes Modell an. Er erhält einen 404 und wird unter dem Span-Namen policy-check.retry wiederholt.
run.py spielt zwei Gespräche mit jeweils zwei Gesprächsrunden durch. Jedes Gespräch bekommt eine Session-ID, jede Runde eine neue Trace-ID:
session_id, history = new_id("support"), []
for text in turns:
    run = Run(session_id, labels={"feature": "support-agent", "release": "v2", "_user": user})
    reply = await handle(run, history, text)
Wie liest man den Wasserfall?
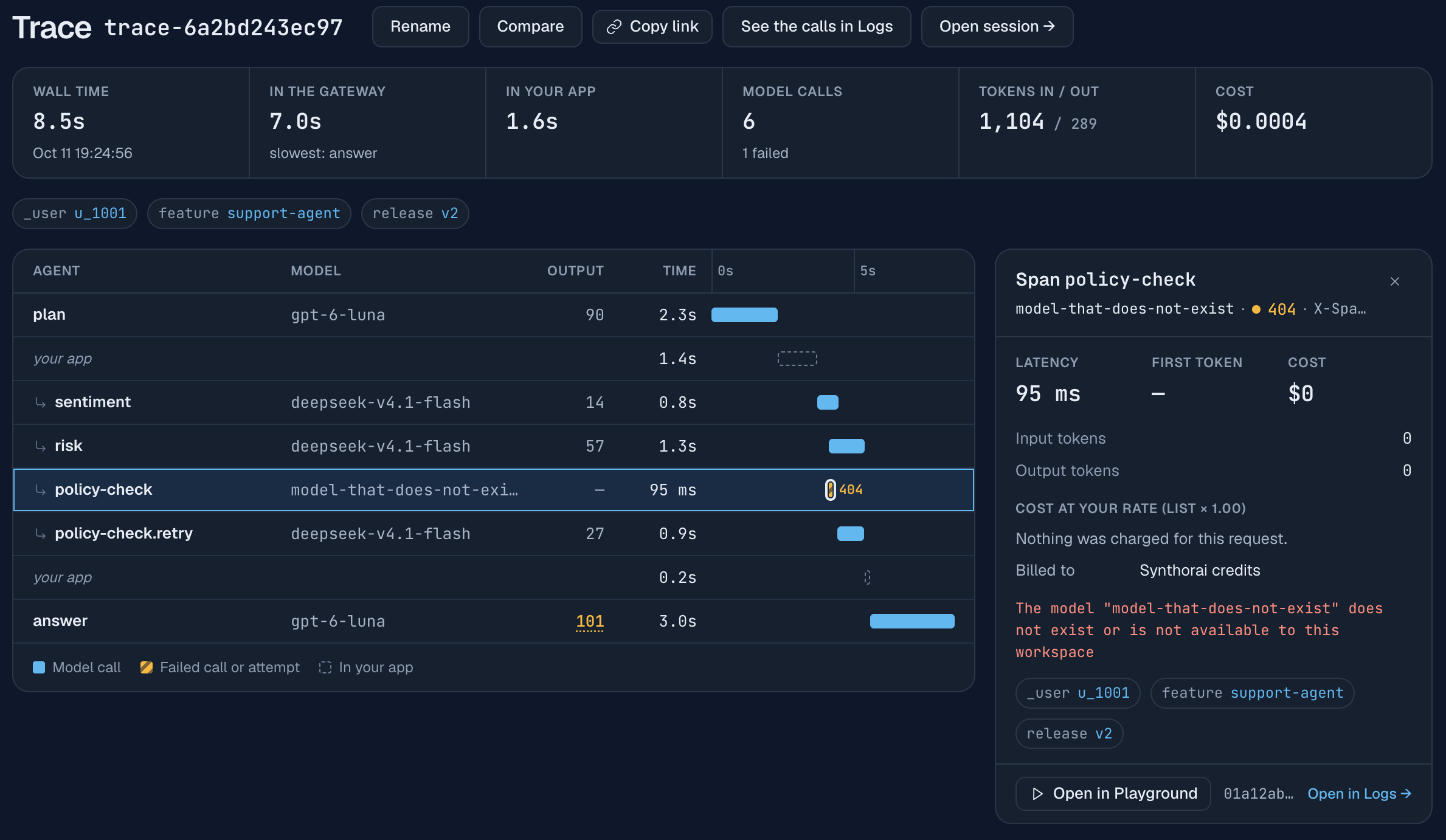
Jede Zeile zeigt einen Modellaufruf oder eine Lücke, in der der eigene Code läuft. Die Zeitachse beginnt, sobald der erste Aufruf des Laufs das Gateway erreicht. Der Screenshot oben zeigt die zweite Runde des ersten Gesprächs. Von oben nach unten:
plandauerte 2.3 s. Der Balken zeigt die Zeit, die das Gateway für diesen Request brauchte, vom Empfang bis zum Abschluss der Response.your appdauerte 1.4 s. In diesem Zeitraum war kein Request offen. Die Zeit entfiel daher auf Arbeit außerhalb des Gateways: den eigenen Code und das Netzwerk zwischen Code und Gateway. Hier sind es die beiden lokalen Tools; das langsamere wartet mitsleep1.2 s. Bei einem echten Agenten wird in dieser Zeile eine langsame Datenbankabfrage oder Vektorsuche sichtbar.sentiment,riskundpolicy-check.retryüberlappen sich. Der Agent hat die drei Prüfungen mitasyncio.gathergestartet. Die überlappenden Balken zeigen die parallelen Aufrufe. Der Pfeil vor den Namen kennzeichnet Aufrufe eines Subagenten.policy-checkist eine schraffierte 95-ms-Markierung mit404. Ein fehlgeschlagener Aufruf bleibt mit dem Statuscode im Trace, den der eigene Code erhalten hat.answerdauerte 3.0 s und ist der langsamste Aufruf. Das steht auch in der Zusammenfassung über dem Wasserfall.- Die Spalte Output zeigt die Ausgabetokens jedes Aufrufs. Die Ausgabe bestimmt, womit ein Aufruf seine Zeit verbringt. Die Spalte erklärt deshalb meist die Länge des danebenliegenden Balkens:
answererzeugte 101 Tokens, die drei Prüfungen jeweils 14 bis 57. Wenn bei einer größeren Ausgabe die meisten Tokens auf Reasoning entfallen, unterstreicht die Konsole die Anzahl. Das ist hier bei den 101 der Fall.
Die Zusammenfassung teilt die 8.5 s Gesamtdauer in 7.0 s im Gateway und 1.6 s in der Anwendung auf. Damit beantwortet sie die erste Frage der meisten Latenzanalysen: Muss man die Modellaufrufe oder den eigenen Code untersuchen? In diesem Lauf entfielen 82% der Wartezeit auf die Modelle. Die beiden Aufrufe des Hauptagenten, plan und answer, machten davon 5.3 s aus. Ein schnelleres Modell für den Hauptagenten würde daher mehr bringen als schnellere Modelle für die drei Prüfungen.
Das Gateway kann nicht in den eigenen Code hineinsehen. Es leitet die Zeilen your app aus den Lücken zwischen Requests ab. Eine Lücke zeigt also, wie lange der Code lief, aber nicht, was er getan hat. Für Spans eigener Funktionen braucht man ein SDK für OpenTelemetry, den offenen Standard für Tracing. Beide können dieselben IDs verwenden: Wenn kein X-Trace-Id gesendet wird, liest das Gateway traceparent, den Standard-Header mit der Trace-ID.
Was ergänzt eine Session gegenüber einem Trace?
Eine Session fasst die Läufe eines Gesprächs zusammen und bildet ihre Summen. Sie lässt sich aus der Traces-Liste öffnen oder über „Session öffnen“ in einem beliebigen Trace.
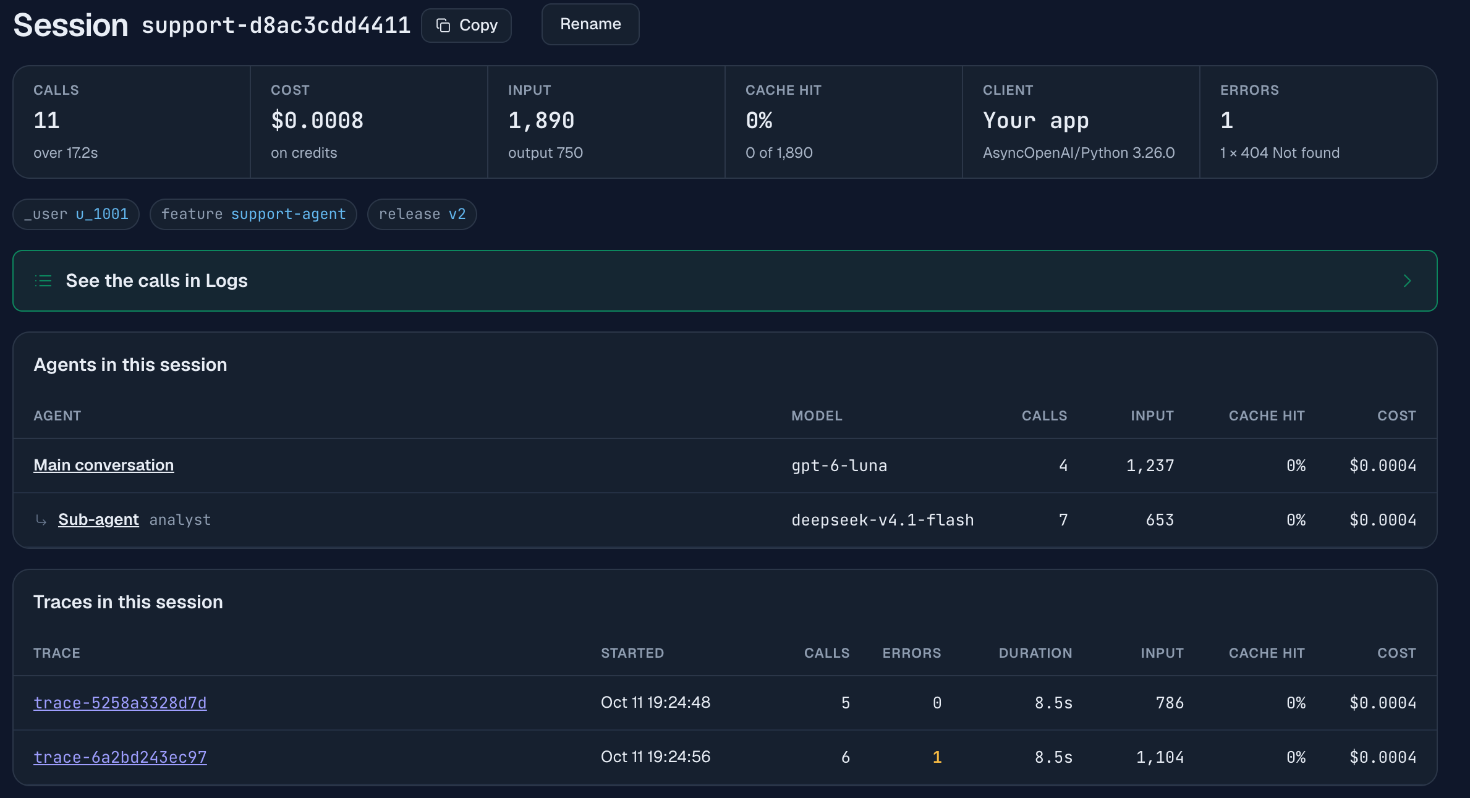
Die Session oben zeigt ein Kundengespräch mit zwei Runden: 11 Aufrufe, 1,890 Eingabe- und 750 Ausgabetokens, $0.0008, ein Fehler. Die Seite besteht aus drei Teilen:
- Agenten dieser Session schlüsselt Aufrufe und Kosten nach Agent auf. Der Hauptagent führte 4 Aufrufe auf GPT-6 Luna für $0.0004 aus. Der Subagent
analystführte 7 Aufrufe für $0.0004 aus: sechs auf DeepSeek V4.1 Flash und einen fehlgeschlagenen. Die Tabelle erscheint, weil die Aufrufe des SubagentenX-Agent-Id: analystmitgeschickt haben. Aufrufe ohne diesen Header zählen zum Hauptgespräch. - Traces dieser Session listet jede Runde mit Fehlern, Dauer, Eingabetokens, Cache-Treffern und Kosten auf. So lässt sich die langsame, fehlgeschlagene oder teure Runde eines langen Gesprächs finden, ohne durch ein Log zu scrollen.
- Cache-Treffer ist der Anteil der Eingabetokens, die aus dem Prompt-Cache des Anbieters gelesen wurden. Hier liegt er bei 0%, weil die Prompts nur wenige hundert Tokens lang sind. Anbieter cachen Präfixe erst ab einer Mindestlänge (bei den meisten 1,024 Tokens; siehe Prompt-Caching).
Die Session-ID erfüllt eine zweite Aufgabe, sobald die Prompts lang genug für den Cache sind. Jeder Aufruf eines Gesprächs sollte denselben X-Session-Id senden. Das Gateway sorgt damit für konsistente Prompt-Cache-Treffer innerhalb des Gesprächs, sodass die zweite Runde den Cache liest, den die erste geschrieben hat. Bei /v1/chat/completions und /v1/responses lässt sich der Wert auch als session_id im Request-Body übergeben, wenn das Framework das Setzen von Headern erschwert.
Wie lassen sich Kosten nach Feature oder Nutzer aufschlüsseln?
Dazu wird X-Synthorai-Metadata mit einem flachen JSON-Objekt aus Strings gesendet. Anschließend kann man danach gruppieren oder filtern. Die Demo versieht jeden Aufruf mit Labels für Feature, Release und Endnutzer:
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}Die Labels erscheinen als kleine Tags am Trace und an der Session. Für die Summen öffnet man die Analyse, wählt den Tab für die Aufschlüsselung und dort die Karte „Kosten nach Metadaten“. Nach Auswahl eines Schlüssels zeigt sie jeden zugehörigen Wert mit Requests, Fehlern, Eingabetokens und Kosten:
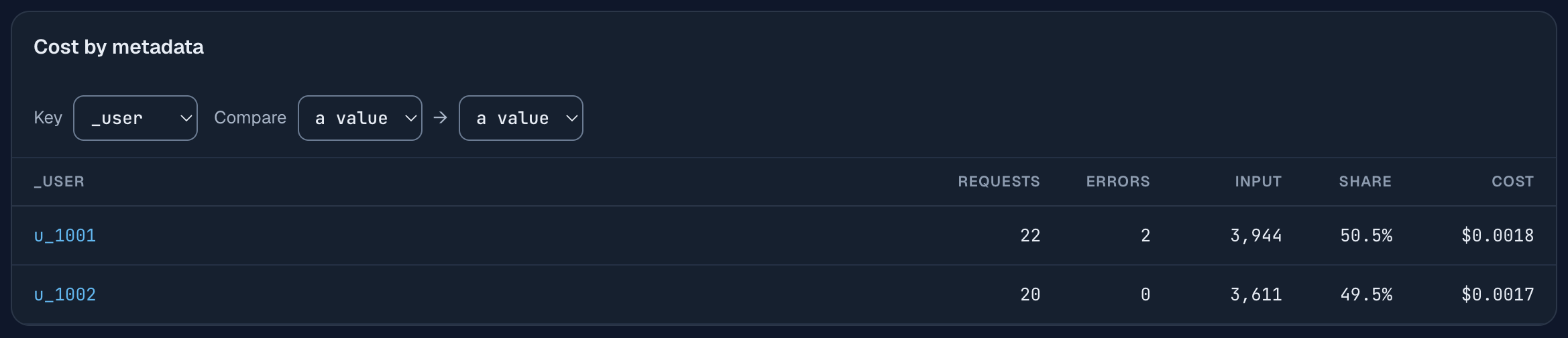
Die Karte oben umfasst eine Stunde, in der die Demo zweimal lief: 22 Requests und $0.0018 für u_1001, dessen Läufe die zwei fehlgeschlagenen Aufrufe enthalten, und 20 Requests und $0.0017 für u_1002. Nach einem Durchlauf stehen dort 11 und 10. Mit feature als Schlüssel sieht man die Kosten je Feature. Mit release lässt sich prüfen, wie sich eine Prompt-Änderung auf die Kosten ausgewirkt hat. Die Karte kann auch zwei Werte eines Schlüssels nebeneinanderstellen. Im selben Tab gibt es eine Karte „Kosten nach Agent“, die jeden X-Agent-Id über alle Sessions hinweg summiert.
Um die Läufe hinter einer Summe zu finden, lassen sich die Labels als Suchkriterien nutzen. metadata._user = u_1002 in das Suchfeld der Traces-Liste eingeben und Enter drücken. Dann bleiben nur die Sessions und Traces dieses Nutzers übrig. Das Filterfeld in den Logs akzeptiert denselben Ausdruck für einzelne Requests.
Für Labels gelten wenige Regeln:
- Höchstens 10 Labels pro Request. Ein Schlüssel besteht aus 1 bis 32 Zeichen aus
a-z,0-9,_,.und-. Ein Wert ist ein String mit bis zu 128 Bytes. _userkennzeichnet den Endnutzer, für den der Request ausgeführt wurde. Andere Schlüssel mit führendem Unterstrich sind reserviert.- Ein Label, das gegen eine Regel verstößt, wird verworfen; der Request läuft trotzdem weiter. Der Response-Header
X-Synthorai-Metadata-Droppednennt die verworfenen Schlüssel. Diesen Header sollte man bei der Einrichtung mitloggen. Wir haben zum Test einen Schlüssel namensBad?Keygesendet. Der Header kam mitBad?Keyzurück. - Prompt-Text, personenbezogene Daten und Geheimnisse gehören nicht in Labels. Für
_userdie interne Nutzer-ID verwenden, keine E-Mail-Adresse.
Was passiert bei einem fehlgeschlagenen Aufruf?
Er bleibt als schraffierte Markierung mit seinem Statuscode im Trace und kostet nichts. In der Demo hat der fehlgeschlagene policy-check eine nicht existierende Modell-ID angefordert. Ein Klick darauf im Wasserfall öffnet das Panel rechts im Screenshot oben. Es zeigt den Fehler, den der Code erhalten hat: The model "model-that-does-not-exist" does not exist or is not available to this workspace, eine Latenz von 95 ms, Kosten von $0 und den Hinweis, dass nichts berechnet wurde.
Die Demo gibt dem Retry einen eigenen Span-Namen:
try:
    await call(run, span, model=BROKEN_MODEL, messages=messages, agent="analyst")
except APIStatusError:
    span = f"{span}.retry"      # the retry is its own span, so both show in the waterfall
resp = await call(run, span, model=ANALYST_MODEL, messages=messages, agent="analyst", max_tokens=400,
                  **analyst_options())   # reasoning_effort="none" unless ANALYST_REASONING says otherwise
Die unveränderte Trace-ID und der neue Span-Name sorgen dafür, dass Fehler und Retry gemeinsam in einer Ansicht stehen. Wenn die Retry-Logik in einer Bibliothek steckt, die dieselben Header wiederverwendet, erscheinen trotzdem beide Versuche, dann als zwei Zeilen mit demselben Namen.
Fehler werden auch zusammengefasst. Die Trace-Zusammenfassung zeigt „6 Modellaufrufe, 1 fehlgeschlagen“. Die Session listet Fehler nach Statuscode auf (1 × 404 Not found). Die Traces-Liste hat eine sortierbare Fehlerspalte, über die sich problematische Läufe finden lassen.
Wie bekommt man die Kosten jedes Aufrufs im Code?
Über die Request-ID aus der Response lässt sich der Abrechnungsdatensatz beim Gateway abfragen. GET /v1/generation?id=<request id> liefert Kosten, Token-Zahlen, Latenz und Status eines Requests.
async def cost_of(http: httpx.AsyncClient, request_id: str) -> float | None:
    """The billing record of one request. It is written a moment after the call returns."""
    if not request_id:
        return None                                  # a call that got no response has no record
    for _ in range(6):
        try:
            r = await http.get(f"{BASE_URL}/generation", params={"id": request_id})
            if r.status_code == 200:
                return r.json()["data"]["total_cost"]
        except (httpx.HTTPError, KeyError, TypeError, ValueError):
            pass                                     # a dropped connection or a half-written record: try again
        await asyncio.sleep(2)
    return None
Der Datensatz wird kurz nach Abschluss der Response geschrieben. Deshalb wiederholt die Funktion die Abfrage, bis sie einen 200 erhält. Sie bekommt einen httpx.AsyncClient, den der aufrufende Code einmal mit gesetztem Authorization-Header erstellt und für jede Abfrage übergibt. Wer zwanzig Aufrufe über denselben Client abfragt, verwendet einige wenige Verbindungen wieder. Ein neuer Client pro Abfrage öffnet dagegen zwanzig Verbindungen gleichzeitig. Bei unseren Läufen brachen eine oder zwei davon ab. Die Demo gibt pro Aufruf eine Zeile aus, die auf ihren eigenen Zeitmessungen und diesen Datensätzen beruht. Dies ist die erste Runde der Session aus den Screenshots:
trace trace-5258a3328d7d  session support-d8ac3cdd4411
  plan                 main     gpt-6-luna                 200   1878 ms    153 in   22 out  $0.000026
  sentiment            analyst  deepseek-v4.1-flash        200   1431 ms     91 in   28 out  $0.000061
  risk                 analyst  deepseek-v4.1-flash        200   1877 ms     96 in   33 out  $0.000068
  policy-check         analyst  deepseek-v4.1-flash        200   1885 ms     96 in   39 out  $0.000076
  answer               main     gpt-6-luna                 200   4142 ms    350 in  339 out  $0.000205
Diese Zeiten werden im Client gemessen und enthalten die Netzwerkzeit. Sie sind deshalb länger als die Balken in der Konsole, die den Request innerhalb des Gateways messen. In der zweiten Runde, die der Wasserfall oben zeigt, dauerte plan im Client 2,499 ms und im Gateway 2.3 s. Bei answer waren es 3,161 ms und 3.0 s. Bei parallel gesendeten Aufrufen kann der Unterschied größer sein: Der fehlgeschlagene Aufruf dauerte im Client 694 ms und im Gateway 95 ms.
Wer die abgerechneten Kosten jedes Aufrufs in eigenen Logs haben möchte, kann diese Funktion übernehmen. Zum Stoppen eines zu teuren Laufs eignet sie sich nicht: Jeder Datensatz kommt erst kurz nach dem Aufruf, und die Funktion kann mehrere Sekunden darauf warten. Für ein laufendes Budget müssen die Kosten aus usage jeder Response während des Laufs selbst berechnet werden. Die Abrechnungsdatensätze dienen anschließend zur Kontrolle.
Was ist, wenn der Agent bereits Trace-Header sendet?
Dann muss möglicherweise nichts ergänzt werden. Für jede der drei IDs, die im Request fehlt, liest das Gateway den entsprechenden Header, den gängige Tools bereits senden:
| Eingesetztes Tool | Gesendeter Header | Interpretiert als |
|---|---|---|
| OpenTelemetry-HTTP-Instrumentierung | traceparent | Trace, mit dessen Parent-ID als Span |
| LiteLLM SDK | X-Litellm-Trace-Id, X-Litellm-Session-Id | Trace, Session |
| Langfuse SDK | baggage: langfuse_trace_id=…, langfuse_session_id=… | Trace, Session |
| Open WebUI | X-OpenWebUI-Chat-Id | Session |
| Claude Code | X-Claude-Code-Session-Id | Session |
| OpenAI Codex CLI | Session-Id | Session |
Die eigenen Header X-Trace-Id, X-Span-Id und X-Session-Id haben Vorrang, wenn beide Varianten vorhanden sind. Die vollständige Liste steht in der Referenz der Request-Header. Bei Agenten-Frameworks, die keinen dieser Header senden, müssen sie über die jeweilige Einstellung für benutzerdefinierte Header ergänzt werden.
Wofür nutzt man einen Trace?
Meist vergleicht man ihn mit einem anderen. Jede Trace-Seite hat einen Vergleichsbutton. Nach Auswahl eines zweiten Traces zeigt die Konsole beide auf einer Seite: jede Kennzahl als A, B und Differenz, jeden Aufruf zusammen mit dem gleichnamigen Aufruf sowie beide Wasserfälle auf einer gemeinsamen Zeitachse. So lässt sich prüfen, wie sich Änderungen am Prompt, am Modell oder am eigenen Code auf einen Lauf ausgewirkt haben.
Drei weiterführende Anleitungen verwenden denselben Agenten und dieselben Header. Jede reproduziert Probleme, behebt sie und vergleicht das Ergebnis auf diese Weise:
- Warum ist mein LLM-Agent langsam? Serielle Aufrufe, ein langsames Tool im eigenen Code und Reasoning für einzeilige Antworten.
- Warum ist mein LLM-Agent teuer? Ein Zeitstempel, der den Cache unbrauchbar macht, wachsender Kontext, eine Retry-Schleife und das falsche Modell.
- LLM-Agenten debuggen Von einer Nutzerbeschwerde zum fehlerhaften Aufruf.
Drei weitere betrachten dasselbe Log aus anderen Blickwinkeln:
- Claude-Code-Kosten nach Subagent Ein Coding-Agent, den man nicht selbst geschrieben hat, untersucht über dieselben Session- und Agentenansichten.
- Claude zu den eigenen LLM-Logs befragen Fragen zu diesen Sessions, beantwortet im Chatfenster über eine schreibgeschützte MCP-Verbindung.
- Dem Agenten Tools für Logs geben Dieselben Tools in einem eigenen Programm und die Kosten der Modelltokens.
Was fehlt noch?
Die Demo deckt Modellaufrufe ab. Im Produktionsbetrieb kommen meist vier Dinge hinzu:
- Spans für den eigenen Code. Das Gateway zeigt die Lücken zwischen Modellaufrufen, aber nicht, was darin passiert. Tools, Retrieval und Queues mit OpenTelemetry instrumentieren und
traceparentdurchreichen, damit dieselbe Trace-ID beide Ansichten verbindet. - Prompt- und Response-Bodys. Diese Anleitung nutzt die Zeit-, Token- und Kostendaten jedes Aufrufs. Sie behandelt nicht die Prüfung der Inhalte, die an das Modell gesendet wurden.
- Budgets.
cost_ofliefert den abgerechneten Betrag im Nachhinein. Um einen Lauf an einem Limit zu stoppen, müssen die Kosten aususagejeder Response direkt bei deren Eingang berechnet werden. Das sind einige Zeilen in der Agentenschleife, die in der Demo fehlen. - Sampling. Jeder Aufruf wird erfasst, weil der Trace aus dem Request-Log entsteht, das das Gateway ohnehin führt. Es gibt nichts zu samplen. Auf Agentenseite entsteht außer einigen Headern kein zusätzlicher Aufwand.
FAQ
Brauche ich OpenTelemetry für das Tracing eines LLM-Agenten?
Nein. Drei Request-Header (X-Trace-Id, X-Span-Id, X-Session-Id) pro Modellaufruf reichen für einen Wasserfall der Modellaufrufe. Die Zeit dazwischen wird der Anwendung zugeordnet. OpenTelemetry wird nützlich, wenn auch eigene Funktionen Spans bekommen sollen.
Was ist der Unterschied zwischen einem Trace und einer Session?
Ein Trace ist ein Agentenlauf: alles, was zur Bearbeitung einer Nutzernachricht oder einer Aufgabe passiert. Eine Session ist ein Gespräch aus mehreren Läufen. In der Demo ist jedes Kundengespräch eine Session mit zwei Traces. Jeder Trace enthält fünf oder sechs Modellaufrufe.
Ändern Trace-Header das Routing, die Abrechnung oder die Daten, die das Modell sieht?
X-Trace-Id und X-Span-Id ändern nichts. X-Session-Id sorgt für konsistente Prompt-Cache-Treffer innerhalb eines Gesprächs. Keiner der Header wird an den Modellanbieter weitergeleitet. Die Abrechnung richtet sich nach der eigenen Request-ID des Gateways.
Wie lange werden Traces aufbewahrt?
Traces und Sessions werden aus dem Request-Log erstellt und decken dieselben 90 Tage ab. Die Traces-Liste zeigt beim Öffnen die letzten 7 Tage.
Kostet ein fehlgeschlagener Aufruf etwas?
Der fehlgeschlagene Aufruf in der Demo, ein 404 für eine unbekannte Modell-ID, wurde mit Kosten von $0 und dem Hinweis erfasst, dass nichts berechnet wurde.
Weiterführende Artikel
- Einen LLM-Chatbot bauen: der Fall mit einem einzelnen Agenten, samt Kontextverwaltung, Gedächtnis und Prompt-Caching.
- Referenz der Request-Header: alle Header dieser Seite und die Aliase, die aus anderen Tools gelesen werden.
- Traces und Sessions in der Konsole: die Liste, der Wasserfall und die Session-Seite.
- LLM-Token-Verbrauch im Detail: was die Token-Zahlen in den einzelnen Datensätzen je nach Anbieter bedeuten.