
LLM-Agent debuggen: 3 Fehler im Trace, einer mit Status 200
Agent-Läufe eines Nutzers per Label finden und drei Fehler im Trace erkennen: 404 mit Retry, abgebrochene Antworten bei Status 200 und 400 im zweiten Turn.
Unsere Empfehlungen
Live-Preise| Modell | Fazit | Preis |
|---|---|---|
| GPT-6 Luna Wies den zweiten Gesprächsschritt nach 0.5 s mit einem 400 ohne Kosten zurück, als im gespeicherten Verlauf ein Tool-Aufruf fehlte. | Hauptagent in der Demo | ab $0.1/Mio. |
| DeepSeek V4.1 Flash Mit max_tokens auf 40 lieferten drei aufeinanderfolgende Aufrufe den Status 200 und genau 40 Ausgabetokens ohne brauchbare Antwort. Mit erhöhtem Limit und deaktiviertem Reasoning beantwortete ein Aufruf die Anfrage mit 49 Tokens. | Unteragent in der Demo | ab $0.3/Mio. |
Inhalt
- Wie findet man den Lauf eines bestimmten Nutzers?
- Wie sieht ein fehlgeschlagener Aufruf mit Retry aus?
- Warum liefert der Agent nichts, obwohl alle Aufrufe erfolgreich waren?
- Warum scheitert der zweite Turn, obwohl der erste funktioniert hat?
- Was muss jeder Agent dafür loggen?
- FAQ
- Wie debugge ich einen LLM-Agenten in Produktion?
- Warum liefert mein LLM eine leere Antwort mit Status 200?
- Was verursacht „No tool call found for function call output“?
- Sollte ich einen fehlgeschlagenen LLM-Aufruf wiederholen?
- Weiterführende Artikel
„Der Assistent hat mir gestern Nachmittag eine unbrauchbare Antwort gegeben.“ So werden die meisten Agent-Bugs gemeldet: ein Nutzer, eine ungefähre Uhrzeit, keine Request-ID. Um den Lauf zu finden, brauchen die Requests ein Label. Um ihn zu verstehen, braucht man einen Trace. Meist betrifft der Fehler nur einen von mehreren Aufrufen und sieht oft gar nicht wie ein Fehler aus. Dieser Leitfaden zeigt den Weg von der Beschwerde zum fehlerhaften Aufruf. Anschließend reproduzieren wir drei Fehler in einem kleinen Support-Agenten und sehen uns an, wie sie in der Synthorai-Konsole aussehen.
TL;DR
- Mit einem
_user-Label an jedem Request lassen sich die Agent-Läufe eines Nutzers über eine einzige Suche in der Traces-Liste finden. - Ein fehlgeschlagener Aufruf und sein Retry stehen nebeneinander, wenn der Retry dieselbe Trace-ID verwendet. Der 404 in der Demo kostete 95 ms und $0.
- Mit
max_tokens=40bei einem Reasoning-Modell lieferten drei Aufrufe Status 200 mit 40 Output-Tokens, aber keine Antwort. - In der gespeicherten Historie fehlte ein Tool-Aufruf. Dadurch scheiterte der zweite Turn mit einem 400, ohne Kosten zu verursachen.
Dieser Leitfaden baut auf LLM-Agenten mit Traces untersuchen auf. Dort werden die hier verwendeten Request-Header erklärt. Richte die Demo wie dort beschrieben ein (Python 3.10 oder neuer, virtualenv aktiviert). Führe anschließend diese Befehle im selben Verzeichnis von github.com/synthorai-io/use-cases aus:
cd use-cases/agent-tracing
python run.py --fail                    # a failed call with a retry
python incidents.py cut-off bad-history
Die Zahlen auf dieser Seite stammen aus jeweils einem Lauf am 11. Oktober 2026.
| Was im Trace zu sehen ist | Was es bedeutet | Fall |
|---|---|---|
| eine schraffierte Markierung mit Statuscode, danach ein ähnlicher Aufruf | ein Aufruf ist fehlgeschlagen und wurde wiederholt | run.py --fail |
| derselbe Span mehrfach, alle mit 200, die Spalte Output entspricht dem gesetzten Limit | die Antworten werden abgeschnitten, bevor sie brauchbar sind | cut-off |
| ein 400 im zweiten Turn einer Session, 0 Tokens, $0 | der vom Code erstellte Request ist ungültig | bad-history |
Wie findet man den Lauf eines bestimmten Nutzers?
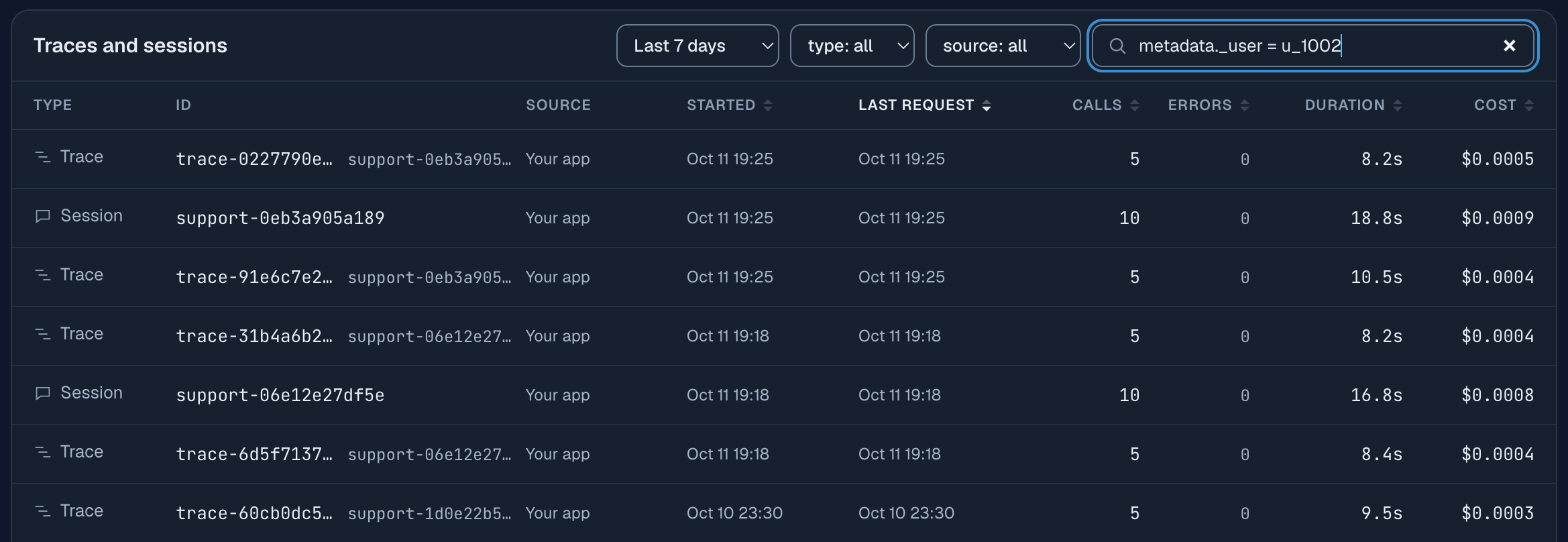
Über das Label, das mit dem Request gesendet wurde. Wenn jeder Request X-Synthorai-Metadata mit einem _user-Schlüssel enthält, reicht ein Filter für die Requests dieses Nutzers:
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}- Öffne Traces, gib
metadata._user = u_1002in das Suchfeld ein und drücke Enter. Wähle einen Zeitraum, der die Beschwerde abdeckt. - Prüfe die Liste. Sie enthält jetzt nur die Sessions dieses Nutzers und deren Traces, jeweils mit Aufrufen, Fehlern, Dauer und Kosten. Die Spalten Calls, Errors, Duration und Cost lassen sich sortieren. Beginne mit Traces, die einen Fehler oder deutlich mehr Aufrufe als die umliegenden Traces haben.
- Öffne den betreffenden Trace. Er zeigt den gesamten Lauf. „Open session“ zeigt den zugehörigen Gesprächsverlauf, „See the calls in Logs“ die einzelnen Requests.
Um einzelne Requests statt ganzer Läufe zu suchen, kannst du dasselbe Label im Filterfeld von Logs verwenden. Dort gibt es außerdem status (error, success, 4xx, 5xx oder einen Code), latency, cost, model, session und trace.
Ohne Labels beginnt die Suche mit dem, was du hast: Eine Trace-ID aus deinen eigenen Logs kommt in das Suchfeld von Traces, eine Request-ID aus einem Response-Header als request_id in den Logs-Filter. Deshalb solltest du den Response-Header x-request-id zusammen mit deinen eigenen Nutzer- und Gesprächs-IDs loggen.
Verwende für _user eine interne Nutzer-ID, keine E-Mail-Adresse und keinen Namen. Labels werden mit dem Request gespeichert.
Wie sieht ein fehlgeschlagener Aufruf mit Retry aus?
Als schraffierte Markierung mit Statuscode neben dem Aufruf, der ihn ersetzt. Im Tracing-Leitfaden verwendet eine von drei parallelen Prüfungen eine Modell-ID, die nicht existiert. Der Trace zeigt policy-check als 95 ms lange Markierung mit dem Label 404 und policy-check.retry als normalen Balken daneben. Die Trace-Zusammenfassung zeigt „6 model calls, 1 failed“, die Session-Seite „1 × 404 Not found“. Der fehlgeschlagene Aufruf kostete $0.
Zwei Entscheidungen im Code machen diese Darstellung verständlich. Der Retry behält die Trace-ID, sodass Fehler und Retry in derselben Ansicht erscheinen. Außerdem bekommt der Retry einen eigenen Span-Namen, damit sich die Versuche unterscheiden lassen. Startet ein Retry einen neuen Trace, sieht das nach zwei unabhängigen Läufen aus, von denen einer ohne erkennbaren Grund fehlgeschlagen ist.
Ein Fehler im Trace ist nicht automatisch ein Problem. Dieser Lauf hat sich erholt, und der Kunde bekam eine Antwort. Der Trace zeigt, was der Fehler gekostet hat: hier 95 ms und keine Gebühren. Damit kannst du entscheiden, ob ein Retry ausreicht oder die Ursache behoben werden muss.
Warum liefert der Agent nichts, obwohl alle Aufrufe erfolgreich waren?
Status 200 bedeutet nur, dass der Request abgeschlossen wurde. In diesem Fall soll der Sub-Agent mit DeepSeek V4.1 Flash bestimmen, welche Richtlinienthemen eine Nachricht betrifft. max_tokens=40 stammt noch aus einem früheren, einfacheren Prompt. Anders als bei den übrigen Sub-Agent-Aufrufen der Demo bleibt Reasoning in der fehlerhaften Variante auf der Standardeinstellung des Modells (think im Codeausschnitt). Das Modell durchläuft erst das Reasoning und antwortet danach. Das Reasoning verbraucht alle 40 Tokens, die Antwort bleibt leer und finish_reason steht auf length. Der Code erkennt die leere Antwort und versucht es erneut, insgesamt drei Mal:
for attempt in range(1, 4):
    resp = await check(run, f"policy-check-{attempt}", prompt, think=variant == "before", max_tokens=limit)
    choice = resp.choices[0]
    if choice.finish_reason != "length" and (choice.message.content or "").strip():
        break                                    # a usable reply; otherwise try again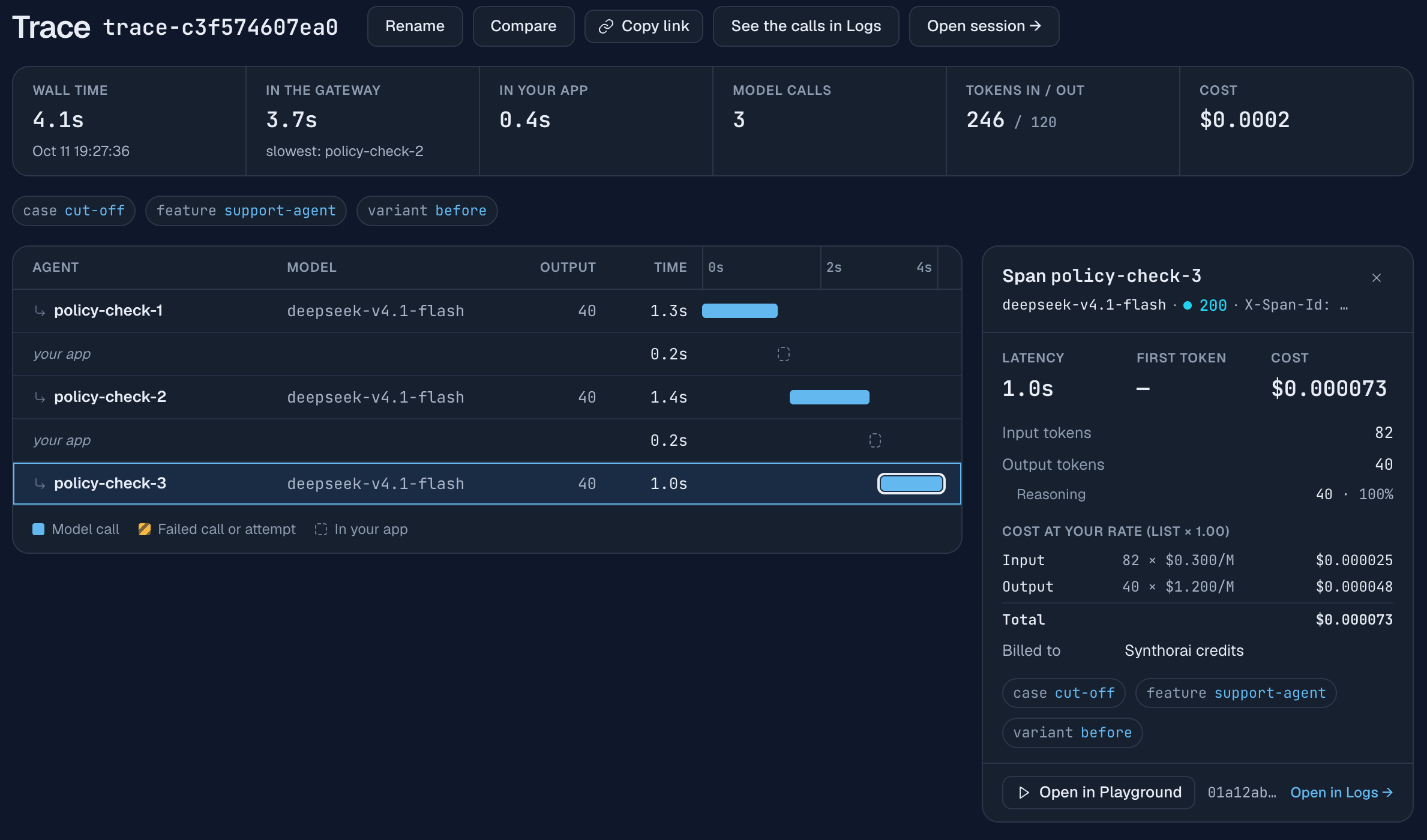
Im Wasserfalldiagramm ist nichts als fehlgeschlagen markiert. Die Hinweise sind der wiederholte Span und die Spalte Output: 40, 40 und 40, genau das Limit. Wählst du einen Aufruf aus, öffnet sich rechts das Detailpanel. Es bestätigt den Befund: Status 200, 40 Output-Tokens und darunter „Reasoning 40 · 100%“.
Entspricht die Zahl der Output-Tokens genau dem gesetzten Limit, deutet das auf eine abgeschnittene Antwort hin. Die korrigierte Variante erhöht das Limit auf 2,000 und schaltet Reasoning für diese Prüfung aus, weil sie es nicht benötigt. Ein einzelner Aufruf liefert dann eine Antwort mit 49 Output-Tokens. Im Trace steht nur noch ein Balken statt drei. Auch das alleinige Erhöhen des Limits beendete die Retries. Dieser eine Aufruf verbrauchte allerdings 1,876 Output-Tokens für Reasoning und dauerte 22 s.
Für deinen eigenen Agenten:
- Prüfe
finish_reasonbei jedem Aufruf.lengthbedeutet, dass die Antwort abgeschnitten wurde. Werte das in deinen eigenen Logs als Fehler, auch bei Status 200. - Bemesse
max_tokensfür Reasoning und Antwort zusammen. Bei einem Reasoning-Modell gilt das Limit für beides. Ist es nur auf die sichtbare Antwort ausgelegt, bleibt möglicherweise kein Platz für sie. - Wiederhole einen abgeschnittenen Aufruf nicht mit demselben Limit. Der zweite Versuch stößt an dieselbe Grenze. Erhöhe das Limit, reduziere den Reasoning-Aufwand oder ändere beides.
Warum scheitert der zweite Turn, obwohl der erste funktioniert hat?
Die Ursache liegt meist darin, was der Code zwischen den Turns gespeichert hat. Ein Modell-Request enthält den gesamten Gesprächsverlauf. Fehler beim Speichern oder Wiederherstellen der Historie fallen deshalb erst ab dem zweiten Turn auf. Hier verwendet der erste Turn Nachrichten aus dem Arbeitsspeicher: GPT-6 Luna ruft ein Tool auf, erhält das Ergebnis und antwortet. Alles funktioniert. Dann speichert der Code den Turn. Er legt die Nachricht des Assistenten nur als Text ab, wodurch der Tool-Aufruf verloren geht, und speichert daneben das Tool-Ergebnis:
# What the app stores for the next turn.
saved = msg.model_dump(exclude_none=True)
if variant == "before":
    saved.pop("tool_calls", None)                # the bug: the assistant message is saved as text only
    saved["content"] = saved.get("content") or ""
history = [saved, *results, {"role": "assistant", "content": answer.choices[0].message.content or ""}]
Wenn der Kunde erneut schreibt, wird der zweite Turn aus dieser gespeicherten Historie aufgebaut. Der Request enthält ein Tool-Ergebnis zu einem Aufruf, der in der Historie nicht mehr existiert. Er wird mit folgender Fehlermeldung abgelehnt („function call output“ ist die Bezeichnung des Providers für ein Tool-Ergebnis):
400 No tool call found for function call output with call_id call_Nqc1zUFvwLLuF5oGMEE9WheQ.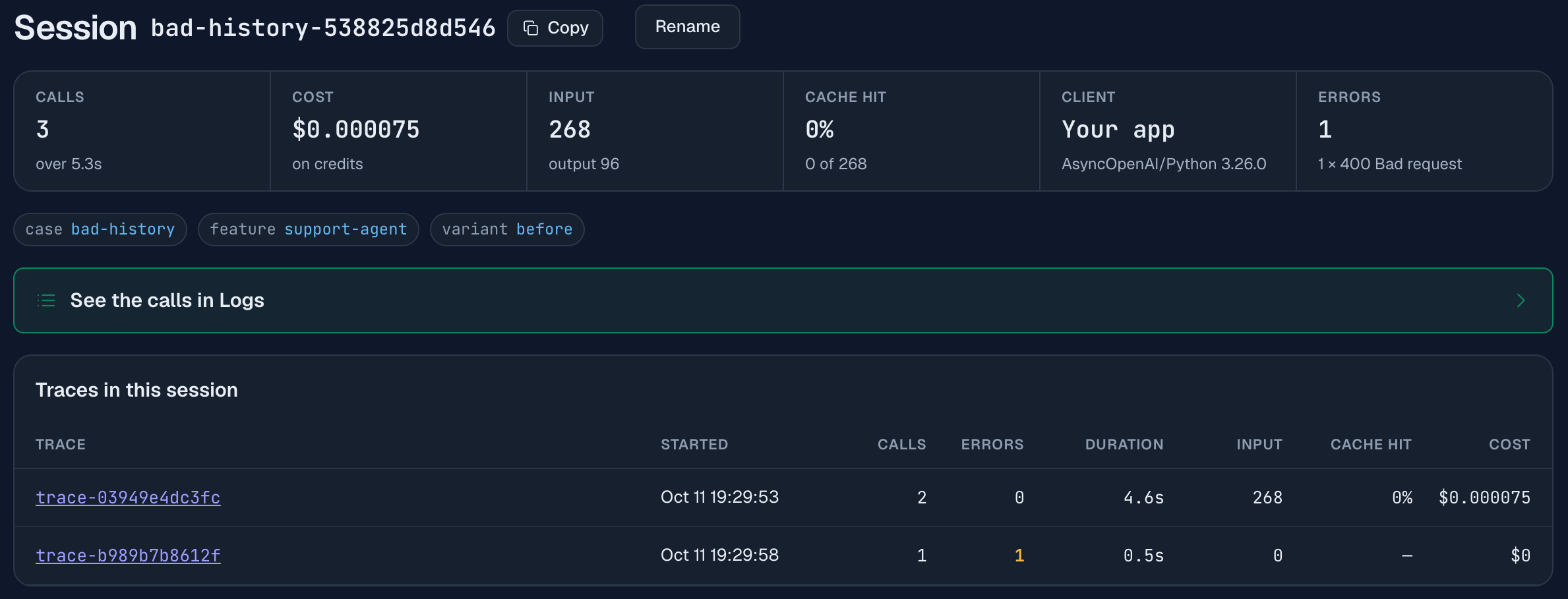
Die Session-Seite zeigt das Muster: zwei Traces, der erste mit 2 Aufrufen und ohne Fehler, der zweite mit 1 Aufruf und 1 Fehler. In der Fehlerkarte steht „1 × 400 Bad request“. Der fehlgeschlagene Trace zeigt 0 Input-Tokens, eine Dauer von 0.5 s und Kosten von $0. Zusammengenommen bedeuten diese drei Werte, dass kein Modell ausgeführt wurde: Der Request wurde als ungültig abgelehnt. Das unterscheidet diesen Fehler von einem Modell- oder Provider-Problem, bei dem Tokens, eine längere Dauer oder ein 5xx-Status zu sehen wären.
Ein 400 weist auf einen Fehler im Request hin. Ein Retry hilft deshalb nicht, und die Fehlermeldung nennt die nötige Korrektur. Wird die Nachricht des Assistenten vollständig gespeichert, funktioniert der zweite Turn.
Dasselbe Muster (erster Turn erfolgreich, späterer Turn abgelehnt) entsteht durch andere Fehler in der Historie: ein Tool-Ergebnis ohne zugehörige Call-ID, Nachrichten in der falschen Reihenfolge oder eine Kürzung mitten in einem Tool-Austausch, bei der das Ergebnis erhalten bleibt und der Aufruf entfernt wird. Wenn du die Historie zur Kostenkontrolle kürzt, schneide zwischen den Turns, nie innerhalb eines Turns.
Was muss jeder Agent dafür loggen?
Logge fünf Dinge:
- Eine Trace-ID pro Lauf und eine Session-ID pro Gespräch, gesendet als
X-Trace-IdundX-Session-Idund zusätzlich in deinen eigenen Logs gespeichert. - Einen Span-Namen pro Aufruf, der Schritt und Versuch benennt, etwa
plan-2oderpolicy-check.retry. - Labels für Nutzer, Feature und Release, gesendet als
X-Synthorai-Metadata. - Den Response-Header
x-request-idjedes Aufrufs, zusammen mit deinen eigenen IDs. finish_reasonund die Anzahl der Output-Tokens jedes Aufrufs, wobeilengthals Fehler zählt.
Setze außerdem für jeden Aufruf einen Client-Timeout und einen Wert für max_tokens. Bemesse beide großzügig. Ohne diese Grenzen kann ein Aufruf so lange laufen, wie das Modell weiterschreibt, und dein Code wartet entsprechend lange. Ein Limit nur für die sichtbare Antwort führt aber zum Fehler aus dem zweiten Fall. Ein Timeout, der kürzer als eine lange Generierung ist, bricht funktionierende Aufrufe ab: Bei einem Reasoning-Modell kann ein einzelner Aufruf Minuten dauern. Die Demo wartet 300 s und begrenzt jeden Aufruf auf 2,000 Output-Tokens, sofern der Aufruf keinen eigenen Wert setzt.
FAQ
Wie debugge ich einen LLM-Agenten in Produktion?
Finde zuerst den Lauf: Filtere deine Request-Logs nach einem Nutzer- oder Gesprächslabel und öffne dann den Trace eines passenden Requests. Der Trace zeigt alle Modellaufrufe des Laufs in ihrer Reihenfolge und markiert fehlgeschlagene Aufrufe. So siehst du, welcher Schritt schiefging, bevor du Code lesen musst.
Warum liefert mein LLM eine leere Antwort mit Status 200?
Meist wurde das Output-Limit erreicht, bevor das Modell seine Antwort schreiben konnte. Bei einem Reasoning-Modell umfasst max_tokens sowohl Reasoning als auch Antwort. Prüfe finish_reason: Steht es auf length und entspricht die Zahl der Output-Tokens dem Limit, wurde die Antwort abgeschnitten. In der Demo lieferten drei Aufrufe hintereinander Status 200 mit genau 40 Output-Tokens und ohne brauchbare Antwort.
Was verursacht „No tool call found for function call output“?
Die Gesprächshistorie enthält ein Tool-Ergebnis, aber der zugehörige Tool-Aufruf fehlt. Das passiert, wenn die Nachricht des Assistenten mit dem Aufruf ohne ihre tool_calls gespeichert wird oder die Historie zwischen Aufruf und Ergebnis gekürzt wird. Speichere die Nachricht des Assistenten vollständig und kürze nur zwischen Turns.
Sollte ich einen fehlgeschlagenen LLM-Aufruf wiederholen?
Das hängt vom Status ab. Ein 429 (Rate-Limit erreicht) oder ein 5xx (Serverfehler) kann bei einem Retry erfolgreich sein. Ein 400 bedeutet, dass der Request fehlerhaft ist, und scheitert erneut auf dieselbe Weise. Eine durch max_tokens abgeschnittene Antwort wird wieder abgeschnitten, wenn das Limit unverändert bleibt. Behalte bei einem Retry die Trace-ID bei, damit beide Versuche im selben Trace erscheinen.
Weiterführende Artikel
- LLM-Agenten mit Traces untersuchen: die Header, das Wasserfalldiagramm und das Beispiel eines fehlgeschlagenen Aufrufs.
- Warum ist mein LLM-Agent langsam?: denselben Trace auf Latenz untersuchen.
- Warum ist mein LLM-Agent teuer?: Kosten anhand von Sessions untersuchen.
- Claude-Code-Kosten nach Sub-Agent: dieselben Ansichten für einen Coding-Agenten, den du nicht selbst geschrieben hast.
- Claude zu deinen LLM-Logs befragen: „Ist ein Request dieses Nutzers fehlgeschlagen?“, beantwortet über MCP.
- Deinem Agenten Tools für Logs geben: dieselben Logs mit einem eigenen Programm lesen und die Kosten der Modell-Tokens ermitteln.
- Referenz der Request-Header: IDs, Labels und ihre Grenzen.