
Warum ist mein LLM-Agent langsam? 3 Ursachen im Trace
Drei Ursachen für langsame Agenten, reproduziert und behoben: serielle Modellaufrufe (3.7 s auf 1.8 s), langsamer eigener Tool-Code und Reasoning bei Ein-Satz-Antworten.
Unsere Empfehlungen
Live-Preise| Modell | Fazit | Preis |
|---|---|---|
| GPT-6 Luna Fünf Antworten mit jeweils einem Satz benötigten im Median 25.6 s bei standardmäßigem Reasoning-Aufwand und 10.2 s mit reasoning_effort auf none, wobei die Anzahl der Ausgabetokens von 1,150 auf 190 sank. | Hauptagent in der Demo | ab $0.1/Mio. |
| DeepSeek V4.1 Flash Drei Prüfungen mit jeweils einem Satz benötigten bei denselben 127 Eingabetokens im Median 3.7 s bei aufeinanderfolgendem Versand und 1.8 s bei gleichzeitigem Versand. | Unteragent in der Demo | ab $0.3/Mio. |
Inhalt
- Wo beginnt die Analyse eines langsamen Agentenlaufs?
- Wie sieht es aus, wenn parallele Aufrufe nacheinander laufen?
- Woran erkennst du, dass dein eigener Code langsam ist?
- Was tun, wenn ein einzelner Modellaufruf langsam ist?
- Was behandelt diese Seite nicht?
- FAQ
- Wie finde ich den langsamsten Schritt eines LLM-Agenten?
- Kosten parallele LLM-Aufrufe mehr als serielle?
- Warum ist ein Modellaufruf langsam, obwohl die Antwort kurz ist?
- Wie messe ich, ob eine Korrektur meinen Agenten beschleunigt hat?
- Kann das Gateway zeigen, was mein Code zwischen zwei Modellaufrufen getan hat?
- Weiterführende Artikel
Ein langsamer Agent hat meistens eines von drei Problemen: Seine Modellaufrufe warten unnötig aufeinander, sein eigener Code ist zwischen den Aufrufen langsam, oder ein Modellaufruf leistet mehr Arbeit, als der Schritt erfordert. Ein Trace zeigt in wenigen Sekunden, welche Ursache vorliegt. Er stellt jeden Aufruf auf einer Zeitachse dar und macht die Lücken dazwischen sichtbar. In dieser Anleitung reproduzieren wir jedes Problem mit einem kleinen Support-Agenten, beheben es und vergleichen den Lauf vor und nach der Korrektur in der Synthorai-Konsole.
TL;DR
- Drei unabhängige Modellaufrufe mit
asyncio.gathergleichzeitig zu senden, senkte den Median von 3.7 s auf 1.8 s bei gleichen Kosten. - Vier simulierte Datenbankabfragen von je 1.1 s gleichzeitig auszuführen, verkürzte die Zeit im eigenen Agenten-Code von 4.6 s auf 1.3 s. Ein anderes Modell hätte daran nichts geändert.
- Reasoning für fünf Ein-Satz-Antworten von GPT-6 Luna abzuschalten (
reasoning_effort="none"), senkte die Zeit von 25.6 s auf 10.2 s und die Anzahl der Output-Token von 1,150 auf 190.
Diese Anleitung baut auf LLM-Agenten mit Traces untersuchen auf. Dort werden die drei Request-Header erklärt, die Modellaufrufe zu einem Trace zusammenfassen. Richte die Demo wie dort beschrieben ein (Python 3.10 oder neuer, aktivierte virtualenv). Führe dann die drei Fälle aus demselben Verzeichnis von github.com/synthorai-io/use-cases aus:
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
Jeder Fall läuft zweimal, zuerst mit dem Problem und dann mit der Korrektur. Pro Lauf wird eine Zeile mit der Trace-ID ausgegeben:
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
Die Modelllatenz schwankt von Aufruf zu Aufruf. Deshalb haben wir jeden Fall am 11. Oktober 2026 fünfmal ausgeführt. Die Tabelle zeigt den Median, in Klammern den schnellsten und den langsamsten Lauf. Ein Lauf der korrigierten Version im dritten Fall schlug fehl; dieser Median basiert daher auf vier Läufen. Die Beispielausgabe oben und die Paare in den Screenshots stammen aus jeweils einem zusätzlichen Lauf, der nicht zu den fünf Messungen gehört. Die Zeiten sind die vom Skript gemessene Gesamtdauer vom Start bis zum Ende.
| Fall | Was der Trace zeigt | Korrektur | Vorher | Nachher |
|---|---|---|---|---|
serial-checks | Balken in Treppenform, ohne Überlappung | unabhängige Aufrufe gleichzeitig senden | 3.7 s (3.5 bis 4.5) | 1.8 s (1.7 bis 2.0) |
slow-tool | eine lange Zeile your app | eigenen Code korrigieren | 11.0 s (9.5 bis 12.2) | 9.2 s (6.7 bis 11.0) |
reasoning | viel mehr Output-Token als in der Antwort | Reasoning-Aufwand reduzieren | 25.6 s für fünf Antworten (19.0 bis 31.8) | 10.2 s (7.9 bis 12.1) |
Wo beginnt die Analyse eines langsamen Agentenlaufs?
Beginne mit der Zusammenfassung oben im Trace. Sie teilt die Gesamtdauer in die Zeit im Gateway und die Zeit in deiner Anwendung auf. Die Gesamtdauer entspricht der Wartezeit des Nutzers. „In the gateway“ umfasst die Zeit, in der mindestens eine Modellanfrage offen war. „In your app“ ist der Rest: die Abschnitte zwischen den Anfragen, in denen nur dein Code lief. Dazu gehört auch die Netzwerkzeit zwischen deinem Code und dem Gateway, bei den Läufen auf dieser Seite einige Zehntelsekunden pro Aufruf.
Diese Aufteilung bestimmt, wo du als Nächstes nachsiehst:
- Überwiegend im Gateway, Balken in Treppenform: Die Aufrufe warten aufeinander. Siehe den ersten Fall.
- Ein großer Anteil in deiner Anwendung: Das Modell ist nicht das Problem. Siehe den zweiten Fall.
- Überwiegend im Gateway, ein langer Balken: Ein Aufruf dominiert. Die Zusammenfassung nennt ihn unter „slowest“. Siehe den dritten Fall.
Um die Wirkung einer Änderung zu sehen, öffne den Trace vor der Änderung, wähle Compare und dann den Trace danach. Die Konsole zeigt beide Läufe auf einer Seite: jede Metrik als A, B und Differenz, jeden Aufruf neben dem gleichnamigen Aufruf und beide Wasserfalldiagramme auf derselben Zeitachse. Alle Abbildungen auf dieser Seite zeigen diese Ansicht.
Wie sieht es aus, wenn parallele Aufrufe nacheinander laufen?
Das Wasserfalldiagramm zeigt eine Treppe: Jeder Balken beginnt dort, wo der vorherige endet. Der Demo-Agent prüft eine Kundennachricht mit DeepSeek V4.1 Flash auf Stimmung, Richtlinienkonformität und Risiko. Jede der drei Prüfungen liefert einen Satz. Keine braucht das Ergebnis einer anderen, aber die fehlerhafte Version wartet in einer Schleife auf jeden Aufruf:
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
Die Korrektur besteht aus einer Zeile:
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))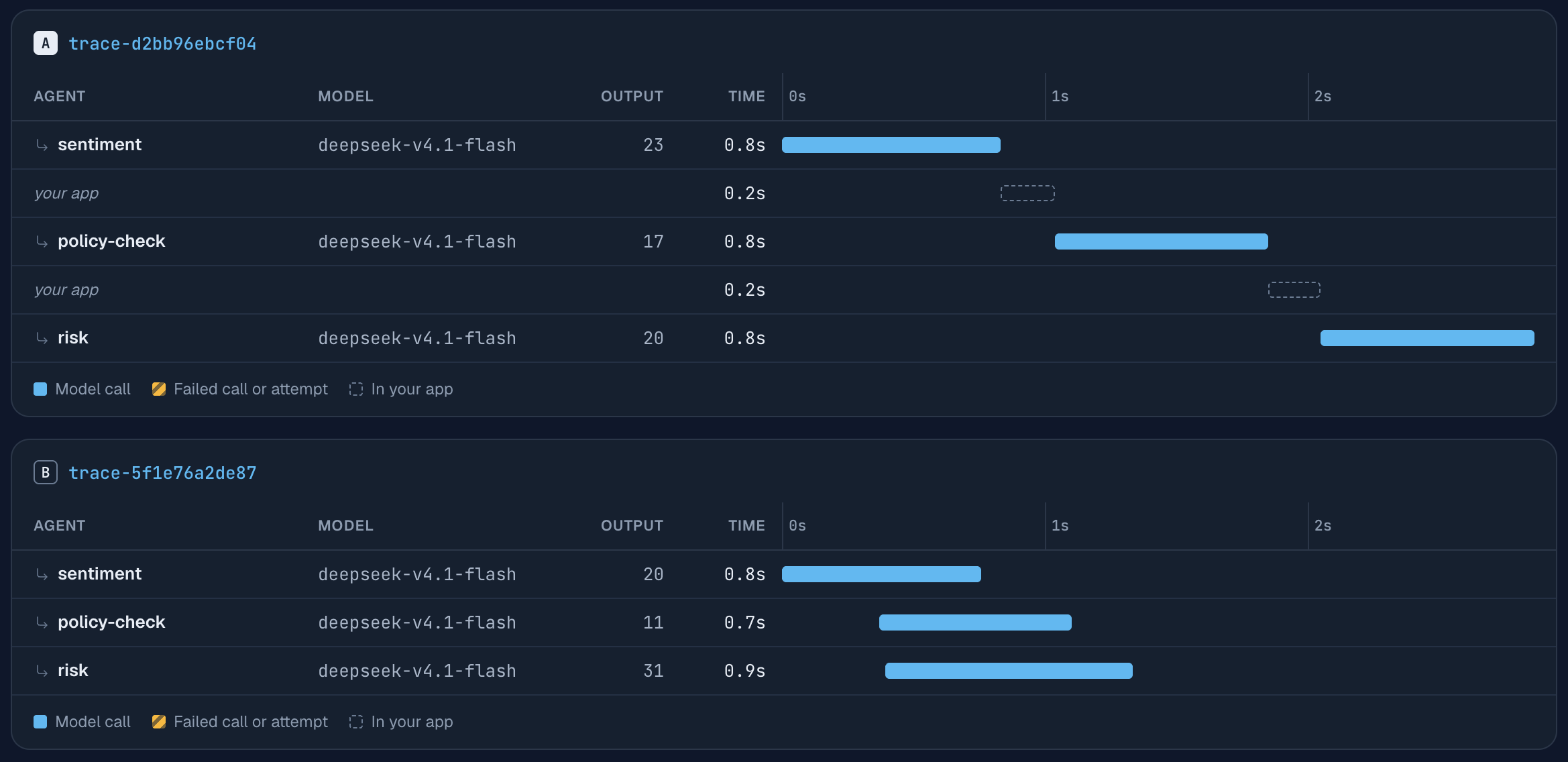
In Trace A beträgt die Gesamtdauer 2.9 s: Die drei Aufrufe dauern jeweils 0.8 s und laufen nacheinander, mit einer Lücke von 0.2 s dazwischen. In Trace B überlappen die Balken, und die Gesamtdauer beträgt 1.3 s. Die Vergleichstabelle auf derselben Konsolenseite, oberhalb des hier gezeigten Ausschnitts, weist eine Verkürzung von 2.9 s auf 1.3 s aus, also um 53.4% (aus ungerundeten Zeiten berechnet). Das Skript maß für dasselbe Paar 3.5 s und 1.5 s, weil es auch den Verbindungsaufbau und die Netzwerkzeit jedes Aufrufs mitzählt.
Der Input ist in beiden Läufen identisch: 127 Token. Die Kosten hängen vom Output ab, dessen Länge zwischen den Läufen leicht schwankt. Dieses Paar kostete $0.000110 und $0.000112. Über fünf Läufe lag der Median bei $0.000105 für die serielle und $0.000109 für die parallele Version. Parallele Aufrufe senden und empfangen dieselben Token und kosten deshalb nicht mehr.
Prüfe bei deinem eigenen Agenten für jedes Paar aufeinanderfolgender Balken, ob der zweite Aufruf den Output des ersten verwendet hat. Falls nicht, können sie überlappen. Aufrufe, die aufeinander aufbauen (erst ein Plan, dann der darin geplante Schritt), müssen nacheinander bleiben.
Woran erkennst du, dass dein eigener Code langsam ist?
Die Zeile your app ist lang. Die fehlerhafte Version dieses Falls beantwortet eine Frage, nachdem sie Kundendaten aus vier Tabellen abgefragt hat, eine Abfrage nach der anderen. Jede Abfrage wird durch einen sleep von 1.1 s simuliert:
rows = [await lookup(t) for t in tables] # four queries, one at a timeAuch hier reicht eine Zeile, um die vier Abfragen gleichzeitig auszuführen:
rows = await asyncio.gather(*(lookup(t) for t in tables))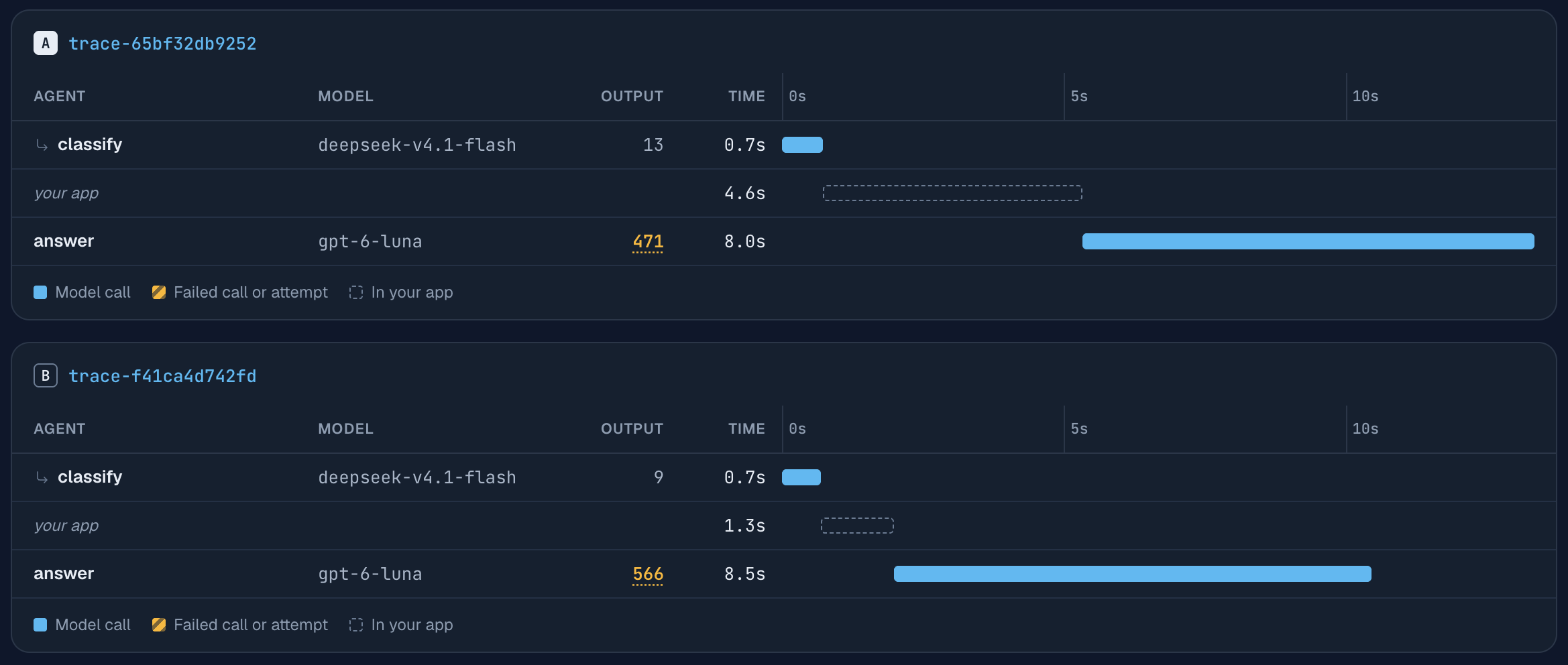
Die korrigierte Zeile verkürzte sich von 4.6 s auf 1.3 s. Die Vergleichstabelle meldet für „In your app“ eine Reduktion um 71.8%, ebenfalls aus ungerundeten Zeiten berechnet. Ein anderes Modell oder ein anderer Prompt hätte diesen Abschnitt nicht verändert: Es war keine Modellanfrage offen, und der Agent wartete auf seine eigenen Datenbankabfragen.
Bei der Gesamtdauer ist der Effekt weniger eindeutig. In diesem Paar sank sie von 13.3 s auf 10.5 s. Die Korrektur sparte im betroffenen Abschnitt 3.3 s, insgesamt aber nur 2.8 s. Die fehlende halbe Sekunde entfällt auf den answer-Aufruf mit GPT-6 Luna: Er erzeugte im ersten Lauf 471 Output-Token und im zweiten 566 und dauerte 8.0 s beziehungsweise 8.5 s. Über die fünf Läufe in der Tabelle überlappten die Zeitbereiche beider Versionen: Die korrigierten Läufe dauerten 6.7 bis 11.0 s, die fehlerhaften 9.5 bis 12.2 s. Ein einzelner korrigierter Lauf kann also langsamer sein als ein einzelner fehlerhafter.
Vergleiche deshalb die geänderte Zeile, nicht die Gesamtdauer eines einzelnen Laufs. Die Tabelle der einzelnen Aufrufe in der Vergleichsansicht übernimmt das: Sie ordnet jedem Aufruf sein Gegenstück zu und zeigt Zeit, Output und Kosten als A und B. Um eine Verbesserung der Gesamtdauer zu belegen, vergleiche die Dauer vieler Traces beider Varianten. Die p95-Latenz in Logs (die Zeit, innerhalb derer 95% der Anfragen abgeschlossen sind) wird diese Korrektur nicht abbilden. Sie misst einzelne Anfragen; hier wurde Zeit zwischen den Anfragen eingespart.
Das Gateway sieht nicht, was dein Code während der Lücke getan hat, sondern nur, wie lange sie dauerte. Ist die Lücke groß und die Ursache unklar, ergänze an dieser Stelle mit OpenTelemetry Spans für deine eigenen Funktionen.
Was tun, wenn ein einzelner Modellaufruf langsam ist?
Sieh dir an, wie viele Token der Aufruf erzeugt hat, denn die Ausgabe kostet Zeit. Ein Reasoning-Modell denkt vor der Antwort nach. Dieses Nachdenken wird als Output-Token abgerechnet und zeitlich erfasst, auch wenn die sichtbare Antwort nur aus einem Satz besteht. Die fehlerhafte Version dieses Falls stellt GPT-6 Luna fünf kurze Fragen zu Richtlinien, jeweils mit der Anweisung „Antworte in einem Satz“, und belässt den Reasoning-Aufwand beim Standardwert. Die korrigierte Version ergänzt einen Parameter:
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")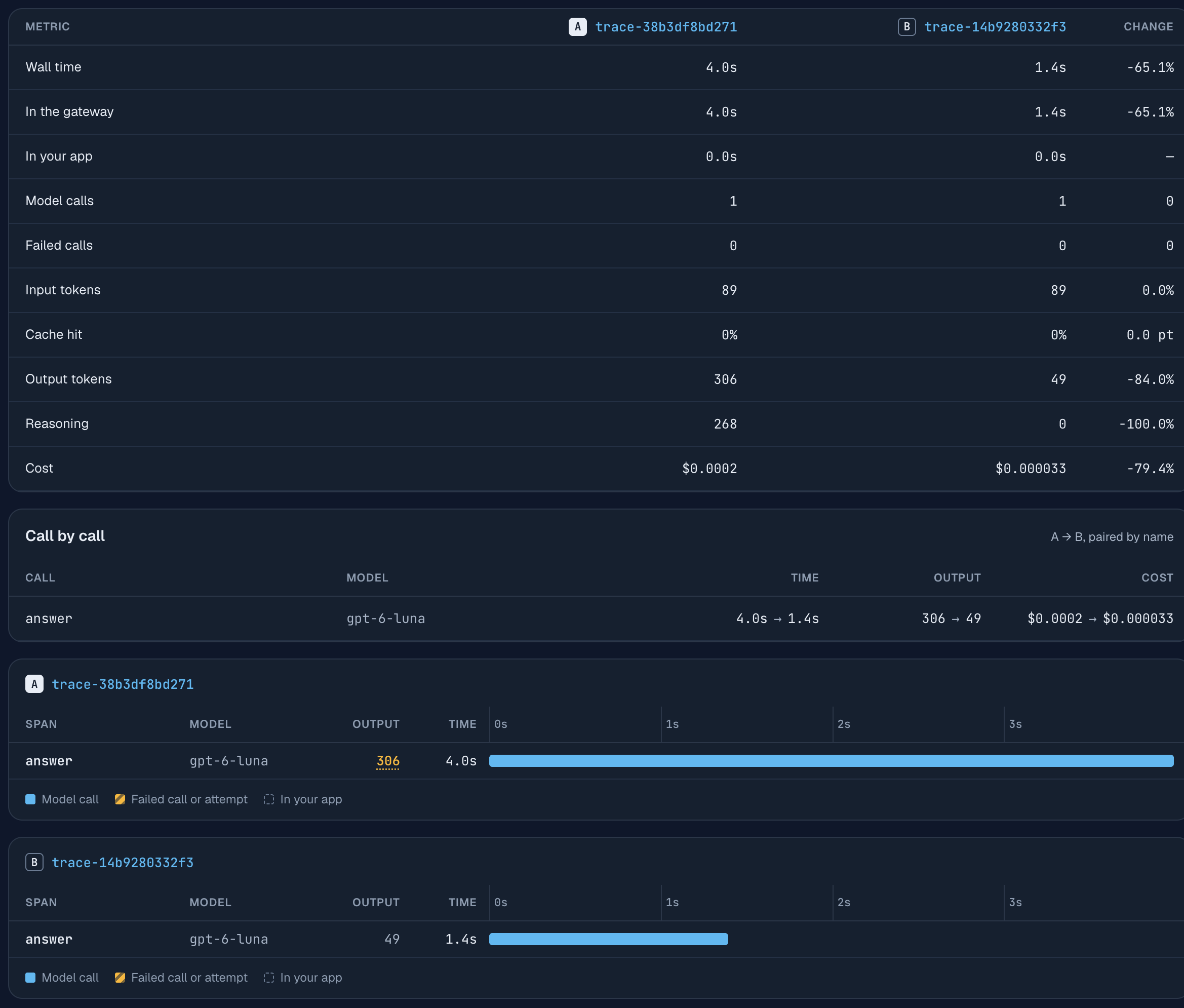
Das ist die erste der fünf Fragen, vor und nach der Änderung. Die Antwort besteht in beiden Fällen aus einem Satz. Mit dem Standardwert erzeugte das Modell dafür 306 Output-Token, davon 268 für Reasoning, und brauchte 4.0 s. Ohne Reasoning erzeugte es 49 Token und brauchte 1.4 s. Die Kosten des Aufrufs sanken von $0.00016, in der Konsole auf $0.0002 gerundet, auf $0.000033.
| Fünf Ein-Satz-Antworten (Median aus fünf Läufen, vier für die zweite Zeile) | Zeit | Output-Token | Kosten |
|---|---|---|---|
| Standardwert für den Reasoning-Aufwand | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
Um das zu erkennen, brauchst du keinen Vergleich. Das Wasserfalldiagramm hat eine Spalte Output. Es unterstreicht die Token-Anzahl eines Aufrufs, wenn bei einem größeren Output der überwiegende Teil auf Reasoning entfällt, wie bei den 306 oben. Wähle den Aufruf aus: Im Detailbereich stehen die Reasoning-Token in einer eigenen Zeile unter den Output-Token.
Reasoning abzuschalten passt zu solchen Schritten: Daten nachschlagen, klassifizieren, ein Tool-Ergebnis umformulieren. Für Aufgaben, die mehrere Denkschritte erfordern, ist es die falsche Wahl. Diese Demo testet solche Aufgaben nicht. Unsere Messungen zu GPT-6 Luna zeigen Reasoning-Token und Kosten pro Antwort für jede Einstellung. Die Anleitung zum Reasoning-Aufwand listet auf, welche Modelle welche Werte akzeptieren. Passe die Einstellung pro Schritt an und prüfe dessen Antworten vor und nach der Änderung.
Was behandelt diese Seite nicht?
Zwei Dinge bleiben außen vor. Das erste ist die gefühlte Antwortgeschwindigkeit. Streaming verkürzt den Aufruf nicht, aber der Nutzer sieht früher Text. Bei einer Chat-Antwort ist das oft entscheidend. Im Detailbereich eines Aufrufs gibt es dafür das Feld First token. In diesen Traces ist es leer, weil die Demo kein Streaming verwendet.
Das zweite sind Ursachen außerhalb deines Agenten: ein Provider, der gerade langsam ist, oder ein Rate Limit, durch das dein Client warten und die Anfrage wiederholen muss. Sie erscheinen als ein langer Balken oder als fehlgeschlagener Aufruf mit anschließendem Retry. Eine Änderung an der Struktur deines Codes behebt sie nicht.
FAQ
Wie finde ich den langsamsten Schritt eines LLM-Agenten?
Öffne den Trace des Laufs und lies die Zusammenfassung. Sie nennt den langsamsten Aufruf und teilt die Gesamtdauer in Zeit im Gateway und Zeit in deiner Anwendung auf. Das Wasserfalldiagramm darunter zeigt jeden Aufruf als Balken. Untersuche den längsten Balken oder die längste Zeile your app.
Kosten parallele LLM-Aufrufe mehr als serielle?
Nein. In der Demo kosteten drei nacheinander gesendete Prüfungen im Median $0.000105 und parallel gesendete $0.000109, bei denselben 127 Input-Token. Der Unterschied entsteht durch die zwischen den Läufen schwankende Output-Länge. Die Kosten hängen von den Token ab, und parallele Aufrufe senden und empfangen dieselben Token. Achte auf dein Rate Limit, weil parallele Aufrufe gleichzeitig eintreffen.
Warum ist ein Modellaufruf langsam, obwohl die Antwort kurz ist?
Meist hat das Modell zuerst nachgedacht. Reasoning wird als Output-Token erzeugt, die in der Antwort nicht sichtbar sind. Fünf Ein-Satz-Antworten mit GPT-6 Luna verbrauchten beim Standardwert für den Reasoning-Aufwand im Median 1,150 Output-Token, mit reasoning_effort="none" dagegen 190.
Wie messe ich, ob eine Korrektur meinen Agenten beschleunigt hat?
Vergleiche den geänderten Abschnitt, nicht eine einzelne Gesamtdauer. In der Demo verkürzten vier gleichzeitig ausgeführte Abfragen die Zeit im eigenen Code von 4.6 s auf 1.3 s. Die Gesamtdauer einzelner Läufe nach der Korrektur lag trotzdem zwischen 6.7 s und 11.0 s, weil ein Modellaufruf schwankte. Vergleiche anhand der Trace-Dauer viele Läufe jeder Version.
Kann das Gateway zeigen, was mein Code zwischen zwei Modellaufrufen getan hat?
Es zeigt die Dauer der Lücke als Zeile your app, aber nicht, was darin passiert ist. Für Spans innerhalb deines eigenen Codes verwende ein OpenTelemetry SDK und reiche dessen traceparent-Header weiter, damit beide Ansichten dieselbe Trace-ID verwenden.
Weiterführende Artikel
- LLM-Agenten mit Traces untersuchen: die Header und das Wasserfalldiagramm, die diese Seite verwendet.
- Warum ist mein LLM-Agent teuer?: dieselbe Methode für die Kostenanalyse.
- LLM-Agenten debuggen: von der Nutzerbeschwerde zum fehlerhaften Aufruf.
- Claude-Code-Kosten nach Sub-Agent: dieselben Ansichten für einen Coding-Agenten, den du nicht selbst geschrieben hast.
- Claude zu deinen LLM-Logs befragen: Fragen zum Request-Log, beantwortet über MCP.
- Deinem Agenten Tools für Logs geben: dasselbe Log mit einem eigenen Programm lesen und die Kosten der Modell-Token ermitteln.
- GPT-6 Luna vs GPT-5.6 Luna: Reasoning-Token und Kosten pro Antwort für jede Einstellung des Reasoning-Aufwands.