
Melhor API LLM Flash 2026: GLM em custo, Gemini 3.8 em força
Conteúdo
- Como os nove se comparam e como fizemos os testes?
- Quais modelos entram na categoria Flash e vale migrar para o mais novo?
- Quanto custam os nove modelos?
- Que tipos de entrada cada modelo aceita? É possível desligar o thinking?
- Quanto custa uma tarefa completa, não apenas um token?
- Qual modelo Flash escolher?
- Quais modelos Flash falham na configuração padrão?
- Um modelo Flash basta ou é preciso usar o modelo maior?
- O que quebra ao colocar um modelo Flash em produção?
- Como a Synthorai lida com isso
- Perguntas frequentes
A melhor API LLM da categoria Flash em setembro de 2026 depende do que você precisa: GLM 5.3 Flash entrega a maior pontuação em benchmarks por dólar, Gemini 3.8 Flash é o modelo mais forte no geral e a escolha para áudio e vídeo, Claude Sonnet 5 inventa menos respostas pelo preço mais alto, e Seed 2.0 Mini é o modelo mais barato que passou em todos os nossos testes. Categoria Flash significa o modelo pequeno e rápido de cada fornecedor. Avaliamos dezesseis modelos. Todos os modelos atuais superaram o pequeno da geração anterior de seu fornecedor. Comparamos os nove atuais por preço de tabela, preço de cache, tipos de entrada, controles de thinking, benchmarks independentes, custo por tarefa e problemas encontrados em produção.
TL;DR
- Migre para o modelo atual de cada fornecedor: Claude Sonnet 5, GPT-5.6 Terra e Gemini 3.8 Flash custam mais por token que Haiku 4.5, GPT-5.4 mini e Gemini 3.5 Flash-Lite, mas custam de 2.5 a 3.9 vezes menos por resposta correta.
- Melhor custo-benefício: GLM 5.3 Flash, com índice 41.9 no Artificial Analysis por $0.25 por tarefa.
- Mais forte e melhor multimodal: Gemini 3.8 Flash.
- Menos respostas inventadas: Claude Sonnet 5, com o maior custo por tarefa.
- Mais barato: Seed 2.0 Mini por $0.10 / $0.40.
Como os nove se comparam e como fizemos os testes?
Preços e recursos vêm das páginas dos fornecedores. Os benchmarks vêm de rankings independentes que executam todos os modelos na mesma infraestrutura. Nosso teste serve como critério de admissão, não como ranking. Usamos o Intelligence Index v4.3 do Artificial Analysis (AA) e sua taxa de não alucinação (a frequência com que o modelo se recusa a responder em vez de chutar), além de LiveBench, Vals Index e votos de texto e WebDev do Arena. Nosso teste reúne 11 tarefas com respostas numéricas verificáveis (contagem de dígitos, soma de primos, caminhos em grade, troca de moedas, potência modular, knapsack e outras semelhantes), com 3 execuções por tarefa. Também fizemos cinco perguntas sobre uma empresa, um instituto, uma cidade, uma liga metálica e um prêmio inexistentes. Lemos as respostas completas para verificar se o modelo recusava ou inventava. Thinking são os tokens de raciocínio gerados antes da resposta. Eles são cobrados como saída e configurados em cada request por um campo como reasoning_effort. Executamos cada modelo com a configuração padrão e com todas as configurações de thinking aceitas.
| Modelo | Índice AA | AA sem alucinação | LiveBench | Vals Index | Arena texto / WebDev | Nosso teste: padrão / melhor | Inventadas no padrão |
|---|---|---|---|---|---|---|---|
| GPT-5.6 Terra | 42.3 em max | 12.1 | 77.9 | 59.6 | 1466 / 1521 | 31 / 33 | 2 de 5 |
| GLM 5.3 Flash | 41.9 | 72.4 | 71.6 | 47.2 | 1475 / 1607 | 31 / 31 | 0 de 5 |
| Gemini 3.8 Flash | 41.2 em high | 44.8 | 75.8 | 62.3 | 1493 / 1568 | 32 / 33 | 0 de 5 |
| Qwen3.8 Flash | 39.9 | 54.7 | 76.2 | não listado | não listado / 1635 | 33 / 33 | 2 de 5 |
| DeepSeek V4.1 Flash | 39.5 em max | 3.5 | 81.1 | 57.9 | não listado / 1614 | 33 / 33 | 4 de 5 |
| Claude Sonnet 5 | 38.4 em max | 60.6 | 76.0 | 59.6 | 1461 / 1537 | 33 / 33 | 0 de 5 |
| GPT-5.6 Luna | 37.5 em max | 7.4 | 73.6 | 59.9 | 1453 / 1519 | 31 / 32 | 4 de 5 |
| Hy3 | 25.8 | 25.9 | não listado | não listado | 1456 / 1513 | 33 / 33 | 0 de 5 |
| Seed 2.0 Mini | não listado | não listado | não listado | não listado | não listado | 33 / 33 | 0 de 5 |
Fontes consultadas em 2026-09-17: Artificial Analysis, LiveBench, Vals Index, Arena texto e Arena WebDev. As pontuações do Arena seguem o estilo Elo, em que uma diferença de 20 pontos é pequena. O Qwen3.8 Flash aparece nesses rankings como Qwen3.8-Flash-Next, o modelo de pesos abertos por trás da API. As medições foram realizadas em 2026-09-16 e 17. Dois modelos foram executados novamente no segundo dia para confirmar que os resultados dos dois dias eram comparáveis.
Nenhum modelo lidera todos os rankings: Terra vence no índice, DeepSeek no LiveBench, Gemini 3.8 Flash no Vals e no Arena texto, e Qwen3.8 Flash no Arena WebDev. A taxa de não alucinação do AA e nossas cinco perguntas inventadas apontam os mesmos modelos que chutam: DeepSeek V4.1 Flash, Luna e Terra raramente recusam; GLM 5.3 Flash e Sonnet 5 costumam recusar. Seed 2.0 Mini não aparece em nenhum benchmark independente. Nosso teste é a única evidência disponível para ele.
Quais modelos entram na categoria Flash e vale migrar para o mais novo?
O modelo pequeno mais recente de cada fornecedor entra, e vale migrar. Google, DeepSeek, Alibaba, Z.ai, ByteDance e Tencent chamam os seus de Flash, Mini ou oferecem um único modelo barato. A geração atual da Anthropic é formada por Fable, Opus e Sonnet. O Haiku 4.5 pertence à geração anterior (outubro de 2025, com desativação não antes de 15 de outubro de 2026), então tratamos o Claude Sonnet 5 como a categoria Flash do Claude. A documentação da OpenAI posiciona o GPT-5.6 Terra na antiga categoria mini e o GPT-5.6 Luna na nano. Sonnet 5 ($2 / $10) e Terra ($2 / $12) custam várias vezes mais por token que os outros sete e formam uma faixa de preço própria mais abaixo.
Também avaliamos o modelo pequeno anterior de quatro fornecedores. Para cada um, calculamos o custo por resposta correta: todo o valor gasto nas 33 execuções dividido pelo número de acertos. Assim, um modelo que acerta metade das vezes paga o dobro por resposta. O modelo atual venceu em todos os pares. Nos três pares citados no TL;DR, ele custou mais por token, mas menos por resposta correta:
- Claude Sonnet 5 em vez de Claude Haiku 4.5. O Haiku só chegou a 32 de 33 com thinking no máximo. O Sonnet 5 fez 33 de 33 em todas as configurações com thinking e, em
max, sua configuração mais barata, custou 2.9 vezes menos por resposta correta. Ambos recusaram as cinco perguntas inventadas. - GPT-5.6 Terra em vez de GPT-5.4 mini. O mini fez 9 de 33 na configuração padrão e precisou de
highpara chegar a 33. O Terra fez 33 emlowpor um custo 2.5 vezes menor. O Terra inventou duas respostas, enquanto o mini recusou as cinco. - Gemini 3.8 Flash em vez de Gemini 3.5 Flash-Lite e Gemini 3.7 Flash. Contra o Flash-Lite, custou 3.9 vezes menos por resposta correta e recusou as três perguntas inventadas que o Flash-Lite respondeu. O Flash-Lite ainda faz sentido apenas para extrações de uma etapa. Contra o 3.7 Flash, o preço de tabela é igual e o 3.8 custa cerca de 10% mais por chamada. Essa migração compra capacidade, não economia.
- GPT-5.6 Luna em vez de GPT-5.4 nano, por cerca de um terço do custo por resposta correta e os mesmos 31 acertos em 33. Também Qwen3.8 Flash em vez de Qwen3.6 Flash e Qwen3.5 Flash, que usam cerca de dez vezes mais thinking e custam de 6 a 27 vezes mais por resposta correta.
O restante deste artigo considera apenas os nove modelos atuais.
Quanto custam os nove modelos?
Há três faixas pelo preço de tabela da saída. A barra mostra nosso custo medido por resposta correta na melhor configuração de cada modelo. Assim, um preço de tabela baixo combinado com um uso caro de thinking aparece no mesmo número. O rótulo traz o preço de tabela e o preço de leitura do cache, isto é, quanto custa um prefixo repetido do prompt como proporção do preço de entrada.
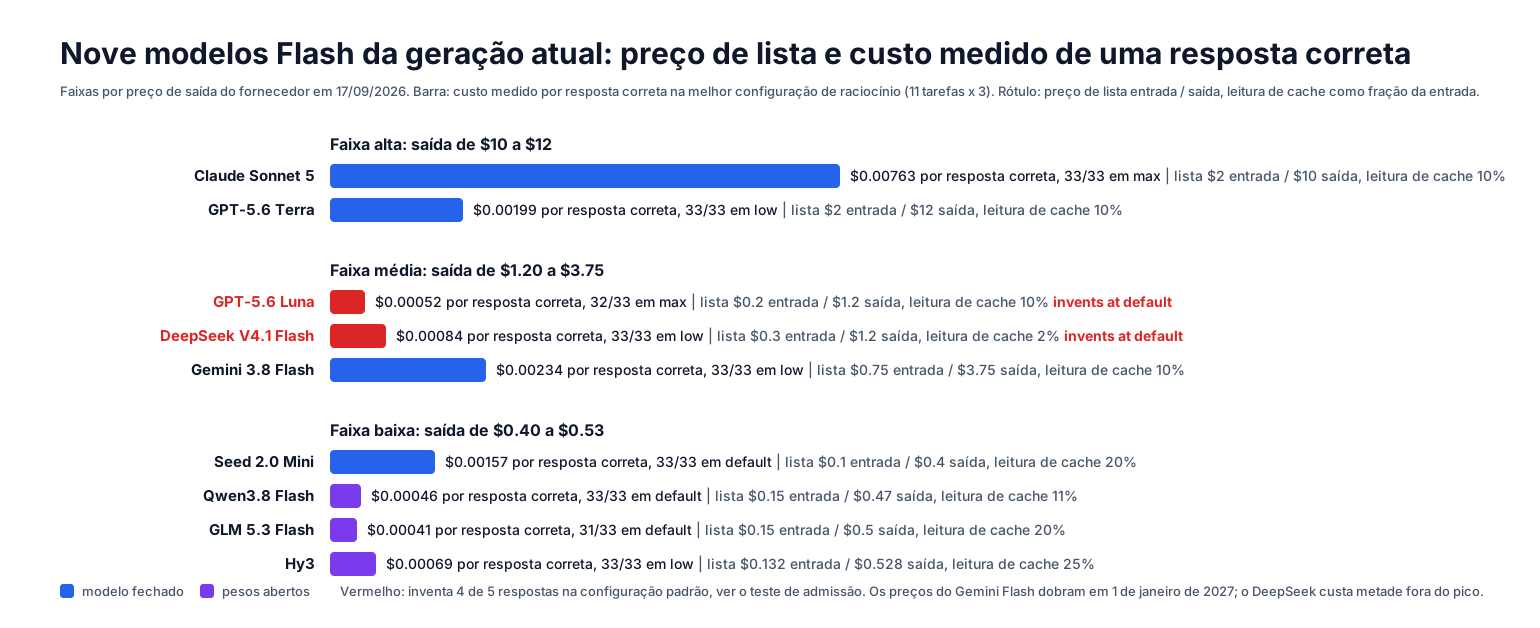
A faixa de preço prevê mal o valor da fatura. O GPT-5.6 Terra, na faixa mais cara, custou menos por resposta correta que o Gemini 3.8 Flash e apenas cerca de um quarto a mais que o Seed 2.0 Mini. O gasto do modelo com thinking afeta o custo tanto quanto o preço de tabela. Os preços também mudam com frequência e variam conforme horário e região. Os preços dos modelos Google 3.x Flash dobram em 1º de janeiro de 2027 (Gemini 3.8 Flash passa para $1.50 / $7.50). O DeepSeek cobra metade fora dos períodos de 01:00 a 04:00 e de 06:00 a 10:00 UTC em dias úteis. A OpenAI reduziu o preço do GPT-5.6 Luna em 80% em julho. O Qwen3.8 Flash custa de 19 a 25% menos fora da região de Singapura da Alibaba. Três modelos pequenos atuais não estavam disponíveis na Synthorai nos dias dos testes e não foram medidos: Mistral Small 4 ($0.15 / $0.60), StepFun Step 3.7 Flash ($0.20 / $1.15) e Amazon Nova 2 Lite ($0.30 / $2.50).
Que tipos de entrada cada modelo aceita? É possível desligar o thinking?
Oito dos nove aceitam imagens, quatro recebem vídeo, dois recebem áudio, e o Hy3, Hunyuan 3 da Tencent, lê apenas texto. A última coluna mostra se a extração JSON com schema estrito retornou valores corretos em 8 execuções de uma extração de fatura.
| Modelo | Entrada | Contexto / saída máxima | Pesos abertos | Permite desligar thinking | Thinking padrão | JSON com schema |
|---|---|---|---|---|---|---|
| Claude Sonnet 5 | texto, imagem | 1M / 128K | não | sim | adaptive, high | 8/8 via tool call |
| GPT-5.6 Terra | texto, imagem | 1.05M / 128K | não | sim | medium | 8/8 |
| Gemini 3.8 Flash | texto, imagem, áudio, vídeo, PDF | 1M / 64K | não | não | medium | 8/8 |
| GPT-5.6 Luna | texto, imagem | 1.05M / 128K | não | sim | medium | 8/8 |
| DeepSeek V4.1 Flash | texto, imagem | 1M / 384K | MIT | sim | high | apenas json_object, 8/8 |
| Seed 2.0 Mini | texto, imagem, áudio, vídeo | 256K / 128K | não | sim | medium | 8/8 |
| Qwen3.8 Flash | texto, imagem, vídeo | 1M / 128K | licença Qwen | sim | xhigh | 3/8, inteiros errados |
| GLM 5.3 Flash | texto, imagem, vídeo, arquivo | 1M / 128K | MIT | não | max | apenas json_object, 8/8 |
| Hy3 | texto | 256K / 128K | Apache 2.0 | sim | high | apenas json_object, 7/8 |
“Via tool call” significa que o schema foi enviado como entrada de uma ferramenta e o Claude foi obrigado a chamá-la. “Apenas json_object” significa que o schema estrito não retornou corretamente no caminho de request usado em nosso teste, mas {"type": "json_object"} funcionou quando informamos as chaves no prompt. Para entrada de áudio, escolha Gemini 3.8 Flash ou Seed 2.0 Mini. Para saída acima de 128K, DeepSeek V4.1 Flash. Para hospedar os pesos por conta própria, DeepSeek, GLM, Hy3 ou Qwen3.8 Flash.
Quanto custa uma tarefa completa, não apenas um token?
O custo de uma chamada é o preço multiplicado pelos tokens que o modelo decide gastar. Nesta categoria, o segundo fator varia mais que o primeiro. A medida pública mais justa é o custo calculado pelo Artificial Analysis para executar uma tarefa de seu índice, contando os tokens de thinking. Há dados para oito dos nove modelos.
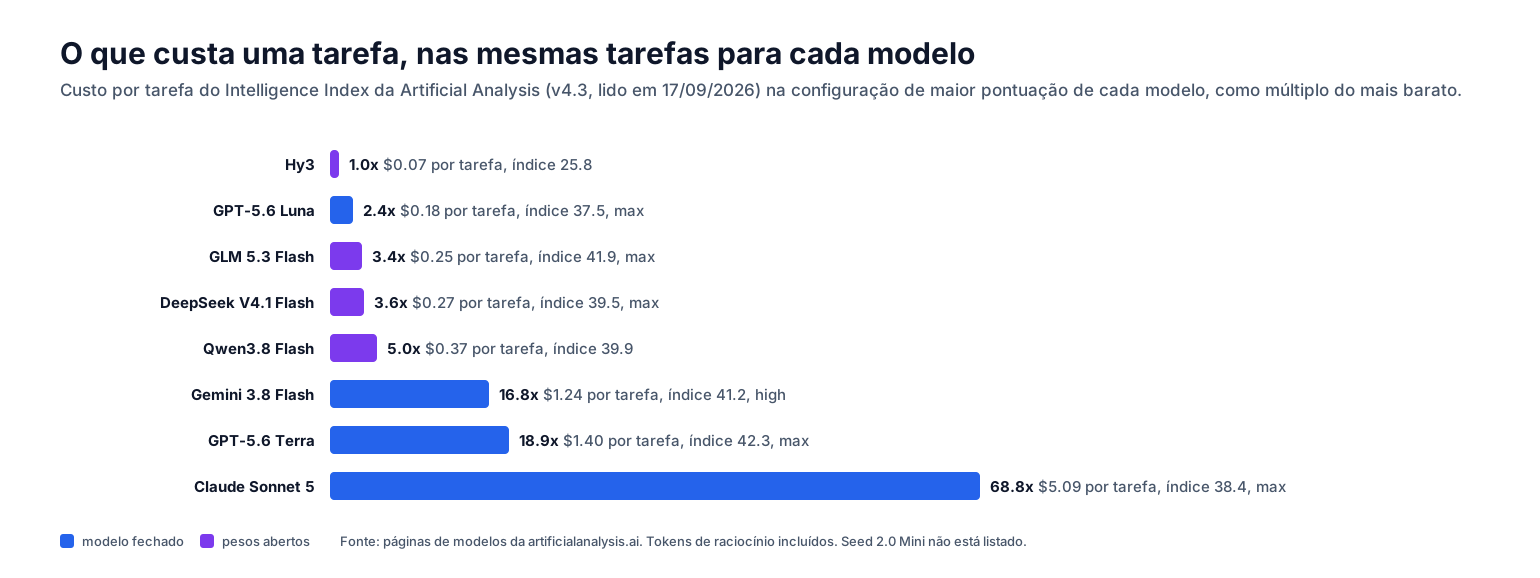
O GLM 5.3 Flash fica a menos de meio ponto do GPT-5.6 Terra por um quinto do custo por tarefa. O Qwen3.8 Flash tem preço de tabela quase igual ao do GLM, mas custa 50% a mais por tarefa. Para executar o índice, ele gerou 240 milhões de tokens de saída, contra 180 milhões do GLM. O Claude Sonnet 5 em max custa $5.09 por tarefa, contra $1.79 no padrão high, em troca de seis pontos adicionais no índice. Nossas chamadas isoladas mostram o mesmo efeito. O Seed 2.0 Mini tem preço de tabela menor que o Qwen3.8 Flash, mas custou 3.4 vezes mais por resposta correta porque usou uma mediana de 2,810 tokens de thinking por tarefa, contra 530.
Leituras de cache custam 2% da entrada no DeepSeek, cerca de 10% no Google, OpenAI, Anthropic e Alibaba, 20% na Z.ai e ByteDance, e 25% na Tencent. Em tráfego de agentes e RAG (geração aumentada por recuperação, em que documentos recuperados são incluídos em cada prompt), o preço de leitura define a fatura. Um prefixo em cache de 100K tokens custa $0.0006 por chamada no DeepSeek V4.1 Flash, contra $0.02 no Sonnet 5 ou Terra. A OpenRouter informou que, em um dia após o lançamento, 90% dos tokens atendidos pelo V4.1 Flash eram leituras de cache (publicação). As modalidades batch, com resposta em algumas horas, reduzem pela metade os preços do Gemini 3.8 Flash, GPT-5.6 Luna, Terra e Sonnet 5. Qwen3.8 Flash, GLM 5.3 Flash e Hy3 não oferecem essa modalidade.
Qual modelo Flash escolher?
GLM 5.3 Flash para custo-benefício, Gemini 3.8 Flash para capacidade e entrada multimodal, Claude Sonnet 5 para reduzir respostas inventadas, Seed 2.0 Mini para preço.
| Necessidade | Escolha | Motivo |
|---|---|---|
| Melhor custo-benefício | GLM 5.3 Flash | índice 41.9, atrás apenas do Terra, por $0.25 por tarefa; maior taxa de não alucinação dos nove (72.4); $0.15 / $0.50; entrada de imagem, vídeo e arquivo; pesos MIT |
| Mais forte no geral | Gemini 3.8 Flash | lidera o Vals e o Arena texto entre os nove, fica 1.1 ponto no índice atrás do Terra por 11% menos por tarefa; 33 de 33 em low, recusou todas as perguntas inventadas |
| Melhor multimodal | Gemini 3.8 Flash | entrada de áudio, vídeo e PDF, com áudio cobrado como texto; JSON com schema em 8 de 8 |
| Menos respostas inventadas, com rapidez | Claude Sonnet 5 | 33 de 33 em todas as configurações com thinking, recusou as cinco perguntas inventadas com thinking ligado e desligado, primeiro token da resposta em 2.2 segundos; é o mais caro por tarefa, então use quando uma resposta inventada custar mais que a chamada |
| Mais barato | Seed 2.0 Mini | $0.10 / $0.40; 33 de 33 no padrão, JSON com schema em 8 de 8, recusou as cinco perguntas inventadas, entrada de áudio e vídeo |
Três modelos ficam sem recomendação por um motivo cada. O GPT-5.6 Terra tem o maior índice e fez 33 de 33 em low por $0.00199 por resposta correta, mas inventou duas de cinco respostas cobrando $12 por milhão de tokens de saída. O DeepSeek V4.1 Flash lidera o LiveBench e tem o cache mais barato, mas aceita apenas texto e imagens e inventou quatro de cinco respostas com thinking ligado. O Qwen3.8 Flash obteve a pontuação perfeita mais barata em nosso teste, $0.00046 por resposta correta, e lidera o Arena WebDev. Porém, inventou duas respostas, escreveu inteiros errados com schema estrito e levou quase três minutos para produzir uma explicação de 400 palavras.
Em vez de escolher um único modelo, roteie por tipo de request. Envie tarefas fechadas com resposta verificável para o modelo mais barato que passa no teste (GLM 5.3 Flash, Qwen3.8 Flash, Hy3). Envie perguntas factuais abertas para um modelo que saiba recusar (GLM 5.3 Flash, Sonnet 5, Gemini 3.8 Flash). Para execuções longas de agentes, use o modelo mais forte que couber no orçamento.
Quais modelos Flash falham na configuração padrão?
Dois dos nove. Ambos passam quando perguntas abertas são enviadas para uma configuração que sabe recusar. Aplicamos estes mínimos de admissão à configuração de fábrica: pelo menos 30 acertos em 33 tarefas e no máximo duas respostas inventadas em cinco.
| Modelo | Na configuração padrão | Mudança | Depois da mudança |
|---|---|---|---|
| DeepSeek V4.1 Flash | inventou 4 de 5 (“50 funcionários”, “1790 °C”, um personagem de Simpsons como vencedor de um prêmio) | desligar thinking para perguntas abertas | recusou 5 de 5, mas fez 21 de 33 nas tarefas; envie apenas perguntas abertas para essa configuração |
| GPT-5.6 Luna | inventou 4 de 5 (“aproximadamente 20 funcionários”, “1974”, “1,400 °C”) | desligar thinking para perguntas abertas | recusou 4 de 5, mas fez 7 de 33 nas tarefas; aplique o mesmo roteamento |
O GPT-5.6 Terra e o Qwen3.8 Flash ficam exatamente no limite, com duas respostas inventadas cada (“0 funcionários” e “cerca de 1,455 °C” no Terra). Aplique o mesmo cuidado em perguntas abertas.
Um modelo Flash basta ou é preciso usar o modelo maior?
Para tarefas delimitadas, basta. Nos benchmarks mais curtos de agentes, em que o modelo trabalha em um shell com repositórios reais, o DeepSeek V4.1 Flash supera o DeepSeek V4 Pro no Terminal-Bench 2.1 (90.6 contra 87.9) e no DeepSWE (74.2 contra 62.7). O Gemini 3.8 Flash faz 89.4 no Terminal-Bench 2.1, contra 89.1 do Claude Opus 5. Os nove concluíram nosso loop de tool calling com dois turnos em 3 de 3 execuções.
A diferença reaparece em tarefas e contextos longos. Na tabela do próprio Google para o Terminal-Bench 4.0, o Gemini 3.8 Flash faz 19.1, contra 51.8 do Opus 5. No teste de recuperação de múltiplas agulhas da OpenAI entre 512K e 1M tokens, o GPT-5.6 Luna faz 41.3, contra 72.5 do GPT-5.6 Terra. Uma janela de 1M não significa recuperação confiável de 1M tokens nos modelos menores. Reserve os modelos Flash para extração, classificação, etapas curtas com ferramentas e alterações de código com formato conhecido. Use um modelo maior para planejar execuções longas de agentes e responder sobre documentos muito extensos.
O que quebra ao colocar um modelo Flash em produção?
Os padrões e formatos de request causam mais problemas que a capacidade dos modelos.
- Dois modelos não permitem desligar o thinking. Gemini 3.8 Flash e GLM 5.3 Flash retornaram 400 em todas as configurações de desligamento que testamos.
- As configurações padrão ficam nos dois extremos. O GLM 5.3 Flash usa
maxpor padrão e o Qwen3.8 Flash usaxhigh(Alibaba). Em nossas cinco perguntas inventadas, o Qwen3.8 Flash gastou uma mediana de 11,680 tokens de raciocínio. O Google inclui o thinking emmax_output_tokens. Um limite apertado pode retornar uma resposta truncada ou vazia que ainda será cobrada (guia de thinking). - Claude usa controles próprios. O Claude Sonnet 5 define a profundidade do thinking com
output_config.efforte rejeita o antigobudget_tokens(effort).reasoning_effortnão é um de seus parâmetros. - Loops de ferramentas precisam reenviar o raciocínio. O modo de thinking do DeepSeek espera o
reasoning_contentdos turnos anteriores (modo de thinking), e o Gemini anexa assinaturas de pensamento às partes de chamada de função. Frameworks que remontam o histórico de mensagens descartam ambos. - JSON estrito não funciona da mesma forma em todos. O Qwen3.8 Flash respeitou os tipos do schema, mas escreveu inteiros errados em 5 de 8 execuções (
-561994nos itens da fatura). Usejson_objectcom as chaves declaradas no prompt em Qwen, GLM, Hy3 e DeepSeek. No Claude, use uma tool call. - O thinking altera a honestidade. O DeepSeek V4.1 Flash inventou quatro de cinco respostas com thinking ligado e nenhuma com ele desligado.
- IDs de modelos mudam.
deepseek-v4-flashaponta para o V4.1 Flash desde 10 de setembro (preços), e o Claude Haiku 4.5 pode ser desativado a partir de 15 de outubro (descontinuações). Fixe uma versão datada quando houver, comoseed-2-0-mini-260428. - Hosts terceirizados de pesos abertos variam. DeepSeek, GLM, Qwen e Hy3 são servidos por vários provedores, com diferenças de quantização e comportamento de cache. Em setembro, descobriram que um revendedor estava roteando requests pagos para um modelo mais barato (Hacker News). Compare as respostas do seu provedor com a API oficial do fornecedor.
A velocidade depende mais da configuração padrão de thinking que do tamanho do modelo. Executamos 3 vezes uma explicação de 400 palavras com streaming e a configuração padrão de cada modelo em 2026-09-17:
| Modelo, configuração padrão | Primeiro token da resposta | Tempo total | Tokens de saída por segundo |
|---|---|---|---|
| Claude Sonnet 5 | 2.2 s | 10.5 s | 70 |
| Gemini 3.8 Flash | 10.7 s | 14.3 s | 114 |
| GPT-5.6 Luna | 24.9 s | 26.1 s | 89 |
| GPT-5.6 Terra | 33.3 s | 34.2 s | 63 |
| GLM 5.3 Flash | 36.7 s | 39.3 s | 128 |
| DeepSeek V4.1 Flash | 40.4 s | 40.6 s | 158 |
| Seed 2.0 Mini | 61.3 s | 61.5 s | 81 |
| Hy3 | 123.0 s | 134.5 s | 35 |
| Qwen3.8 Flash | 159.9 s | 165.8 s | 72 |
Os tokens por segundo incluem raciocínio e resposta durante toda a chamada. O thinking adaptativo do Sonnet 5 não gastou nada em uma tarefa de escrita e começou a responder imediatamente. O Qwen3.8 Flash gastou uma mediana de 10,697 tokens de raciocínio na mesma tarefa. Um prompt aberto pode levar minutos mesmo em um modelo que responde tarefas fechadas por pouco dinheiro.
A configuração ocupa um único campo em um request compatível com OpenAI, e o gasto de thinking volta em usage:
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key="sk-syn-...")
r = client.chat.completions.create(
    model="gemini-3.8-flash",          # or glm-5.3-flash, gpt-5.6-terra, ...
    reasoning_effort="low",
    max_tokens=32768,
    messages=[{"role": "user", "content": "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer."}],
)
u = r.usage
print(r.choices[0].message.content, u.completion_tokens, u.completion_tokens_details.reasoning_tokens)
Para Claude Sonnet 5, envie o mesmo request para a Messages API com output_config: {"effort": "low"}.
Como a Synthorai lida com isso
Todos os modelos acima usam um único ID em model no mesmo endpoint, compatível com OpenAI ou Anthropic. A página de comparação de modelos coloca dois modelos lado a lado em preço, cache, tipos de entrada, contexto e benchmarks dos fornecedores. Os preços atuais dos nove estão na comparação de preços dos modelos.
Perguntas frequentes
Claude Sonnet 5 é um modelo Flash? A Anthropic não usa esse nome, mas ele é o menor modelo da geração atual do Claude. O Claude Haiku 4.5 é de outubro de 2025 e pode ser desativado a partir de 15 de outubro de 2026. O Claude Sonnet 5 custa $2 / $10, contra $1 / $5 do Haiku, mas teve um custo 2.9 vezes menor por resposta correta em nosso teste.
A API Gemini Flash é gratuita? O Gemini 3.8 Flash tem uma modalidade gratuita no Google AI Studio, mas o Google usa o conteúdo dessa modalidade para melhorar seus produtos (preços). Para aplicativos que atendem o EEE, a Suíça ou o Reino Unido, apenas o serviço pago é permitido (termos). A modalidade paga custa $0.75 / $3.75 até 31 de dezembro de 2026. Depois passa para $1.50 / $7.50.
Devo usar Gemini Flash ou Flash-Lite? Use o Gemini 3.8 Flash, a menos que todos os requests sejam extrações de uma única etapa. Ele marca 41.2 no índice do Artificial Analysis, contra 23 do Gemini 3.5 Flash-Lite, custou 3.9 vezes menos por resposta correta em nosso teste e recusou as cinco perguntas inventadas, enquanto o Flash-Lite respondeu três. O Flash-Lite custa $0.30 / $2.50 e responde em cerca de 4 segundos.
GPT-5.6 Luna ou GPT-5.6 Terra?
Use o GPT-5.6 Luna para volume e o GPT-5.6 Terra para raciocínio mais difícil. O Luna custa $0.20 / $1.20 e fez 31 de 33 na configuração padrão por $0.00030 por resposta correta. O Terra custa $2 / $12, fez 33 de 33 em low por $0.00199 e tem a maior pontuação no índice entre os nove. Ambos inventaram respostas na configuração padrão: quatro de cinco no Luna e duas no Terra.
Qual modelo Flash é melhor para programação? Qwen3.8 Flash, DeepSeek V4.1 Flash e GLM 5.3 Flash lideram o Arena WebDev (1635, 1614 e 1607). O DeepSeek lidera a categoria de programação com agentes do LiveBench (77.3). DeepSeek e Claude Sonnet 5 lideram o Vibe Code Bench do Vals (84.7 e 81.3).
Relacionados: custo da API DeepSeek V4.1 Flash, custo da API GLM 5.3, custo da API Gemini 3.7 Flash, cache de prompts entre provedores, melhor LLM por caso de uso.