
API GLM 5.3: sempre pensa, 2.5x menos por resposta que a 5.2
Conteúdo
- O que é o GLM 5.3 e quanto ele custa?
- Ainda é possível desativar o raciocínio?
- Qual nível de esforço produz as respostas corretas?
- Ele inventa informações quando uma pergunta não tem resposta?
- O GLM 5.3 segue um schema JSON?
- Quanto custa uma imagem no GLM 5.3 Flash?
- O que mais mudou em relação ao GLM 5.2?
- Como a Synthorai implementa esses modelos
- Perguntas frequentes
O GLM 5.3 custa os mesmos $1.40 por milhão de tokens de entrada e $4.40 por milhão de tokens de saída que o GLM 5.2, mas não permite mais desativar o raciocínio: qualquer tentativa retorna erro 400, e o nível padrão é max. Em 11 tarefas com resposta verificável, executadas três vezes cada, max foi a única configuração que acertou todas as 33, a $0.00468 por resposta correta. Isso representa um custo 2.5x menor que o GLM 5.2 em max, porque o GLM 5.3 usa cerca de metade do raciocínio. low custa 63% menos por resposta correta, mas erra 5 de 33. O GLM 5.3 Flash acertou 31 de 33 por um décimo do preço. O parâmetro reasoning_effort, que define quanto tempo o modelo pensa antes de responder, agora determina tanto a precisão quanto o custo. Medimos os dois modelos em um único lote e os comparamos com o GLM 5.2 e o DeepSeek V4.1 Flash.
TL;DR
- GLM 5.3 e GLM 5.3 Flash rejeitam
thinking: disabled,reasoning_effort: noneemediumcom o erro 1210; somentelow,highemax(o padrão) funcionam. - Em
max, o GLM 5.3 acertou 33 de 33 a $0.00468 por resposta correta; o GLM 5.2 emmaxcustou $0.01173. - Em
low, o GLM 5.3 acertou 28 de 33, e o GLM 5.3 Flash, 24 de 33. - Os dois modelos GLM 5.3 ignoram um
json_schemaestrito;json_objectretornou os valores corretos em 8 de 8 execuções.
O que é o GLM 5.3 e quanto ele custa?
É um GLM 5.2 retreinado pelo mesmo preço, acompanhado de um modelo menor que custa um décimo. Segundo o guia da Z.ai, o GLM 5.3 “usa o mesmo modelo-base do GLM-5.2, e todas as melhorias vêm do pós-treinamento”. Ele aceita somente texto. O GLM 5.3 Flash tem “320B de parâmetros no total, com 18B ativados” (somente 18B processam cada token, o que reduz o custo) e aceita imagens, vídeos e arquivos. Ambos têm contexto de 1M tokens e saída de 128K. Estes são os preços por milhão de tokens publicados na página de preços da Z.ai:
| Modelo | Entrada | Entrada em cache | Saída |
|---|---|---|---|
| GLM 5.3 | $1.40 | $0.26 | $4.40 |
| GLM 5.3 Flash | $0.15 | $0.03 | $0.50 |
| GLM 5.2 | $1.40 | $0.26 | $4.40 |
| DeepSeek V4.1 Flash | $0.30 no pico | $0.006 no pico | $1.20 no pico |
O model card e o guia do Flash da Z.ai atribuem os ganhos a tarefas com agentes e programação:
| Benchmark | O que avalia | GLM 5.2 | GLM 5.3 | GLM 5.3 Flash |
|---|---|---|---|---|
| Terminal Bench 3.0 | tarefas de agentes em um terminal | 4.6 | 28.3 | não informado |
| DeepSWE v1.1 | correções em repositórios reais | 46.2 | 66.9 | 63.4 |
| AutomationBench | automação de workflows | 26.2 | 48.2 | 48.8 |
| CyberGym | tarefas de vulnerabilidade de segurança | 77.2 | 84.5 | não informado |
| HLE with tools | perguntas difíceis com uso de ferramentas | 54.7 | 62.5 | não informado |
A seguir estão os resultados que conseguimos verificar diretamente, usando tarefas com uma única resposta verificável, não benchmarks de agentes.
Ainda é possível desativar o raciocínio?
Não. O GLM 5.2 aceitava thinking: {"type": "disabled"}. O GLM 5.3 e o GLM 5.3 Flash retornam HTTP 400 com o código de erro 1210 (“este modelo sempre pensa; não é possível desativar o raciocínio; use low, high ou max”) para thinking: disabled, enable_thinking: false e reasoning_effort definido como none, minimal, medium ou xhigh. Se reasoning_effort for omitido, o valor usado será max. O thinking_budget, limite de tokens de raciocínio respeitado por alguns provedores, é aceito e ignorado pelo GLM 5.3: na mesma pergunta, todos os valores de 0 a 1,024 produziram cerca de 101 tokens de raciocínio.
resp = client.chat.completions.create(
    model="glm-5.3",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="high",   # "low" | "high" | "max"; omitted means "max"
    max_tokens=8192,           # GLM 5.3 Flash rejects anything above 131,072
)
reasoning_tokens = resp.usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content                # the thinking itself, as text
A antiga opção mais barata também não era boa: com o raciocínio desativado, o GLM 5.2 acertou 10 das nossas 33 tarefas, e o DeepSeek V4.1 Flash, 22.
Qual nível de esforço produz as respostas corretas?
No GLM 5.3, somente max; no GLM 5.3 Flash, nenhum deles. Executamos três vezes cada uma das 11 tarefas cuja resposta é um único número verificável: somas de números primos, contagens de dígitos, caminhos em uma grade, combinações de moedas, uma regra aplicada 40 vezes, o resto da divisão de 7 elevado a 222 por 1000, uma conversão de base, um problema da mochila e a contagem de números de quatro algarismos sob três restrições. Os tokens de raciocínio correspondem ao processamento oculto gerado antes da resposta e são cobrados como saída. O custo por resposta correta é o gasto total dividido pelo número de acertos, usando o preço de tabela:
| Modelo | Nível | Acertos | Tokens de raciocínio, mediana (máximo) | Custo por resposta correta |
|---|---|---|---|---|
| GLM 5.3 | low | 28/33 | 143 (1,826) | $0.00173 |
| GLM 5.3 | high | 29/33 | 226 (1,950) | $0.00197 |
| GLM 5.3 | max (padrão) | 33/33 | 538 (7,733) | $0.00468 |
| GLM 5.3 Flash | low | 24/33 | 120 (467) | $0.00012 |
| GLM 5.3 Flash | high | 29/33 | 196 (1,582) | $0.00021 |
| GLM 5.3 Flash | max (padrão) | 31/33 | 419 (5,024) | $0.00040 |
| GLM 5.2 | max | 33/33 | 1,129 (21,917) | $0.01173 |
| DeepSeek V4.1 Flash | low | 33/33 | 337 (6,797) | $0.00102 |
| DeepSeek V4.1 Flash | max | 33/33 | 386 (10,769) | $0.00138 |
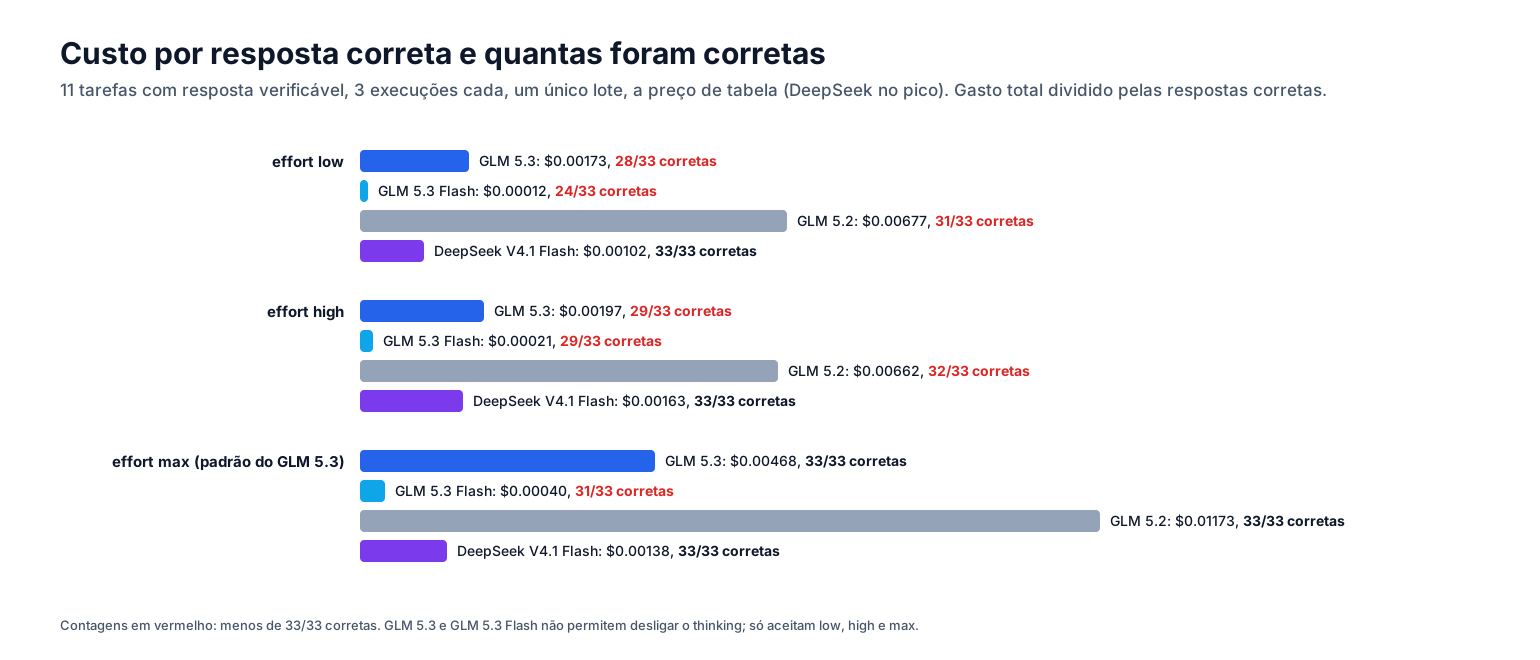
A diferença de 2.5x em relação ao GLM 5.2 vem do volume de raciocínio: mediana de 538 tokens contra 1,129, e execução mais longa de 7,733 contra 21,917. Os níveis menores economizam porque pulam verificações. Em low, o GLM 5.3 respondeu 216 duas vezes para a contagem de caminhos na grade (uma célula bloqueada reduz o resultado para 132) e errou uma vez cada nas combinações de moedas, no problema da mochila e na conversão de base. O GLM 5.3 Flash em low errou sempre a regra de 40 etapas e a contagem com restrições. Em comparação, o DeepSeek V4.1 Flash acertou 33 de 33 em todas as configurações.
No GLM 5.3, mantenha a configuração padrão para qualquer tarefa com cálculos ou várias etapas. Use low somente quando for barato detectar uma resposta errada. Em max, o GLM 5.3 custa 3.4x mais que o DeepSeek V4.1 Flash por resposta correta. O GLM 5.3 Flash custa menos de um terço, mas erra 2 de 33.
Ele inventa informações quando uma pergunta não tem resposta?
Não, mesmo com o raciocínio obrigatório. Fizemos cinco perguntas sobre entidades inventadas, então a única resposta correta era “não sei” (a cotação das ações da Verantis Dynamics, o ponto de fusão do Oridium-7, o vencedor do 1987 Pan-Continental Robotics Prize), usando o nível padrão e um limite de 16,384 tokens:
| Modelo | Respondeu que não sabia | Inventou uma resposta | Atingiu o limite, resposta vazia | Tokens de raciocínio | Custo por pergunta |
|---|---|---|---|---|---|
| GLM 5.3 | 5/5 | 0/5 | 0/5 | 230 a 542 | $0.0022 |
| GLM 5.3 Flash | 5/5 | 0/5 | 0/5 | 238 a 625 | $0.0003 |
| GLM 5.2 | 5/5 | 0/5 | 0/5 | 134 a 1,559 | $0.0035 |
| DeepSeek V4.1 Flash | 1/5 | 3/5 | 1/5 | 7,021 a 16,384 | $0.0139 |
Os dois modelos GLM 5.3 disseram que não tinham informações após algumas centenas de tokens de raciocínio. O DeepSeek V4.1 Flash raciocinou por 7,000 a 16,000 tokens e, na maioria das vezes, inventou algo (Andrew Martin, the robot protagonist of Isaac Asimov's The Bicentennial Man, won). Em nosso próprio estudo realizado um dia antes, mais execuções atingiram o limite, mas o modelo raramente respondeu que não sabia. Para consultas que podem legitimamente não retornar resultados, essa foi a maior diferença que medimos entre os dois modelos da categoria Flash.
O GLM 5.3 segue um schema JSON?
Não um schema estrito; use json_object. Com response_format definido como um json_schema estrito para extrair dados de uma fatura, o GLM 5.3 e o GLM 5.3 Flash retornaram HTTP 200 e ignoraram o schema nas 16 execuções. O JSON veio dentro de um bloco de código Markdown e continha chaves não solicitadas pelo schema (invoice_date, reference), por isso nenhum resultado pôde ser interpretado como o objeto pedido. A referência da API da Z.ai lista somente text e json_object; o problema é que o schema é aceito silenciosamente.
Com {"type": "json_object"} e os campos especificados no prompt, os dois modelos retornaram todos os valores corretos em 8 de 8 execuções, assim como o GLM 5.2 e o DeepSeek V4.1 Flash. Como o raciocínio permanece ativo, a extração usa uma mediana de 240 tokens de saída no GLM 5.3 e 140 no Flash, contra 25 no V4.1 Flash com o raciocínio desativado. Valide o resultado por conta própria usando seu schema.
Quanto custa uma imagem no GLM 5.3 Flash?
A contagem cresce com a área em pixels e ainda não atinge um teto em 2048x2048. Por isso, imagens grandes custam mais que no DeepSeek V4.1 Flash, apesar da tarifa menor. Enviamos arquivos PNG gerados ao GLM 5.3 Flash (o GLM 5.3 aceita somente texto) e descontamos os tokens do mesmo prompt sem imagem:
| Imagem | Tokens do GLM 5.3 Flash | Custo a $0.15/M | Tokens do DeepSeek V4.1 Flash | Custo a $0.30/M |
|---|---|---|---|---|
| 512x512 | 363 | $0.000054 | 184 | $0.000055 |
| 1024x1024 | 1,371 | $0.000206 | 652 | $0.000196 |
| 2048x2048 | 5,478 | $0.000822 | 994 | $0.000298 |
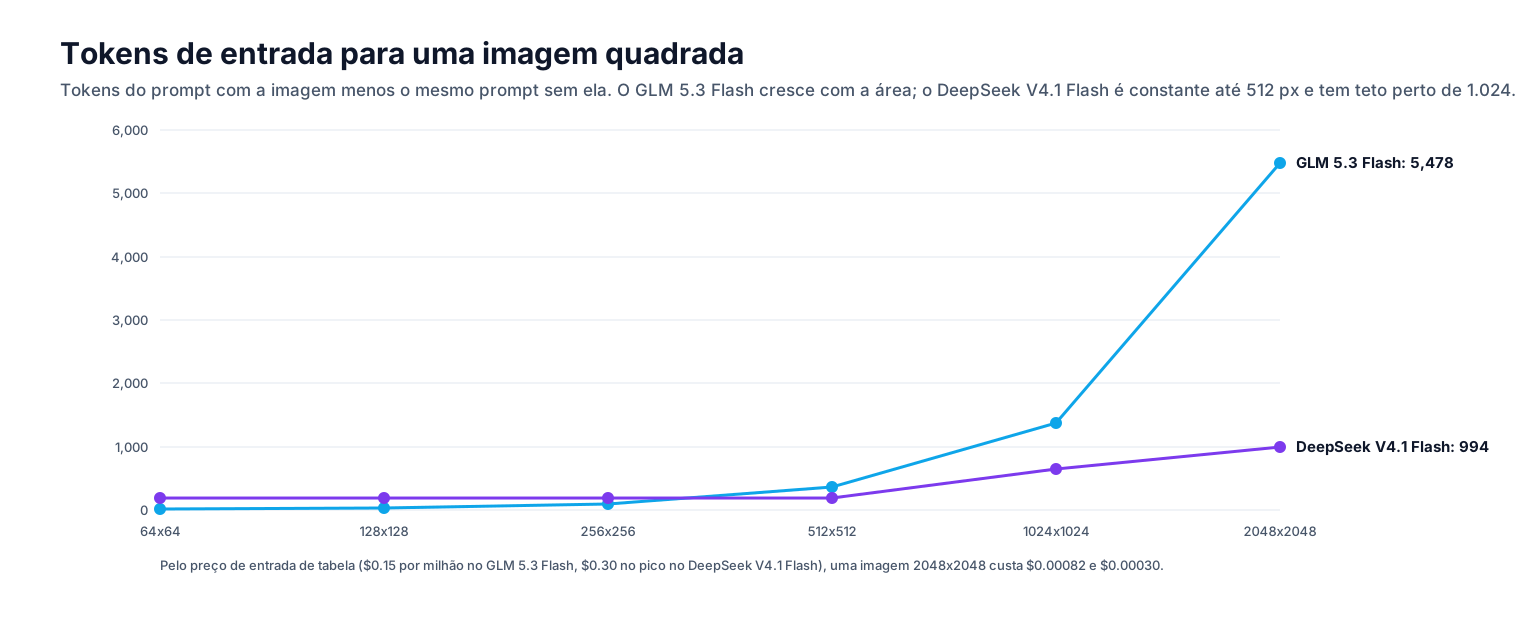
Acima de 512 pixels, o GLM 5.3 Flash usa cerca de um token para cada 766 pixels. O valor de detail, o conteúdo da imagem e o formato do arquivo não alteraram a contagem. Os números do DeepSeek V4.1 Flash vêm do estudo feito no dia anterior. Reduza a resolução de capturas de tela e páginas de documentos antes do envio: em 2048x2048, o GLM 5.3 Flash custa 2.8x mais por imagem.
O que mais mudou em relação ao GLM 5.2?
A velocidade; o restante da integração quase não mudou. Em streaming, na mesma janela de medição e com low, o GLM 5.3 gerou de 59 a 64 tokens de saída por segundo, o GLM 5.3 Flash, de 70 a 82, o GLM 5.2, de 51 a 55, e o DeepSeek V4.1 Flash, de 124 a 161. Em um loop de function calling com dois turnos, todos os modelos fizeram uma chamada por turno. Os três modelos GLM contabilizam o mesmo número de tokens para textos em inglês, chinês e Python (737, 484 e 488), então os orçamentos de tokens continuam válidos.
A parte inicial repetida de um prompt é cobrada pela tarifa de cache, com contagem em blocos de 64 tokens (em um prompt de 1,153 tokens, 1,024 foram lidos do cache). Os dois modelos aceitam prompts próximos do limite de 1M tokens, embora o model card do Flash mencione 300,000 tokens: um prompt de 990,000 tokens, com um valor oculto próximo ao início, retornou esse valor (não testamos a recuperação de conteúdo perto do fim). Outro prompt com cerca de 1.07M tokens recebeu um erro 400, Prompt exceeds max length, em vez de ser truncado. Há uma incompatibilidade na migração: o GLM 5.3 Flash rejeita max_tokens acima de 131,072.
Como a Synthorai implementa esses modelos
O GLM 5.3, o GLM 5.3 Flash e o GLM 5.2 estão disponíveis no gateway como glm-5.3, glm-5.3-flash e glm-5.2, pelos preços de tabela da Z.ai, nos endpoints /v1/chat/completions e /v1/responses. O erro 1210 é repassado sem alterações. Assim, clientes que ainda enviam a opção do GLM 5.2 para desativar o raciocínio falham de forma explícita, em vez de usar max silenciosamente. O texto de raciocínio retorna em reasoning_content; imagens são enviadas ao GLM 5.3 Flash como partes de conteúdo image_url.
Perguntas frequentes
É possível desativar o raciocínio no GLM 5.3?
Não. O GLM 5.3 e o GLM 5.3 Flash retornam erro 400 com o código 1210 para todas as formas de desativação. Somente low, high e max são aceitos, e max é o padrão. Em nossos testes, low custou 63% menos por resposta correta, mas acertou 28 de 33, em vez de 33.
O GLM 5.3 é mais barato que o GLM 5.2?
Por token, não: ambos custam $1.40 pela entrada e $4.40 pela saída. Por resposta correta, sim: em max, o GLM 5.3 custou $0.00468, contra $0.01173 do GLM 5.2, porque usa cerca de metade do raciocínio.
O GLM 5.3 Flash pode substituir o GLM 5.3?
Sim, quando um erro numérico ocasional pode ser detectado nas etapas seguintes, por um décimo do preço: o GLM 5.3 Flash em max acertou 31 de 33 a $0.00040 por resposta correta, contra 33 de 33 a $0.00468 no GLM 5.3. Evite usar o Flash em low para cálculos com várias etapas, configuração em que ele acertou 24 de 33.
Veja também: níveis de raciocínio do GLM 5.2, chamadas de ferramentas do GLM 5.2, custo do DeepSeek V4.1 Flash, controles de raciocínio em LLMs, saídas estruturadas de LLMs.