
API DeepSeek V4.1 Flash: nível Pro por 3-6x menos
Conteúdo
- O que mudou em 10 de setembro e quanto custa o V4.1 Flash?
- O V4.1 Flash realmente empata com o V4 Pro e supera o V4 Flash?
- O que o controle de esforço faz? É possível desativar o raciocínio?
- O que acontece quando você pergunta sobre algo que não existe?
- A corrupção de JSON do V4 Flash foi corrigida?
- Quanto custa uma imagem no V4.1 Flash?
- Como a Synthorai lida com o modelo
- Perguntas frequentes
O DeepSeek V4.1 Flash custa $0.30 por milhão de tokens de entrada e $1.20 por milhão de tokens de saída no horário de pico, e metade disso fora do pico. Em 11 tarefas com resposta verificável, executadas três vezes cada, acertou 33 de 33, a mesma pontuação do V4 Pro, com custo por resposta correta entre 3 e 6x menor e velocidade de saída 2.9x maior. Em relação ao V4 Flash que substitui, o custo por resposta correta caiu 26%, a velocidade aumentou 1.5x e agora a linha Flash aceita imagens pela primeira vez. Há também dois comportamentos que precisam ser considerados no projeto: sem raciocínio, o modelo responde a cálculos em várias etapas com um único token incorreto; com o raciocínio ativado, consome toda a janela de saída, 16,384 tokens em três de cinco execuções, ao responder sobre coisas que não existem. Medimos as três versões. deepseek-v4.1-flash e deepseek-v4-pro-0813 foram testados no mesmo lote, na mesma hora e pelo mesmo gateway, quatro dias após o lançamento. deepseek-v4-flash-0731 foi medido naquela mesma noite.
TL;DR
- O V4.1 Flash custa $0.30/$1.20 por milhão no horário de pico e metade disso fora do pico; o V4 Pro custa $1.32/$3.96.
- Com o raciocínio ativado, as três versões acertaram 33 de 33; o V4.1 Flash custou entre $0.00097 e $0.00149 por resposta correta, de 3 a 6x menos que o V4 Pro e 26% menos que o V4 Flash.
- Sem raciocínio, as três versões caem para 21 de 33; o V4.1 Flash responde com um único token incorreto.
- Diante de cinco entidades inventadas, o V4.1 Flash com raciocínio ativado atingiu o limite de 16,384 tokens três vezes e inventou respostas duas vezes; sem raciocínio, recusou as cinco.
O que mudou em 10 de setembro e quanto custa o V4.1 Flash?
Uma arquitetura nova, um preço novo e uma descontinuação. O V4.1 Flash é “o menor modelo da nossa nova família de arquiteturas”: são 552B parâmetros em um encoder-decoder causal, no qual uma pilha de 20 camadas lê o prompt e outra escreve a resposta. O modelo ativa 8B parâmetros por token na entrada e 16B na saída, aceita imagens nativamente, oferece contexto de 1M tokens e limite de saída de 384K, sob licença MIT. A página de preços da DeepSeek informa $0.30 por milhão de tokens de entrada e $1.20 por milhão de tokens de saída no horário de pico, das 01:00 às 04:00 e das 06:00 às 10:00 UTC, de segunda a sexta-feira. Fora do pico, os preços são $0.15 e $0.60, com cache hits a $0.006 e $0.003. O valor fica entre as duas tabelas de preço que o V4 Flash teve: $0.14/$0.28 fixos no lançamento de julho e $0.44/$1.32 no pico a partir de 2026-08-16. Também fica bem abaixo do V4 Pro, que custa $1.32/$3.96 no pico.
O V4 Flash e a versão Vision Exp foram descontinuados, e seus nomes agora direcionam para o V4.1 Flash com o preço do Flash. A DeepSeek também planejava redirecionar o tráfego do V4 Pro para o V4.1 Flash a partir de 14 de setembro. O registro de alterações retirou esse plano no mesmo dia, “em resposta à demanda dos usuários”, então o Pro continua disponível com os preços do Pro.
A integração mudou menos que o preço. O tokenizer é idêntico nas três versões, com 729, 452 e 528 tokens nos mesmos corpora em inglês, chinês e Python, portanto os limites de tokens continuam válidos. As páginas de cache caíram de 1,024 para 512 tokens, então um prompt de 549 tokens agora armazena 512 deles em cache. Um prompt de 902K tokens com um valor inserido retornou esse valor, enquanto um prompt acima da janela de 1M retornou 400 em vez de sofrer truncamento silencioso.
Os números da própria DeepSeek, publicados no model card, colocam o novo Flash acima do antigo em todos os testes. Ele também supera o Pro em tarefas de agentes e programação, mas não em conhecimento:
| Benchmark | O que testa | V4 Flash | V4.1 Flash | V4 Pro |
|---|---|---|---|---|
| GPQA Diamond | perguntas de ciências em nível de pós-graduação | 89.9 | 90.9 | 92.4 |
| HLE | perguntas difíceis de várias áreas | 37.8 | 36.8 | 42.7 |
| Codeforces | classificação em programação competitiva | 3289 | 3471 | 3348 |
| MathArena Apex | matemática de competições | 58.6 | 65.6 | 65.3 |
| Terminal-Bench 2.1 | tarefas de agentes em um terminal | 82.7 | 90.6 | 87.9 |
| Terminal-Bench 4.0 | tarefas mais difíceis de agentes em terminal | 7.0 | 31.2 | 12.4 |
| DeepSWE v1.1 | correção de repositórios reais | 54.4 | 74.2 | 62.7 |
| CyberGym | tarefas de vulnerabilidades de segurança | 76.7 | 88.1 | 83.3 |
| AutomationBench | automação de fluxos de trabalho | 37.7 | 54.8 | 43.2 |
O restante deste post cobre o que conseguimos verificar por conta própria: a primeira metade da tabela, com respostas que podem ser conferidas, e não as linhas de conhecimento.
O V4.1 Flash realmente empata com o V4 Pro e supera o V4 Flash?
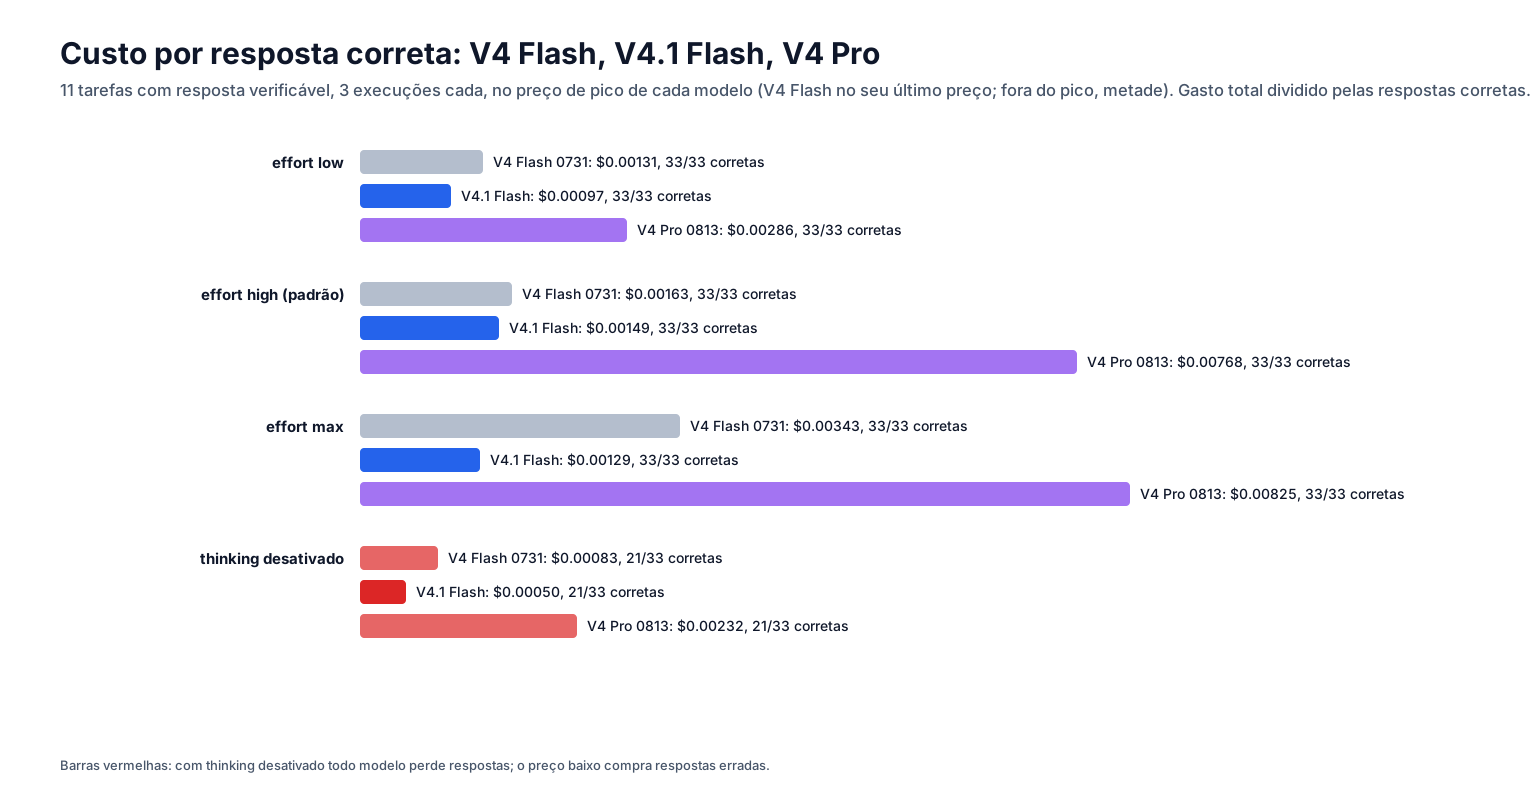
Nas tarefas com resposta verificável, as três versões tiveram a mesma pontuação. As diferenças estão no preço, na velocidade e no modo como falham. Executamos 11 tarefas cuja resposta é um único número verificável, três vezes cada, com reasoning_effort em low, high e max, além de execuções sem raciocínio. As tarefas incluíram somas de números primos, contagem de dígitos, caminhos em uma grade, combinações de moedas, aplicação de uma regra 40 vezes, o resto da divisão de 7 elevado a 222 por 1000, conversão de base, um problema de mochila e a contagem de números de quatro dígitos sujeitos a três restrições. Reasoning tokens são o raciocínio oculto que o modelo produz antes da resposta e são cobrados como saída. O custo por resposta correta é o gasto total dividido pelo número de respostas corretas, usando a tabela de pico de cada modelo. Para o V4 Flash, usamos $0.44/$1.32, o preço praticado até sua descontinuação. Fora do pico, o valor cai pela metade:
| Modelo | Esforço | Corretas | Reasoning tokens, mediana (máximo) | Custo por resposta correta, pico |
|---|---|---|---|---|
| V4 Flash 0731 | low | 33/33 | 492 (6,444) | $0.00131 |
| V4 Flash 0731 | high (padrão) | 33/33 | 433 (9,172) | $0.00163 |
| V4 Flash 0731 | max | 33/33 | 453 (24,010) | $0.00343 |
| V4 Flash 0731 | sem raciocínio | 21/33 | 0 | $0.00083 |
| V4.1 Flash | low | 33/33 | 316 (6,153) | $0.00097 |
| V4.1 Flash | high (padrão) | 33/33 | 391 (13,300) | $0.00149 |
| V4.1 Flash | max | 33/33 | 391 (11,037) | $0.00129 |
| V4.1 Flash | sem raciocínio | 21/33 | 0 | $0.00050 |
| V4 Pro | low | 33/33 | 309 (6,398) | $0.00286 |
| V4 Pro | high (padrão) | 33/33 | 548 (18,247) | $0.00768 |
| V4 Pro | max | 33/33 | 644 (15,920) | $0.00825 |
| V4 Pro | sem raciocínio | 21/33 | 0 | $0.00232 |
Com o raciocínio ativado, nenhuma versão errou qualquer tarefa em qualquer nível de esforço. Este conjunto de testes não permite diferenciá-las pela precisão, mas mostra diferenças de custo e velocidade. Frente ao Pro, o V4.1 Flash foi 2.9x mais barato em low, 5.2x no high padrão e 6.4x em max. Frente ao V4 Flash, foi 26% mais barato em low. Em streaming e sem raciocínio, para que o relógio medisse a geração da resposta e não o raciocínio, o V4.1 Flash gerou de 121 a 134 tokens de saída por segundo, com 1.4 s entre a requisição e o primeiro token. O V4 Flash ficou entre 86 e 94, com 2.3 s até o primeiro token, e o Pro entre 46 e 49, com 1.9 s. Em um loop de function calling com dois turnos, cada versão fez exatamente uma chamada por turno. O V4.1 Flash usou 27 e 13 tokens de raciocínio nas duas etapas, o V4 Flash usou 30 e 19, e o Pro, 61 e 29, a um custo de $0.00019, $0.00030 e $0.00103 por etapa. A lacuna de conhecimento mostrada na tabela da DeepSeek, em HLE e GPQA, é o único ponto que estes testes não cobrem.
O que o controle de esforço faz? É possível desativar o raciocínio?
O controle altera o custo em algumas tarefas, mas não muda nenhuma resposta. Desativar o raciocínio elimina 12 das 33 respostas corretas em cada versão. O V4.1 Flash aceita reasoning_effort como low, high e max. A DeepSeek mapeia minimal para low, e medium e xhigh para high. Em nove das onze tarefas, as três configurações ficaram a poucas centenas de reasoning tokens umas das outras. A exceção foi a contagem de números de quatro dígitos sujeitos a três restrições: 5,650 em low, 9,714 em high e 6,763 em max, todas corretas. Todos os valores de thinking_budget entre 0 e 1,024 foram aceitos e ignorados. A configuração “esforço de raciocínio continuamente ajustável, com valores inteiros de 1 a 100” descrita no model card não está disponível na API, que rejeita números inteiros. O V4 Pro e o V4 Flash se comportam da mesma forma, com suas respectivas contagens. É nessa tarefa de contagem que max fica caro nas versões anteriores: de 12,729 a 15,920 reasoning tokens no Pro e de 17,866 a 24,010 no V4 Flash, para chegar à mesma resposta correta que o V4.1 Flash produziu com 6,763.
Os dois controles e a origem dos números medidos na resposta:
resp = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="low",                    # "low" | "high" | "max"; default "high"
    extra_body={"thinking": {"type": "enabled"}},  # {"type": "disabled"} turns it off
    max_tokens=4096,                           # always set one: see the next section
)
usage = resp.usage
reasoning_tokens = usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content            # returned on every thinking call
Desativar o raciocínio é a opção barata e perigosa. Cada versão perde um conjunto diferente de tarefas:
| Sem raciocínio, 11 tarefas x 3 | V4 Flash 0731 | V4.1 Flash | V4 Pro |
|---|---|---|---|
| Corretas | 21/33 | 21/33 | 21/33 |
| Perdidas por completo (0 de 3) | mochila, soma de primos, horário de trens | combinações de moedas, regra de 40 etapas, mochila | mochila, tarefa de contagem |
| Como falha | um número incorreto no formato certo (17, 1043; 10:40) | um único token incorreto (83 para uma sequência de cinco etapas cuja resposta é 168) | mostra os cálculos e termina com uma resposta incorreta |
A sequência de cinco etapas do nosso conjunto padrão é o exemplo mais claro. Sem raciocínio, o V4.1 Flash acertou 1 de 3, e 0 de 3 em uma segunda série de execuções. O V4 Flash acertou 2 de 3 e o Pro, 3 de 3, porque o Pro escreve as etapas antes da resposta, enquanto as versões Flash não fazem isso. Há ainda dois detalhes menores que afetam o orçamento. O modo de raciocínio adiciona um prefixo de template oculto cobrado como entrada: 26 tokens de prompt no V4.1 Flash e 79 no V4 Flash e no Pro. Sem raciocínio, o texto é idêntico e soma 729 tokens nos três. Além disso, o reasoning_content enviado de volta no turno seguinte não é cobrado outra vez: foram 81 tokens de prompt com e sem esse conteúdo no V4.1 Flash e 134 no Pro.
O que acontece quando você pergunta sobre algo que não existe?
Com o raciocínio ativado, o V4.1 Flash esgota o limite de saída ou inventa uma resposta. Sem raciocínio, recusa responder, com mais consistência que as outras duas versões. Fizemos cinco perguntas sobre entidades inventadas, para as quais a única resposta correta seria “não sei”, com limite de 16,384 tokens. Entre elas estavam o preço das ações da “Verantis Dynamics”, o número de funcionários do “Kessler-Fanning Institute”, o ponto de fusão do “Oridium-7” e o vencedor do “1987 Pan-Continental Robotics Prize”:
| Modelo, configuração | Recusou | Inventou uma resposta | Atingiu o limite de 16,384 tokens, sem resposta | Reasoning tokens |
|---|---|---|---|---|
| V4.1 Flash, com raciocínio | 0/5 | 2/5 (“O Professor Frink, de The Simpsons, venceu o prêmio de 1987”; “O Oridium-7 tem ponto de fusão de 1815 °C”) | 3/5 | 2,610; 11,905; 16,384 x3 |
| V4.1 Flash, sem raciocínio | 5/5 | 0/5 | 0/5 | 0 (69 a 248 tokens de saída) |
| V4 Flash 0731, com raciocínio | 1/5 | 3/5 (“0 funcionários”; “O Oridium-7 tem aproximadamente 1065 °C”; “Montblanc, o robô suíço do mangá Pluto, venceu”) | 1/5 | 4,080 a 16,384 |
| V4 Flash 0731, sem raciocínio | 4/5 | 1/5 (“O Oridium-7 tem ponto de fusão de…“) | 0/5 | 0 |
| V4 Pro, com raciocínio | 1/5 | 3/5 (“Andrew Martin venceu”; “0 funcionários”; uma faixa de fusão entre 899 e 949 °C) | 1/5 | 754 a 16,384 |
| V4 Pro, sem raciocínio | 3/5 | 2/5 (According to reference 844476, the Kessler-Fanning Institute had 247…) | 0/5 | 0 |
Três das cinco execuções do V4.1 Flash com raciocínio custaram $0.0197 cada no horário de pico e retornaram uma mensagem vazia. Com o limite de 2,048 tokens usado nos outros testes, isso aconteceu nas cinco execuções e também em quatro de cinco no Pro. Se uma consulta puder legitimamente não ter resposta, execute-a sem raciocínio ou limite max_tokens e trate uma mensagem vazia como “desconhecido”. A falha do Pro sem raciocínio é diferente e merece uma regex própria: ele escreve Let me check that reference for you. According to reference e depois inventa um número.
A corrupção de JSON do V4 Flash foi corrigida?
Com json_object, não há nada a corrigir em nenhuma das versões. Não conseguimos testar com json_schema estrito. O V4 Flash 0731 foi lançado com um defeito: raciocínio ativado junto de um json_schema estrito corrompia campos inteiros em 8 de 13 execuções. No V4.1 Flash, um json_schema estrito retornou 400 no caminho que testamos, e o guia de JSON da DeepSeek documenta apenas {"type": "json_object"}.
Com json_object, a mesma fatura, contendo fornecedor, data, total e itens, retornou todos os valores corretos em 8 de 8 execuções com raciocínio e em 8 de 8 sem raciocínio, nas três versões. O V4 Pro ainda corrompe dados com json_schema estrito e raciocínio ativado: nenhuma das 8 execuções trouxe a quantidade correta de itens, retornando 45, 12, 47, 1 e 2026. Sem raciocínio, acertou 8 de 8. Para extração, json_object sem raciocínio acertou todas as vezes em todas as versões. No V4.1 Flash, isso custa 25 tokens de saída.
Quanto custa uma imagem no V4.1 Flash?
São 184 tokens de entrada para qualquer imagem de até 512x512, 652 para um megapixel e 994 para quatro megapixels. A entrada de imagens é novidade na linha Flash. A versão Vision Exp descontinuada era um modelo separado, e o V4 Flash 0731 aceita apenas texto. Enviamos PNGs gerados ao V4.1 Flash e subtraímos os tokens do prompt somente com texto:
| Imagem | Tokens da imagem | Custo no pico |
|---|---|---|
| 64x64, 128x128, 256x256, 512x512 | 184 | $0.000055 |
| 1024x1024 | 652 | $0.000196 |
| 2048x512 (mesma área que 1024x1024) | 652 | $0.000196 |
| 512x2048 | 688 | $0.000206 |
| 2048x2048 | 994 | $0.000298 |
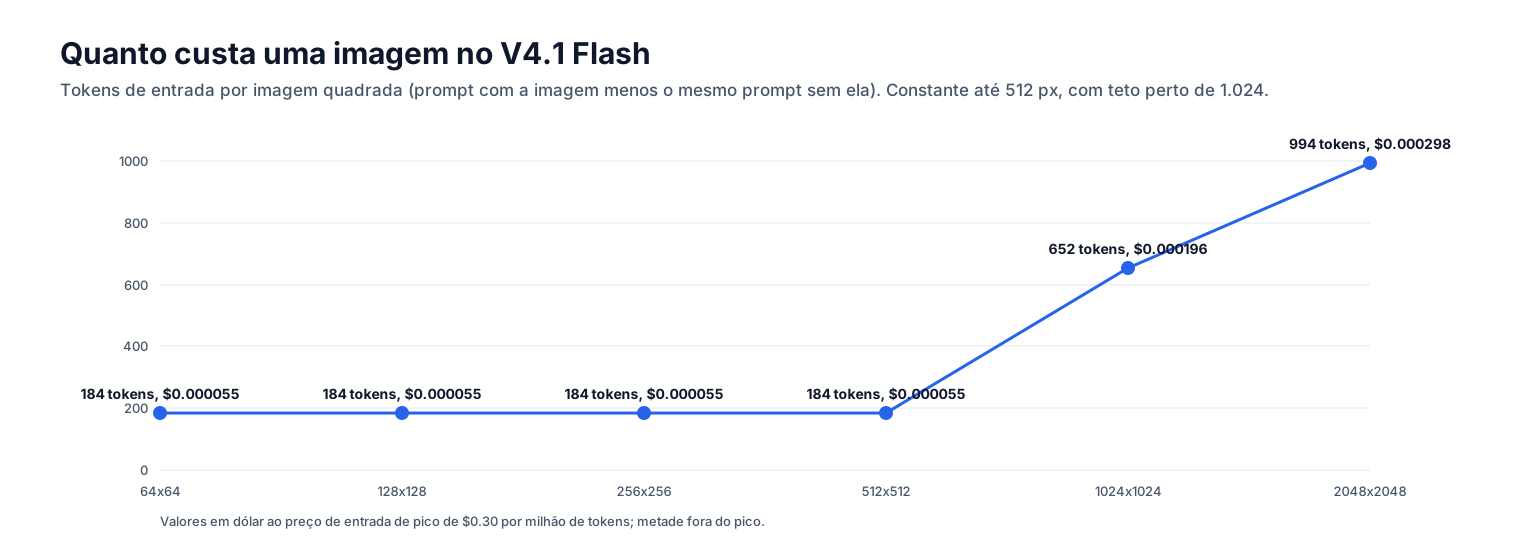
O valor mínimo corresponde ao guia de visão: “imagens com contagem total de pixels abaixo de aproximadamente 544x544 são ampliadas”, enquanto as maiores são reduzidas “para aproximadamente o tamanho de uma imagem de 1300x1300”. O limite documentado é de 1,024 tokens por imagem. O conteúdo, seja cor sólida, ruído ou texto renderizado, e o formato, PNG, JPEG ou WebP entre 174 e 243 KB, não alteraram a contagem. A cobrança depende da geometria, não da quantidade de bytes. Mil imagens de 1 megapixel custam $0.20 em tokens de imagem no horário de pico, sem contar a pergunta e a resposta.
Como a Synthorai lida com o modelo
O V4.1 Flash aparece como deepseek-v4.1-flash no gateway. O ID usado pela própria DeepSeek é deepseek-flash. A cobrança é de $0.30 por milhão de tokens de entrada e $1.20 por milhão de tokens de saída em qualquer horário, com leituras de cache a $0.03 por milhão e sem tarifa fora do pico. Todos os números deste post usam a tabela pública da DeepSeek, para que você possa aplicar seus próprios horários. O V4 Flash 0731 e o V4 Pro 0813 continuam disponíveis como deepseek-v4-flash-0731 e deepseek-v4-pro-0813, com suas próprias tarifas. Tanto /v1/chat/completions quanto /v1/responses aceitam o modelo. thinking: {"type": "disabled"} desativa o raciocínio nesse caminho, e o texto do raciocínio retorna em reasoning_content em todas as chamadas com raciocínio. Imagens são enviadas como partes de conteúdo image_url.
Perguntas frequentes
O DeepSeek V4.1 Flash é mais barato que o V4 Flash?
É mais barato que a tabela de agosto que substitui, mas não que o preço de lançamento de julho. O V4.1 Flash custa $0.30/$1.20 por milhão no horário de pico e $0.15/$0.60 fora do pico. O V4 Flash custava $0.44/$1.32 no pico desde meados de agosto e $0.14/$0.28 antes disso. Em nosso conjunto de testes, o V4.1 Flash em low custou $0.00097 por resposta correta, contra $0.00131 do V4 Flash em sua última tabela.
É possível desativar o raciocínio no DeepSeek V4.1 Flash?
Sim, com thinking: {"type": "disabled"}. A DeepSeek também documenta reasoning_effort: "none". Isso reduz a precisão em tarefas com várias etapas: o V4.1 Flash caiu de 33 de 33 para 21 de 33 em nossos testes e respondeu a uma sequência de cinco etapas com um único token incorreto. Mantenha o raciocínio ativado para cálculos e planejamento. Desative-o para extração e consultas que talvez não tenham resposta.
O DeepSeek V4.1 Flash aceita imagens? Quanto custa cada imagem?
Sim, nativamente. No V4.1 Flash, uma imagem custa 184 tokens de entrada até 512x512, 652 em 1024x1024 e 994 em 2048x2048, independentemente do conteúdo e do formato. Pela tarifa pública de pico, isso equivale a $0.000055 a $0.000298 por imagem.
Relacionado: custo do DeepSeek V4 Flash, DeepSeek V4 Pro GA versus preview, controles de raciocínio em LLMs, custo de tokens para entrada de imagens, saídas estruturadas de LLMs.