
プロンプトのバージョン管理:再デプロイせず 10 秒未満で変更を反映
LLMのプロンプトをライブラリに保存し、prompt_idで呼び出す方式を解説。ラベルを付け替えてリリースすると、実測では8〜9秒で実際の呼び出しに反映。プロンプトのトークン数は114.5で、本文をインラインで直接指定した場合と同じ値となり、増加はありません。
推奨モデル
リアルタイム価格| モデル | 評価 | 価格 |
|---|---|---|
| GPT-6 Luna support-answer の v1 と v2 を配信。プロンプト ID による呼び出しで送信されたプロンプトトークン数は、レンダリング済みのリクエストをインラインで送信した場合と同じ 114.5(20 ペアの中央値)だった。 | デモの回答プロンプトで使用するモデル | $0.1/100万〜 |
| DeepSeek V4.1 Flash バージョンに保存した出力スキーマを使用して policy-check v1 を実行。reasoning_effort を none に設定し、18 出力トークンの JSON 回答を $0.000033 で生成した。 | デモの JSON チェックで使用するモデル | $0.3/100万〜 |
目次
プロンプトのバージョン管理では、プロンプトをコードの外に保存し、変更できない番号付きのバージョンとして管理します。呼び出しには ID を使い、本番で使うバージョンはラベルの参照先で切り替えます。ラベルは production や staging のような名前付きのポインタで、それぞれ 1 つのバージョンを指します。Synthorai のプロンプトライブラリでは、リクエストの prompt_id でプロンプトを指定すると、ゲートウェイがそのバージョンのメッセージ、モデル、パラメータを補完します。production ラベルを付け替えれば、以後の呼び出しに変更が反映されます。今回の計測では、継続的にトラフィックがある状態で 8-9 秒、呼び出しが途切れた後は最初の呼び出しで反映されました。ID 指定の呼び出しで送信されたプロンプトのトークン数は、同じリクエストをコードに直接記述した場合と完全に一致しました。
TL;DR
- Synthorai ゲートウェイへの
prompt_id指定の呼び出しでは、20 組の比較でプロンプトのトークン数の中央値が 114.5 となり、インラインで送信したリクエストと一致しました。 productionラベルの付け替えは、継続的なトラフィックの下では変更から 8.0-8.5 秒後(中央値)に反映され、15 秒間呼び出しがなかった後は即座に反映されました。- 20 回のラベル変更すべてで、新バージョンを使った最初の呼び出しの後に旧バージョンが使われることはありませんでした。
- 処理できない呼び出しは、モデルを実行する前に 400 または 404 で失敗し、課金されませんでした。
この記事では、LLM エージェントのトレースで使ったサポートエージェントのプロンプトをライブラリに移し、ゲートウェイが受け付けるすべての方法で呼び出します。コードは github.com/synthorai-io/use-cases の prompt-library/ にあります。Python 3.10 以降と、推論用キー、prompts.write 権限を持つ管理用キーが必要です。キーはコンソールで取得できます。
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put both keys in it
cd prompt-library
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python setup.py         # saves the prompts and their versions; safe to run again
python call.py          # every way to call a prompt
python ship.py          # moves production and times it
python errors.py        # what a call that cannot be served answers
この記事の実行結果は 2026 年 10 月 19 日のものです。setup.py は 2 つのプロンプトを保存します。support-answer はエージェントの回答ステップで、実際にありそうな変更を 1 つずつ加えた 4 バージョンを用意しました。policy-check は JSON で結果を返すサブエージェントのチェック処理です。
| プロンプト | バージョン | 変更内容 | モデル |
|---|---|---|---|
support-answer | v1 | 基準版:注文番号を明記し、返金日は絶対に約束しない | GPT-6 Luna |
support-answer | v2 | システム文を短くし、注文番号のルールを削除 | GPT-6 Luna |
support-answer | v3 | v1 の文面を別のモデルで実行 | DeepSeek V4.1 Flash |
support-answer | v4 | v1 にデフォルト値のない {{tone}} 変数を追加 | GPT-6 Luna |
policy-check | v1 | トピックとリスクレベルをスキーマに従う JSON で出力 | DeepSeek V4.1 Flash |
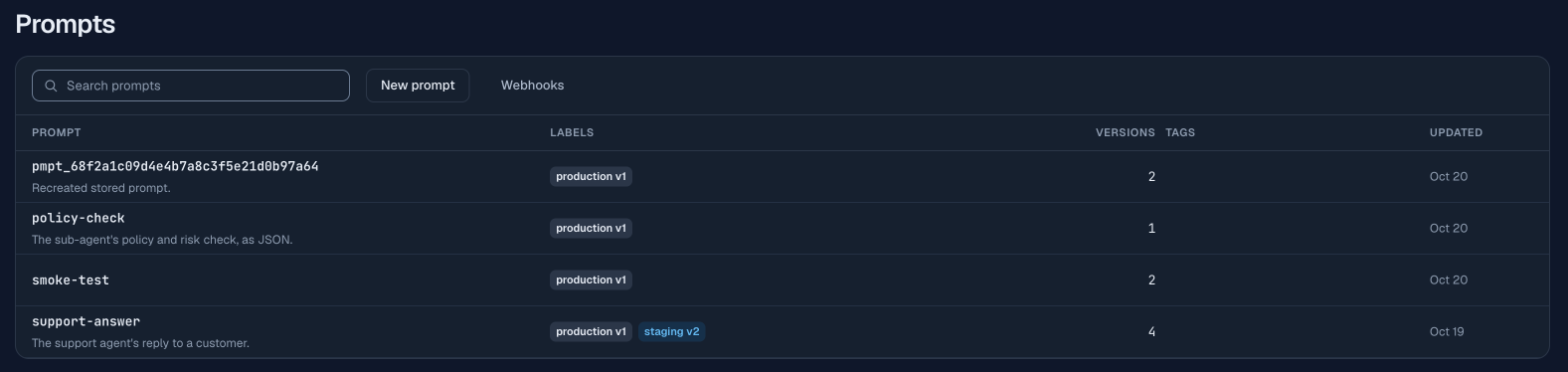
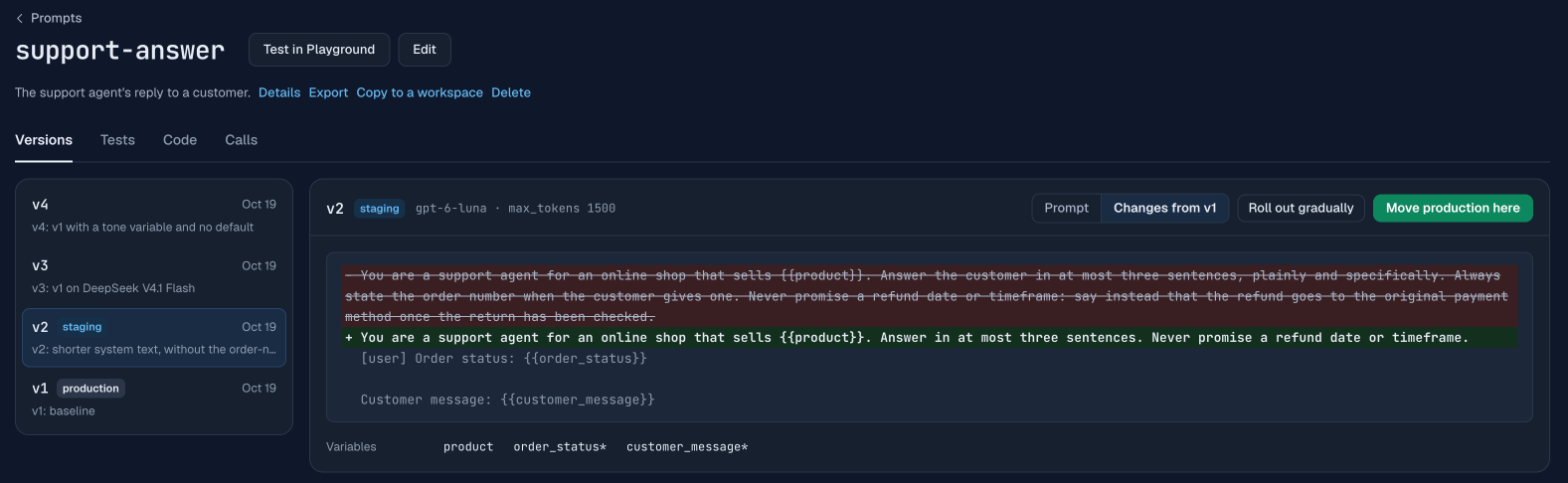
production は v1 を、staging は v2 を指しています。v2 と v3 は、続編のリリース前のバージョンテストと本番トラフィックの一部への段階的リリースで扱います。コンソールでは、各バージョンと直前のバージョンとの差分を確認できます。
プロンプトを ID で呼び出すには?
通常どおり /v1/chat/completions、/v1/responses、/v1/messages のいずれかにリクエストを送り、ボディに prompt_id と prompt_variables を追加します。変数は、バージョンの文面に含まれる {{name}} 形式のプレースホルダーです。prompt_variables で、その呼び出しで使う値を渡します。SDK ではモデルとメッセージが必須なので、任意のモデル名と空のユーザーメッセージを送ります。ゲートウェイはバージョンに保存されたモデルを使い、空のメッセージを取り除きます。OpenAI Python SDK では、追加フィールドを extra_body に指定します。
import os
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key=os.environ["SYNTHORAI_API_KEY"])

raw = client.chat.completions.with_raw_response.create(
    model="any",                                   # the version's model is used
    messages=[{"role": "user", "content": ""}],    # required by the SDK; dropped
    extra_body={
        "prompt_id": "support-answer",
        "prompt_variables": {
            "customer_message": "Where is order A-50977? It has been a week.",
            "order_status": "in transit, shipped on 2026-10-01",
        },
    },
)
print(raw.headers["x-synthorai-prompt-version"])   # which version answered
print(raw.parse().choices[0].message.content)
product はバージョン側にデフォルト値(「home electronics」)があるため、呼び出しでは指定していません。応答の X-Synthorai-Prompt-Version ヘッダーで、使われたバージョンを確認できます。ラベルで呼び出す場合、呼び出し元がバージョンを知る手段はこのヘッダーだけです。
バージョンを指定しなければ、production が指すバージョンが使われます。別のバージョンを選ぶには、次の 2 つのフィールドのどちらか一方を指定します。両方は指定できません。
| フィールド | 例 | デモで使われたバージョン |
|---|---|---|
| 指定なし | v1(production) | |
prompt_label | "staging" | v2 |
prompt_version | 1 | v1 |
ID 指定の同じ呼び出しは、3 つのエンドポイントすべてで動作しました。Chat Completions と Responses は OpenAI SDK、Messages は Anthropic SDK を使い、同じ extra_body を渡しています。いずれも GPT-6 Luna の v1 で処理されました。Responses では、バージョンのメッセージが input に入ります。エンドポイントごとのフィールド対応は、プロンプトライブラリのガイドに記載しています。
ID 指定の呼び出しは、コードに直接書くより高くなる?
ID 指定でも、コードに直接記述したリクエストでも、料金は同じです。ゲートウェイからプロバイダーに送るのは通常のリクエストだからです。20 組の比較で確認しました。各組ではプロンプトをレンダリングし、そのリクエストをインラインで送る方法と、同じ変数値を ID 指定で送る方法を交互の順序で実行しました。同じ組には同じソルトを使っています。ソルトはメッセージに追加する短いランダムなタグで、組ごとに異なるリクエストにするためのものです。
| プロンプトのトークン数の中央値 | クライアント側レイテンシの中央値 | |
|---|---|---|
prompt_id 指定 | 114.5 | 4.1 秒 |
| インライン指定 | 114.5 | 4.6 秒 |
トークン数は完全に一致しました。ID 指定のほうが速く、追加のオーバーヘッドでこの差は説明できません。そのため、この差は GPT-6 Luna の呼び出しごとのばらつきと捉え、ID 指定による計測可能な遅延はなかったと判断しました。レイテンシの差について統計的な検定は行っていません。
モデルを呼ばずに送信内容を確認するには、レンダリングを使います。POST /v1/prompts/{id}/render は同じ変数を受け取り、解決後のリクエストとバージョンを返します。
curl https://synthorai.io/v1/prompts/support-answer/render \
  -H "Authorization: Bearer $SYNTHORAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"format": "chat", "prompt_variables": {"customer_message": "Where is order A-50977?", "order_status": "in transit"}}'
レンダリングは課金されず、Logs にも記録されません。デモのレンダリング後に確認したところ、そのセッション ID に対応するリクエストは Logs にありませんでした。ただし、キーのレート制限にはカウントされます。
ラベルの変更は何秒で呼び出しに反映される?
10 秒未満です。今回の実行では、呼び出しが続いている状態で 8-9 秒、呼び出しが途切れた後は即座に反映されました。バージョンのリリースは、管理用キーを使った 1 回の呼び出しで行います。ラベルの参照先を、指定したバージョン番号に変更します。
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})
admin.put("/prompts/support-answer/labels/production", json={"version": 3}).raise_for_status()
ロールバックも同じ呼び出しで、元のバージョン番号を指定するだけです。コードは同じ ID を呼び続け、再デプロイは不要です。ラベルを変更できるのは管理者かワークスペースのオーナーだけで、変更はすべてワークスペースの監査ログに記録されます。
ship.py で反映時間を計測しました。0.5 秒間隔で呼び出しながら API で production を変更し、ヘッダーに新バージョンが現れるまで呼び出しを続け、その後も 10 秒間継続しました。v1 から v3 への変更を 5 回、逆方向を 5 回実行しました。その後、呼び出しを 15 秒間止めた状態で同じ 10 回の変更を繰り返しました。
| 条件 | 旧バージョンで処理された最後の呼び出しの送信時刻 | 新バージョンで処理された最初の呼び出しの送信時刻 |
|---|---|---|
| 0.5 秒間隔の呼び出し、v1 から v3 | 変更後の中央値 8.02 秒(7.53-8.53) | 中央値 8.52 秒(8.03-9.03) |
| 0.5 秒間隔の呼び出し、v3 から v1 | 中央値 7.52 秒(7.52-8.52) | 中央値 8.02 秒(8.02-9.02) |
| 15 秒間呼び出しなし、両方向 | なし | 10 回すべてで 0.0 秒 |
時間の起点は、ラベル変更の API 呼び出しが返った時点です。ドキュメントでは「約 10 秒」で反映されるとしています。この 2 つの結果は、ゲートウェイがラベルの読み取り結果を、最後に読み取った時点から数秒間保持する動作と整合します。トラフィックが続いている場合は保持した情報の期限が切れると変更が反映され、間が空いた後の最初の呼び出しではラベルを読み直します。20 回の変更すべてで、新バージョンを使った最初の呼び出しの後に旧バージョンが使われることはありませんでした。反映中に新旧のバージョンが行き来する挙動は見られませんでした。
呼び出しを処理できない場合はどうなる?
モデルを呼ぶ前に失敗し、呼び出したエンドポイントのエラー形式で 400 または 404 を返します。課金はされません。errors.py で次の 5 通りを試しました。
| 呼び出し | ステータス | コード | メッセージ |
|---|---|---|---|
tone なしで v4 を呼び出す | 400 | prompt_variable_missing | ”prompt_variables: missing tone (no value and no default)“ |
| バージョンとラベルを両方指定する | 400 | prompt_invalid | ”send prompt_version or prompt_label, not both” |
| 存在しない ID を指定する | 404 | prompt_not_found | ”prompt_id: no prompt “support-answer-missing” in this workspace” |
| バージョン 99 を指定する | 404 | prompt_not_found | ”prompt “support-answer” has no version 99” |
| 参照先のないラベルを指定する | 404 | prompt_not_found | ”the “development” label of prompt “support-answer” points to no version yet” |
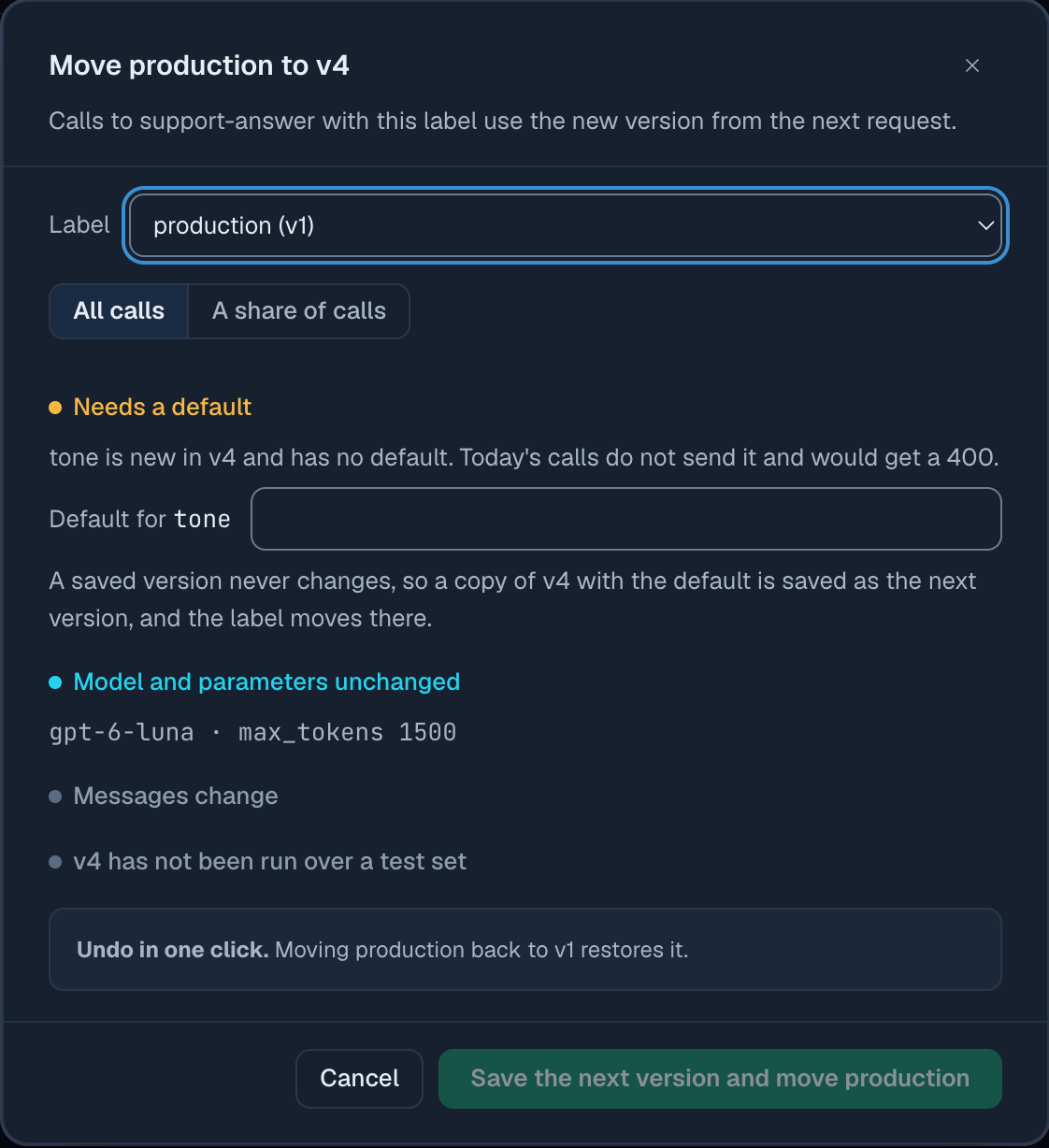
5 件とも課金記録はありませんでした。最初の行は、既存の呼び出しを壊す変更です。v4 はデフォルト値のない変数を追加するため、tone を送らない呼び出しはすべて失敗します。コンソールでは、リリース前にこれを検出します。production を v4 に変更しようとすると、現在の呼び出し元への影響を確認するダイアログが開き、デフォルト値の入力を求めます。入力した値は次のバージョンとして保存されます。
一時的にライブラリを読み取れない場合、ゲートウェイは最後に読み取ったコピーを最長 24 時間使い、応答に X-Synthorai-Prompt-Stale: 1 を追加します。最近のコピーがないプロンプトは 503 prompt_unavailable を返すので、リトライしてください。デモでは、どちらのケースも発生しませんでした。
バージョンには文面以外に何を保存できる?
バージョンには、システム文、メッセージ、モデル、5 つのパラメータ、出力スキーマ、関数ツールを保存できます。パラメータは呼び出し元の指定が優先されます。バージョン側の temperature、max_tokens、top_p、response_format、reasoning_effort は、リクエストで同じフィールドを指定していない場合だけ適用されます。
policy-check は JSON スキーマをバージョンに保存しています。そのため、呼び出し元が形式を指定しなくても、スキーマに従った JSON が返ります。API から保存する場合、params に形式を指定し、schema にスキーマ本体を入れます。
version = {
    "model": "deepseek-v4.1-flash",
    "system": "You review messages to an online electronics shop's support desk. ...",
    "messages": [{"role": "user", "content": "{{customer_message}}"}],
    "params": {"max_tokens": 300, "response_format": "json_schema"},
    "schema": {"name": "policy_check", "strict": True, "schema": {
        "type": "object",
        "properties": {"topics": {"type": "array", "items": {"type": "string"}},
                       "risk": {"type": "string", "enum": ["low", "medium", "high"]}},
        "required": ["topics", "risk"], "additionalProperties": False}},
}
admin.post("/prompts/policy-check/versions", json={"body": version, "note": "v1: JSON check"}).raise_for_status()
response_format: "json_schema" を指定せずにスキーマを保存しようとすると、その理由を示す 400 で拒否されます。DeepSeek V4.1 Flash で policy-check を 1 回呼び出したところ、入力 151 トークン、出力 18 トークンで {"topics": ["shipping", "refunds"], "risk": "medium"} が返り、料金は $0.000033 でした。この呼び出しでは、呼び出し元から reasoning_effort: "none" を送りました。デモのバージョンは、この設定をバージョンに保存できるようになる前に作成したためです。現在は params に保存できます。確認のため reasoning_effort: "none" を指定したテスト用バージョンを保存してレンダリングしたところ、Chat Completions では reasoning_effort、Responses では reasoning.effort がリクエストに含まれました。Messages では、バージョンに保存された値は送信されません。Claude モデルの思考設定は形式が異なるため、呼び出し元から指定してください。
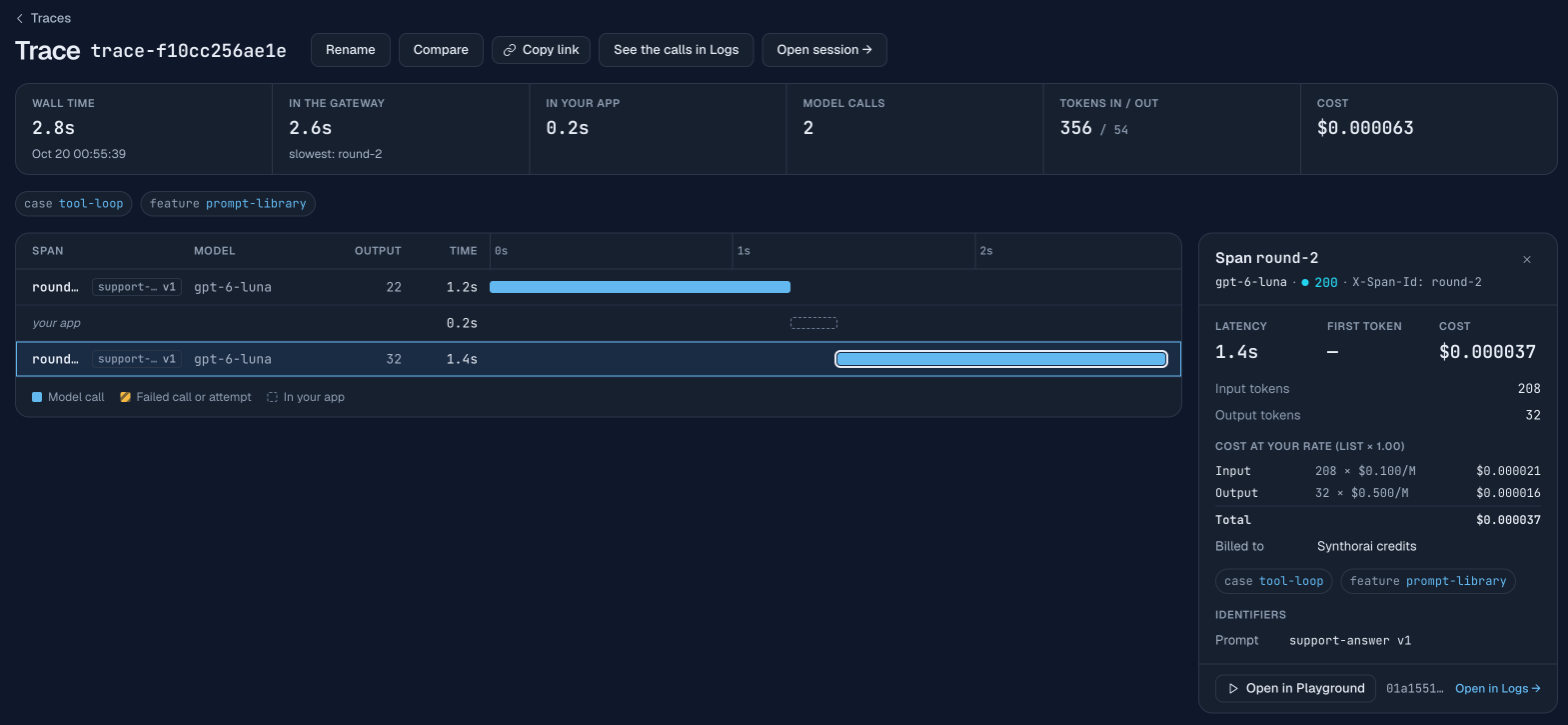
ツール呼び出しや複数ターンの会話は、ライブラリのプロンプトを使わない場合と同じように動作します。バージョンに保存されたメッセージが先に入り、その後に呼び出し元が送った会話が続きます。デモのツールループでは、1 ラウンド目にモデルが lookup_order({"order_id": "A-50977"}) を要求しました。2 ラウンド目では、モデルのツール呼び出しとツールの実行結果を通常のメッセージとして同じ ID に送り、v1 がその結果を使って回答しました。
呼び出しに使われたバージョンはどこで確認できる?
各呼び出しにはプロンプトとバージョンが記録され、次の 3 か所で確認できます。
- 応答:
X-Synthorai-Prompt-Versionヘッダーで確認できます。デモでは、各呼び出しの結果と並べてこの値を出力します。 - Logs:
prompt = support-answerとprompt_version = 3で絞り込むと、そのバージョンの呼び出しを一覧にできます。リクエストの詳細にもプロンプトとバージョンが表示されます。GET /api/v1/requestsでも、同じprompt_idとprompt_versionのフィルターを使えます。 - トレース: ウォーターフォールの各モデル呼び出しの行に「prompt vN」バッジが付き、呼び出しのパネルにもプロンプトとバージョンが表示されます。LLM エージェントのトレースで使ったトレース用ヘッダーは、ID 指定の呼び出しでもそのまま使えます。
プロンプト画面では、7 日、30 日、90 日の期間で、呼び出し数、エラー数、料金、トークン数、レイテンシをバージョン別に集計できます。段階的リリースのガイドでは、この画面で本番トラフィック上の 2 つのバージョンを比較します。
この記事で扱わない機能は?
- 段階的リリースとテスト。 本番トラフィックの一部を候補バージョンに送る方法はプロンプト変更の A/B テスト、固定の入力セットでバージョンを検証する方法はリリース前のプロンプトテストで扱います。
- パーシャル。 テキストのブロックを一度だけ保存し、
{{>id}}で複数のプロンプトに取り込めます。保存した各バージョンは、取り込んだパーシャルのバージョンを固定します。 - 変更通知の Webhook。 プロンプトにバージョンが追加されたときやラベルが変更されたときに、署名付き POST を送ります。プロンプトを git やチャットチャンネルに同期する用途に使えます。デモの
webhook.pyは署名を検証しますが、実際の配信は受信していません。 - 作成時の冪等性。
Idempotency-Keyヘッダーで、安全にリトライできます。同じキーのリクエストには、24 時間にわたって最初の応答を返し、プロンプトを重複作成しません。プロンプトを削除した後も有効なので、削除済みのプロンプトを作り直す場合は新しいキーを送ってください。
よくある質問
プロンプトのバージョン管理とは?
各プロンプトを、保存後は変更できない番号付きのバージョンとして管理することです。本番で使うバージョンは、コードの変更ではなくラベルで選びます。ロールバックは、ラベルの参照先を前のバージョンに戻すだけです。
ID 指定で呼び出すと、レイテンシやトークン数は増える?
今回の 20 組の比較では、どちらも増えませんでした。プロンプトのトークン数の中央値は両方とも 114.5 で、ID 指定の呼び出しが遅くなることもありませんでした。ゲートウェイがバージョンを解決し、プロバイダーには通常のリクエストを送ります。
プロンプトの変更はどのくらいで本番に反映される?
約 10 秒以内です。今回の実行では、呼び出しが続いている状態で、新バージョンを使った最初の呼び出しはラベル変更から 8.0-8.5 秒後(中央値)に送信されました。トラフィックが 15 秒間途切れた後は即座に反映されました。
OpenAI SDK や Anthropic SDK をそのまま使える?
どちらも変更なしで使えます。プロンプト関連のフィールドを extra_body で送り、必須引数を満たすために任意のモデル名と空のユーザーメッセージを渡します。
関連記事
- プロンプトライブラリのガイド:この記事で使ったすべてのフィールド、エラー、応答ヘッダー。
- コンソールでのプロンプト管理:エディター、バージョン間の差分、ラベル変更ダイアログ。
- プロンプト変更の A/B テスト:10% への段階的リリースとバージョン別の比較。
- リリース前のプロンプトテスト:テストセット、チェック項目、1 回の実行で分かることと分からないこと。
- LLM エージェントのトレース:このデモでも引き続き送信するセッションとトレースのヘッダー。