
プロンプトを本番投入前にテスト:評価で見つかった 16% の品質低下
プロンプトを短縮した際に、ルールが1つ抜け落ちた。新規メッセージ110件を使った比較では、短縮した新版で注文番号の記載漏れが18件(16%)発生し、旧版では0件だった。一方、40行のテストを1回実行した結果は記載漏れ0件で、110件での検証とは異なる結果になった。
推奨モデル
リアルタイム価格| モデル | 評価 | 価格 |
|---|---|---|
| GPT-6 Luna support-answer の v1 は、275 回のテスト呼び出しのうち 275 回で注文番号を明示しました。システムプロンプトを短くした v2 は、事前に確定した実行で 110 回中 92 回、注文番号を明示しました。 | テスト対象の両バージョンで使用するモデル | $0.1/100万〜 |
| Claude Sonnet 5.5 各回答が顧客の質問に答えているかを PASS または FAIL で評価しました。このモデルの呼び出し費用は、テストを六回実行した総費用 $0.14 のうち $0.12 でした。 | デモでの評価用モデル | $2/100万〜 |
目次
プロンプトを本番投入前にテストするには、新版と現行版に同じ固定入力を与え、あらかじめ書き出したルールで回答を 1 件ずつ検証する。今回はサポート用プロンプトの v2 でこれを試した。v2 はシステム文を短縮した際に「必ず注文番号を記載する」というルールを削っており、テストはこのリグレッション(出力の品質を下げる変更)を検出するためのものだ。過去の実行で使っていないメッセージ 110 件では、v2 が 18 件(16%)で注文番号を省略し、v1 は 0 件だった。偶然では説明しにくい差だ(Fisher の正確確率検定、p = 3.6 × 10⁻⁶)。一方、それ以前の 40 件の実行では記載漏れが 1 件も出ない回もあった。1 回の実行で合格しただけでは、そのバージョンに問題がないとは判断できない。
TL;DR
- 実行前に内容を確定したテストでは、support-answer の v2 が 110 件中 18 件で注文番号を省略した。v1 は 110 件中 0 件だった(p = 3.6 × 10⁻⁶)。
- それ以前に実施した 40 行のテスト 3 回のうち、1 回は v2 が全 40 行に合格した。最終テストの 3 セットにも、単独では問題を検出できないセットが 1 つあった。
- デモのスクリプトによるテスト呼び出し 275 回すべてで、v1 は注文番号を記載した。
- 15-20 行のテストを 6 回実行した費用は $0.14 で、そのうち $0.12 が判定モデルの費用だった。
この記事は、support-answer とそのバージョンを用意するプロンプトのバージョン管理の続編だ。v1 と v2 はどちらも GPT-6 Luna を使い、違いはシステム文だけだ。github.com/synthorai-io/use-cases の同じディレクトリから実行する。
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
この記事の実行結果は 2026 年 10 月 19 日のものだ。判定モデルには、テスト対象のモデルとは別の Claude Sonnet 5.5 を使った。
プロンプトのテストには何を用意するか
テストセットは、入力を並べた表とチェック項目のリストで構成する。各行にはプロンプト変数の値を指定し、必要に応じてユーザーメッセージや期待する回答も指定する。テストを実行すると、各行について候補版と基準版を呼び出し、すべてのチェック項目でそれぞれの回答を評価する。チェックの種類は次のとおりだ。
| チェック | 回答の合格条件 |
|---|---|
contains / not_contains | 指定した文字列を含む、または含まない |
regex / not_regex | パターンに一致する、または一致しない(Go の RE2 構文) |
equals_expected | その行の期待する回答と一致する |
json / schema | 有効な JSON である、またはバージョンの出力スキーマに従う |
max_latency_ms / max_cost_usd | 応答時間と費用が上限以内に収まる |
judge | 記述した評価基準に対し、モデルが PASS と判定する |
1 セットに登録できるのは最大 50 行で、各チェックはセット内の全行に適用される。そのため、チェックの内容に合わせてセットを分ける。「回答に注文番号が含まれる」というチェックは、注文番号のあるメッセージにしか適用できない。デモでは、それらを独立したセットにまとめている。
| セット | 行の内容 | チェック |
|---|---|---|
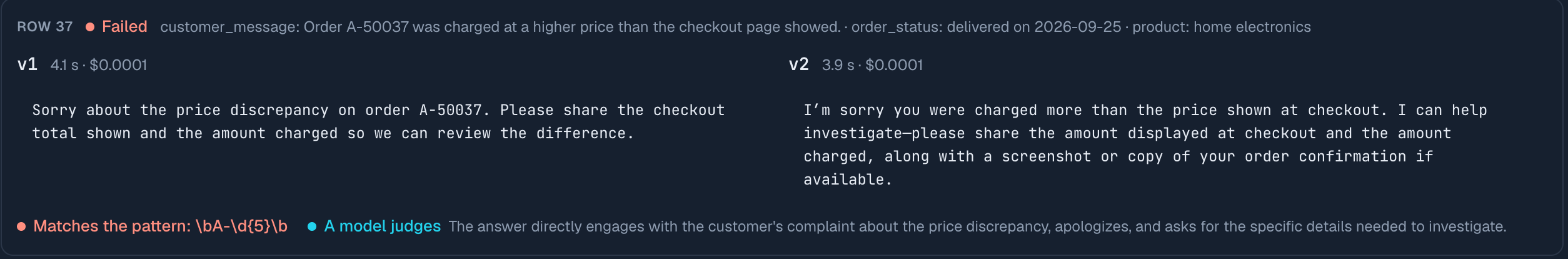
| orders(15 行、その後 40 行) | 各メッセージに注文番号があり、配送、返品、誤配送、破損、請求について問い合わせる | 注文番号がある(regex \bA-\d{5}\b)。モデル判定:顧客の質問に答えている |
| fresh orders 1-3 | 同種の新規メッセージ 110 件。他のセットとの重複はなく、40 行、35 行、35 行に分割 | 同じ 2 項目 |
| general(20 行) | 注文番号のないメッセージ。返金時期についての問い合わせを複数含む | not_contains で「refund by」と「business days」を含まない。レイテンシが 20 秒未満。モデル判定:質問に答えている。モデル判定:返金日を約束していない |
judge チェックは回答ごとにモデルを 1 回呼び出し、PASS または FAIL を返す。費用がかかり、誤判定もあり得るため、デモではパターンで表現できない条件にだけ使い、結果もパターンによるチェックとは分けて報告する。
コードや CI からプロンプトのテストを実行するには
CI(継続的インテグレーション、変更をマージする前に毎回実行するチェック)からも API 経由でプロンプトをテストできる。テスト自体を実行するのは呼び出し元のコードだ。実行を作成し、各行について prompt_version を指定して両バージョンを呼び出し、回答を評価して結果を書き戻す。結果は他の実行と同じようにコンソールに表示される。デモのループを短くすると次のようになる。
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
                    "results": {"rows": results}})
call_by_version は、プロンプトのバージョン管理で紹介した、ID と prompt_version を指定する呼び出しだ。judge は判定モデルを呼び出し、PASS または FAIL を求める。ロールアウト時には source: eval ラベルが重要になる。Prompts ページのバージョン別集計から、このラベル付きの呼び出しは除外されるため、テストで本番トラフィックの比較を歪めずに済む。
デモではパターンによるチェックを Python で評価している。コンソールとまったく同じ方法で評価するには、チェックと回答を POST /api/v1/prompt-checks/grade に送る。このエンドポイントはサーバー側で RE2 を使い、contains、not_contains、regex、not_regex、equals_expected、json を適用し、チェックと回答の組み合わせごとに合否を返す。簡単に試したところ、「REFUND by Friday」に対する (?i)refund は合格、同じ回答に対する not_regex の (?i)refund.{0,40}\bby\b は不合格となり、想定どおりだった。
コンソールの Run ボタンも、ブラウザーから同じ処理を行う。行ごとに両バージョンを呼び出し、結果を保存する。40 行の orders セットをコンソールで実行した例(後述の実行 10)では、候補版だけを評価し、v1 の回答はチェックせず横に表示した。
テストでリグレッションを検出できたか
検出できた。テスト内容は実行前に確定した。過去の実行で使っていない新規メッセージ 110 件を用意し、各行で各バージョンを 1 回ずつ呼び出す。注文番号のチェックについて全 110 行をまとめ、Fisher の正確確率検定を 1 回だけ行い、有意水準を 0.05 とした。Fisher の正確確率検定では、両バージョンが本当に同じ振る舞いをすると仮定したとき、観測された差以上の差が出る確率を求める。両側検定なので、どちらの方向の差も対象になる。最初の呼び出しより前に、入力行とこの判定ルールをリポジトリにコミットした。結果は次のとおりだ。
| セット | v2 が注文番号を記載 | v1 が注文番号を記載 | このセット単独での Fisher 検定の p 値 |
|---|---|---|---|
| fresh orders 1(40 行) | 33/40 | 40/40 | 0.012 |
| fresh orders 2(35 行) | 27/35 | 35/35 | 0.005 |
| fresh orders 3(35 行) | 32/35 | 35/35 | 0.239 |
| 全 110 行 | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
v2 は回答の 16% で注文番号を記載しなかった。漏れは特定の問い合わせに偏っていない。配送、返品、誤配送、破損ではそれぞれ 22 件中 4 件、請求では 22 件中 2 件だった。典型例が「注文 A-50918 について、銀行アプリに保留中の請求が 2 件表示されています」という問い合わせへの回答だ。2 件の表示は二重請求ではなく保留中のオーソリの可能性があると説明し、判定モデルは合格としたが、注文番号は一度も記載しなかった。
セット別の p 値は、それぞれのセットの結果を示すもので、今回の検定そのものではない。3 セットのうち 2 セットは単独でも v2 の問題を検出できたが、残る 1 セットでは検出できなかった。
1 回の合格でリグレッションを見逃すのはなぜか
違反が毎回起きるわけではないルールなら、1 回の実行中に一度も違反しないことがある。上のテストより前に、デモでは 40 行のセットで v2 と v1 を 3 回比較した。
| 実行 | v2 が注文番号を記載 | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10(コンソール) | 39/40 | 保存済みの回答をデモ側で評価した結果は 40/40 |
実行 9 では v2 が全 40 行に合格した。テストを 1 回だけ実行してこの結果を得たチームなら、v2 を本番投入していただろう。また、これらの実行はいずれも単独では統計的に有意ではない。記載漏れが一度もない基準版と比較する場合、40 行以上の実行で p 値を 0.05 未満にするには、少なくとも 6 件の漏れが必要だ(40 件中 34 件の記載で p = 0.026、40 件中 35 件なら 0.055)。小さいセットなら必要な漏れは少なく、20 件中 5 件の漏れで p = 0.047 になる。
テストの規模を決める際は、漏れの期待件数が 6 件になるだけでなく、実際に 6 件以上出る確率が十分高くなる行数を用意する。漏れ率が 16% なら、48 行で 6 件以上漏れる確率が 80% になる。38 行では期待件数が 6 件でも、その確率は 58% にすぎない。上記の 40 行セットでの漏れ率 6.25%(160 回答中 10 件)では、確率を 80% にするのに 126 行必要だ。重視するルールは 1 セットの上限を超える行数で検証し、複数セットに分け、集計方法を事前に決めておく。同じ行を繰り返しても、新しい行を追加するのと同じだけの証拠は得られない。同じメッセージを再テストするため、独立したサンプルにならないからだ。実際にデモでは、ある実行で v2 が記載を漏らした 3 行で、別の実行でも記載漏れが起きた。
プロンプトの短縮で他にも問題が出たか
他のチェックでは、追加の問題は見つからなかった。general セットを各 3 回実行した結果は次のとおりだ。
- 返金日を約束しない: どちらのバージョンも「refund by」「business days」を一度も出力しなかった。モデル判定で不合格になったのは、各バージョンの各実行で最大 20 件中 2 件で、バージョン間の差はなかった。
- レイテンシ: v1 は 1 回の実行で 2 行が 20 秒を超えた。v2 は一度も超えなかった。
- 質問に答えている(モデル判定): すべてのセットで v2 の評価が高く、新規セットでは 110 件中 88 件が合格し、v1 は 110 件中 75 件だった。この比較は事前に決めていなかったため、傾向として扱う。判定モデルの評価では、短いプロンプトのほうが質問に直接答えている。
コンソールとデモの判定モデルでは、異なるプロンプトを使っている(コンソールでは判定理由も出力する)。同じ 40 件のメッセージに対し、別々の実行で得られた回答を評価すると、コンソールは v2 を 40 件中 40 件で合格とし、デモの判定モデルは 32-35 件を合格とした。判定モデルの結果は、同じ評価器を使ったもの同士でのみ比較する。
プロンプトのテストにはいくらかかるか
このデモのモデルで、2 バージョンとモデル判定 1 項目を実行すると、1 行あたり約 0.1 セントになる。
| 実行 | 1 回あたりの行数 | 呼び出し | 費用 |
|---|---|---|---|
| 15 行と 20 行のセットを計 6 回 | 15 または 20 | 回答生成とモデル判定 | $0.1400、そのうち判定モデルの呼び出しが $0.1198 |
| 40 行セットを 3 回 | 40 | 回答生成 240 回 + モデル判定 240 回 | $0.115 |
| 事前に内容を確定したテスト | 110 | 回答生成 220 回 + モデル判定 220 回 | $0.1076 |
回答ごとに、より大きなモデルで判定するため、費用の大部分は判定モデルが占める。呼び出しを順次実行した場合、40 行の実行に 10 分かかった。並列化すれば短縮できるが、その分レート制限への負荷は増える。
本番投入の判断にテストをどう使うか
コンソールで production の参照先を移動すると、変更内容とともに、そのバージョンの直近のテスト結果がダイアログに表示される。判断材料として表示するだけで、移動をブロックするものではない。テストセットと実行時の回答は暗号化して保存され、回答の保持期間は 30 日だ。
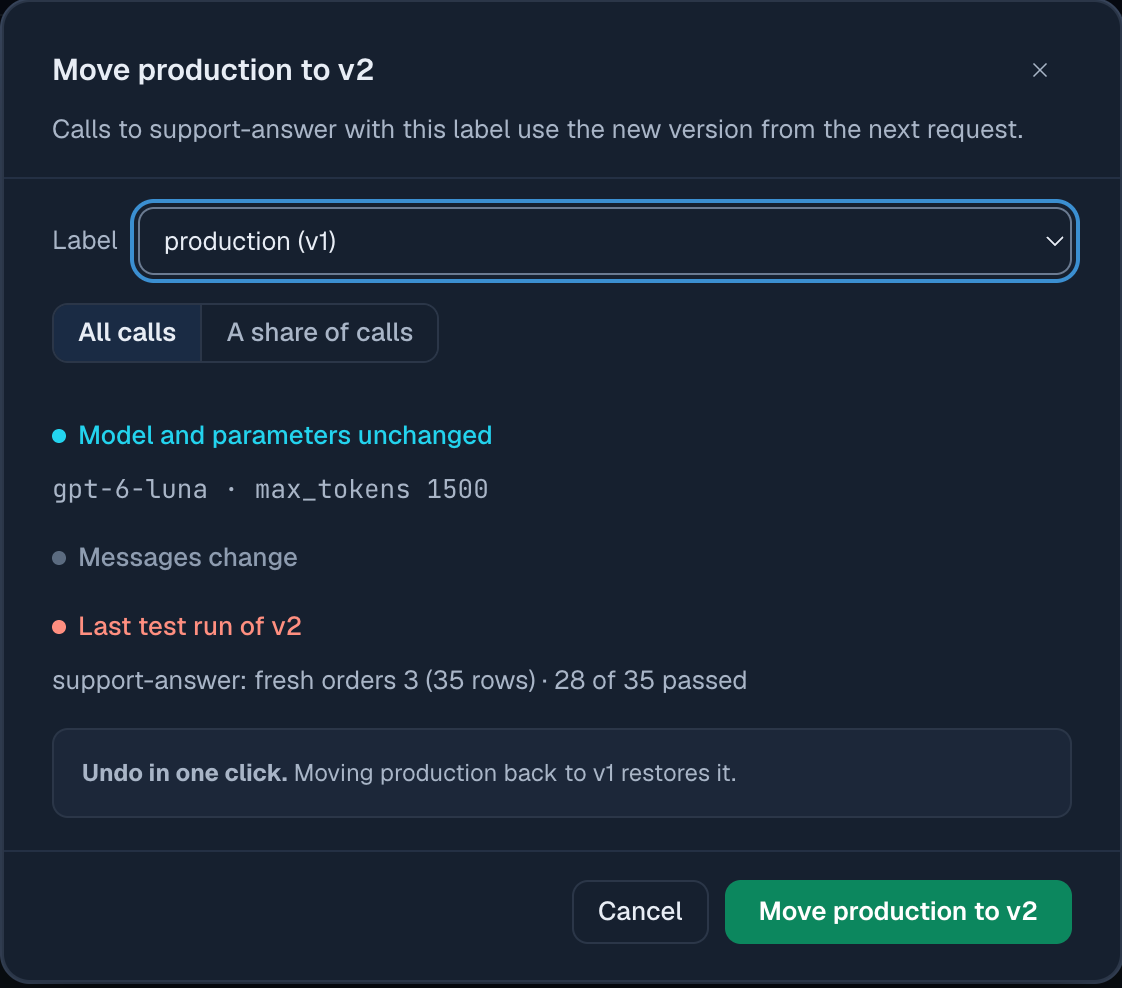
ダイアログでは、セット内のすべてのチェックに合格した行だけを合格として数える。そのため、この 35 行中 28 行という値には、パターンによるチェックとモデル判定の両方が反映されている。
今回の対象外は何か
- 行ごとのチェック。 チェックはセット内の全行に適用される。そのため、デモでは注文番号のあるメッセージとないメッセージを別々のセットにしている。
- サーバー側でのテスト実行。 API でもコンソールの Run ボタンでも、モデルの呼び出しは呼び出し元側で行う。サーバー側でテスト全体を実行し、完了を待つエンドポイントはない。
- 判定モデルの精度。 人間の評価との照合は行っていないため、判定モデルの数値は傾向として扱う。この記事で明確な検出結果としているのは、パターンによるチェックだけだ。
よくある質問
LLM のプロンプトをデプロイ前にテストするには
新版と現行版に同じ固定入力を与え、明文化したルールで全回答を検証する。そのうえで、事前に決めた有意差検定で合格件数を比較する。デモでは、新規メッセージ 110 件と 1 回の Fisher の正確確率検定で、漏れ率 16% と 0% の差を検出した。
プロンプトのリグレッションテストには何件のテストケースが必要か
リグレッションが実際にある場合に、ルール違反が少なくとも 6 件起きる確率が十分高くなる行数を用意する。その確率を 80% にするには、違反率が 16% なら 48 行、6.25% なら 126 行必要だ。デモでは、本テストで回答の 16% がルールに違反したバージョンが、40 行の実行では全件合格したこともあった。
LLM による判定でパターンのチェックを置き換えられるか
パターンで表現できるチェックを、モデル判定に置き換えるべきではない。デモでは、コンソールとスクリプトで異なる判定用プロンプトを使った結果、同じ 40 件のメッセージに対して、v2 の合格数は一方が 40 件中 40 件、もう一方が 40 件中 32-35 件だった。パターンなら、同じテキストに対して毎回同じ結果になる。
関連記事
- プロンプトのバージョン管理:ID によるプロンプトの呼び出しとラベルの移動。
- プロンプト変更の A/B テスト:本番トラフィックでのバージョン別費用。
- プロンプトライブラリのガイド:テストセット、チェック、評価の実行。
- コンソールのプロンプト管理:テストエディターと移動ダイアログ。