
プロンプト変更の A/B テスト:10% の段階展開で 1.9x のコスト増を検出
本番トラフィックの10%を新しいプロンプトバージョンに振り分け、セッション単位で割り当てを固定する検証。実測では200セッション中8.0%に当たる16セッションが新版に割り当てられました。全セッションで同一バージョンが維持され、呼び出し1回あたりのコストは従来比1.94倍でした。
推奨モデル
リアルタイム価格| モデル | 評価 | 価格 |
|---|---|---|
| GPT-6 Luna support-answer の v1 は、ロールアウトでの 1,272 回の呼び出しにおいて、1 回あたりのコストが $0.000110、レイテンシの中央値が 4.9 秒でした。reasoning_effort を none にすると、コストは $0.000034 でした。 | デモの本番バージョン | $0.1/100万〜 |
| DeepSeek V4.1 Flash このモデルで同じプロンプトを使用した v3 は、応答が速く(中央値 3.1 秒)、一方で 1 回あたりのコストは $0.000213 と、v1 の 1.94 倍でした。これは、トークン単価が高く、出力トークン数も 1.6 倍だったためです。 | デモの候補バージョン | $0.3/100万〜 |
目次
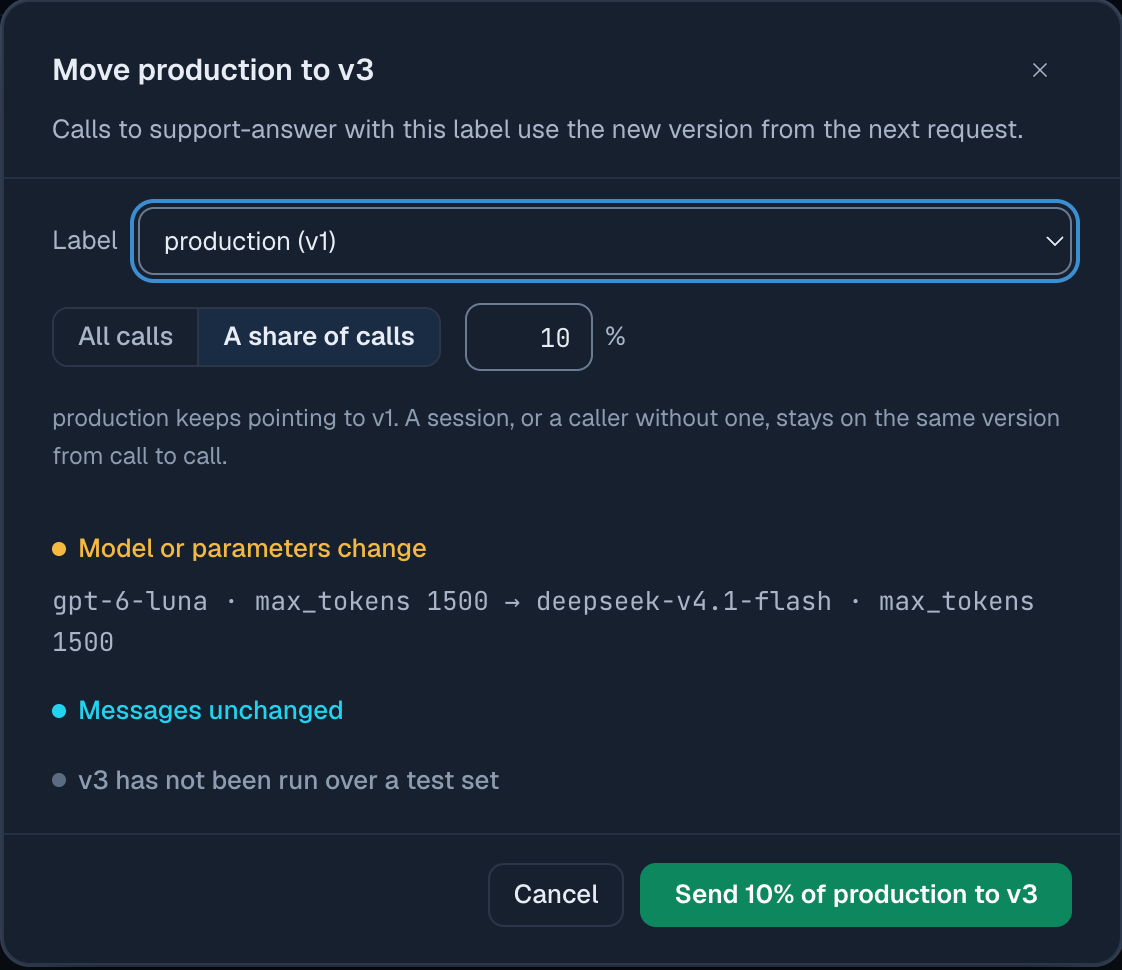
プロンプトの段階展開では、同じプロンプト ID への呼び出しの一部を候補バージョンに振り分け、残りは本番バージョンで処理します。全体を切り替える前に、実際のトラフィックで両者を比較できます。Synthorai のプロンプトライブラリでは、production ラベルに「v1 を使い、10% は v3 に振り分ける」と設定します。ゲートウェイはセッション ID でバージョンを決めるため、会話の途中で切り替わることはありません。今回の実行では、10% の設定で 200 セッション中 16 セッション(8.0%)が候補に割り当てられ、すべてのセッションで同じバージョンが使われました。候補ではプロンプトの実行先モデルを変更していましたが、そのコストは未計測でした。10% の段階だけでも、バージョン別の集計から、候補の呼び出し単価が 1.92 倍だと分かりました。
TL;DR
- 10% の段階展開では、200 セッション中 16 セッション(8.0%、95% 区間は 5.0-12.6%)が候補に割り当てられました。50% では 200 セッション中 111 セッション(55.5%)でした。
- 3 ターンの会話を行った全 400 セッションで、プロンプトのバージョンは固定されました。
_user、リクエスト本文のuser、safety_identifierで識別したエンドユーザーも、全員同じバージョンを使い続けました。 - 候補は同じプロンプトを GPT-6 Luna ではなく DeepSeek V4.1 Flash で実行します。呼び出し単価は $0.000213 対 $0.000110、レイテンシの中央値は 3.1 s 対 4.9 s でした。
prompt_version=1に固定した呼び出しは、40 件中 0 件、つまり一度も候補に振り分けられませんでした。
この記事は、2 つのプロンプトとそのバージョンを用意するプロンプトのバージョン管理の続きです。github.com/synthorai-io/use-cases の同じディレクトリで実行します。
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
段階展開は 2026 年 10 月 19 日に実施し、1,840 回呼び出しました。エンドユーザーの振り分けを確認したのは 10 月 20 日です。本番は GPT-6 Luna で動く support-answer の v1 です。候補の v3 は、同じシステムテキストとメッセージを DeepSeek V4.1 Flash で実行します。変更点はモデルだけです。
本番の 10% を新バージョンに振り分けるには
production ラベルに、もう 1 つのバージョンと振り分け率を設定します。管理者キーがあれば、設定も停止もそれぞれ 1 回の API 呼び出しで済みます。
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
呼び出し側の変更は不要です。これまでどおりバージョンを指定せずに support-answer を呼び出せます。どのバージョンが応答したかは、レスポンスヘッダーの X-Synthorai-Prompt-Version で確認できます。候補を正式に採用するには、production をそのバージョンに移します。これで段階展開は終了します。コンソールでは、候補のページにある「段階的に展開」が同じ設定にあたります。設定後、プロンプト一覧のラベル表示は「production v1 · v3 10%」になります。
どの呼び出しが候補に振り分けられるか
ゲートウェイは、各呼び出しの固定キーからバージョンを選びます。振り分け率を変えない限り、同じキーには常に同じバージョンが割り当てられます。キーには、次のうち呼び出しに含まれる最初のものを使います。
- セッション ID(
X-Session-Id。LLM エージェントのトレースで使うヘッダー)。 - エンドユーザー。まず
X-Synthorai-Metadataの_userラベルを使い、なければリクエスト本文のuser、safety_identifier、Anthropic のmetadata.user_idの順に使います。 - いずれもなければ、リクエスト自体。呼び出しごとに個別に振り分けます。
rollout.py では、10% と 50% の振り分け率で各ケースを確認しました。1 セッションは 3 ターン、エンドユーザー 1 人あたり 2 回の呼び出しです。
| 呼び出し | 10% 設定時の v3 割り当て | 50% 設定時の v3 割り当て | 同じバージョンを維持 |
|---|---|---|---|
200 セッション、X-Session-Id | 16 = 8.0%(5.0-12.6%) | 111 = 55.5%(48.6-62.2%) | 400 セッション中 400 |
エンドユーザー 50 人、_user ラベル | 6 | 27 | 100 人中 100 |
| どちらもない呼び出し 100 件 | 11 = 11.0%(6.3-18.6%) | 49 = 49.0%(39.4-58.7%) | 対象外 |
prompt_version=1 に固定した呼び出し 20 件 | 0 | 0 |
括弧内は 95% 信頼区間です。この試行数から推定される真の割合の範囲を示しており、いずれも設定した振り分け率を含んでいます。リクエスト本文の 2 つのフィールドは、別の実行で 50% に設定して確認しました。本文の user だけで識別する 50 人と、safety_identifier だけで識別する 20 人について、それぞれ 2 回ずつ呼び出しています。全 70 人でバージョンは固定され、v3 に割り当てられたのは 50 人中 25 人と 20 人中 8 人でした。
実運用で押さえる点は 2 つです。複数ターンの会話でバージョンを揃えるには、セッション ID が必要です。会話内のすべての呼び出しに付けてください。キーが何もなければ、同じユーザーでも、ある呼び出しは v1、次は v3 になる可能性があります。また、prompt_version でバージョンを明示した呼び出しは、段階展開の対象外です。バージョンを固定したテストやバッチジョブは、指定したバージョンで処理され続けます。
2 つのバージョンをどう比較するか
Prompts ページでは、呼び出し数、エラー数、費用、token 数、レイテンシをバージョン別に集計します。Requests API でも、prompt_id と prompt_version で絞り込めば同じ指標を取得できます。デモでは、段階展開の終了後に取得しました。
| バージョン | リクエスト数 | 費用 | 呼び出し単価 | レイテンシ中央値 | 呼び出しあたりの出力 token 数の平均 | 呼び出しあたりの推論 token 数の平均 |
|---|---|---|---|---|---|---|
| v1、GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3、DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
推論 token は、モデルが回答前に思考するために生成する token です。出力として課金されますが、回答には表示されません。
プロンプトの Calls タブにも同様の集計が表示されます。7 日間の表示では、段階展開だけでなく、各バージョンに対するデモの全呼び出しを数えるため、上の表より数値が大きくなります。
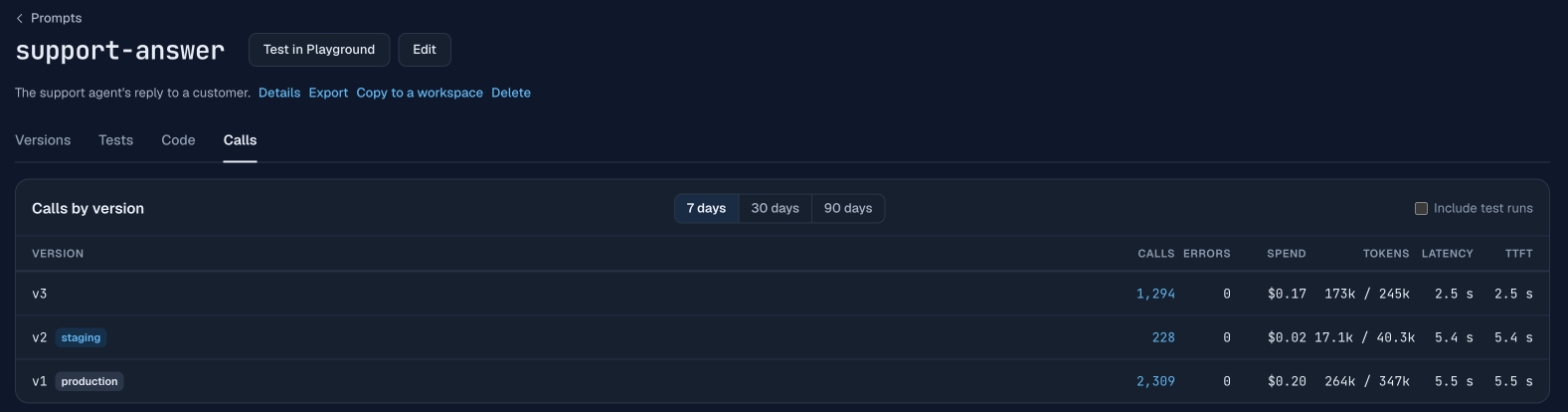
実行全体で見ると、v3 は速い一方、呼び出し単価は 1.94 倍でした。原因は 2 つあります。このゲートウェイでは、DeepSeek V4.1 Flash の token 単価が GPT-6 Luna より高く設定されています。オフピーク時の 100 万 token あたりの入力単価と出力単価は、それぞれ $0.15 と $0.60 で、GPT-6 Luna は $0.10 と $0.50 です。さらに、v3 は出力 token を 1.6 倍生成しました。その差のほぼすべてが推論によるものです。呼び出しあたりの推論 token 数は 256 対 149 で、回答自体は 65 token と 48 token(中央値)でした。どちらの数値も、プロンプトのテキストからは分かりません。10% の段階だけでも差は出ていました。v3 が応答した 71 件の単価は $0.000212、v1 が応答した 749 件は $0.000111 で、1.92 倍でした。
料金は時間帯にも依存します。段階展開中の DeepSeek 呼び出しは、すべてこのモデルのゲートウェイ上のオフピーク時間帯(北京時間 22:00-08:00)に実行されました。料金はピーク時の $0.30 と $1.20 の半額です。10 月 20 日の 140 件はピーク時間帯に実行されました。このときの呼び出し単価は v3 が $0.000394、v1 が $0.000107 で、3.7 倍でした。呼び出し数はそれぞれ 66 件と 74 件です。
1,840 件中 1,839 件が 200 を返しました。1 件は 300 s 後にクライアント側でタイムアウトし、エラーとして集計されています。そのセッションのほかのターンは処理されました。
推論をオフにすると結果は変わるか
両バージョンともコストが 3 分の 2 以上減りますが、v3 のほうが安くなるわけではありません。effort.py では、各バージョンを reasoning_effort なしで 50 回、呼び出し側から reasoning_effort: "none" を指定して 50 回呼び出しました。入力には、リリース前のプロンプトテストのテストセットにある顧客メッセージを使いました。すべてに注文番号が含まれます(40 メッセージのうち 10 件を 2 回使用)。
| バージョン | reasoning_effort | 呼び出し単価 | 出力 token 数の平均 | レイテンシ中央値 | 回答に注文番号を含む | 質問に答えていると判定 |
|---|---|---|---|---|---|---|
| v1、GPT-6 Luna | デフォルト | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1、GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3、DeepSeek V4.1 Flash | デフォルト | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3、DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
「none」では両モデルとも推論が完全になくなり、呼び出し単価は v1 で 68%、v3 で 75% 下がりました。50 回の呼び出しで確認できる範囲では、回答の品質は維持されました。すべての回答に引き続き注文番号が含まれ、モデルによる判定(Claude Sonnet 5.5 を呼び出し、回答が顧客の質問に答えているか評価)での差は、50 件中 2 件と 4 件でした。Fisher の正確確率検定では p = 0.82 と 0.44 です。この検定は、「none」に効果がないとした場合に、観測された差以上の差が出る確率を求めます。これだけ高い値なら、変化は偶然の範囲内です。両方を「none」にしても、v3 の呼び出し単価は v1 の 1.44 倍でした($0.000049 対 $0.000034)。これらの呼び出しも、ゲートウェイ上の DeepSeek のオフピーク時間帯に実行しています。
段階展開中、呼び出し側にはどのバージョンが応答するか分かりません。そのため、送信した reasoning_effort は両方に適用されます。代わりに、バージョン側に reasoning_effort を保存することもできます。呼び出し側が推論の設定を指定しなければ、ゲートウェイがその値を Chat Completions と Responses のリクエストに書き込みます。この形で保存した候補は、自分の設定を使って段階展開されます。バージョン別の集計でも、実際にリリースする設定同士を比較できます。
テスト実行は比較に影響するか
デフォルトでは影響しません。Prompts ページのバージョン別集計は、テストトラフィックを除外するためです。対象は Playground の呼び出し(コンソールのテスト実行を含む)と、X-Synthorai-Metadata で source: prompt-test または source: eval を付けた呼び出しです。「テスト実行を含める」をオンにすると、これらも集計されます。support-answer では、オンにすると v1 と v2 にそれぞれ 150 件が加わりました。内訳は、ラベル付き評価実行の各 110 件と、コンソールでのテスト実行の各 40 件です。v3 は変わりませんでした。ログと Requests API には引き続きすべての呼び出しが記録されます。段階展開中に評価を実行した場合は、そちらではラベルで絞り込んでください。
X-Synthorai-Metadata: {"source":"eval"}今回の対象外
- コストとレイテンシの統計検定。上のバージョン別の表は合計と平均の比較であり、差の検定はしていません。差をもとに判断する前に検定してください。小さな差では特に必要です。
- 本番トラフィックでの回答品質。段階展開で分かるのは、バージョンのコストと速度です。回答が正しいかどうかは、展開前に固定の入力セットで確認するほうが容易です。リリース前のプロンプトテストでは、v2 に対してこれを行っています。
- 自動停止。このデモには、候補のエラー率やコストが上限を超えたときに段階展開を終了する仕組みはありません。管理者が振り分け率を変更するか、ラベルを候補に移すか、段階展開を停止します。
よくある質問
本番環境でプロンプトを A/B テストするには
本番ラベルに候補バージョンと振り分け率を設定し、これまでどおりプロンプト ID を指定して呼び出します。そのうえで、バージョン別の集計を比較します。デモでは 10% の設定で 200 セッション中 16 セッションが候補に割り当てられ、数百回の呼び出し後には集計からコストが分かりました。
段階展開中も会話ごとにバージョンを固定できるか
呼び出しにセッション ID が付いていれば、会話内では同じバージョンが使われます。デモでは全 400 セッションで、3 ターンを通じてバージョンが固定されました。セッション ID がなければエンドユーザーの識別子を使い、どちらもなければ呼び出しごとに個別に振り分けます。
テキストを変えなくてもプロンプトのコストは上がるか
同じテキストでも、モデルを変えると上がることがあります。このデモもそうでした。DeepSeek V4.1 Flash を使う候補の呼び出し単価は、GPT-6 Luna 版の 1.94 倍でした。このゲートウェイでの token 単価が高く、推論にもより多くの token を使ったためです。モデルの料金だけでなく、バージョン全体の呼び出し単価を比較してください。
関連記事
- プロンプトのバージョン管理:ID を指定したプロンプトの呼び出しと、ラベルの移動。
- リリース前のプロンプトテスト:テストセットとチェック項目を使った v2 と v1 の比較。
- LLM エージェントのコストが高い理由:トレースで見つかった、請求額を押し上げるほかの 4 つの原因。
- プロンプトライブラリガイド:段階展開、バージョン別統計、全フィールドの説明。