
gemini-3.1-flash-lite-image vs GPT Image 2
どんなときに、どちらを選ぶか
どちらも100万出力トークンあたり同じ$30を請求する画像モデルであるため、実際の違いは入力にあります。gemini-3.1-flash-lite-imageは100万あたり$0.25でテキストと画像を受け取るのに対し、gpt-image-2は$5であるため、プロンプトと参照画像を20x安価に供給できます。入力ボリュームが請求の大半を占めるプロンプトの多いパイプラインやimage-in-image-outのパイプラインにはgemini-3.1-flash-lite-imageを選択し、4096出力トークンの上限とオフにできないthinkingを持ち、画像と一緒にテキストも返せることに留意してください。OpenAIからの純粋な画像出力エンドポイントが必要で、入力コストが軽微な項目である場合は、gpt-image-2を選択してください。
料金
| gemini-3.1-flash-lite-image | GPT Image 2 | Δ | |
|---|---|---|---|
| 入力 / 100 万トークン | $0.25 | $5 | 0.05× |
| 出力 / 100 万トークン | $30 | $30 | = |
ビルド時点の現行カタログの料金です。最新の料金表は各モデルのページに掲載しています。
両モデルの位置:100 万トークンあたりの出力料金(この課金単位の画像生成モデル全 9 件、対数スケール)
仕様
| gemini-3.1-flash-lite-image | GPT Image 2 | |
|---|---|---|
| 入力モダリティ | テキスト 画像 | テキスト 画像 |
| 出力モダリティ | テキスト 画像 | 画像 |
| リリース | 2026-06-30 | 2026-04-21 |
| 知識カットオフ | 2025-01 | - |
| 出力サイズ | 1K only (1:1 = 1024x1024) |
|
| 入力モード | text-to-image, interleaved generation + editing, up to 14 reference images | text-to-image, image edit with mask inpainting |
| リクエストあたりの画像数 | - | 10 |
| フォーマット | - | png, jpeg, webp |
| 備考 | 1K (1024px) output only 10 aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) and up to 14 reference images interleaved generation and editing with fast multi-turn local edits sub-2s end-to-end latency SynthID + C2PA watermarking always on | Flexible resolutions: edges up to 3840px in multiples of 16, ratio <=3:1, ~0.65-8.3MP total (incl. 4K 3840x2160) editing with mask inpainting all image inputs processed at high fidelity significantly improved text rendering (precise placement can still struggle) |
仕様は各ベンダーのドキュメントから転記しています。ベンダーが公表していない項目は、推測で埋めずに省いています。 出典の一覧: gemini-3.1-flash-lite-image · GPT Image 2
1 つのプロンプトを両モデルで実行(ゲートウェイ経由で測定)
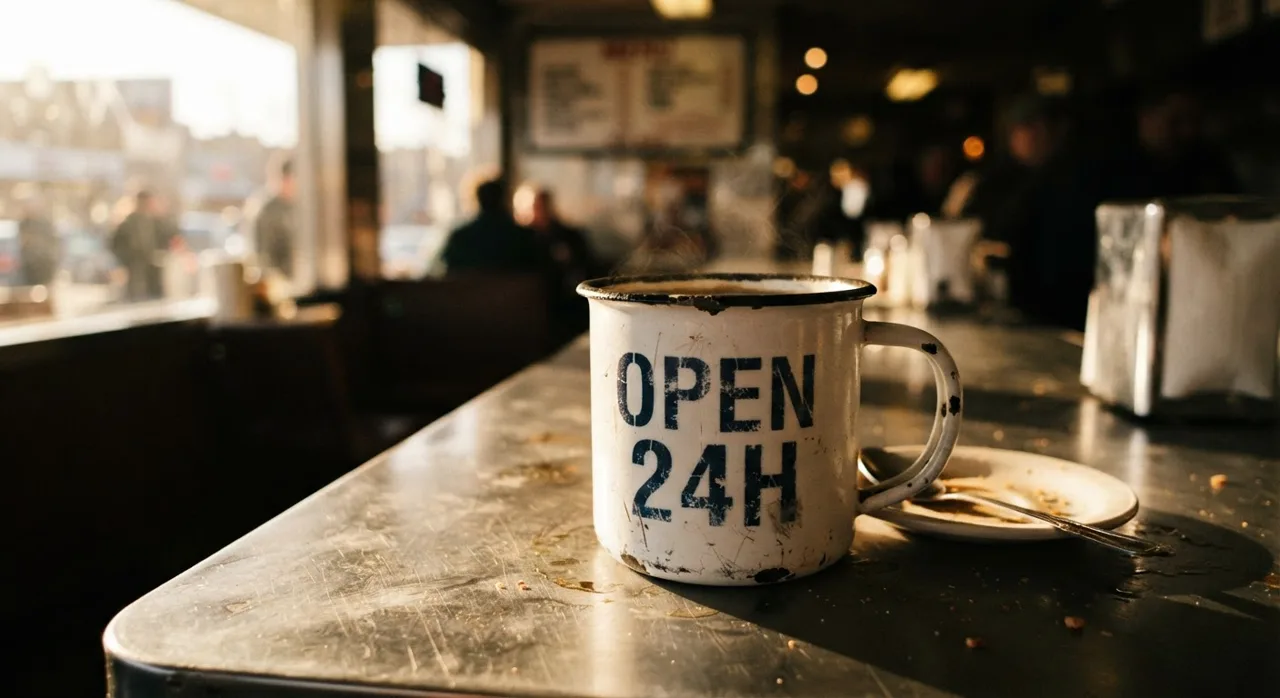
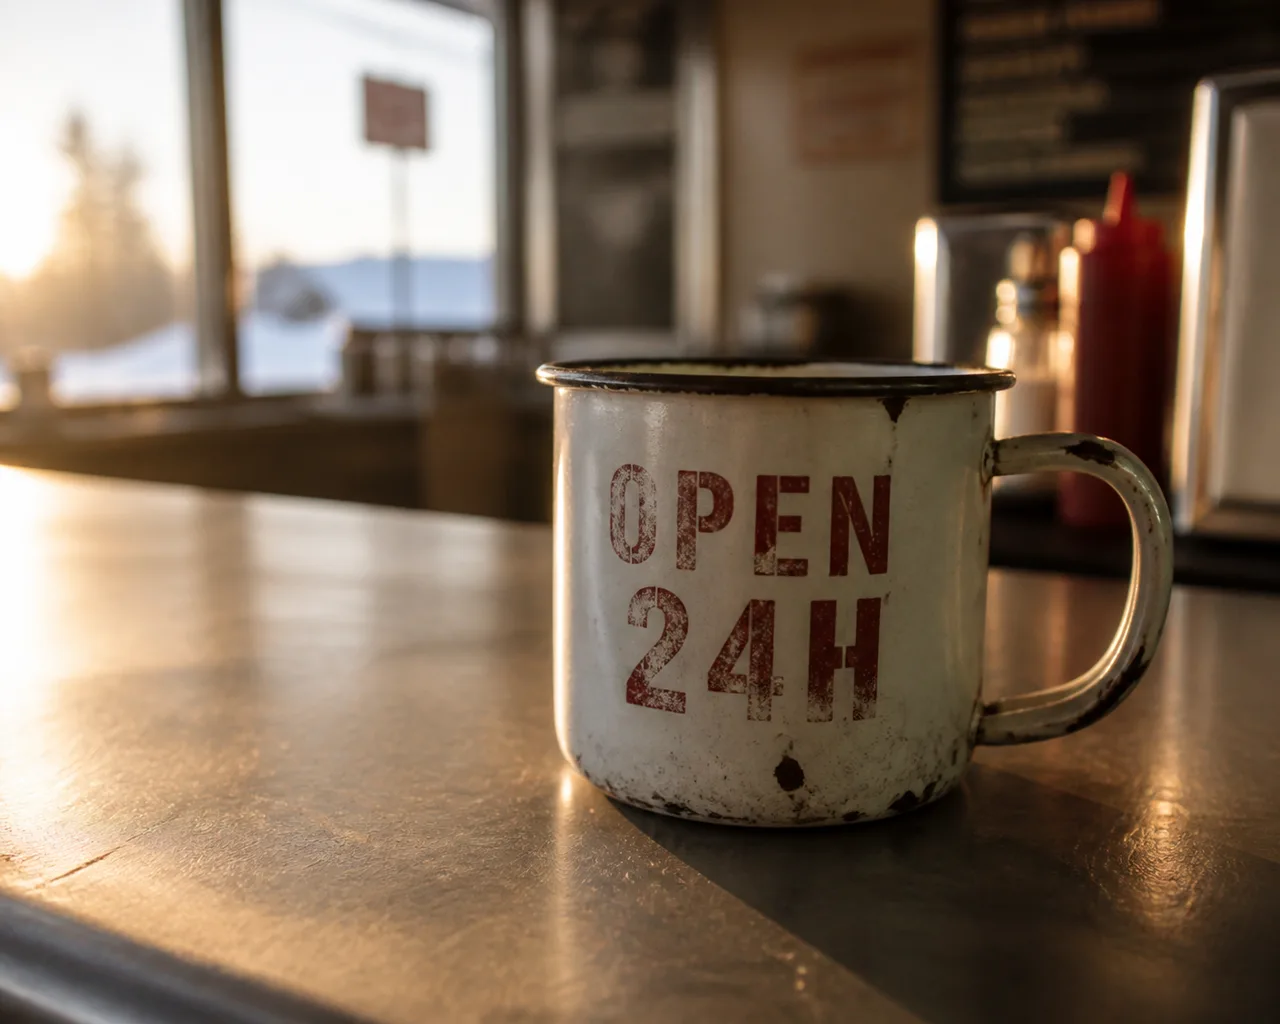
1 つのプロンプトを各モデルに 1 回ずつ送り、最初に返ってきた結果をそのまま掲載しています。再試行も、出来のよいものだけを選ぶこともしていません。サイズと長さは指定せず、各モデルのデフォルトに任せました。すべてのモデルに合わせた条件にすると、どのモデルの持ち味も出なくなるためです。ここに掲載しているファイルは Web 用に再エンコードしているので、圧縮品質ではなく、構図とプロンプトへの忠実さを見てください。
1 行の変更で切り替え
以下のどのタブにも両方のモデル ID が入っています。書き換えるのはハイライトされた 2 行だけで、エンドポイント、キー、リクエスト形式はすべて同じです。
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="gpt-image-2",  # この行のコメントを外し、上の行をコメントアウト
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "gpt-image-2", // この行のコメントを外し、上の行をコメントアウト
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "gpt-image-2", # この行のコメントを外し、上の行をコメントアウト
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "gpt-image-2", // この行のコメントを外し、上の行をコメントアウト
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("gpt-image-2") // この行のコメントを外し、上の行をコメントアウト
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));よくある質問
gemini-3.1-flash-lite-image と GPT Image 2 ではどちらが安いですか?
入力 / 100 万トークンは gemini-3.1-flash-lite-image のほうが安くなります($0.25 対 $5、20 倍の差)。ほかの行では逆になることもあります。料金の全体は上の表に掲載しており、実際のコストは利用の内訳によって変わります。
gemini-3.1-flash-lite-image と GPT Image 2 の A/B テストは、実装を 2 つ用意せずにできますか?
はい。どちらも同じ OpenAI 互換エンドポイントから 1 つの API キーで利用できます。切り替えはモデル名の文字列を 1 行変えるだけなので、トラフィックの一部をそれぞれに振り分けて、請求額を直接比較できます。
画像サイズによって価格は変わりますか?
モデルの課金方式によります。画像単位で課金されるモデルは、プロンプトや出力サイズにかかわらず同じ料金です。トークン単位で課金されるモデルは、生成する解像度に応じて料金が変わるため、4K 画像は小さな画像の数倍のコストになります。各モデルがどちらに当たるかは、上の表で確認できます。