
Beste Flash-LLM-API 2026: GLM günstig, Gemini 3.8 stark
Inhalt
- Wie schneiden die neun Modelle ab und wie haben wir getestet?
- Welche Modelle zählen als Flash und lohnt sich der Wechsel zur neuesten Version?
- Was kosten die neun Modelle?
- Welche Eingaben unterstützen die Modelle und lässt sich Thinking abschalten?
- Was kostet eine ganze Aufgabe statt eines Tokens?
- Welches Flash-Modell solltest du wählen?
- Welche Flash-Modelle scheitern mit der Standardeinstellung?
- Reicht ein Flash-Modell oder brauchst du das größere Modell?
- Was geht mit Flash-Modellen in Produktion schief?
- So setzt Synthorai das um
- FAQ
Welche Flash-LLM-API im September 2026 die beste ist, hängt vom Einsatzzweck ab: GLM 5.3 Flash liefert den höchsten Benchmark-Score pro Dollar. Gemini 3.8 Flash ist der stärkste Allrounder und die richtige Wahl für Audio und Video. Claude Sonnet 5 erfindet am seltensten Antworten, ist aber auch am teuersten. Seed 2.0 Mini ist das günstigste Modell, das alle unsere Tests bestanden hat. Mit Flash-Tier meinen wir das kleine, schnelle Modell eines Anbieters. Wir haben sechzehn Modelle untersucht. Bei jedem Anbieter schlägt das aktuelle Modell seinen kleinen Vorgänger. Die neun aktuellen Modelle vergleichen wir nach Listenpreis, Cache-Kosten, Eingabetypen, Thinking-Steuerung, unabhängigen Benchmarks, Kosten pro Aufgabe und typischen Produktionsproblemen.
TL;DR
- Wechselt bei jedem Anbieter zum aktuellen Modell: Claude Sonnet 5, GPT-5.6 Terra und Gemini 3.8 Flash kosten pro Token mehr als Haiku 4.5, GPT-5.4 mini und Gemini 3.5 Flash-Lite, aber pro korrekter Antwort 2.5- bis 3.9-mal weniger.
- Bestes Preis-Leistungs-Verhältnis: GLM 5.3 Flash mit einem Artificial Analysis Index von 41.9 bei $0.25 pro Aufgabe.
- Stärkstes und bestes multimodales Modell: Gemini 3.8 Flash.
- Wenigste erfundene Antworten: Claude Sonnet 5, bei den höchsten Kosten pro Aufgabe.
- Am günstigsten: Seed 2.0 Mini für $0.10 / $0.40.
Wie schneiden die neun Modelle ab und wie haben wir getestet?
Preise und Funktionen stammen von den Anbieterseiten. Für die Benchmarks nutzen wir unabhängige Leaderboards, die alle Modelle mit demselben Testsystem prüfen. Unser eigener Test ist eine Aufnahmeprüfung, kein Ranking. Herangezogen haben wir den Artificial Analysis (AA) Intelligence Index v4.3 und dessen Non-Hallucination Rate (wie oft ein Modell eine Antwort verweigert, statt zu raten), LiveBench, den Vals Index sowie die Text- und WebDev-Bewertungen von Arena. Unser Test umfasst 11 Aufgaben mit eindeutig prüfbaren Zahlen als Ergebnis, darunter Ziffernzählen, Primzahlsummen, Gitterpfade, Münzwechsel, modulare Potenzen und ein Rucksackproblem. Jede Aufgabe lief dreimal. Hinzu kamen fünf Fragen zu einem Unternehmen, einem Institut, einer Stadt, einer Legierung und einem Preis, die nicht existieren. Die Antworten haben wir vollständig gelesen und geprüft, ob das Modell ablehnt oder etwas erfindet. Thinking bezeichnet die Reasoning-Token, die ein Modell vor seiner Antwort erzeugt. Sie werden als Output abgerechnet und pro Request über ein Feld wie reasoning_effort gesteuert. Jedes Modell lief mit seiner Standardeinstellung und mit allen unterstützten Thinking-Stufen.
| Modell | AA Index | AA Non-Hallucination | LiveBench | Vals Index | Arena Text / WebDev | Unser Test: Standard / Bestwert | Standardmäßig erfunden |
|---|---|---|---|---|---|---|---|
| GPT-5.6 Terra | 42.3 bei max | 12.1 | 77.9 | 59.6 | 1466 / 1521 | 31 / 33 | 2 von 5 |
| GLM 5.3 Flash | 41.9 | 72.4 | 71.6 | 47.2 | 1475 / 1607 | 31 / 31 | 0 von 5 |
| Gemini 3.8 Flash | 41.2 bei high | 44.8 | 75.8 | 62.3 | 1493 / 1568 | 32 / 33 | 0 von 5 |
| Qwen3.8 Flash | 39.9 | 54.7 | 76.2 | nicht gelistet | nicht gelistet / 1635 | 33 / 33 | 2 von 5 |
| DeepSeek V4.1 Flash | 39.5 bei max | 3.5 | 81.1 | 57.9 | nicht gelistet / 1614 | 33 / 33 | 4 von 5 |
| Claude Sonnet 5 | 38.4 bei max | 60.6 | 76.0 | 59.6 | 1461 / 1537 | 33 / 33 | 0 von 5 |
| GPT-5.6 Luna | 37.5 bei max | 7.4 | 73.6 | 59.9 | 1453 / 1519 | 31 / 32 | 4 von 5 |
| Hy3 | 25.8 | 25.9 | nicht gelistet | nicht gelistet | 1456 / 1513 | 33 / 33 | 0 von 5 |
| Seed 2.0 Mini | nicht gelistet | nicht gelistet | nicht gelistet | nicht gelistet | nicht gelistet | 33 / 33 | 0 von 5 |
Quellen, abgerufen am 2026-09-17: Artificial Analysis, LiveBench, Vals Index, Arena Text und Arena WebDev. Arena verwendet Elo-ähnliche Bewertungen, bei denen 20 Punkte Abstand wenig sind. Qwen3.8 Flash wird dort als Qwen3.8-Flash-Next geführt, dem Open-Weight-Modell hinter der API. Die Messungen liefen am 2026-09-16 und 17. Zwei Modelle haben wir am zweiten Tag erneut getestet, um die Vergleichbarkeit beider Tage zu bestätigen.
Kein Modell führt in allen Benchmarks: Terra liegt beim Index vorn, DeepSeek bei LiveBench, Gemini 3.8 Flash beim Vals Index und Arena Text, Qwen3.8 Flash bei Arena WebDev. Die AA Non-Hallucination Rate und unsere fünf Fragen zu erfundenen Sachverhalten zeigen dasselbe Muster: DeepSeek V4.1 Flash, Luna und Terra lehnen nur selten ab. GLM 5.3 Flash und Sonnet 5 tun es meist. Für Seed 2.0 Mini gibt es keinen unabhängigen Score. Unser Test ist daher der einzige Beleg für seine Leistung.
Welche Modelle zählen als Flash und lohnt sich der Wechsel zur neuesten Version?
Die jeweils neuesten kleinen Modelle aller Anbieter zählen dazu, und der Wechsel lohnt sich. Google, DeepSeek, Alibaba, Z.ai, ByteDance und Tencent nennen ihre Modelle Flash, Mini oder bieten nur ein einzelnes günstiges Modell an. Anthropics aktuelle Generation besteht aus Fable, Opus und Sonnet. Haiku 4.5 stammt noch aus der vorherigen Generation (Oktober 2025, Einstellung frühestens am 15. Oktober 2026). Deshalb behandeln wir Claude Sonnet 5 als Claudes Flash-Tier. In der OpenAI-Dokumentation entspricht GPT-5.6 Terra dem früheren Mini-Tier und GPT-5.6 Luna dem Nano-Tier. Sonnet 5 ($2 / $10) und Terra ($2 / $12) kosten pro Token ein Mehrfaches der übrigen sieben Modelle. Deshalb bilden sie unten eine eigene Preisklasse.
Von vier Anbietern haben wir auch das vorherige kleine Modell untersucht. Bewertet wurde anhand der Kosten pro korrekter Antwort: Alle Ausgaben für die 33 Durchläufe geteilt durch die Zahl der richtigen Antworten. Ein Modell mit 50% Trefferquote zahlt damit pro Antwort doppelt. In jedem direkten Vergleich gewann das aktuelle Modell. Bei den drei Modellpaaren aus dem TL;DR war der Token-Preis höher, die korrekte Antwort aber günstiger:
- Claude Sonnet 5 statt Claude Haiku 4.5. Haiku erreichte 32 von 33 erst mit maximalem Thinking. Sonnet 5 kam mit jeder aktivierten Thinking-Stufe auf 33 von 33 und kostete bei
max, seiner günstigsten Einstellung, pro korrekter Antwort 2.9-mal weniger. Beide lehnten alle fünf Fragen zu erfundenen Sachverhalten ab. - GPT-5.6 Terra statt GPT-5.4 mini. Mini erreichte standardmäßig 9 von 33 und brauchte
highfür 33. Terra kam mitlowauf 33 und war dabei 2.5-mal günstiger. Terra erfand zwei Antworten, während Mini alle fünf Fragen ablehnte. - Gemini 3.8 Flash statt Gemini 3.5 Flash-Lite und Gemini 3.7 Flash. Im Vergleich zu Flash-Lite lagen die Kosten pro korrekter Antwort 3.9-mal niedriger. Außerdem lehnte 3.8 die drei erfundenen Fragen ab, die Flash-Lite beantwortete. Flash-Lite bleibt nur für einstufige Extraktion sinnvoll. Gegenüber 3.7 Flash ist der Listenpreis gleich, ein Aufruf kostet mit 3.8 aber etwa 10% mehr. Dieses Upgrade bringt also mehr Leistung, keine Einsparung.
- GPT-5.6 Luna statt GPT-5.4 nano bei etwa einem Drittel der Kosten pro korrekter Antwort und denselben 31 von 33 Punkten. Außerdem Qwen3.8 Flash statt Qwen3.6 Flash und Qwen3.5 Flash. Die Vorgänger denken etwa zehnmal so viel und kosten pro korrekter Antwort 6- bis 27-mal mehr.
Im weiteren Artikel geht es nur noch um die neun aktuellen Modelle.
Was kosten die neun Modelle?
Gemessen am Listenpreis für Output gibt es drei Preisklassen. Der Balken zeigt unsere gemessenen Kosten pro korrekter Antwort mit der jeweils besten Einstellung. So werden ein günstiger Listenpreis und übermäßiges Thinking gemeinsam sichtbar. Die Beschriftung enthält Listenpreis und Cache-Read-Preis, also die Kosten eines wiederholten Prompt-Präfixes als Anteil des Input-Preises.
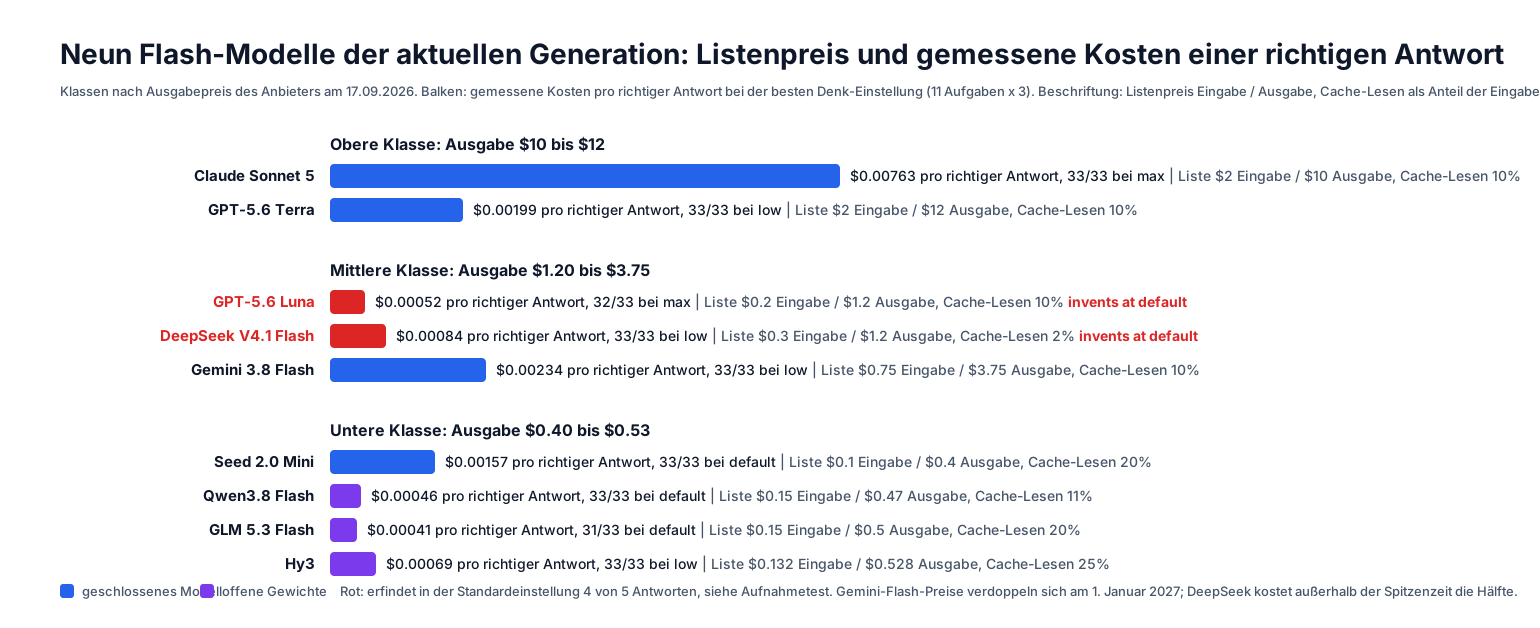
Die Preisklasse sagt wenig über die tatsächliche Rechnung aus. GPT-5.6 Terra gehört zur teuersten Klasse, kostete pro korrekter Antwort aber weniger als Gemini 3.8 Flash und nur etwa ein Viertel mehr als Seed 2.0 Mini. Der Thinking-Verbrauch beeinflusst die Kosten ebenso stark wie der Listenpreis. Preise ändern sich außerdem häufig und hängen von Zeit und Region ab: Googles Preise für 3.x Flash verdoppeln sich am 1. Januar 2027 (Gemini 3.8 Flash dann $1.50 / $7.50). DeepSeek berechnet an Werktagen außerhalb von 01:00 bis 04:00 und 06:00 bis 10:00 UTC nur die Hälfte. OpenAI senkte den Preis von GPT-5.6 Luna im Juli um 80%. Qwen3.8 Flash kostet außerhalb von Alibabas Region Singapur 19 bis 25% weniger. Drei aktuelle kleine Modelle waren an den Testtagen bei Synthorai nicht verfügbar und wurden deshalb nicht gemessen: Mistral Small 4 ($0.15 / $0.60), StepFun Step 3.7 Flash ($0.20 / $1.15) und Amazon Nova 2 Lite ($0.30 / $2.50).
Welche Eingaben unterstützen die Modelle und lässt sich Thinking abschalten?
Acht der neun Modelle akzeptieren Bilder, vier Video und zwei Audio. Hy3, Tencents Hunyuan 3, verarbeitet nur Text. Die letzte Spalte zeigt, ob die JSON-Extraktion mit einem strikten Schema in 8 Durchläufen einer Rechnungsextraktion korrekte Werte lieferte.
| Modell | Eingabe | Kontext / max. Output | Open Weights | Thinking abschaltbar | Thinking-Standard | Schema-JSON |
|---|---|---|---|---|---|---|
| Claude Sonnet 5 | Text, Bild | 1M / 128K | nein | ja | adaptiv, high | 8/8 per Tool Call |
| GPT-5.6 Terra | Text, Bild | 1.05M / 128K | nein | ja | medium | 8/8 |
| Gemini 3.8 Flash | Text, Bild, Audio, Video, PDF | 1M / 64K | nein | nein | medium | 8/8 |
| GPT-5.6 Luna | Text, Bild | 1.05M / 128K | nein | ja | medium | 8/8 |
| DeepSeek V4.1 Flash | Text, Bild | 1M / 384K | MIT | ja | high | nur json_object, 8/8 |
| Seed 2.0 Mini | Text, Bild, Audio, Video | 256K / 128K | nein | ja | medium | 8/8 |
| Qwen3.8 Flash | Text, Bild, Video | 1M / 128K | Qwen-Lizenz | ja | xhigh | 3/8, falsche Integer |
| GLM 5.3 Flash | Text, Bild, Video, Datei | 1M / 128K | MIT | nein | max | nur json_object, 8/8 |
| Hy3 | Text | 256K / 128K | Apache 2.0 | ja | high | nur json_object, 7/8 |
“Per Tool Call” bedeutet, dass das Schema als Tool-Input übergeben und Claude zum Aufruf gezwungen wurde. “Nur json_object” heißt, dass auf unserem Request-Pfad kein korrektes Ergebnis mit einem strikten Schema zurückkam. Mit {"type": "json_object"} und den im Prompt genannten Schlüsseln funktionierte es. Für Audio-Input kommen Gemini 3.8 Flash oder Seed 2.0 Mini infrage. Mehr als 128K Output bietet DeepSeek V4.1 Flash. Selbst hostbare Weights gibt es bei DeepSeek, GLM, Hy3 und Qwen3.8 Flash.
Was kostet eine ganze Aufgabe statt eines Tokens?
Die Kosten eines Aufrufs ergeben sich aus Preis und Token-Menge, die das Modell selbst verbraucht. In diesem Tier schwankt der zweite Faktor stärker als der erste. Der fairste öffentliche Vergleichswert ist der von Artificial Analysis gemessene Preis für eine Aufgabe im Index. Thinking-Token sind darin enthalten. Für acht der neun Modelle liegt dieser Wert vor.
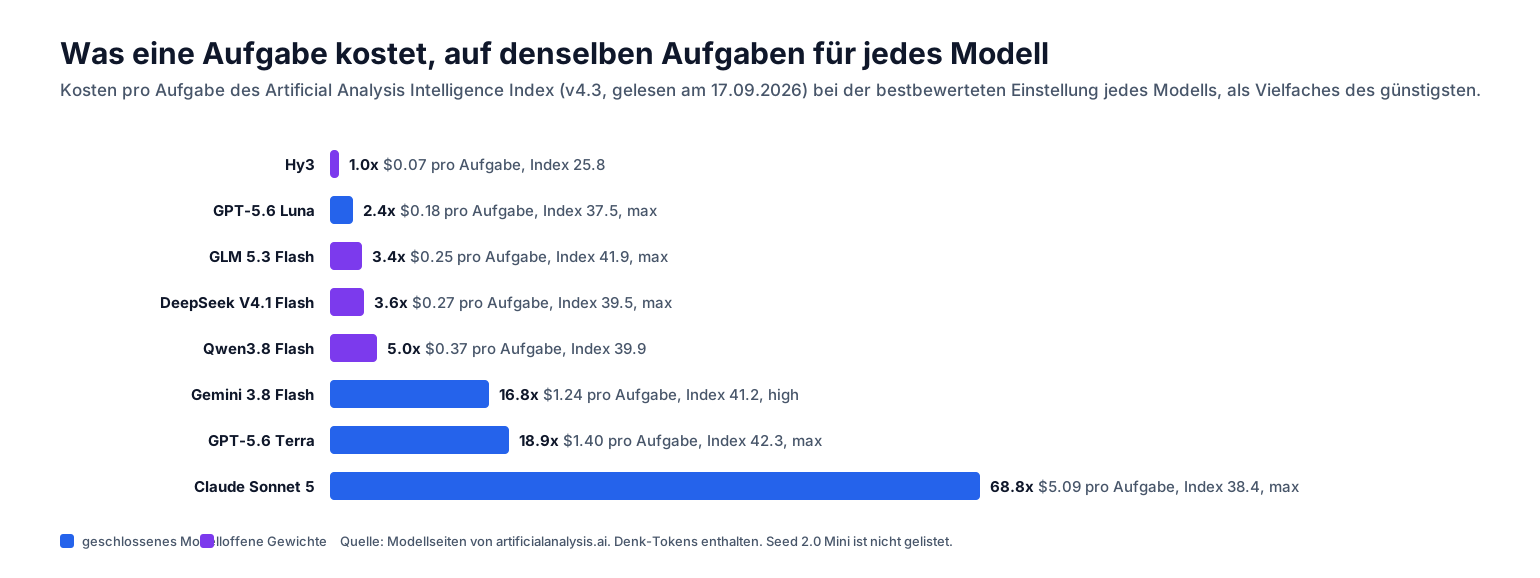
GLM 5.3 Flash liegt beim Score weniger als einen halben Punkt hinter GPT-5.6 Terra, kostet pro Aufgabe aber nur ein Fünftel. Qwen3.8 Flash hat fast denselben Listenpreis wie GLM, kostet pro Aufgabe jedoch noch einmal die Hälfte mehr. Für den Index erzeugte Qwen 240 Millionen Output-Token, GLM nur 180 Millionen. Claude Sonnet 5 kostet mit max $5.09 pro Aufgabe, gegenüber $1.79 mit der Standardeinstellung high. Dafür steigt der Index um sechs Punkte. Unsere Einzelaufrufe zeigen denselben Effekt: Seed 2.0 Mini hat einen niedrigeren Listenpreis als Qwen3.8 Flash, kostete pro korrekter Antwort aber 3.4-mal mehr. Seed dachte pro Aufgabe im Median 2,810 Token, Qwen nur 530.
Cache Reads kosten bei DeepSeek 2% des Input-Preises, bei Google, OpenAI, Anthropic und Alibaba etwa 10%, bei Z.ai und ByteDance 20% und bei Tencent 25%. Bei Agent- und RAG-Traffic (Retrieval-Augmented Generation, bei dem abgerufene Dokumente in jeden Prompt eingefügt werden) bestimmt der Read-Preis die Rechnung: Ein gecachtes Präfix mit 100K Token kostet bei DeepSeek V4.1 Flash $0.0006 pro Aufruf, bei Sonnet 5 oder Terra dagegen $0.02. OpenRouter berichtete, dass 90% der von V4.1 Flash an einem Tag nach dem Launch ausgelieferten Token Cache Reads waren (Beitrag). Batch-Tiers liefern Antworten innerhalb weniger Stunden und halbieren die Preise von Gemini 3.8 Flash, GPT-5.6 Luna, Terra und Sonnet 5. Qwen3.8 Flash, GLM 5.3 Flash und Hy3 bieten keine Batch-Tiers.
Welches Flash-Modell solltest du wählen?
GLM 5.3 Flash für das Preis-Leistungs-Verhältnis, Gemini 3.8 Flash für Leistung und multimodale Eingaben, Claude Sonnet 5 für möglichst wenige erfundene Antworten, Seed 2.0 Mini für den niedrigsten Preis.
| Anforderung | Empfehlung | Begründung |
|---|---|---|
| Bestes Preis-Leistungs-Verhältnis | GLM 5.3 Flash | Index 41.9, nur Terra liegt höher, bei $0.25 pro Aufgabe; höchste Non-Hallucination Rate der neun Modelle (72.4); $0.15 / $0.50; Bild-, Video- und Datei-Input; MIT-Weights |
| Stärkster Allrounder | Gemini 3.8 Flash | führt unter den neun Modellen beim Vals Index und Arena Text, liegt im Index 1.1 Punkte hinter Terra und kostet pro Aufgabe 11% weniger; 33 von 33 mit low, alle erfundenen Fragen abgelehnt |
| Beste Multimodalität | Gemini 3.8 Flash | Audio-, Video- und PDF-Input, Audio kostet so viel wie Text; Schema-JSON 8 von 8 |
| Wenigste erfundene Antworten, schnell | Claude Sonnet 5 | 33 von 33 mit jeder aktivierten Thinking-Stufe, alle fünf erfundenen Fragen mit und ohne Thinking abgelehnt, erstes Antwort-Token nach 2.2 Sekunden; pro Aufgabe am teuersten, daher für Fälle einsetzen, in denen eine erfundene Antwort mehr kostet als der Aufruf |
| Am günstigsten | Seed 2.0 Mini | $0.10 / $0.40; standardmäßig 33 von 33, Schema-JSON 8 von 8, alle fünf erfundenen Fragen abgelehnt, Audio- und Video-Input |
Drei Modelle erhalten aus jeweils einem Grund keine Empfehlung. GPT-5.6 Terra hat den höchsten Index und erreicht mit low 33 von 33 für $0.00199 pro korrekter Antwort, erfand aber zwei von fünf Antworten bei $12 pro Million Output-Token. DeepSeek V4.1 Flash führt LiveBench an und hat den günstigsten Cache, verarbeitet aber nur Text und Bilder und erfand bei aktiviertem Thinking vier von fünf Antworten. Qwen3.8 Flash erzielte in unserem Test das günstigste perfekte Ergebnis mit $0.00046 pro korrekter Antwort und führt Arena WebDev an. Es erfand jedoch zwei Antworten, schrieb unter einem strikten Schema falsche Integer und brauchte für eine 400 Wörter lange Erklärung fast drei Minuten.
Statt ein Modell für alles einzusetzen, sollte das Routing vom Request abhängen: Geschlossene Aufgaben mit prüfbarem Ergebnis gehen an das günstigste Modell, das sie besteht (GLM 5.3 Flash, Qwen3.8 Flash, Hy3). Offene Faktenfragen gehen an ein Modell, das bei Unsicherheit ablehnt (GLM 5.3 Flash, Sonnet 5, Gemini 3.8 Flash). Lange Agent-Läufe gehören auf das stärkste Modell, das ins Budget passt.
Welche Flash-Modelle scheitern mit der Standardeinstellung?
Zwei der neun Modelle. Beide bestehen, sobald offene Fragen an eine Einstellung weitergeleitet werden, die Antworten ablehnt. Die Mindestanforderung gilt für die Werkseinstellung eines Modells: mindestens 30 von 33 Aufgaben und höchstens zwei erfundene Antworten von fünf.
| Modell | Mit Standardeinstellung | Änderung | Nach der Änderung |
|---|---|---|---|
| DeepSeek V4.1 Flash | erfand 4 von 5 Antworten (“50 Mitarbeiter”, “1790 °C”, eine Simpsons-Figur als Preisträger) | Thinking bei offenen Fragen ausschalten | lehnte 5 von 5 ab, erreichte bei den Aufgaben aber nur 21 von 33, daher nur offene Fragen dorthin routen |
| GPT-5.6 Luna | erfand 4 von 5 Antworten (“ungefähr 20 Mitarbeiter”, “1974”, “1,400 °C”) | Thinking bei offenen Fragen ausschalten | lehnte 4 von 5 ab, erreichte bei den Aufgaben aber nur 7 von 33, daher gilt dasselbe Routing |
GPT-5.6 Terra und Qwen3.8 Flash liegen mit jeweils zwei erfundenen Antworten genau auf der Grenze (“0 Mitarbeiter” und “etwa 1,455 °C” bei Terra). Behandelt sie bei offenen Fragen daher genauso.
Reicht ein Flash-Modell oder brauchst du das größere Modell?
Für klar abgegrenzte Aufgaben reicht es. In den kürzeren Agent-Benchmarks, bei denen das Modell in einer Shell an echten Repositories arbeitet, schlägt DeepSeek V4.1 Flash DeepSeek V4 Pro sowohl bei Terminal-Bench 2.1 (90.6 gegenüber 87.9) als auch bei DeepSWE (74.2 gegenüber 62.7). Gemini 3.8 Flash erreicht bei Terminal-Bench 2.1 einen Wert von 89.4, Claude Opus 5 kommt auf 89.1. Alle neun Modelle haben unsere Tool-Calling-Schleife über zwei Turns dreimal erfolgreich abgeschlossen.
Bei langen Aufgaben und großen Kontexten öffnet sich die Lücke wieder. Googles eigene Tabelle für Terminal-Bench 4.0 weist Gemini 3.8 Flash mit 19.1 und Opus 5 mit 51.8 aus. In OpenAIs Multi-Needle-Retrieval-Test zwischen 512K und 1M Token erreicht GPT-5.6 Luna 41.3, GPT-5.6 Terra dagegen 72.5. Ein Kontextfenster von 1M bedeutet bei den kleinsten Modellen also nicht, dass sie sich zuverlässig an 1M Token erinnern. Nutzt Flash-Modelle für Extraktion, Klassifizierung, kurze Tool-Schritte und Codeänderungen mit bekanntem Muster. Planung für lange Agent-Läufe und Fragen zu sehr langen Dokumenten gehören auf ein größeres Modell.
Was geht mit Flash-Modellen in Produktion schief?
Meist liegen die Probleme an Defaults und Request-Formaten, nicht an den Fähigkeiten des Modells.
- Bei zwei Modellen lässt sich Thinking nicht abschalten. Gemini 3.8 Flash und GLM 5.3 Flash antworteten bei jeder von uns getesteten Off-Einstellung mit einem 400-Fehler.
- Die Defaults liegen an beiden Extremen. GLM 5.3 Flash verwendet standardmäßig
max, Qwen3.8 Flashxhigh(Alibaba). Bei unseren fünf erfundenen Fragen verbrauchte Qwen3.8 Flash im Median 11,680 Reasoning-Token. Google zählt Thinking gegenmax_output_tokens. Ein knappes Limit kann deshalb zu einer abgeschnittenen oder leeren Antwort führen, die trotzdem berechnet wird (Thinking-Anleitung). - Claude verwendet eigene Parameter. Claude Sonnet 5 steuert die Thinking-Tiefe über
output_config.effortund lehnt das älterebudget_tokensab (Effort).reasoning_effortgehört nicht zu seinen Parametern. - Tool-Schleifen müssen Reasoning zurücksenden. DeepSeeks Thinking-Modus erwartet bei Folgeturns das vorherige
reasoning_content(Thinking-Modus). Gemini hängt Thought Signatures an Function-Call-Parts. Frameworks, die den Message-Verlauf neu aufbauen, verlieren beides. - Striktes JSON funktioniert nicht überall gleich. Qwen3.8 Flash hielt die Typen des Schemas ein, schrieb aber in 5 von 8 Durchläufen falsche Integer (
-561994als Positionen). Verwendet bei Qwen, GLM, Hy3 und DeepSeekjson_objectund nennt die Schlüssel im Prompt. Bei Claude funktioniert ein Tool Call. - Thinking beeinflusst, ob ein Modell etwas erfindet. DeepSeek V4.1 Flash erfand bei aktiviertem Thinking vier von fünf Antworten, bei deaktiviertem Thinking keine.
- Modell-IDs ändern ihre Bedeutung.
deepseek-v4-flashliefert seit dem 10. September V4.1 Flash aus (Preise). Claude Haiku 4.5 kann ab dem 15. Oktober eingestellt werden (Deprecations). Pinnt einen datierten Snapshot, sofern verfügbar, etwaseed-2-0-mini-260428. - Drittanbieter-Hosts für Open Weights unterscheiden sich. DeepSeek, GLM, Qwen und Hy3 werden von vielen Providern mit unterschiedlicher Quantisierung und unterschiedlichem Cache-Verhalten angeboten. Im September wurde bei einem Reseller entdeckt, dass bezahlte Requests an ein günstigeres Modell weitergeleitet wurden (Hacker News). Vergleicht die Antworten eures Providers mit der API des jeweiligen Anbieters.
Die Geschwindigkeit hängt stärker von der Standard-Thinkingeinstellung ab als von der Modellgröße. Gemessen wurde eine gestreamte Erklärung mit 400 Wörtern, jeweils drei Durchläufe mit der Standardeinstellung am 2026-09-17:
| Modell, Standardeinstellung | Erstes Antwort-Token | Gesamtdauer | Output-Token pro Sekunde |
|---|---|---|---|
| Claude Sonnet 5 | 2.2 s | 10.5 s | 70 |
| Gemini 3.8 Flash | 10.7 s | 14.3 s | 114 |
| GPT-5.6 Luna | 24.9 s | 26.1 s | 89 |
| GPT-5.6 Terra | 33.3 s | 34.2 s | 63 |
| GLM 5.3 Flash | 36.7 s | 39.3 s | 128 |
| DeepSeek V4.1 Flash | 40.4 s | 40.6 s | 158 |
| Seed 2.0 Mini | 61.3 s | 61.5 s | 81 |
| Hy3 | 123.0 s | 134.5 s | 35 |
| Qwen3.8 Flash | 159.9 s | 165.8 s | 72 |
Die Token pro Sekunde umfassen Reasoning und Antwort über den gesamten Aufruf. Sonnet 5 verbrauchte mit seinem adaptiven Thinking für die Schreibaufgabe keine Thinking-Token und begann sofort mit der Antwort. Qwen3.8 Flash verbrauchte dafür im Median 10,697 Reasoning-Token. Ein offener Prompt kann bei einem Modell, das geschlossene Aufgaben günstig löst, deshalb mehrere Minuten dauern.
Bei einem OpenAI-kompatiblen Request wird die Einstellung über ein einzelnes Feld gesetzt. Der Thinking-Verbrauch steht anschließend in usage:
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key="sk-syn-...")
r = client.chat.completions.create(
    model="gemini-3.8-flash",          # or glm-5.3-flash, gpt-5.6-terra, ...
    reasoning_effort="low",
    max_tokens=32768,
    messages=[{"role": "user", "content": "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer."}],
)
u = r.usage
print(r.choices[0].message.content, u.completion_tokens, u.completion_tokens_details.reasoning_tokens)
Für Claude Sonnet 5 wird derselbe Request an die Messages API gesendet, ergänzt um output_config: {"effort": "low"}.
So setzt Synthorai das um
Alle oben genannten Modelle sind über dieselbe API erreichbar, jeweils mit einer eigenen model-ID und wahlweise OpenAI- oder Anthropic-kompatibel. Auf der Seite zum Modellvergleich lassen sich zwei Modelle direkt nach Preis, Cache, Eingabetypen, Kontext und Anbieter-Benchmarks vergleichen. Die aktuellen Preise aller neun Modelle stehen im Preisvergleich für Modelle.
FAQ
Ist Claude Sonnet 5 ein Flash-Modell? Anthropic selbst bezeichnet es nicht so. Es ist aber das kleinste Modell der aktuellen Claude-Generation, denn Claude Haiku 4.5 stammt vom Oktober 2025 und kann ab dem 15. Oktober 2026 eingestellt werden. Claude Sonnet 5 kostet $2 / $10 gegenüber $1 / $5 bei Haiku, war in unserem Test pro korrekter Antwort aber 2.9-mal günstiger.
Ist die Gemini Flash API kostenlos? Für Gemini 3.8 Flash gibt es in Google AI Studio ein kostenloses Tier. Google verwendet Inhalte aus diesem Tier jedoch zur Verbesserung seiner Produkte (Preise). Für Apps, die Nutzer im EWR, in der Schweiz oder im Vereinigten Königreich bedienen, ist nur der kostenpflichtige Dienst erlaubt (Bedingungen). Das kostenpflichtige Tier kostet bis zum 31. Dezember 2026 $0.75 / $3.75, danach $1.50 / $7.50.
Sollte ich Gemini Flash oder Flash-Lite verwenden? Gemini 3.8 Flash, außer jeder Request ist eine einstufige Extraktion. Im Artificial Analysis Index erreicht es 41.2 gegenüber 23 bei Gemini 3.5 Flash-Lite. In unserem Test kostete es pro korrekter Antwort 3.9-mal weniger und lehnte alle fünf erfundenen Fragen ab, von denen Flash-Lite drei beantwortete. Flash-Lite kostet $0.30 / $2.50 und antwortet in etwa 4 Sekunden.
GPT-5.6 Luna oder GPT-5.6 Terra?
GPT-5.6 Luna für hohes Volumen, GPT-5.6 Terra für anspruchsvolleres Reasoning. Luna kostet $0.20 / $1.20 und erreichte standardmäßig 31 von 33 für $0.00030 pro korrekter Antwort. Terra kostet $2 / $12, erreichte mit low 33 von 33 für $0.00199 und hat den höchsten Index-Score der neun Modelle. Beide erfanden mit der Standardeinstellung Antworten, Luna vier von fünf und Terra zwei.
Welches Flash-Modell eignet sich am besten zum Programmieren? Qwen3.8 Flash, DeepSeek V4.1 Flash und GLM 5.3 Flash führen Arena WebDev an (1635, 1614 und 1607). DeepSeek liegt in der Kategorie Agentic Coding von LiveBench vorn (77.3). Bei Vals Vibe Code Bench führen DeepSeek und Claude Sonnet 5 (84.7 und 81.3).
Mehr dazu: API-Kosten von DeepSeek V4.1 Flash, API-Kosten von GLM 5.3, API-Kosten von Gemini 3.7 Flash, Prompt Caching im Provider-Vergleich, das beste LLM nach Anwendungsfall.