
DeepSeek V4.1 Flash: V4 Pro-Niveau bei 3-6x weniger Kosten
Inhalt
- Was änderte sich am 10. September, und was kostet V4.1 Flash?
- Erreicht V4.1 Flash wirklich V4 Pro und schlägt V4 Flash?
- Was bewirkt die Effort-Einstellung, und lässt sich Thinking abschalten?
- Was passiert bei Fragen nach Dingen, die nicht existieren?
- Ist die JSON-Beschädigung von V4 Flash behoben?
- Was kostet ein Bild mit V4.1 Flash?
- So bindet Synthorai das Modell an
- FAQ
DeepSeek V4.1 Flash kostet zu Spitzenzeiten $0.30 pro Million Input-Token und $1.20 pro Million Output-Token, außerhalb der Spitzenzeiten jeweils die Hälfte. Bei 11 Aufgaben mit überprüfbarer Antwort, die wir jeweils dreimal ausführten, waren 33 von 33 Antworten richtig. Damit erreicht das Modell denselben Wert wie V4 Pro, kostet pro korrekter Antwort aber 3-6x weniger und erzeugt Output 2.9x schneller. Gegenüber dem abgelösten V4 Flash sinken die Kosten pro korrekter Antwort um 26%, die Geschwindigkeit steigt um den Faktor 1.5, und erstmals kann ein Flash-Modell Bilder verarbeiten. Zwei Verhaltensweisen muss man bei der Integration berücksichtigen: Ohne Thinking beantwortet es mehrstufige Rechenaufgaben mit einem einzigen falschen Token. Mit Thinking verbraucht es bei Fragen nach nicht existierenden Dingen das gesamte Ausgabefenster, in drei von fünf Durchläufen 16,384 Token. Wir haben deepseek-v4.1-flash und deepseek-v4-pro-0813 vier Tage nach dem Release in einem Batch getestet, zur selben Stunde über dasselbe Gateway. deepseek-v4-flash-0731 folgte am selben Abend.
TL;DR
- V4.1 Flash kostet zu Spitzenzeiten $0.30/$1.20 pro Million Token, außerhalb davon die Hälfte. V4 Pro kostet $1.32/$3.96.
- Mit aktiviertem Thinking erreichten alle drei Builds 33 von 33 Punkten. V4.1 Flash kostete pro korrekter Antwort $0.00097 bis $0.00149, damit 3-6x weniger als V4 Pro und 26% weniger als V4 Flash.
- Ohne Thinking fallen alle drei auf 21 von 33 Punkten. V4.1 Flash antwortet dann mit einem einzigen falschen Token.
- Bei fünf erfundenen Entitäten erreichte V4.1 Flash mit Thinking dreimal das Limit von 16,384 Token und erfand zweimal eine Antwort. Ohne Thinking lehnte es alle fünf Fragen ab.
Was änderte sich am 10. September, und was kostet V4.1 Flash?
Neue Architektur, neuer Preis und ein eingestelltes Modell. V4.1 Flash ist laut DeepSeek “das kleinste Modell unserer neuen Architekturfamilie”: 552B Parameter in einem kausalen Encoder-Decoder. Ein Stack mit 20 Layern liest den Prompt, ein weiterer erzeugt die Antwort. Pro Input-Token sind 8B Parameter aktiv, pro Output-Token 16B. Dazu kommen native Bildverarbeitung, ein Kontextfenster mit 1M Token, ein Ausgabelimit von 384K und eine MIT-Lizenz. Laut DeepSeeks Preisseite kostet das Modell zu Spitzenzeiten $0.30 pro Million Input-Token und $1.20 pro Million Output-Token. Diese gelten montags bis freitags von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC. Außerhalb dieser Zeiten kostet es $0.15 und $0.60, Cache-Treffer liegen bei $0.006 und $0.003. Der Preis liegt zwischen den beiden Tarifen des bisherigen V4 Flash: pauschal $0.14/$0.28 zum Start im Juli und $0.44/$1.32 zu Spitzenzeiten ab 2026-08-16. V4 Pro ist mit $1.32/$3.96 zu Spitzenzeiten deutlich teurer.
V4 Flash und der Vision-Exp-Build wurden eingestellt. Anfragen an ihre Namen werden zum Flash-Preis an V4.1 Flash weitergeleitet. DeepSeek wollte ab dem 14. September auch den Traffic von V4 Pro auf V4.1 Flash umleiten. Noch am selben Tag wurde dieser Plan laut Änderungsprotokoll “auf Wunsch der Nutzer” verworfen. Pro bleibt daher zum Pro-Preis verfügbar.
Technisch hat sich weniger geändert als beim Preis. Alle drei Builds verwenden denselben Tokenizer und erzeugen für dieselben englischen, chinesischen und Python-Korpora 729, 452 und 528 Token. Bestehende Token-Budgets lassen sich daher übernehmen. Cache-Seiten wurden von 1,024 auf 512 Token halbiert, sodass bei einem Prompt mit 549 Token nun 512 Token im Cache landen. Ein Prompt mit 902K Token und einem darin platzierten Wert gab diesen korrekt zurück. Bei einem Prompt jenseits des 1M-Fensters kam ein 400-Fehler statt einer stillen Kürzung.
DeepSeeks eigene Zahlen aus der Model Card zeigen den neuen Flash-Build durchgehend vor dem alten. Bei Agenten- und Coding-Aufgaben liegt er auch vor Pro, bei Wissensaufgaben dagegen nicht:
| Benchmark | Getesteter Bereich | V4 Flash | V4.1 Flash | V4 Pro |
|---|---|---|---|---|
| GPQA Diamond | naturwissenschaftliche Fragen auf Hochschulniveau | 89.9 | 90.9 | 92.4 |
| HLE | schwierige fachübergreifende Fragen | 37.8 | 36.8 | 42.7 |
| Codeforces | Rating im kompetitiven Programmieren | 3289 | 3471 | 3348 |
| MathArena Apex | Wettbewerbsaufgaben in Mathematik | 58.6 | 65.6 | 65.3 |
| Terminal-Bench 2.1 | Agentenaufgaben im Terminal | 82.7 | 90.6 | 87.9 |
| Terminal-Bench 4.0 | schwierigere Agentenaufgaben im Terminal | 7.0 | 31.2 | 12.4 |
| DeepSWE v1.1 | Fehlerbehebung in echten Repositories | 54.4 | 74.2 | 62.7 |
| CyberGym | Aufgaben zu Sicherheitslücken | 76.7 | 88.1 | 83.3 |
| AutomationBench | Workflow-Automatisierung | 37.7 | 54.8 | 43.2 |
Im weiteren Verlauf geht es um den Teil, den wir selbst überprüfen konnten: Aufgaben mit eindeutig verifizierbaren Antworten, nicht die Wissens-Benchmarks.
Erreicht V4.1 Flash wirklich V4 Pro und schlägt V4 Flash?
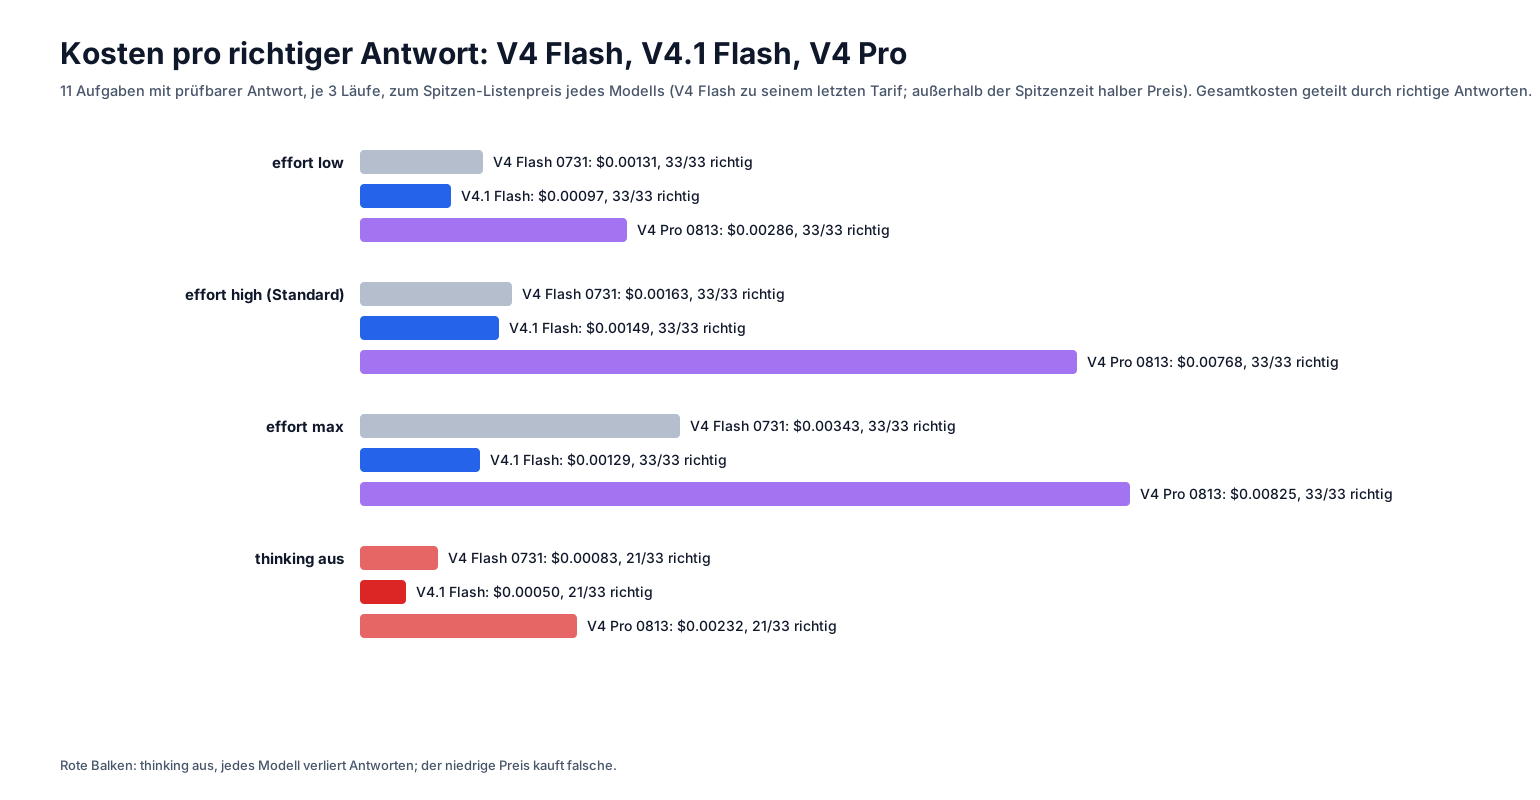
Bei Aufgaben mit überprüfbarer Antwort erreichen alle drei Builds dasselbe Ergebnis. Sie unterscheiden sich beim Preis, bei der Geschwindigkeit und bei ihren Fehlermustern. Wir verwendeten 11 Aufgaben, deren Antwort jeweils eine einzelne überprüfbare Zahl ist: Primzahlsummen, Ziffernanzahl, Pfade durch ein Gitter, Münzkombinationen, eine 40-mal angewandte Regel, der Rest bei der Division von 7 hoch 222 durch 1000, eine Basisumwandlung, ein Rucksackproblem und das Zählen vierstelliger Zahlen unter drei Bedingungen. Jede Aufgabe lief dreimal mit reasoning_effort auf low, high und max sowie ohne Thinking. Reasoning-Token sind die verborgenen Gedankenschritte, die das Modell vor der Antwort erzeugt. Sie werden als Output abgerechnet. Die Kosten pro korrekter Antwort entsprechen den Gesamtkosten geteilt durch die Zahl der richtigen Antworten, jeweils zum Spitzentarif des Modells. Für V4 Flash gilt der bis zur Einstellung verlangte Tarif von $0.44/$1.32. Außerhalb der Spitzenzeiten halbieren sich die Kosten:
| Modell | Aufwand | Korrekt | Reasoning-Token, Median (Maximum) | Kosten pro korrekter Antwort, Spitzenzeit |
|---|---|---|---|---|
| V4 Flash 0731 | low | 33/33 | 492 (6,444) | $0.00131 |
| V4 Flash 0731 | high (Standard) | 33/33 | 433 (9,172) | $0.00163 |
| V4 Flash 0731 | max | 33/33 | 453 (24,010) | $0.00343 |
| V4 Flash 0731 | Thinking aus | 21/33 | 0 | $0.00083 |
| V4.1 Flash | low | 33/33 | 316 (6,153) | $0.00097 |
| V4.1 Flash | high (Standard) | 33/33 | 391 (13,300) | $0.00149 |
| V4.1 Flash | max | 33/33 | 391 (11,037) | $0.00129 |
| V4.1 Flash | Thinking aus | 21/33 | 0 | $0.00050 |
| V4 Pro | low | 33/33 | 309 (6,398) | $0.00286 |
| V4 Pro | high (Standard) | 33/33 | 548 (18,247) | $0.00768 |
| V4 Pro | max | 33/33 | 644 (15,920) | $0.00825 |
| V4 Pro | Thinking aus | 21/33 | 0 | $0.00232 |
Mit aktiviertem Thinking löste jeder Build jede Aufgabe bei jeder Einstellung korrekt. Die Genauigkeit lässt sich mit dieser Suite also nicht unterscheiden, wohl aber Kosten und Geschwindigkeit. Gegenüber Pro ist V4.1 Flash bei low 2.9x, beim standardmäßigen high 5.2x und bei max 6.4x günstiger. Gegenüber V4 Flash kostet es bei low 26% weniger. Beim Streaming ohne Thinking, sodass nur die Antwortgenerierung und nicht das Reasoning gemessen wird, erzeugte V4.1 Flash 121 bis 134 Output-Token pro Sekunde. Vom Request bis zum ersten Token vergingen 1.4 s. V4 Flash erreichte 86 bis 94 Token pro Sekunde bei 2.3 s bis zum ersten Token, Pro 46 bis 49 bei 1.9 s. In einer Function-Calling-Schleife über zwei Turns führte jeder Build pro Turn genau einen Call aus. V4.1 Flash verwendete dabei 27 und 13 Reasoning-Token, V4 Flash 30 und 19, Pro 61 und 29. Die Kosten pro Abschnitt lagen bei $0.00019, $0.00030 und $0.00103. Die Wissenslücke aus DeepSeeks Tabelle bei HLE und GPQA ist der einzige Bereich, den diese Suite nicht abdeckt.
Was bewirkt die Effort-Einstellung, und lässt sich Thinking abschalten?
Die Einstellung verändert bei einigen Aufgaben die Kosten, aber nie die Antwort. Ohne Thinking gehen bei jedem Build 12 von 33 Antworten verloren. V4.1 Flash akzeptiert für reasoning_effort die Werte low, high und max. DeepSeek ordnet minimal dem Wert low zu, medium und xhigh dagegen high. Bei neun der elf Aufgaben liegen die drei Einstellungen nur wenige hundert Reasoning-Token auseinander. Lediglich die Zählaufgabe mit vierstelligen Zahlen unter drei Bedingungen zeigt größere Unterschiede: 5,650 bei low, 9,714 bei high und 6,763 bei max, jeweils mit korrekter Antwort. Alle Werte für thinking_budget von 0 bis 1,024 wurden akzeptiert und ignoriert. Die in der Model Card genannte “stufenlos einstellbare Reasoning-Effort-Einstellung mit Ganzzahlen von 1-100” ist über die API nicht verfügbar. Ganzzahlen werden abgelehnt. V4 Pro und V4 Flash verhalten sich mit ihren jeweiligen Token-Zahlen genauso. Bei den älteren Builds wird die Zählaufgabe mit max teuer: Pro benötigt 12,729 bis 15,920 Reasoning-Token, V4 Flash 17,866 bis 24,010. V4.1 Flash kommt mit 6,763 zur selben korrekten Antwort.
Die beiden Steuerungsmöglichkeiten und die Herkunft der Messwerte in der Response:
resp = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="low",                    # "low" | "high" | "max"; default "high"
    extra_body={"thinking": {"type": "enabled"}},  # {"type": "disabled"} turns it off
    max_tokens=4096,                           # always set one: see the next section
)
usage = resp.usage
reasoning_tokens = usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content            # returned on every thinking call
Thinking abzuschalten ist günstig, aber riskant. Jeder Build scheitert dann an anderen Aufgaben:
| Ohne Thinking, 11 Aufgaben x 3 | V4 Flash 0731 | V4.1 Flash | V4 Pro |
|---|---|---|---|
| Korrekt | 21/33 | 21/33 | 21/33 |
| Vollständig gescheitert (0 von 3) | Rucksackproblem, Primzahlsumme, Zugfahrplan | Münzkombinationen, 40-Schritt-Regel, Rucksackproblem | Rucksackproblem, Zählaufgabe |
| Fehlermuster | eine falsche Zahl im richtigen Format (17, 1043; 10:40) | ein falsches Token (83 für eine Kette mit fünf Schritten und dem Ergebnis 168) | zeigt den Rechenweg und liefert dann eine falsche Antwort |
Am deutlichsten zeigt sich das bei der fünfstufigen Kette aus unseren Standardaufgaben. Ohne Thinking beantwortete V4.1 Flash sie in 1 von 3 Fällen korrekt, in einer zweiten Messreihe in 0 von 3. V4 Flash erreichte 2 von 3, Pro 3 von 3. Pro schreibt die einzelnen Schritte vor die Antwort, die Flash-Builds tun das nicht. Zwei weitere Punkte sind für die Budgetierung relevant: Der Thinking-Modus fügt ein verborgenes Template-Präfix hinzu, das als Input abgerechnet wird. Bei V4.1 Flash sind es 26 Prompt-Token, bei V4 Flash und Pro 79. Ohne Thinking umfasst derselbe Text bei allen drei Modellen 729 Token. Außerdem wird reasoning_content, wenn es im nächsten Turn zurückgesendet wird, nicht erneut abgerechnet. Bei V4.1 Flash waren es mit und ohne diesen Inhalt 81 Prompt-Token, bei Pro 134.
Was passiert bei Fragen nach Dingen, die nicht existieren?
Mit aktiviertem Thinking verbraucht V4.1 Flash entweder das gesamte Ausgabelimit oder erfindet eine Antwort. Ohne Thinking lehnt es die Frage ab, und zwar zuverlässiger als die beiden anderen Builds. Wir stellten fünf Fragen zu frei erfundenen Entitäten. Die einzig richtige Antwort lautet daher “Ich weiß es nicht”. Gefragt wurde unter anderem nach dem Aktienkurs von “Verantis Dynamics”, der Mitarbeiterzahl des “Kessler-Fanning Institute”, dem Schmelzpunkt von “Oridium-7” und dem Gewinner eines “1987 Pan-Continental Robotics Prize”. Das Ausgabelimit lag bei 16,384 Token:
| Modell, Einstellung | Abgelehnt | Antwort erfunden | Limit von 16,384 Token erreicht, keine Antwort | Reasoning-Token |
|---|---|---|---|---|
| V4.1 Flash, Thinking an | 0/5 | 2/5 (“Professor Frink aus The Simpsons gewann 1987 den Preis”; “Oridium-7 hat einen Schmelzpunkt von 1815 °C”) | 3/5 | 2,610; 11,905; 16,384 x3 |
| V4.1 Flash, Thinking aus | 5/5 | 0/5 | 0/5 | 0 (69 bis 248 Output-Token) |
| V4 Flash 0731, Thinking an | 1/5 | 3/5 (“0 Mitarbeiter”; “Oridium-7 hat ungefähr einen Schmelzpunkt von 1065 °C”; “Montblanc, der Schweizer Roboter aus dem Manga Pluto, gewann”) | 1/5 | 4,080 bis 16,384 |
| V4 Flash 0731, Thinking aus | 4/5 | 1/5 (“Oridium-7 hat einen Schmelzpunkt von…“) | 0/5 | 0 |
| V4 Pro, Thinking an | 1/5 | 3/5 (“Andrew Martin gewann”; “0 Mitarbeiter”; ein Schmelzbereich von 899 bis 949 °C) | 1/5 | 754 bis 16,384 |
| V4 Pro, Thinking aus | 3/5 | 2/5 (According to reference 844476, the Kessler-Fanning Institute had 247…) | 0/5 | 0 |
Drei der fünf V4.1-Flash-Durchläufe mit Thinking kosteten zu Spitzenzeiten jeweils $0.0197 und lieferten eine leere Nachricht zurück. Mit dem sonst von uns verwendeten Limit von 2,048 Token passierte das bei allen fünf Durchläufen und bei Pro in vier von fünf Fällen. Wenn eine Suche berechtigterweise ohne Ergebnis enden kann, sollte sie ohne Thinking laufen. Alternativ lässt sich max_tokens begrenzen und eine leere Nachricht als “unbekannt” behandeln. Das Fehlermuster von Pro ohne Thinking ist anders und rechtfertigt einen eigenen regulären Ausdruck: Es schreibt Let me check that reference for you. According to reference und ergänzt anschließend eine erfundene Zahl.
Ist die JSON-Beschädigung von V4 Flash behoben?
Unter json_object gibt es bei keinem Build etwas zu beheben. Mit strengem json_schema konnten wir es nicht testen. V4 Flash 0731 wurde mit einem Fehler veröffentlicht: Die Kombination aus aktiviertem Thinking und strengem json_schema beschädigte in 8 von 13 Durchläufen Integer-Felder. Bei V4.1 Flash lieferte ein strenges json_schema über unseren Zugriffspfad einen 400-Fehler. DeepSeeks JSON-Anleitung dokumentiert nur {"type": "json_object"}.
Mit json_object wurde dieselbe Rechnung mit Anbieter, Datum, Gesamtbetrag und Positionen bei allen drei Builds vollständig korrekt zurückgegeben: in 8 von 8 Durchläufen mit Thinking und 8 von 8 ohne Thinking. V4 Pro beschädigt Daten unter strengem json_schema weiterhin, wenn Thinking aktiviert ist. In 0 von 8 Durchläufen stimmte die Anzahl der Positionen (45, 12, 47, 1, 2026), ohne Thinking dagegen in 8 von 8. Für Extraktionen war json_object ohne Thinking bei jedem Build in jedem Durchlauf korrekt. Bei V4.1 Flash kostet das 25 Output-Token.
Was kostet ein Bild mit V4.1 Flash?
184 Input-Token für alle Bilder bis 512x512, 652 bei einem Megapixel und 994 bei vier Megapixeln. Bild-Input ist neu in der Flash-Reihe. Der eingestellte Vision-Exp-Build war ein separates Modell, und V4 Flash 0731 verarbeitet nur Text. Wir sendeten deshalb generierte PNGs an V4.1 Flash und zogen die Token des reinen Text-Prompts ab:
| Bild | Bild-Token | Kosten zu Spitzenzeiten |
|---|---|---|
| 64x64, 128x128, 256x256, 512x512 | 184 | $0.000055 |
| 1024x1024 | 652 | $0.000196 |
| 2048x512 (dieselbe Fläche wie 1024x1024) | 652 | $0.000196 |
| 512x2048 | 688 | $0.000206 |
| 2048x2048 | 994 | $0.000298 |
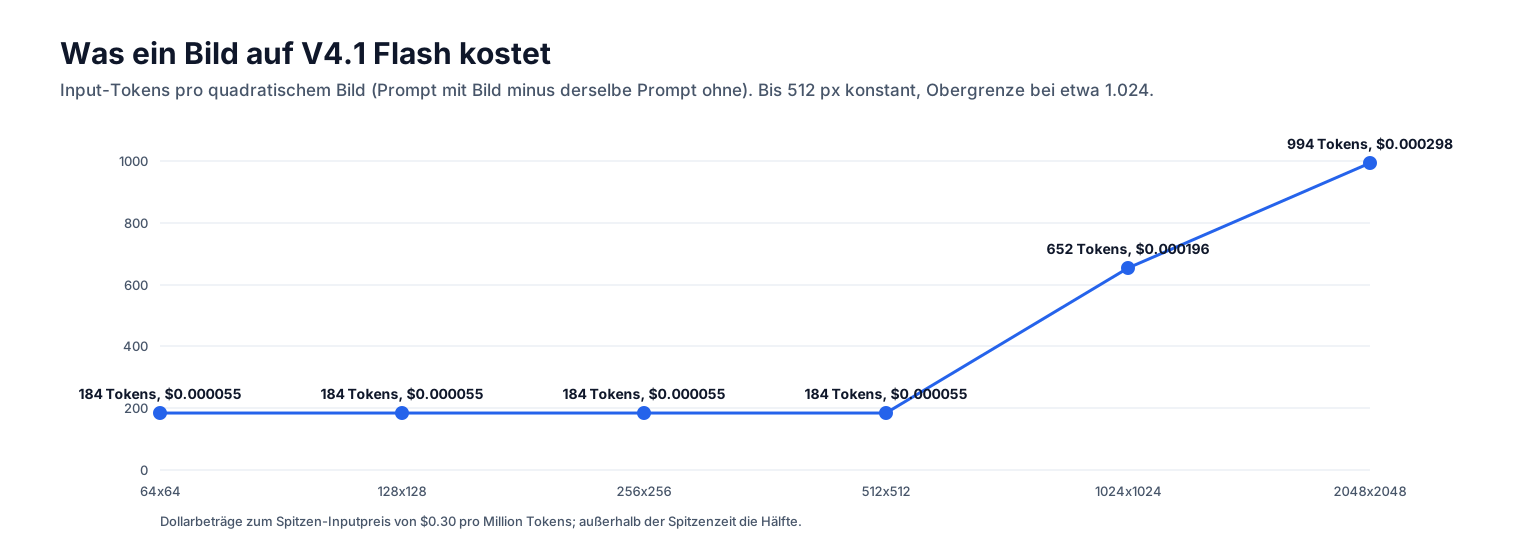
Die Untergrenze entspricht der Anleitung zur Bildverarbeitung: “Bilder mit insgesamt weniger als ungefähr 544x544 Pixeln werden hochskaliert”. Größere Bilder werden “auf ungefähr die Größe eines Bildes mit 1300x1300 Pixeln” herunterskaliert. Das dokumentierte Maximum liegt bei 1,024 Token pro Bild. Inhalt (einfarbig, Rauschen, gerenderter Text) und Format (PNG, JPEG, WebP; 174 bis 243 KB) änderten die Token-Zahl nicht. Abgerechnet wird nach Geometrie, nicht nach Dateigröße. Tausend Bilder mit einem Megapixel kosten zu Spitzenzeiten $0.20 an Bild-Token, zuzüglich Frage und Antwort.
So bindet Synthorai das Modell an
V4.1 Flash ist über das Gateway als deepseek-v4.1-flash verfügbar. DeepSeeks eigene ID lautet deepseek-flash. Rund um die Uhr werden $0.30 pro Million Input-Token und $1.20 pro Million Output-Token berechnet, Cache-Zugriffe kosten $0.03 pro Million. Einen günstigeren Tarif außerhalb der Spitzenzeiten gibt es nicht. Alle Zahlen in diesem Beitrag verwenden DeepSeeks Listenpreis, damit sich die Kosten für die eigenen Nutzungszeiten berechnen lassen. V4 Flash 0731 und V4 Pro 0813 bleiben als deepseek-v4-flash-0731 und deepseek-v4-pro-0813 zu ihren jeweiligen Tarifen verfügbar. Sowohl /v1/chat/completions als auch /v1/responses unterstützen das Modell. Über thinking: {"type": "disabled"} lässt sich Thinking auf diesem Zugriffspfad abschalten. Der Reasoning-Text wird bei jedem Call mit Thinking in reasoning_content zurückgegeben. Bild-Input wird als image_url-Content-Part übermittelt.
FAQ
Ist DeepSeek V4.1 Flash günstiger als V4 Flash?
Es ist günstiger als der August-Tarif, den es ersetzt, aber nicht günstiger als der Einführungspreis vom Juli. V4.1 Flash kostet zu Spitzenzeiten $0.30/$1.20 pro Million Token und außerhalb davon $0.15/$0.60. V4 Flash kostete ab Mitte August zu Spitzenzeiten $0.44/$1.32, zuvor $0.14/$0.28. In unserer Suite kostete eine korrekte Antwort mit V4.1 Flash bei low $0.00097, bei V4 Flash zum zuletzt gültigen Tarif $0.00131.
Lässt sich Thinking bei DeepSeek V4.1 Flash abschalten?
Ja, mit thinking: {"type": "disabled"}. DeepSeek dokumentiert außerdem reasoning_effort: "none". Bei mehrstufigen Aufgaben sinkt dadurch die Genauigkeit: V4.1 Flash fiel in unserer Suite von 33 von 33 auf 21 von 33 und beantwortete eine fünfstufige Kette mit einem einzigen falschen Token. Für Rechenaufgaben und Planung sollte Thinking aktiviert bleiben. Bei Extraktionen und Suchen, die ohne Ergebnis enden können, sollte es deaktiviert werden.
Unterstützt DeepSeek V4.1 Flash Bild-Input, und was kostet ein Bild?
Ja, nativ. Bei V4.1 Flash kostet ein Bild bis 512x512 184 Input-Token, bei 1024x1024 652 und bei 2048x2048 994. Inhalt und Format spielen keine Rolle. Zum Spitzentarif sind das $0.000055 bis $0.000298 pro Bild.
Verwandte Beiträge: Kosten von DeepSeek V4 Flash, DeepSeek V4 Pro GA im Vergleich zur Preview, Thinking-Steuerung bei LLMs, Token-Kosten für Bild-Input, strukturierte LLM-Ausgaben.