
GLM 5.3 API-Kosten: immer Thinking, pro Antwort 2.5x günstiger
Inhalt
- Was ist GLM 5.3 und was kostet es?
- Lässt sich Thinking weiterhin abschalten?
- Welche Effort-Stufe liefert richtige Antworten?
- Erfindet das Modell Antworten auf unbeantwortbare Fragen?
- Hält sich GLM 5.3 an ein JSON-Schema?
- Was kostet ein Bild mit GLM 5.3 Flash?
- Was hat sich gegenüber GLM 5.2 noch geändert?
- So verarbeitet Synthorai die Modelle
- FAQ
GLM 5.3 kostet wie GLM 5.2 $1.40 pro Million Input-Token und $4.40 pro Million Output-Token. Thinking lässt sich nicht mehr abschalten: Jeder entsprechende Versuch endet mit einem 400-Fehler, und standardmäßig gilt max. Wir haben 11 Aufgaben mit eindeutig prüfbarer Antwort jeweils dreimal ausgeführt. Nur max löste alle 33 korrekt, bei Kosten von $0.00468 pro richtiger Antwort. Das ist 2.5x günstiger als GLM 5.2 mit max, weil GLM 5.3 nur etwa halb so viel Reasoning erzeugt. low kostet pro richtiger Antwort 63% weniger, löst aber 5 von 33 Aufgaben falsch. GLM 5.3 Flash erreichte 31 von 33 zu einem Zehntel der Kosten. reasoning_effort, also der Parameter für die Dauer des Reasonings vor der Antwort, bestimmt jetzt neben den Kosten auch die Genauigkeit. Wir haben beide Varianten in einem Batch mit GLM 5.2 und DeepSeek V4.1 Flash verglichen.
TL;DR
- GLM 5.3 und GLM 5.3 Flash lehnen
thinking: disabled,reasoning_effort: noneundmediummit Fehler 1210 ab. Unterstützt werden nurlow,highundmax(Standardwert). - Mit
maxerreichte GLM 5.3 33 von 33 bei $0.00468 pro richtiger Antwort. GLM 5.2 kostete mitmax$0.01173. - Mit
lowerreichte GLM 5.3 28 von 33 und GLM 5.3 Flash 24 von 33. - Beide GLM-5.3-Varianten ignorieren ein striktes
json_schema. Mitjson_objectwaren die Werte in 8 von 8 Fällen korrekt.
Was ist GLM 5.3 und was kostet es?
GLM 5.3 ist ein zum gleichen Preis nachtrainiertes GLM 5.2, ergänzt um ein kleineres Modell für ein Zehntel der Kosten. Laut dem Guide von Z.ai verwendet GLM 5.3 “dasselbe Basismodell wie GLM-5.2, wobei alle Verbesserungen aus dem Post-Training stammen”, und verarbeitet ausschließlich Text. GLM 5.3 Flash hat “insgesamt 320B Parameter, von denen 18B aktiviert sind”. Pro Token arbeiten also nur 18B Parameter, was die niedrigen Kosten ermöglicht. Flash akzeptiert außerdem Bilder, Videos und Dateien. Beide Modelle bieten 1M Token Kontext und 128K Token Output. Laut der Preisseite von Z.ai gelten pro Million Token folgende Preise:
| Modell | Input | Gecachter Input | Output |
|---|---|---|---|
| GLM 5.3 | $1.40 | $0.26 | $4.40 |
| GLM 5.3 Flash | $0.15 | $0.03 | $0.50 |
| GLM 5.2 | $1.40 | $0.26 | $4.40 |
| DeepSeek V4.1 Flash | $0.30 zu Spitzenzeiten | $0.006 zu Spitzenzeiten | $1.20 zu Spitzenzeiten |
Die Model Card und der Flash-Guide von Z.ai verorten die Verbesserungen vor allem bei Agenten- und Coding-Aufgaben:
| Benchmark | Getesteter Bereich | GLM 5.2 | GLM 5.3 | GLM 5.3 Flash |
|---|---|---|---|---|
| Terminal Bench 3.0 | Agentenaufgaben im Terminal | 4.6 | 28.3 | nicht aufgeführt |
| DeepSWE v1.1 | Fehlerbehebung in echten Repositories | 46.2 | 66.9 | 63.4 |
| AutomationBench | Workflow-Automatisierung | 26.2 | 48.2 | 48.8 |
| CyberGym | Aufgaben zu Sicherheitslücken | 77.2 | 84.5 | nicht aufgeführt |
| HLE with tools | schwierige Fragen mit erlaubten Tools | 54.7 | 62.5 | nicht aufgeführt |
Im Folgenden geht es um das, was wir selbst prüfen konnten: Aufgaben mit genau einer verifizierbaren Antwort, nicht um Agenten-Benchmarks.
Lässt sich Thinking weiterhin abschalten?
Nein. GLM 5.2 akzeptierte thinking: {"type": "disabled"}. GLM 5.3 und GLM 5.3 Flash antworten mit HTTP 400 und Fehlercode 1210 (“dieses Modell denkt immer; Thinking kann nicht abgeschaltet werden; verwenden Sie low, high oder max”), wenn thinking: disabled, enable_thinking: false oder für reasoning_effort einer der Werte none, minimal, medium oder xhigh gesetzt wird. Ohne reasoning_effort gilt max. thinking_budget, ein von einigen Providern unterstütztes Token-Limit für Thinking, wird von GLM 5.3 akzeptiert, aber ignoriert: Bei derselben Frage erzeugte jeder Wert von 0 bis 1,024 ungefähr 101 Reasoning-Token.
resp = client.chat.completions.create(
    model="glm-5.3",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="high",   # "low" | "high" | "max"; omitted means "max"
    max_tokens=8192,           # GLM 5.3 Flash rejects anything above 131,072
)
reasoning_tokens = resp.usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content                # the thinking itself, as text
Der bisherige günstige Pfad war ohnehin nicht gut: Mit abgeschaltetem Thinking löste GLM 5.2 10 unserer 33 Aufgaben korrekt, DeepSeek V4.1 Flash schaffte 22.
Welche Effort-Stufe liefert richtige Antworten?
Bei GLM 5.3 nur max, bei GLM 5.3 Flash keine. Wir haben 11 Aufgaben verwendet, deren Antwort jeweils eine einzelne, prüfbare Zahl ist, und jede dreimal ausgeführt. Dazu gehörten Primzahlsummen, Ziffernzählungen, Gitterpfade, Münzkombinationen, eine 40-mal angewendete Regel, der Rest von 7 hoch 222 bei Division durch 1000, eine Basisumrechnung, ein Rucksackproblem sowie das Zählen vierstelliger Zahlen unter drei Bedingungen. Reasoning-Token sind die vor der Antwort erzeugten, verborgenen Gedankenschritte und werden als Output abgerechnet. Die Kosten pro richtiger Antwort entsprechen den Gesamtkosten zum Listenpreis geteilt durch die Anzahl richtiger Antworten:
| Modell | Effort | Richtig | Reasoning-Token, Median (Maximum) | Kosten pro richtiger Antwort |
|---|---|---|---|---|
| GLM 5.3 | low | 28/33 | 143 (1,826) | $0.00173 |
| GLM 5.3 | high | 29/33 | 226 (1,950) | $0.00197 |
| GLM 5.3 | max (Standardwert) | 33/33 | 538 (7,733) | $0.00468 |
| GLM 5.3 Flash | low | 24/33 | 120 (467) | $0.00012 |
| GLM 5.3 Flash | high | 29/33 | 196 (1,582) | $0.00021 |
| GLM 5.3 Flash | max (Standardwert) | 31/33 | 419 (5,024) | $0.00040 |
| GLM 5.2 | max | 33/33 | 1,129 (21,917) | $0.01173 |
| DeepSeek V4.1 Flash | low | 33/33 | 337 (6,797) | $0.00102 |
| DeepSeek V4.1 Flash | max | 33/33 | 386 (10,769) | $0.00138 |
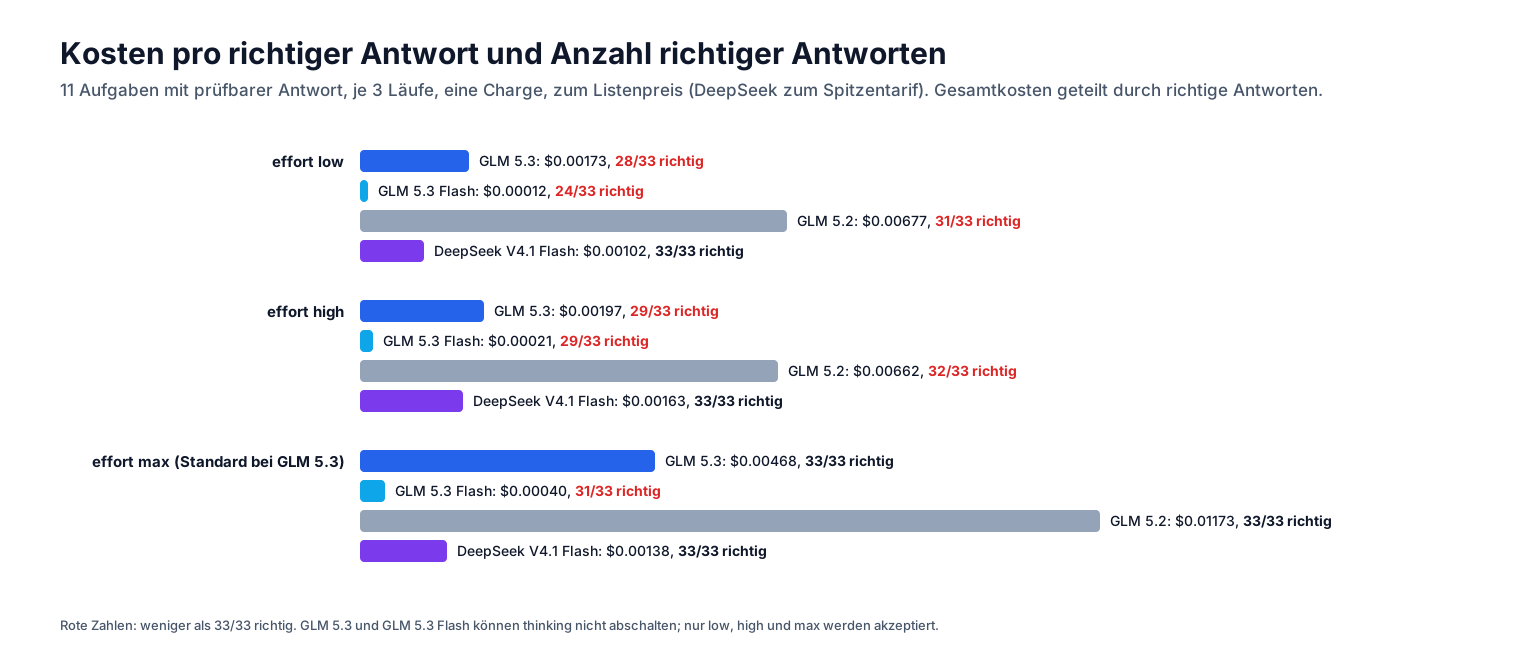
Der Faktor 2.5x gegenüber GLM 5.2 ergibt sich aus der Menge des Reasonings: Der Median liegt bei 538 statt 1,129 Reasoning-Token, der längste Lauf bei 7,733 statt 21,917. Die niedrigeren Stufen sparen Kosten, weil sie Prüfungen überspringen. Mit low gab GLM 5.3 für die Anzahl der Gitterpfade zweimal 216 aus, obwohl eine blockierte Zelle das korrekte Ergebnis auf 132 reduziert. Außerdem löste es die Münzkombinationen, das Rucksackproblem und die Basisumrechnung jeweils einmal falsch. GLM 5.3 Flash scheiterte mit low jedes Mal an der 40-Schritte-Regel und der Zählaufgabe mit Nebenbedingungen. DeepSeek V4.1 Flash erreichte dagegen mit jeder Einstellung 33 von 33.
Für Arithmetik oder Aufgaben mit mehreren Schritten sollte GLM 5.3 mit dem Standardwert laufen. low eignet sich nur, wenn eine falsche Antwort nachgelagert leicht erkannt werden kann. Mit max kostet GLM 5.3 pro richtiger Antwort 3.4x so viel wie DeepSeek V4.1 Flash. GLM 5.3 Flash kostet weniger als ein Drittel davon, löst aber 2 von 33 Aufgaben falsch.
Erfindet das Modell Antworten auf unbeantwortbare Fragen?
Nein, auch nicht bei erzwungenem Thinking. Wir stellten fünf Fragen zu frei erfundenen Entitäten, bei denen “Ich weiß es nicht” die einzig richtige Antwort war. Beispiele waren der Aktienkurs von Verantis Dynamics, der Schmelzpunkt von Oridium-7 und der Gewinner des 1987 Pan-Continental Robotics Prize. Verwendet wurden der Standard-Effort und ein Limit von 16,384 Token:
| Modell | Antwort verweigert | Antwort erfunden | Limit erreicht, leere Antwort | Reasoning-Token | Kosten pro Frage |
|---|---|---|---|---|---|
| GLM 5.3 | 5/5 | 0/5 | 0/5 | 230 bis 542 | $0.0022 |
| GLM 5.3 Flash | 5/5 | 0/5 | 0/5 | 238 bis 625 | $0.0003 |
| GLM 5.2 | 5/5 | 0/5 | 0/5 | 134 bis 1,559 | $0.0035 |
| DeepSeek V4.1 Flash | 1/5 | 3/5 | 1/5 | 7,021 bis 16,384 | $0.0139 |
Beide GLM-5.3-Varianten teilten nach einigen Hundert Reasoning-Token mit, dass ihnen keine Informationen vorlagen. DeepSeek V4.1 Flash erzeugte 7,000 bis 16,000 Token Reasoning und erfand anschließend meist eine Antwort (Andrew Martin, the robot protagonist of Isaac Asimov's The Bicentennial Man, won). In der eigenen Untersuchung vom Vortag erreichten mehr Läufe stattdessen das Limit, doch eine Antwort verweigerte das Modell nur selten. Bei Lookups, die berechtigterweise kein Ergebnis liefern können, war dies der größte von uns gemessene Unterschied zwischen den beiden Flash-Modellen.
Hält sich GLM 5.3 an ein JSON-Schema?
Nicht an ein striktes. Verwenden Sie json_object. Bei einer Rechnungsextraktion mit einem strikten json_schema als response_format antworteten GLM 5.3 und GLM 5.3 Flash mit HTTP 200, ignorierten das Schema aber in 16 von 16 Läufen. Das JSON stand in einem Markdown-Codeblock und enthielt nicht angeforderte Schlüssel (invoice_date, reference). Daher ließ sich keine Antwort als das angeforderte Objekt parsen. Die API-Referenz von Z.ai führt nur text und json_object auf. Das Problem: Das Schema wird ohne Fehlermeldung akzeptiert.
Mit {"type": "json_object"} und den Feldnamen im Prompt lieferten beide Varianten in 8 von 8 Läufen alle Werte korrekt. Dasselbe galt für GLM 5.2 und DeepSeek V4.1 Flash. Da Thinking aktiv bleibt, benötigt die Extraktion bei GLM 5.3 im Median 240 Output-Token und bei Flash 140. V4.1 Flash braucht mit abgeschaltetem Thinking 25. Validieren Sie das Ergebnis selbst gegen Ihr Schema.
Was kostet ein Bild mit GLM 5.3 Flash?
Die Kosten steigen mit der Pixelfläche und werden bei 2048x2048 nicht gedeckelt. Große Bilder kosten damit trotz des niedrigeren Token-Preises mehr als bei DeepSeek V4.1 Flash. Wir sendeten generierte PNGs an GLM 5.3 Flash (GLM 5.3 verarbeitet nur Text) und zogen die Token des reinen Text-Prompts ab:
| Bild | GLM 5.3 Flash Token | Kosten bei $0.15/M | DeepSeek V4.1 Flash Token | Kosten bei $0.30/M |
|---|---|---|---|---|
| 512x512 | 363 | $0.000054 | 184 | $0.000055 |
| 1024x1024 | 1,371 | $0.000206 | 652 | $0.000196 |
| 2048x2048 | 5,478 | $0.000822 | 994 | $0.000298 |
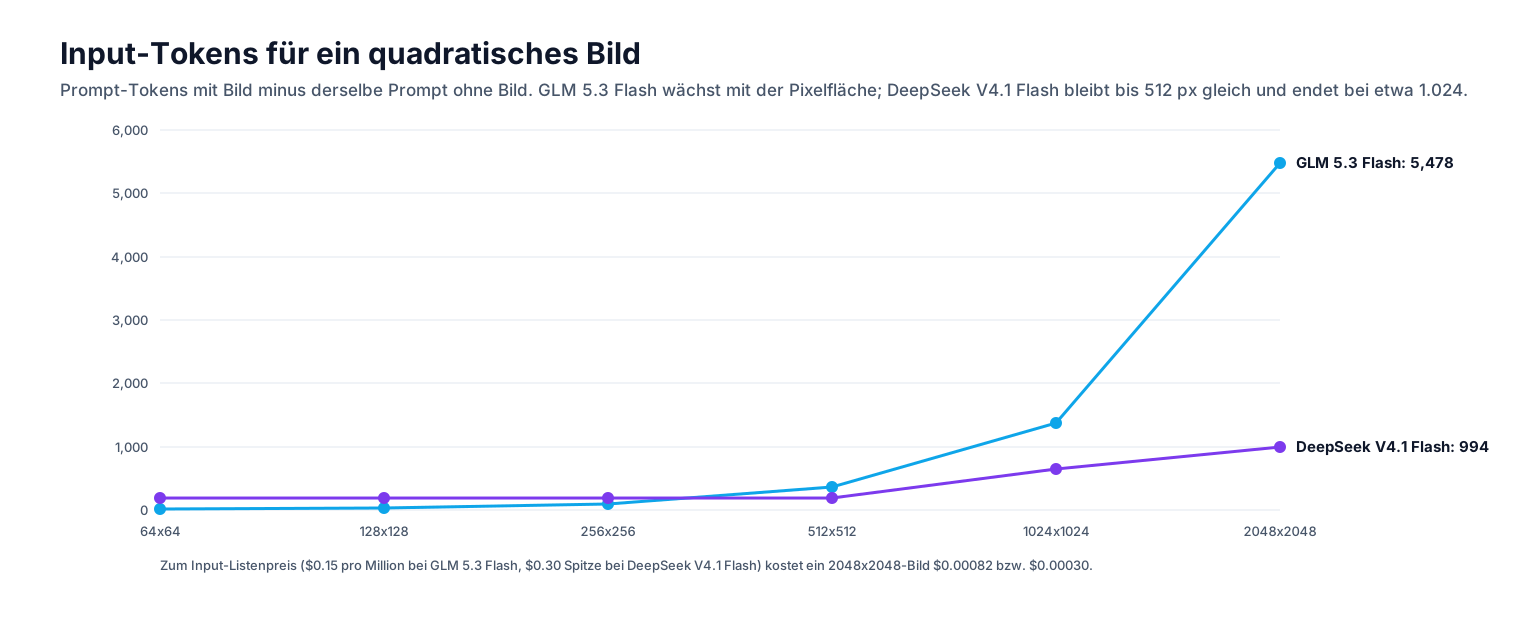
Oberhalb von 512 Pixeln benötigt GLM 5.3 Flash ungefähr ein Token pro 766 Pixel. detail, Bildinhalt und Dateiformat änderten die Anzahl nicht. Die Werte für DeepSeek V4.1 Flash stammen aus der Untersuchung vom Vortag. Screenshots und Dokumentseiten sollten vor dem Senden verkleinert werden: Bei 2048x2048 kostet GLM 5.3 Flash pro Bild 2.8x mehr.
Was hat sich gegenüber GLM 5.2 noch geändert?
Vor allem die Geschwindigkeit, wenig an der technischen Anbindung. Beim Streaming im selben Zeitfenster und mit low erzeugte GLM 5.3 59 bis 64 Output-Token pro Sekunde, GLM 5.3 Flash 70 bis 82, GLM 5.2 51 bis 55 und DeepSeek V4.1 Flash 124 bis 161. In einer Function-Calling-Schleife mit zwei Turns führte jedes Modell pro Turn genau einen Call aus. Die drei GLM-Varianten zählen für englischen, chinesischen und Python-Text identisch viele Token (737, 484 und 488), vorhandene Token-Budgets können also übernommen werden.
Ein am Anfang des Prompts wiederholter Abschnitt wird zum Cache-Tarif abgerechnet und in 64-Token-Schritten gezählt. Bei einem Prompt mit 1,153 Token wurden 1,024 aus dem Cache gelesen. Beide Varianten akzeptieren Prompts nahe der Grenze von 1M Token, obwohl die Model Card von Flash 300,000 Token nennt: Ein Prompt mit 990,000 Token, in dessen vorderem Teil ein Wert versteckt war, lieferte diesen Wert zurück (den Abruf von Inhalten nahe dem Ende haben wir nicht getestet). Ein Prompt mit ungefähr 1.07M Token führte zu einem 400-Fehler mit Prompt exceeds max length, statt abgeschnitten zu werden. Eine Inkompatibilität beim Upgrade gibt es: GLM 5.3 Flash lehnt max_tokens über 131,072 ab.
So verarbeitet Synthorai die Modelle
GLM 5.3, GLM 5.3 Flash und GLM 5.2 sind auf dem Gateway als glm-5.3, glm-5.3-flash und glm-5.2 zu den Listenpreisen von Z.ai verfügbar, sowohl über /v1/chat/completions als auch über /v1/responses. Der Fehler 1210 wird unverändert durchgereicht. Ein Client, der weiterhin den Schalter zum Abschalten von Thinking aus GLM 5.2 sendet, schlägt damit sichtbar fehl, statt unbemerkt mit max zu arbeiten. Reasoning-Text wird in reasoning_content zurückgegeben. Bilder werden als image_url-Content-Parts an GLM 5.3 Flash gesendet.
FAQ
Lässt sich Thinking bei GLM 5.3 abschalten?
Nein. GLM 5.3 und GLM 5.3 Flash antworten bei jedem Versuch mit einem 400-Fehler und Fehlercode 1210. Akzeptiert werden nur low, high und max, wobei max der Standardwert ist. In unseren Tests kostete low pro richtiger Antwort 63% weniger, erreichte aber nur 28 statt 33 richtige Antworten.
Ist GLM 5.3 günstiger als GLM 5.2?
Pro Token nein: Beide kosten $1.40 für Input und $4.40 für Output. Pro richtiger Antwort ja: Mit max kostete GLM 5.3 $0.00468 gegenüber $0.01173 bei GLM 5.2, weil GLM 5.3 nur ungefähr halb so viel Reasoning erzeugt.
Kann GLM 5.3 Flash GLM 5.3 ersetzen?
Ja, wenn gelegentlich falsche Zahlen nachgelagert erkannt werden, und das zu einem Zehntel der Kosten: GLM 5.3 Flash erreichte mit max 31 von 33 bei $0.00040 pro richtiger Antwort. GLM 5.3 erreichte 33 von 33 bei $0.00468. Für mehrstufige Arithmetik sollte Flash nicht mit low verwendet werden, da es damit nur 24 von 33 Aufgaben korrekt löste.
Verwandte Artikel: Reasoning-Effort bei GLM 5.2, Tool-Calls mit GLM 5.2, Kosten von DeepSeek V4.1 Flash, Thinking-Steuerung bei LLMs, strukturierte Ausgaben von LLMs.