
GPT-6.1 Terra vs GPT-5.6 Terra e Sol: 192 chamadas de API
Conteúdo
- Qual é o lugar do GPT-6.1 Terra na linha de modelos da OpenAI?
- O que mostram os benchmarks oficiais?
- Como testamos os níveis de raciocínio?
- O que aconteceu ao desativar o raciocínio?
- Como os três modelos se comparam nas nossas tarefas?
- Vale migrar do GPT-5.6 Terra para o GPT-6.1 Terra?
- Qual escolher: GPT-6.1 Terra ou GPT-6.1 Sol?
- Como configurar o nível de raciocínio na API?
- Como validar valores de faturas em produção?
- Perguntas frequentes
- Vale migrar do GPT-5.6 Terra para o GPT-6.1 Terra?
- Qual escolher: GPT-6.1 Terra ou GPT-6.1 Sol?
- Posso desativar o raciocínio no processamento de faturas?
GPT-6.1 Terra é o modelo de menor custo da OpenAI para fluxos de trabalho visuais. Custa $1 por milhão de tokens de entrada e $5 por milhão de tokens de saída, metade dos preços do GPT-6.1 Sol. O nível de raciocínio controla o processamento interno antes da resposta. A opção none desativa esse processamento; nas demais opções, os tokens de raciocínio são cobrados como parte da saída. Sem raciocínio, o modelo acertou todas as 16 tarefas de tabelas e seleção de botões do nosso teste, mas apenas 3/8 cálculos em imagens de faturas e 0/8 cálculos equivalentes em texto.
TL;DR
- GPT-6.1 Terra em
noneacertou 16/16 tarefas de tabelas e capturas de tela, mas apenas 3/8 cálculos em imagens de faturas no nosso teste sintético. - GPT-6.1 Terra em
lowacertou 24/24 tarefas com imagens e 7/8 tarefas equivalentes com faturas em texto; emmedium, acertou 24/24 e 8/8. - GPT-6.1 Terra em
mediumcustou $0.028290 para 24 imagens; GPT-6.1 Sol emlowcustou $0.055012. - Em uma execução separada, com condições equivalentes, GPT-6.1 Terra em
mediumcustou $0.028269 para 24 imagens; GPT-5.6 Terra custou $0.072094.
Qual é o lugar do GPT-6.1 Terra na linha de modelos da OpenAI?
GPT-6.1 Terra foi desenvolvido para raciocínio visual, ações em interfaces e redação concisa, com preço inferior ao do GPT-6.1 Sol. A OpenAI lançou o Terra em 26 de outubro de 2026. Seu guia de escolha de modelos recomenda o uso em tarefas bem definidas, com resultados verificáveis, incluindo fluxos em interfaces e correções pontuais de código. O Sol continua sendo a opção mais generalista para projetos complexos.
GPT-5.6 Terra serve como referência da geração anterior para decidir se vale a pena migrar. O Sol é a alternativa atual de maior preço para decidir qual categoria de modelo usar. Os três modelos ajudam a responder a essas duas questões:
| Especificação | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Papel nesta comparação | Referência da geração anterior | Novo modelo para fluxos visuais | Opção de maior preço para trabalhos complexos |
| Preço Standard de entrada por 1M de tokens | $2 | $1 | $2 |
| Preço Standard de saída por 1M de tokens | $12 | $5 | $10 |
| Preço de leitura de entrada em cache por 1M de tokens | $0.20 | $0.05 | $0.10 |
| Janela de contexto | 1,050,000 tokens | 1,050,000 tokens | 1,050,000 tokens |
| Saída máxima | 128,000 tokens | 128,000 tokens | 128,000 tokens |
| Níveis de raciocínio | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Raciocínio padrão | medium | medium | medium |
| Modalidades de entrada / saída | Texto e imagem / texto | Texto e imagem / texto | Texto e imagem / texto |
| Endpoint usado nos testes | Responses API | Responses API | Responses API |
Fontes: documentação oficial do GPT-5.6 Terra, GPT-6.1 Terra e Sol, além do histórico de lançamentos. Os preços acima se aplicam a requisições Standard com até 272,000 tokens de entrada. Acima desse limite, o preço da entrada sem cache dobra e o da saída aumenta em 50% para toda a requisição. Gravações em cache têm preços separados; nenhuma das requisições principais medidas registrou leituras ou gravações em cache.
O novo Terra mantém a janela de contexto, o limite de saída e os nomes dos níveis de raciocínio da geração anterior. O preço de tabela da entrada caiu 50%, e o da saída, 58.3%. Mais adiante, nosso teste de migração em condições equivalentes separa essas reduções de preço das mudanças no consumo de tokens e nos acertos das tarefas.
O que mostram os benchmarks oficiais?
No lançamento, a OpenAI compara o GPT-6.1 Terra com o GPT-5.6 Terra e o GPT-6.1 Sol. Estes são os resultados efetivamente informados no anúncio:
| Avaliação | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam: fluxos visuais profissionais | Referência; pontuação absoluta não informada | Em medium, +15 pontos percentuais sobre o antecessor, com cerca de um terço do custo por tarefa | Pontuação absoluta não informada |
| MMMU-Pro: raciocínio visual | Abaixo do novo Terra em todos os níveis informados; pontuações não divulgadas | Quase iguala o Sol; pontuações não divulgadas | Descrito como quase igualado pelo novo Terra; pontuação não informada |
| Terminal-Bench 4.0: tarefas de programação no terminal | Pontuação publicada de 21.5%; nível não especificado | 50.3% em max | Pontuação não informada |
| Teste interno de factualidade: quanto menor a taxa de erro, melhor | 53.6% de erros em low | 16.7% de erros em low | Taxa de erro em low não informada |
Fonte: avaliações de lançamento da OpenAI. As pontuações ausentes não foram divulgadas; a avaliação de factualidade é interna. Os testes de API abaixo avaliam a migração e a escolha da categoria de modelo nas mesmas tarefas sintéticas.
Como testamos os níveis de raciocínio?
Testamos o GPT-6.1 Terra em none, low e medium, junto com o GPT-6.1 Sol em low, usando 32 entradas por configuração: 24 imagens e oito controles equivalentes em texto. Isso totaliza 128 chamadas no estudo principal. Uma comparação de migração separada intercalou respostas do GPT-5.6 Terra e novas respostas do GPT-6.1 Terra em medium para as mesmas 32 entradas, acrescentando 64 chamadas e chegando a 192 no total. A tabela de migração usa apenas esse lote separado.
| Grupo de tarefas | Entradas por configuração | Resultado exigido |
|---|---|---|
| Imagens de faturas | 8 | Multiplicar os itens, subtrair um desconto, calcular e arredondar o imposto e subtrair um adiantamento |
| Tabelas com filtros | 8 | Agregar os dados da região e do trimestre correspondentes e calcular uma taxa de devolução |
| Capturas de tela de aplicativos | 8 | Identificar o ID correto do controle e um ponto dentro do botão, entre cartões semelhantes |
| Controles com faturas em texto | 8 | Calcular os mesmos valores da fatura a partir de uma transcrição exata |
Geramos documentos fictícios com respostas conhecidas, usando três modelos de documento com variações nos valores ou no layout. Cada imagem tinha 960 por 640 pixels e foi enviada com detail: "high". As versões em imagem e texto de uma fatura usaram as mesmas instruções, esquema e regras de negócio. Cada entrada recebeu uma resposta por configuração.
A execução usou requisições Responses com streaming pelo Synthorai em 29 de outubro de 2026, com limite comum de 4,096 tokens de saída e configurações intercaladas. Todas as 128 respostas principais foram concluídas e retornaram JSON válido conforme o esquema. Para considerar a tarefa correta, todos os valores solicitados precisavam corresponder exatamente; nas capturas de tela, as coordenadas precisavam estar dentro do botão correto. A correção foi feita em código, com centavos inteiros e arredondamento decimal, sem um modelo avaliador.
Essas 24 imagens representam três modelos de tarefa, não 24 tipos distintos de trabalho. Dezesseis comparações pareadas entre os estudos principal e de migração foram ajustadas em conjunto pelo método de Holm para considerar os múltiplos testes. Nenhum valor-p ajustado ficou abaixo de 0.05. As contagens abaixo descrevem esta execução; não estabelecem uma classificação geral de qualidade nem equivalência entre os modelos.
O que aconteceu ao desativar o raciocínio?
O GPT-6.1 Terra em none errou cinco dos oito cálculos em imagens de faturas e todos os oito cálculos de faturas em texto. Na mesma rodada de testes dos níveis de raciocínio, low acertou 8/8 imagens de faturas e 7/8 controles em texto; medium acertou 8/8 nos dois grupos. Os resultados entre modelos estão reunidos na tabela dos três modelos abaixo.
Os erros nas entradas apenas em texto mostram que a leitura das imagens não explica todas as falhas. Os oito pares de entradas não comprovam uma vantagem do formato de imagem.
Uma das faturas ilustra a falha:
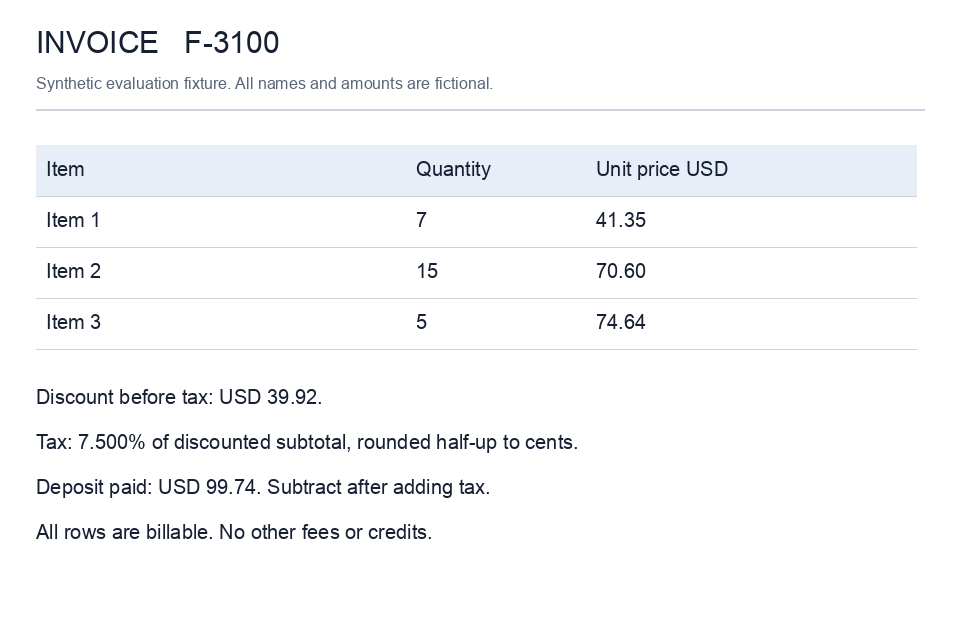
Os itens são 7 × $41.35, 15 × $70.60 e 5 × $74.64. O subtotal é $1,721.65. Após o desconto de $39.92, o imposto de 7.5%, arredondado pelo critério de metade para cima, é $126.13; ao subtrair o adiantamento de $99.74, o saldo a pagar é $1,708.12.
Na versão em texto, o Terra em low retornou subtotal de $1,711.65, imposto de $125.38 e saldo a pagar de $1,697.37. O JSON seguia o esquema, mas a conta estava errada. Aumentar o nível de raciocínio é uma variável a avaliar; uma saída tipada, por si só, não valida um valor monetário.
Na rodada principal original, as quatro configurações acertaram as oito tarefas de tabelas com filtros e as oito de seleção de botões. Esses modelos de tarefa não distinguiram a qualidade das configurações nessa rodada; os erros nas faturas explicam a diferença nas contagens de acertos.
Como os três modelos se comparam nas nossas tarefas?
Comparamos o GPT-5.6 Terra e o GPT-6.1 Terra em medium; o GPT-6.1 Sol usou low na comparação prática entre categorias de modelo. Usamos o Terra em medium na recomendação principal porque ele acertou 8/8 faturas em texto, contra 7/8 em low; para o Sol, usamos a configuração testada, low. A comparação é entre configurações candidatas com níveis diferentes, não entre modelos com o mesmo esforço de raciocínio. A diferença de uma tarefa não comprova que medium seja mais preciso em geral.
Principal é a rodada original de testes dos níveis de raciocínio. Migração é a nova comparação entre as duas gerações do Terra. A coluna do novo Terra apresenta um valor para cada execução sempre que as medidas diferem. As recomendações de migração usam os valores da execução de migração; as recomendações entre Terra e Sol usam os valores da execução principal. Nenhuma razão de custo ou latência abaixo mistura lotes.
| Medida | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Configuração | medium, execução de migração | medium, execuções principal e de migração | low, execução principal |
| Imagens de faturas corretas | 8/8 | 8/8 em cada execução | 8/8 |
| Faturas equivalentes em texto corretas | 8/8 | 8/8 em cada execução | 8/8 |
| Tabelas com filtros corretas | 8/8 | 8/8 em cada execução | 8/8 |
| Tarefas de capturas de tela totalmente corretas | 2/8 | 8/8 em cada execução | 8/8 |
| Total de tarefas com imagens corretas | 18/24 | 24/24 em cada execução | 24/24 |
| Custo de 24 imagens | $0.072094 | Principal: $0.028290; migração: $0.028269 | $0.055012 |
| Mesmo consumo de imagens a $1 de entrada / $5 de saída por 1M de tokens | $0.033500 | Principal: $0.028290; migração: $0.028269 | $0.027506 |
| Custo por tarefa com imagem correta | $0.004005 | Principal: $0.001179; migração: $0.001178 | $0.002292 |
| Tempo mediano de resposta para imagens | 2.57 s | Principal: 5.75 s; migração: 6.43 s | 4.51 s |
O custo por tarefa correta é o custo total dividido pelo número de respostas totalmente corretas. Ele inclui o custo das respostas erradas, sem simular novas tentativas. Usamos o consumo retornado pela API com as tarifas fixas Standard, contando o raciocínio nos tokens de saída. O teste separado de chamadas de função não está incluído. Os tempos de resposta são de ponta a ponta pelo gateway; a infraestrutura de inferência não foi mantida constante de forma independente.
Nas seis falhas do Terra anterior, as coordenadas estavam dentro do botão correto, mas o modelo inventou IDs como cobalt-edit em vez de ler o ID impresso do controle. São erros em campos que exigem correspondência exata. As duas gerações calcularam todas as faturas corretamente em medium na execução de migração.
Na rodada principal dos níveis de raciocínio, o novo Terra em none custou $0.024275 para as 24 imagens, com 19/24 corretas, contra $0.027835 em low, com 24/24 corretas. Assim, o custo observado por tarefa com imagem correta foi $0.001278 em none e $0.001160 em low. O menor gasto total em none não resultou no menor custo por acerto neste conjunto.
Vale migrar do GPT-5.6 Terra para o GPT-6.1 Terra?
Vale avaliar o GPT-6.1 Terra como substituto do GPT-5.6 Terra quando o custo de inferência ou a extração exata de campos visuais são relevantes. Na execução pareada em medium, o custo das tarefas com imagens caiu 60.8%, com 24/24 respostas totalmente corretas contra 18/24. As seis diferenças de resultado envolvem IDs impressos de controles; após a correção estatística, a amostra não comprova superioridade geral de qualidade.
A tarifa atual do modelo antigo é $2 de entrada e $12 de saída por milhão de tokens. O novo Terra reduz esses preços em 50% e 58.3%. Aplicando a mesma tarifa de $1/$5 aos dois, o consumo das tarefas com imagens do novo modelo ainda custa 15.6% menos. As contagens de entrada foram semelhantes, 20,765 contra 20,789 tokens; a saída caiu de 2,547 para 1,496 tokens.
Para processamento interno de documentos ou extração de campos com validação, teste o novo modelo no nível de raciocínio já usado e confira IDs e valores exatos antes de migrar. Para interações sensíveis à latência, mantenha o modelo antigo como referência até o novo atender à meta de tempo de resposta da aplicação: nesta execução, a latência mediana das imagens foi de 2.57 segundos no modelo antigo e 6.43 no novo. Para faturas que podem gerar pagamentos, mantenha cálculos determinísticos e verificações de aprovação em qualquer geração.
Qual escolher: GPT-6.1 Terra ou GPT-6.1 Sol?
O GPT-6.1 Terra em medium é o candidato mais barato para essas tarefas visuais bem delimitadas; o GPT-6.1 Sol em low deve continuar na comparação quando o tempo de resposta ou a complexidade do trabalho importam. Na execução principal, ambos acertaram 24/24 imagens, por $0.028290 e $0.055012, respectivamente. A economia observada de 48.6% é explicada pelas tarifas de entrada e saída 50% menores do Terra: recalcular o consumo do Sol a $1/$5 resulta em $0.027506, ligeiramente abaixo dos $0.028290 do Terra.
Para extração em lote com validação, avalie primeiro o Terra em exemplos locais e compare os tipos de erro. Para fluxos interativos, confronte a mediana observada de 4.51 segundos do Sol e a de 5.75 segundos do Terra com a meta real de latência do produto. Programação complexa e projetos com agentes de escopo aberto exigem uma avaliação representativa além desses três modelos de tarefa; o guia de escolha de modelos da OpenAI indica o Sol para trabalhos complexos. As contagens iguais de acertos aqui não demonstram equivalência geral.
Como configurar o nível de raciocínio na API?
No GPT-6.1 Terra, defina reasoning.effort explicitamente e inspecione tanto a resposta quanto o consumo retornado. O guia do GPT-6 informa que medium é o padrão e exige Responses para chamadas de ferramentas. Os tokens de raciocínio consomem o limite de saída e são cobrados dentro dos tokens de saída, sem serem somados uma segunda vez.
Este exemplo em Python mostra um padrão de extração para produção, não uma reprodução do benchmark de cálculos. Instale openai, defina OPENAI_API_KEY e salve a fatura mostrada como invoice.png. Solicite os itens e as regras impressas, deixando campos ausentes como null. A regra aceita aqui aplica o desconto antes do imposto, arredonda para centavos pelo critério de metade para cima e subtrai o adiantamento após o imposto.
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
Também fizemos um teste local separado de chamadas de função para as quatro configurações principais originais (novo Terra em none/low/medium e GPT-6.1 Sol em low): selecionar um controle na captura de tela, ler a seleção efetivamente armazenada e retornar um resultado verificado. As quatro concluíram corretamente a sequência obrigatória de três turnos, totalizando 12 turnos de API. Os resultados das funções usaram IDs de chamada correspondentes e reenviaram os itens de saída. Esse é um teste local de compatibilidade, não um benchmark de uso autônomo do desktop.
Como validar valores de faturas em produção?
Para lançamentos de faturas e pagamentos, extraia os operandos com tipos definidos e calcule os totais em código determinístico. Valide os campos de origem e exija aprovação antes de movimentar dinheiro, independentemente de qual modelo vencer na comparação de custo ou latência.
Execute este bloco após o exemplo de extração. Ele rejeita entradas ausentes ou não aceitas e calcula os totais da fatura mostrada. Centavos inteiros evitam erros de ponto flutuante binário; Decimal aplica a regra de arredondamento de imposto especificada.
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
A saída está pronta para revisão, não para lançamento automático. As verificações de tipos e regras não comprovam que um preço foi lido corretamente: confira os campos extraídos com o documento de origem e revise condições ambíguas antes de aprovar um pagamento. O exemplo de extração é um padrão de implementação; nossas 192 chamadas medidas testaram os prompts de cálculo descritos acima.
Para outras medições, veja nosso guia de cobrança de imagens de entrada, os testes de custo das representações de PDF e a comparação de modelos com o mesmo preço.
Perguntas frequentes
Vale migrar do GPT-5.6 Terra para o GPT-6.1 Terra?
O GPT-6.1 Terra reduziu o custo das tarefas com imagens em 60.8% frente ao GPT-5.6 Terra em medium na nossa execução pareada, ou em 15.6% quando ambos usam $1 de entrada / $5 de saída por milhão de tokens. Os dois acertaram todos os cálculos de faturas; o modelo antigo errou seis IDs impressos de controles. A maior latência mediana observada no modelo novo exige validar o tempo de resposta antes de decidir pela migração.
Qual escolher: GPT-6.1 Terra ou GPT-6.1 Sol?
O GPT-6.1 Terra em medium custou $0.028290 para 24 tarefas com imagens, contra $0.055012 do GPT-6.1 Sol em low, ambos com 24/24 acertos na execução principal. Avalie o Terra para processamento em lote com validação e compare o Sol para uso interativo: os tempos medianos de resposta foram 5.75 e 4.51 segundos, respectivamente. Essas tarefas sintéticas não comprovam equivalência geral de qualidade.
Posso desativar o raciocínio no processamento de faturas?
O GPT-6.1 Terra em none acertou apenas 3/8 imagens de faturas e 0/8 cálculos equivalentes em texto na nossa execução principal. Mantenha os cálculos monetários exatos em código e valide os operandos extraídos. Para tarefas delimitadas de tabelas ou seleção de botões, none acertou 16/16 neste teste e é uma opção a avaliar com a carga de trabalho real.