
Quantos tokens tem um PDF? 4 regras, de 15 a 2,100 por página
Conteúdo
- Como enviar um documento a um modelo?
- Como saber se o modelo realmente leu o arquivo?
- Como cada fornecedor conta os tokens de um PDF enviado como arquivo?
- Quando o texto extraído falha?
- Como pagar menos por documentos?
- O que fazer com um arquivo Word?
- Como medimos
- Perguntas frequentes
- Quantos tokens tem uma página de PDF?
- É mais barato enviar um PDF ou o texto extraído?
- Um LLM consegue ler um PDF digitalizado?
- Quais modelos aceitam arquivos PDF diretamente?
- Como reduzir o custo de um PDF longo?
- Leituras relacionadas
Cada fornecedor tem uma regra de cobrança para PDFs enviados ao modelo como arquivo. GPT-6 conta os tokens do texto e acrescenta cerca de 15 por página. Claude conta o texto e soma 1,558 tokens por página. Gemini cobra 515 tokens por página, sem cobrar pelo texto. Qwen 3.8 soma 2,098 por página aos tokens do texto. Medimos essas regras enviando as mesmas páginas com quantidades crescentes de texto. Depois, enviamos dez documentos a quinze modelos para encontrar a forma mais barata de enviar cada tipo sem perder acertos nas respostas.
TL;DR
- Por página de PDF enviada como arquivo, GPT-6 soma 15 tokens ao texto, Claude 1,558 e Qwen 3.8 2,098. Gemini cobra 515 fixos, sem cobrar o texto.
- O texto extraído acertou 0 de 150 perguntas sobre gráficos e 0 de 105 perguntas sobre um documento digitalizado.
- Escolher a forma de envio página por página reduziu um documento misto de 17,228 para 6,543 tokens no Claude Sonnet 5.5, com acerto nas 12 respostas.
- Enviar 4 páginas selecionadas de um PDF de 120 páginas reduziu a entrada do Claude Sonnet 5.5 de 253,822 para 8,758 tokens.
Como enviar um documento a um modelo?
Há três formas: como arquivo, como imagens das páginas ou como texto extraído previamente.
import base64
import pymupdf  # pip install pymupdf

doc = pymupdf.open("report.pdf")
b64 = lambda data: base64.b64encode(data).decode()   # binary written as text, so it fits in JSON

# 1. As a file. The vendor decides how to read it.
as_file = [{"type": "file", "file": {"filename": "report.pdf",                # OpenAI-compatible chat
            "file_data": "data:application/pdf;base64," + b64(open("report.pdf", "rb").read())}}]
as_document = [{"type": "document", "source": {"type": "base64",              # Anthropic Messages API
                "media_type": "application/pdf", "data": b64(open("report.pdf", "rb").read())}}]

# 2. As page images. You render each page; any model that accepts images takes these.
as_images = [{"type": "image_url", "image_url": {"url": "data:image/jpeg;base64," +
              b64(page.get_pixmap(dpi=72).tobytes("jpeg"))}} for page in doc]

# 3. As text. The text layer is the selectable text stored in a PDF. A scan has none.
as_text = "\n\n".join(page.get_text() for page in doc)
O que cada um dos quinze modelos aceitou no endpoint de chat:
| Modelo | PDF como arquivo | Imagens das páginas | Texto |
|---|---|---|---|
| GPT-6.1 Sol, GPT-6 Luna | sim | sim, até 50 por requisição | sim |
| Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 | sim | sim | sim |
| Gemini 3.1 Pro, Gemini 3.8 Flash | sim | sim | sim |
| Qwen 3.8 Max, Qwen 3.8 Flash | sim | sim | sim |
| Qwen 3.6 35B (pesos abertos), DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 | não | sim | sim |
| GLM 5.3, DeepSeek V4 Pro | não | não | sim |
Todos os modelos com visão aceitam imagens das páginas, inclusive os quatro modelos de pesos abertos, cujos pesos são publicados e que rejeitam o arquivo. No endpoint que usamos, os modelos Gemini aceitaram o PDF como uma data URL em uma parte de imagem; a API do Google aceita o PDF como dados inline.
Como saber se o modelo realmente leu o arquivo?
Pergunte algo que só esteja no arquivo e confira a contagem de tokens de entrada. Uma entrada não suportada pode retornar erro 400 ou ser descartada enquanto o modelo responde mesmo assim. No nosso teste, os dois modelos sem visão ignoraram uma parte de imagem e responderam com 27 e 98 tokens de entrada para um documento de duas páginas. Outro modelo, que recebeu uma URL no lugar do arquivo, respondeu com conteúdo inventado.
r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": as_file + [question]}])
read_it = "MF-OPS-2291" in r.choices[0].message.content   # a string found only in the document
plausible = r.usage.prompt_tokens > 200 * len(doc)        # a dropped file leaves a few dozen tokens
Identificar o tipo de página não exige um modelo. O roteamento descrito mais adiante depende dessa classificação:
def kind(page) -> str:
    if len(page.get_text().strip()) < 40:
        return "scan"        # no text layer: needs OCR or an image
    if page.get_images() or len(page.get_drawings()) > 60:
        return "visual"      # a picture or a chart drawn on the page
    return "text"
Como cada fornecedor conta os tokens de um PDF enviado como arquivo?
São quatro regras diferentes. Criamos PDFs de seis páginas com 0, 80, 250, 500 e cerca de 670 palavras por página, e repetimos o teste com um gráfico em cada página. Enviamos cada versão como arquivo e como texto extraído.
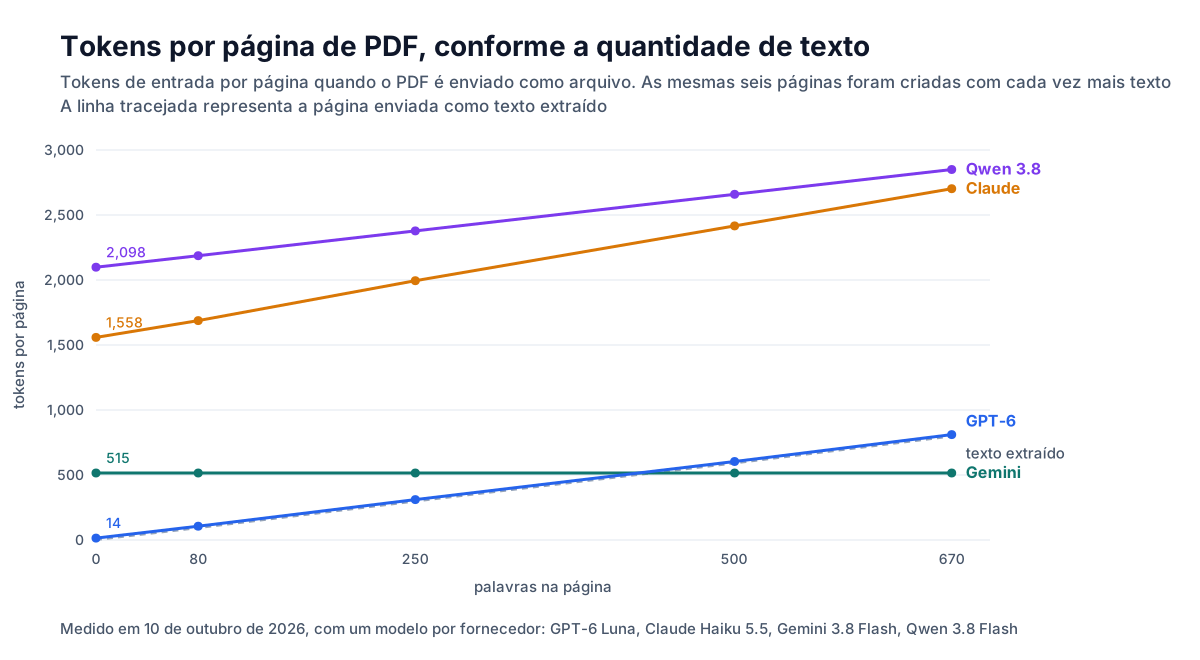
| Fornecedor | Tokens de um PDF enviado como arquivo |
|---|---|
| GPT-6 | Tokens do texto mais 14.5 por página. Uma página com imagem acrescenta cerca de 650 a 1,700 |
| Claude | Tokens do texto mais exatamente 1,558 por página. Um gráfico na página não acrescenta nada |
| Gemini | 515 por página, seja qual for o conteúdo. O texto não entra na conta |
| Qwen 3.8 | Cerca de 0.94 dos tokens do texto mais 2,098 por página. Um gráfico acrescenta cerca de 770 |
Token é a unidade usada para cobrar o uso de um modelo e equivale a aproximadamente três quartos de uma palavra em inglês. Modelos da mesma família apresentaram contagens iguais, com diferenças de poucos tokens.
Duas regras diferem do que os fornecedores publicam, pelo menos na rota que medimos. A documentação do Google diz que uma página custa 258 tokens e que o texto do PDF não é cobrado; medimos 515 por página, com o texto sem cobrança, como informado. A documentação da OpenAI diz que o PDF chega ao modelo como texto extraído e imagens das páginas; aqui, uma página só de texto não teve custo de imagem. A Anthropic diz que cada página é processada como texto e imagem, normalmente com 1,500 a 3,000 tokens, o que bate com a medição.
Consequências dessas regras:
- Páginas com pouco conteúdo saem caras no Claude e no Qwen. Uma página com uma única linha custa 1,558 ou 2,098 tokens como arquivo e cerca de uma dúzia como texto.
- Páginas densas saem baratas no Gemini. Uma página com cerca de 670 palavras custa os mesmos 515 tokens de uma página em branco, enquanto só o texto tem cerca de 800 tokens.
- No GPT-6, o arquivo custa o mesmo que o texto, até aparecer uma imagem. Uma página digitalizada, composta inteiramente por imagem, teve 2,868 tokens.
Um relatório de 12 páginas só de texto, com cerca de 250 palavras por página, totalizou 6,028 tokens como arquivo no GPT-6.1 Sol, 6,441 no Gemini 3.8 Flash, 27,297 no Claude Sonnet 5.5 e 30,934 no Qwen 3.8 Flash. O texto extraído ficou entre 5,924 e 8,716 tokens nos quinze modelos.
Quando o texto extraído falha?
Quando a informação não está na camada de texto. Classificamos cada pergunta pelo tipo de informação necessário para respondê-la e agregamos os resultados dos quinze modelos:
| Forma de envio | Texto corrido | Célula de tabela | Gráfico | Página digitalizada |
|---|---|---|---|---|
| Texto extraído | 297 de 300 | 168 de 170 | 0 de 150 | 0 de 105 |
| OCR, depois texto | 104 de 105 | |||
| PDF como arquivo | 186 de 186 | 103 de 103 | 90 de 90 | 62 de 63 |
| Imagens das páginas, 110 dpi | 258 de 260 | 148 de 148 | 130 de 130 | 89 de 91 |
| Imagens das páginas, 72 dpi | 257 de 260 | 142 de 148 | 130 de 130 | 88 de 91 |
Pontos por polegada (dpi) indicam a resolução de renderização da página; a 72 dpi, uma página no formato US Letter tem 612 por 792 pixels. OCR é reconhecimento óptico de caracteres, um software que lê texto em imagens; usamos o Tesseract, de código aberto, localmente.
O texto extraído não acertou nenhuma pergunta sobre gráficos ou sobre o documento digitalizado, em nenhum modelo, porque os números não estão no texto. O OCR recuperou o relatório digitalizado ao custo de texto, mas não os gráficos: o OCR de uma apresentação de 15 slides com gráficos acertou 0 de 7 nos dois modelos que receberam o resultado. As tabelas sobreviveram à extração porque as nossas eram grades simples. Células mescladas e colunas com texto quebrado em várias linhas são mais difíceis, então teste com as suas.
Como pagar menos por documentos?
Sete formas, seis delas medidas.
1. Escolha a forma de envio com base na regra de contagem. Use texto para páginas que só contêm texto. Nos demais casos, use o arquivo no Gemini e imagens a 72 dpi nos outros modelos, porque o custo de uma imagem de página não depende da quantidade de conteúdo impresso nela. Um formulário denso de 6 páginas do IRS custa 13,635 tokens como texto no Claude Sonnet 5.5, 22,871 como arquivo e 4,015 como imagens a 72 dpi, com acerto nas três perguntas em todas as formas de envio.
2. Escolha a forma de envio página por página. Um documento real mistura tipos de página, e a função kind acima faz essa classificação: páginas de texto são enviadas como texto, páginas com imagem como imagens a 72 dpi e páginas digitalizadas passam por OCR. Em um documento de nove páginas (quatro de texto, três de gráficos e duas digitalizadas), com 12 perguntas:
| Modelo | Como arquivo | Envio escolhido por página | Todas as páginas como imagens a 72 dpi |
|---|---|---|---|
| GPT-6 Luna | 15,106, 12 acertos | 5,140, 12 acertos | 5,750, 9 acertos |
| Claude Sonnet 5.5 | 17,228, 12 acertos | 6,543, 12 acertos | 6,257, 12 acertos |
| Qwen 3.8 Flash | 25,036, 12 acertos | 5,313, 12 acertos | 4,710, 12 acertos |
| Gemini 3.8 Flash | 5,043, 12 acertos | 7,110, 12 acertos | 10,278, 12 acertos |
O roteamento reduziu a entrada em 62% a 79% em comparação com o arquivo em três fornecedores, sem perder nenhum acerto. No Gemini, o arquivo já é a opção mais barata.
3. Reduza a resolução das imagens, mas não nas páginas de texto. Os tokens de uma imagem de página diminuem com a quantidade de pixels, exceto no Gemini, que cobrou o mesmo em todos os tamanhos. Slides de gráficos com rótulos grandes continuaram legíveis a 36 dpi: os seis modelos testados acertaram pelo menos 6 de 7, e os 15 slides custaram 2,874 tokens no Claude Haiku 5.5, contra 23,949 como arquivo. Texto corrido precisou de 72 dpi: a 50 dpi, Claude Haiku 5.5 e Gemini ainda acertaram 7 de 7, mas o GLM 5.3 Flash caiu para 2 de 7. GPT-6 Luna perdeu acertos com imagens de páginas em todas as resoluções abaixo de 96 dpi, então envie o arquivo ou o texto.
4. Na OpenAI, defina detail como low para páginas com imagens. A Responses API aceita um campo detail em arquivos PDF. Com low, GPT-6 Luna leu a apresentação de 15 slides com 9,985 tokens, contra 22,155 na configuração padrão, e o relatório digitalizado com 11,387, contra 34,396 na configuração padrão, acertando todas as respostas. Páginas só de texto não tiveram alteração.
5. Envie apenas as páginas necessárias. Para um manual de 120 páginas, GPT-6 Luna leu o texto extraído (46,420 tokens) e identificou a página necessária para cada uma das quatro perguntas. Claude Sonnet 5.5 respondeu às quatro usando um PDF de 4 páginas com 8,758 tokens. O arquivo inteiro tem 253,822 tokens no Claude, então o custo de entrada caiu de $0.508 para $0.022, incluindo a primeira etapa.
6. Use um modelo barato para transcrever e um grande para raciocinar. Um modelo barato com visão transformou os 15 slides de gráficos em tabelas Markdown por $0.002 a $0.011. Depois, Claude Opus 5.5 acertou as sete perguntas a partir de uma transcrição de cerca de 2,000 tokens por $0.010. O arquivo teria 23,949 tokens e custaria $0.096 de entrada. A transcrição pode ser armazenada e reutilizada em novas perguntas.
7. Coloque o documento em cache e processe em lote o que puder esperar. Com um ponto de cache no PDF (o marcador cache_control na API da Anthropic), seis perguntas ao Claude Sonnet 5.5 custaram $0.117, contra $0.461: a primeira gravou 38,364 tokens no cache, e as cinco seguintes os leram por cerca de $0.004 cada. O processamento em lote foi a única técnica que não medimos. OpenAI, Anthropic e Google anunciam suas APIs de lote pela metade do preço, com resultados em até 24 horas, e a Anthropic informa que o desconto pode ser combinado com cache.
Há um limite de preço para observar: um PDF de 120 páginas ultrapassa 250,000 tokens no Claude, e no Claude Haiku 5.5 um prompt acima de 100,000 tokens custa cinco vezes mais. O texto extraído do mesmo manual tem 68,382 tokens.
O que fazer com um arquivo Word?
Converta. Dos seis modelos que testamos, apenas GPT-6.1 Sol e GPT-6 Luna aceitaram um .docx como arquivo, e leram apenas o texto, como a OpenAI documenta para arquivos que não são PDFs. Converter para Markdown com pandoc basta para texto e tabelas: um contrato de nove páginas ficou com 3,144 tokens, e todos os modelos acertaram 7 de 7. Um memorando com um gráfico incorporado teve 2 de 5 acertos dessa forma e 5 de 5 após a conversão para PDF com LibreOffice, com 1,217 tokens no Gemini 3.8 Flash e 3,827 no Claude Sonnet 5.5.
Como medimos
Dez documentos: sete gerados (um relatório de 12 páginas, 8 páginas de tabelas financeiras, uma apresentação de 15 slides com gráficos, o relatório digitalizado, um manual de 120 páginas, um contrato em Word e um memorando em Word) e três públicos (o artigo “Attention Is All You Need”, o formulário W-9 do IRS e o AI Risk Management Framework do NIST). Cada um tinha de três a sete perguntas com uma única resposta verificável.
Na execução principal, enviamos cada documento, por cada forma de envio, a cada modelo em uma única requisição: 568 requisições em 10 de outubro de 2026, das quais 566 tiveram sucesso (GPT-6 Luna recusou 120 imagens de páginas duas vezes). As regras de contagem e as medições de custo exigiram mais 176 requisições no mesmo dia, usando um modelo de baixo custo por fornecedor. Tudo passou pelo endpoint de chat compatível com OpenAI do gateway Synthorai, exceto o teste de cache (Messages API) e o teste de detail (Responses API). Os valores em dólares usam preços de tabela.
As contagens de tokens são as informadas pelo endpoint nessa rota. Outro provedor do mesmo modelo pode pré-processar os arquivos de forma diferente, então execute o teste de seis páginas na sua própria rota antes de se basear em uma regra. Com três a sete perguntas por documento, acertar tudo mostra que aquela forma de envio permite ler o conteúdo, não prova que não houve perda.
Perguntas frequentes
Quantos tokens tem uma página de PDF?
Depende do fornecedor. Enviada como arquivo, uma página custa os tokens do texto mais cerca de 15 no GPT-6, o texto mais 1,558 no Claude, 515 fixos no Gemini sem cobrar o texto, e cerca de 2,098 mais o texto no Qwen 3.8. Uma página digitalizada teve 2,868 tokens no GPT-6.1 Sol e 1,579 no Claude Sonnet 5.5.
É mais barato enviar um PDF ou o texto extraído?
Para páginas só de texto, o texto extraído custa menos ou o mesmo em todos os modelos, exceto no Gemini, em que uma página densa custa menos tokens como arquivo porque o texto não entra na conta. No GPT-6.1 Sol, o arquivo custa quase o mesmo que o texto. O texto extraído não permite responder a perguntas sobre gráficos ou páginas digitalizadas.
Um LLM consegue ler um PDF digitalizado?
Sim, se receber as páginas como arquivo ou imagens. O texto extraído de um documento digitalizado fica vazio e acertou 0 de 105 no nosso teste. Executar OCR localmente e enviar o resultado gerou 104 de 105 acertos ao custo de texto, a opção mais barata para uma digitalização de texto impresso.
Quais modelos aceitam arquivos PDF diretamente?
No nosso teste, GPT-6.1 Sol, GPT-6 Luna, os três modelos Claude 5.5, Gemini 3.1 Pro, Gemini 3.8 Flash, Qwen 3.8 Max e Qwen 3.8 Flash. DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 e Qwen 3.6 35B aceitaram imagens das páginas, mas não o arquivo.
Como reduzir o custo de um PDF longo?
Envie menos páginas, use a forma mais barata para cada página e reutilize o conteúdo enviado. Um modelo barato selecionando as páginas relevantes reduziu uma requisição de 120 páginas ao Claude Sonnet 5.5 de 253,822 para 8,758 tokens de entrada. O roteamento por tipo de página reduziu a entrada de um documento misto em 62% a 79%. O cache reduziu o custo de seis perguntas sobre um documento de $0.461 para $0.117.
Leituras relacionadas
- Quantos tokens tem uma imagem?: as regras de cobrança de imagens que se aplicam ao envio de imagens das páginas.
- Preços do Claude Haiku 5.5: o limite de 100,000 tokens que um PDF longo ultrapassa.
- Custo de gravação no prompt cache: quanto custa a primeira requisição de um documento armazenado em cache.