
GPT-6 Luna vs GPT-5.6 Luna: metade do preço e das palavras
Conteúdo
- Como se comparam GPT-6 Luna e GPT-5.6 Luna nos benchmarks?
- O que mudou além do preço?
- Como fizemos o teste?
- GPT-6 Luna escreve menos do que GPT-5.6 Luna?
- GPT-6 Luna deixa informação de fora?
- O que faz regressar o comprimento e os detalhes?
- Quanto se poupa com GPT-6 Luna face a GPT-5.6 Luna?
- Os nossos resultados coincidem com outros testes publicados?
- O que observámos e qual modelo escolher?
- Perguntas frequentes
O GPT-6 Luna empata com o GPT-5.6 Luna nos benchmarks públicos (38 contra 37 no Artificial Analysis Intelligence Index) e custa cerca de metade por tarefa. A diferença está no texto que produz: quando o prompt define apenas um objetivo (“escreva a análise do T3”), GPT-6 Luna escreveu 0.55x as palavras em 80 documentos empresariais. Não deixou de fora partes pedidas explicitamente. Quando o prompt indicava as partes obrigatórias, os dois modelos tiveram o mesmo nível de completude. Nos prompts só com o objetivo, o único detalhe que GPT-6 Luna omitiu mais vezes foi a duração de um incidente.
TL;DR
- O Artificial Analysis atribui 38 ao GPT-6 Luna e 37 ao GPT-5.6 Luna com esforço
max, a $0.07 contra $0.18 por tarefa. - Nos prompts só com o objetivo, GPT-6 Luna escreveu 384 palavras por documento, contra 703 do GPT-5.6 Luna.
- GPT-6 Luna omitiu a duração do incidente em 9 de 20 análises pós-incidente com prompts só com o objetivo; GPT-5.6 Luna omitiu-a em 2.
- Com as partes obrigatórias indicadas, GPT-6 Luna entregou documentos completos em 74 de 80 casos, contra 69, a $0.81 contra $1.61 por 1.000.
Como se comparam GPT-6 Luna e GPT-5.6 Luna nos benchmarks?
O GPT-6 Luna iguala o GPT-5.6 Luna nos benchmarks gerais com um custo por tarefa 48% a 61% inferior. A diferença entre os dois só aparece em documentos avaliados segundo uma rubrica (uma lista de critérios de pontuação). As pontuações correspondem a um nível de esforço de raciocínio, a definição da API que controla quanto o modelo raciocina antes de responder (none a max, com medium por defeito). Os valores foram consultados nas páginas dos responsáveis pelos benchmarks em 2026-10-02.
| GPT-6 Luna | GPT-5.6 Luna | |
|---|---|---|
| Lançamento | 2026-09-22 | 2026-07-09 |
| Preço de tabela, input / output por 1M tokens | $0.10 / $0.50 | $0.20 / $1.20 |
| Artificial Analysis Intelligence Index v4.3.2 em max (10 avaliações: conhecimento, raciocínio, programação, tarefas de agentes e documentos empresariais) | 38 | 37 |
| Custo por tarefa do índice | $0.07 | $0.18 |
| Vals Index (programação, direito, fiscalidade, finanças e outras tarefas profissionais) | 51.2% | 51.7% |
| Custo por teste Vals | $0.43 | $0.82 |
| GDPval-AA v2.1 Elo em max (documentos empresariais avaliados segundo uma rubrica oculta; Elo é uma pontuação baseada em comparações diretas, em que um valor mais alto é melhor) | 1438 | 1463 |
| GDPval-AA v2.1 Elo em medium | 1262 | 1133 |
| Velocidade de output, tokens por segundo | 131 | 124 |
Foi no GDPval-AA que surgiu a crítica ao GPT-6 Luna. Na análise do lançamento, o Artificial Analysis colocou GPT-6 Luna cerca de 75 pontos Elo abaixo de GPT-5.6 Luna no GDPval-AA e cerca de 45 abaixo no AA-Briefcase v1.1, outro benchmark de documentos. Atribuiu a diferença à “menor qualidade de apresentação e a entregáveis que omitem elementos da rubrica”; os avaliadores chamaram-lhe “format tax”. A tabela de classificação mostra agora uma diferença de 25 pontos em max; em medium, GPT-6 Luna está 129 pontos à frente.
Entre modelos de outros fornecedores, GPT-6 Luna concorre com a gama flash, de baixo preço e alta velocidade. No mesmo índice, DeepSeek V4.1 Flash em max obtém 39 a $0.27 por tarefa e Gemini 3.8 Flash em high obtém 41 a $1.24. GPT-6 Luna fica 1 a 3 pontos abaixo, mas custa 4 a 18 vezes menos por tarefa. Ambos geram mais depressa, a 209 e 249 tokens por segundo.
O que mudou além do preço?
O GPT-6 Luna mantém os limites e as definições do GPT-5.6 Luna; só mudaram o preço da cache e a data-limite do conhecimento. Ambos têm uma janela de contexto de 1,050,000 tokens e um limite de output de 128,000 tokens. Quando o prompt ultrapassa 272K tokens, todo o pedido passa a ser cobrado a 2x no input e 1.5x no output. O input em cache custa $0.01 por milhão de tokens, em vez de $0.02, e a data-limite do conhecimento passou de 16 de fevereiro para 18 de maio de 2026. Na Responses API, o esforço define-se com reasoning.effort (none, low, medium, high, xhigh, max). O raciocínio não é apresentado na resposta e é cobrado como tokens de output.
Uma semana após o lançamento, a OpenAI lançou o GPT-6.1 Sol para substituir o GPT-6 Sol na gama superior. As nossas medições do GPT-6.1 Sol mostraram que as respostas voltaram ao comprimento anterior. Luna não recebeu nenhuma atualização. Por isso, medimos o que GPT-6 Luna escreve de forma mais curta, o que omite e o que faz o comprimento voltar ao normal.
Como fizemos o teste?
Criámos tarefas de escrita cujos requisitos podem ser verificados por código, sem recorrer a um modelo avaliador. Cada tarefa fornece ao modelo um bloco de dados sintéticos e pede um documento baseado nesses dados:
| Documento | Dados | O que o leitor espera encontrar |
|---|---|---|
| Análise trimestral | receitas de 6 a 12 regiões | todas as regiões abrangidas e identificação da região com a maior queda |
| Análise pós-incidente | 7 a 10 eventos com hora registada | todos os eventos e a duração do incidente |
| Comparação de fornecedores | 5 a 8 propostas de alojamento | todos os fornecedores abrangidos |
| Respostas a clientes | 6 a 14 tickets de suporte | resposta a todos os tickets, dirigida ao cliente pelo nome |
Cada tarefa usa os mesmos dados em dois tipos de prompt. O prompt só com o objetivo diz qual é o documento, sem especificar as suas partes (“Escreva a análise regional do T3 para a direção”), e só é avaliado pelos itens da tabela. O prompt com as partes indicadas enumera secções, quantidades e intervalos de palavras, e é avaliado por todos esses requisitos. Um documento é considerado completo se não faltar nada do que foi pedido, se nenhuma parte for demasiado curta e se todas as quantidades forem cumpridas. Nas comparações de fornecedores com prompts só com o objetivo, avaliamos apenas o comprimento, porque a escolha do fornecedor certo exige julgamento.
Em 2026-10-02, executámos os 80 itens só com o objetivo em ambos os modelos com cinco níveis de esforço e no GPT-6 Luna com uma definição de verbosity. Executámos também os 80 itens com as partes indicadas em ambos os modelos, com o esforço por defeito: 1,040 chamadas à Responses API. Cada prompt continha uma string aleatória única para impedir respostas vindas de cache, e os custos usam os preços de tabela da OpenAI. Os dois modelos responderam aos mesmos itens. Para os comparar, usámos o teste exato de McNemar (um teste emparelhado aplicado aos itens em que os modelos divergem) e a correção de Holm, que torna o limiar mais rigoroso quando se testam várias comparações. Só tratamos como diferenças as que resistem à correção.
GPT-6 Luna escreve menos do que GPT-5.6 Luna?
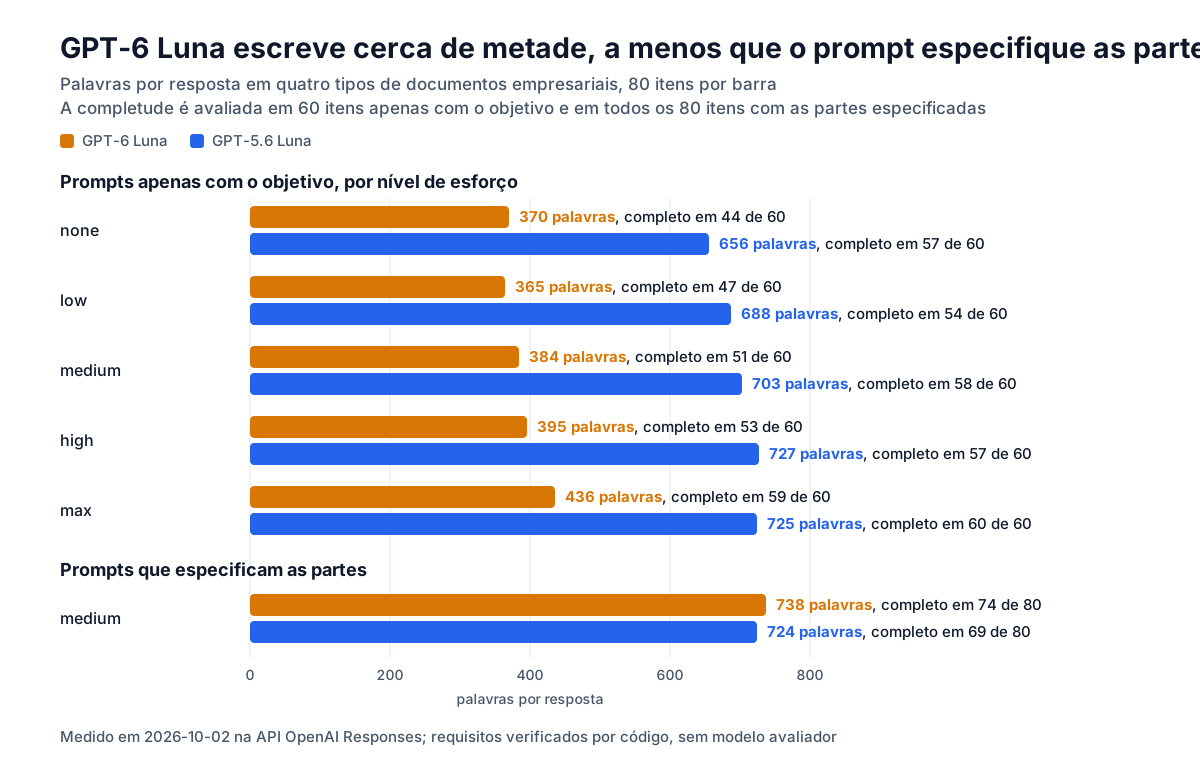
Com o esforço por defeito, o GPT-6 Luna escreveu 0.55x as palavras do GPT-5.6 Luna nos prompts só com o objetivo: 384 palavras por documento contra 703. Foi mais curto nos 80 itens e em todos os tipos de documento. A maior diferença surgiu nas análises pós-incidente (441 contra 981 palavras) e a menor nas respostas a clientes (576 contra 767).
Com as partes indicadas, a diferença desaparece: 738 palavras contra 724.
Este comportamento por defeito não é exclusivo de Luna. Nos mesmos itens, GPT-6 Sol escreveu 325 palavras contra 592 de GPT-5.6 Sol, e GPT-6.1 Sol voltou às 565.
GPT-6 Luna deixa informação de fora?
Nos prompts só com o objetivo, o GPT-6 Luna omitiu um elemento mais vezes do que o GPT-5.6 Luna: a duração do incidente numa análise pós-incidente. Em geral, indicava o intervalo horário (“Período do incidente: 18:00-18:39 UTC”) e deixava ao leitor o cálculo da duração. Todos os outros elementos estavam presentes em todos os níveis de esforço: todas as regiões e a de pior desempenho, todos os eventos e uma resposta dirigida pelo nome para cada ticket, com uma única exceção em none.
| Prompts só com o objetivo | GPT-6 Luna completos | Análises pós-incidente de GPT-6 Luna sem duração | GPT-5.6 Luna completos | Análises pós-incidente de GPT-5.6 Luna sem duração |
|---|---|---|---|---|
none | 44 / 60 | 15 / 20 | 57 / 60 | 3 / 20 |
low | 47 / 60 | 13 / 20 | 54 / 60 | 6 / 20 |
medium | 51 / 60 | 9 / 20 | 58 / 60 | 2 / 20 |
high | 53 / 60 | 7 / 20 | 57 / 60 | 3 / 20 |
max | 59 / 60 | 1 / 20 | 60 / 60 | 0 / 20 |
A diferença em none (44 contra 57) resiste à correção. Em medium (51 contra 58), só é significativa antes da correção, pelo que indica uma tendência. Em max, os dois empatam. Toda a diferença vem de um único tipo de documento: mostra que GPT-6 Luna pode omitir um valor calculado numa análise pós-incidente, não que tenha uma tendência geral para omitir conteúdo.
Com as partes indicadas, GPT-6 Luna entregou 74 documentos completos em 80 e GPT-5.6 Luna, 69: um empate. Todas as falhas dos dois modelos foram memorandos ou parágrafos de impacto abaixo do intervalo de palavras pedido: 6 no GPT-6 Luna e 11 no GPT-5.6 Luna.
O que faz regressar o comprimento e os detalhes?
Indicar as partes no prompt funciona; os dois parâmetros do pedido, não. Com o mesmo nível de esforço, o GPT-6 Luna passou de 384 para 738 palavras e indicou a duração em todas as análises pós-incidente quando o prompt a pediu. Basta um pedido como este:
Write the postmortem with these sections: Timeline (a table with every event),
Impact (120-200 words, state the total duration in minutes), Root Cause,
Action Items (5, each ending "Owner: <team>"), Lessons Learned (at least 3 bullets).
text.verbosity é um parâmetro da Responses API (low, medium, high) que controla o comprimento e o detalhe da resposta visível. Em high, os documentos do GPT-6 Luna com prompts só com o objetivo ficaram 7% mais longos (410 palavras), mas a completude manteve-se praticamente igual: 52 de 60 contra 51.
Aumentar reasoning.effort altera mais o quanto o modelo raciocina do que o quanto escreve. De none para max, os documentos do GPT-6 Luna passaram de 370 para 436 palavras, enquanto o raciocínio passou de 0 para 4,192 tokens por resposta. max recuperou a duração (em falta em 1 de 20), mas custou 4.5 vezes mais do que medium.
Os dois parâmetros com o SDK Python da OpenAI:
from openai import OpenAI

client = OpenAI()
prompt = "Write the postmortem with these sections: ..."  # data and required parts
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "medium"},   # none, low, medium (default), high, xhigh, max
    text={"verbosity": "high"},       # 7% longer in our runs; did not change completeness
    input=prompt,
)
print(resp.output_text)
usage = resp.usage
print(usage.output_tokens, usage.output_tokens_details.reasoning_tokens)
output_tokens inclui os tokens de raciocínio. O número de tokens da resposta visível é a diferença entre os dois valores.
Quanto se poupa com GPT-6 Luna face a GPT-5.6 Luna?
Para o mesmo documento, o GPT-6 Luna custou 49% menos do que o GPT-5.6 Luna: $0.81 contra $1.61 por 1.000 documentos com as partes indicadas. Só a redução dos preços teria produzido uma poupança maior. Os tokens do GPT-5.6 Luna, cobrados aos preços do GPT-6 Luna, custariam $0.68, menos 58%. As respostas do GPT-6 Luna custaram mais 20% do que esse valor porque usou o dobro dos tokens de raciocínio (537 por resposta contra 271) e o output total passou de 1,284 para 1,558 tokens.
Nos prompts só com o objetivo, o custo parece mais favorável: $0.54 contra $1.66 por 1.000 documentos (menos 68%). Mas a maior parte da poupança adicional vem do facto de GPT-6 Luna escrever metade. Só é uma poupança se a outra metade não fizer falta.
A velocidade é semelhante. GPT-6 Luna gerou 115 tokens de output por segundo de duração total do pedido, contra 125. Um documento com prompt só com o objetivo demorou uma mediana de 8.1 segundos, contra 11.1, porque havia menos texto para escrever.
Os nossos resultados coincidem com outros testes publicados?
Os nossos resultados estão alinhados com os benchmarks públicos nos pontos comparáveis. Acrescentam o que fica mais curto, o que falta e como resolver.
| Questão | Resultados publicados por outros | A nossa medição | Conclusão |
|---|---|---|---|
| Capacidade geral, GPT-6 Luna contra GPT-5.6 Luna | Artificial Analysis: 38 contra 37; Vals: 51.2% contra 51.7% | 74 documentos completos contra 69 de 80 com as partes indicadas, um empate | Coincide: desempenho equivalente |
| Qualidade dos documentos | GDPval-AA v2.1 Elo: 25 pontos abaixo em max, 129 acima em medium | em medium, 0.55x as palavras nos prompts só com o objetivo; duração do incidente em falta em 9 de 20 análises pós-incidente, contra 2 | Misto: nenhum dos testes mostra uma perda clara com o esforço por defeito; o nosso mostra respostas mais curtas e o elemento afetado |
| Tokens de output | 51K contra 41K por tarefa do índice em max, mais 24% | 1,558 contra 1,284 por documento em medium, mais 21% | Coincide |
| Custo | menos 61% por tarefa do índice; menos 48% por teste Vals | menos 49% com as partes indicadas, menos 68% nos prompts só com o objetivo | Coincide |
O que observámos e qual modelo escolher?
Use o GPT-6 Luna sempre que controlar o prompt e indique as partes necessárias. Mantenha o GPT-5.6 Luna apenas quando não puder alterar os prompts e os leitores esperarem documentos longos. Há três razões:
- GPT-6 Luna ajusta o texto ao pedido. Um objetivo produz um documento curto; uma lista de partes produz um documento completo, com comprimento semelhante ao do GPT-5.6 Luna.
- As omissões são específicas. Nos quatro tipos de documento, o único elemento esperado que faltou mais vezes foi a duração do incidente.
- A poupança vem da redução do preço. Para o mesmo documento, usa mais 21% de tokens de output. Por isso, a poupança de 49% fica abaixo dos 58% que os preços de tabela, por si só, permitiriam.
| Tipo de trabalho | Escolha | Números |
|---|---|---|
| Output lido por software: classificação, extração, encaminhamento | GPT-6 Luna com o menor esforço que mantenha a precisão necessária | preços de tabela 50% inferiores no input e 58% no output; o comprimento da resposta não importa quando é um programa a lê-la |
| Documentos gerados a partir de um template ou de um prompt que escreve | GPT-6 Luna com secções, quantidades e comprimentos definidos no prompt | 74 documentos completos em 80 contra 69; $0.81 contra $1.61 por 1.000 |
| Documentos gerados a partir de prompts de utilizadores finais que não pode editar | GPT-6 Luna se puder acrescentar as partes esperadas ao pedido; caso contrário, GPT-5.6 Luna | só com o objetivo: 384 contra 703 palavras; duração em falta em 9 de 20 análises pós-incidente, contra 2 |
| Entregáveis avaliados por rubrica | Inclua a rubrica no prompt; não dependa de text.verbosity | verbosity high: 52 contra 51 de 60, mais 7% de palavras |
Nos documentos enviados a clientes, verifique por código os elementos obrigatórios antes do envio, independentemente do modelo usado.
Perguntas frequentes
GPT-6 Luna é pior do que GPT-5.6 Luna? O GPT-6 Luna teve o mesmo nível de completude que o GPT-5.6 Luna quando o prompt indicava as partes obrigatórias (74 contra 69 documentos em 80, um empate), a metade do custo. Quando o prompt só define um objetivo, escreve cerca de metade e omite mais vezes a duração do incidente nas análises pós-incidente.
text.verbosity: "high" faz GPT-6 Luna escrever tanto como GPT-5.6 Luna?
text.verbosity: "high" acrescentou 7% de palavras às respostas do GPT-6 Luna nos nossos testes. Ainda assim, ficaram com cerca de 58% do comprimento das respostas do GPT-5.6 Luna, sem alteração na completude. Indicar as partes no prompt levou as respostas ao mesmo comprimento.
GPT-6.1 resolveu as respostas curtas de GPT-6 Luna? A atualização 6.1 da OpenAI abrange apenas a gama Sol: o GPT-6.1 Sol voltou a escrever respostas com o comprimento das do GPT-5.6 Sol. O GPT-6 Luna não mudou desde o lançamento em 2026-09-22.
Medições relacionadas: GPT-6.1 Sol vs Claude Sonnet 5.5, comparação de LLMs da gama flash e formas de reduzir o custo do GPT-5.6.