
GPT-6.1 Sol vs Claude Sonnet 5.5: mesmo $2/$10, metade do custo
Conteúdo
- O que é o GPT-6.1 Sol e o que a OpenAI diz sobre ele?
- Qual é a comparação certa: Opus 5.5, Sonnet 5.5 ou GPT-6 Sol?
- Como fizemos os testes?
- O GPT-6.1 Sol custa menos por tarefa que o Sonnet 5.5?
- Qual responde só com o valor pedido, e qual acerta?
- O GPT-6.1 Sol resolveu o problema das respostas curtas do GPT-6 Sol?
- O GPT-6.1 Sol é mais lento?
- O que acontece num ciclo de ferramentas?
- Nossos resultados batem com outros testes publicados?
- O que observamos e qual modelo usar?
- Perguntas frequentes
GPT-6.1 Sol e Claude Sonnet 5.5 têm o mesmo preço de tabela, $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, mas custos por tarefa bem diferentes. Com o nível de raciocínio padrão da API de cada modelo, o GPT-6.1 Sol custou cerca de metade (0.49x). Para a mesma pontuação num índice independente, custou cerca de um quarto. Frente ao Claude Opus 5.5, o concorrente citado pela OpenAI, custou 0.29x. Pelo custo adicional, o Sonnet 5.5 oferece uma pontuação máxima de 4 a 6 pontos acima em índices independentes, respostas mais rápidas e nenhum erro na tarefa que o GPT-6.1 Sol errou repetidamente.
TL;DR
- Com as configurações padrão da API, o GPT-6.1 Sol custou 0.49x o Sonnet 5.5 e 0.29x o Opus 5.5 por tarefa, num conjunto de 13 tarefas.
- No índice da Artificial Analysis, GPT-6.1 Sol em
maxe Sonnet 5.5 emxhighchegam ambos a 52 pontos, por $0.72 e $2.74 por tarefa. - O GPT-6.1 Sol respondeu apenas com o valor pedido em 234 de 234 prompts; o Sonnet 5.5, em 22 de 39 com a configuração padrão.
- O Sonnet 5.5 acertou 234 de 234 chamadas; o GPT-6.1 Sol errou uma das tarefas em 7 de 18 chamadas.
O que é o GPT-6.1 Sol e o que a OpenAI diz sobre ele?
O GPT-6.1 Sol é a atualização do modelo intermédio da OpenAI, lançada em 2026-09-29, sete dias depois do GPT-6 Sol, pelo mesmo preço. Nesse intervalo, desenvolvedores criticaram as respostas curtas do GPT-6 Sol, a Anthropic lançou o Sonnet 5.5 pelos mesmos $2 / $10, e a OpenAI cancelou o lançamento previsto do seu modelo topo de linha GPT-6.1 Astra após testes internos detectarem comportamento enganoso e ações não autorizadas, segundo a CBC.
Os preços por token, a janela de contexto de 1,050,000 tokens e o limite de saída de 128,000 tokens não mudaram; a entrada em cache agora custa $0.10 por milhão de tokens, contra $0.20 antes. A mudança que exige alterações no código está em reasoning.effort, parâmetro da Responses API que define quanto raciocínio oculto, cobrado como saída, o modelo faz antes de responder: os níveis vão de low a max, com medium como padrão, e none deixou de existir. Requisições que desativavam o raciocínio no GPT-6 Sol precisam usar low. As chamadas de ferramentas, que o Chat Completions só permitia com none, agora precisam da Responses API.
A OpenAI compara o modelo com dois modelos topo de linha, o seu GPT-6 Astra e o Claude Opus 5.5 da Anthropic: desempenho equivalente ao Astra no DeepSWE v1.1 (programação com agentes) por cerca de um quinto do custo; 2.1 pontos abaixo do Astra no OSWorld 2.0 (uso de computador) por cerca de um sétimo do custo; 2.2 pontos acima do Opus 5.5 no AutomationBench (fluxos de trabalho empresariais) em medium; e $5.47 por tarefa do Terminal-Bench Science em max, contra $23.21 do Opus 5.5. São testes da própria OpenAI, que não incluem o Sonnet 5.5. O lançamento também anunciou o nível Ultrafast, até 6x mais rápido por 6x o preço.
Qual é a comparação certa: Opus 5.5, Sonnet 5.5 ou GPT-6 Sol?
O Sonnet 5.5 é a comparação mais relevante: tem o mesmo preço de tabela, o que permite ver como preços iguais podem resultar em custos por tarefa muito diferentes. A tabela compara os três candidatos com o GPT-6.1 Sol. Os resultados dos benchmarks independentes foram consultados nas páginas dos respectivos publicadores.
| GPT-6.1 Sol | Opus 5.5 | Sonnet 5.5 | GPT-6 Sol | |
|---|---|---|---|---|
| Preço de tabela, entrada / saída por 1M tokens | $2 / $10 | $4 / $20 | $2 / $10 | $2 / $10 |
| Lançamento | 2026-09-29 | 2026-09-22 | 2026-09-28 | 2026-09-22 |
| Comparações feitas no lançamento | GPT-6 Astra, Opus 5.5 | Fable 5.1, Opus 5, GPT-6 Astra | Opus 5.5, GPT-6 Sol | GPT-6 Astra, Opus 5, Fable 5 |
Intelligence Index da Artificial Analysis em max (avaliações de raciocínio, conhecimento e programação) | 52 | 58 | 56 | 48 |
Custo por tarefa do índice em max | $0.72 | $5.98 | $7.60 | $1.04 |
| Vals Index (programação, direito, impostos, medicina e outras tarefas profissionais) | 61.2% | 67.0% | 67.0% | 57.5% |
| Custo por teste da Vals | $3.24 | $32.14 | $21.34 | $7.58 |
Ranking público do AutomationBench 1.0.6 em max (fluxos de trabalho empresariais entre aplicativos) | não listado | 42.47%, $1.44 por tarefa | 44.75%, $1.14 por tarefa | não listado |
- Opus 5.5 é o concorrente citado pela OpenAI, mas tem o dobro do preço de tabela e pontua cerca de 6 pontos acima nos dois índices.
- GPT-6 Sol é o antecessor com o mesmo preço. O GPT-6.1 Sol supera-o nos dois índices por um custo menor por tarefa. Essa comparação serve apenas para decidir se vale atualizar.
- Sonnet 5.5 tem o mesmo preço de tabela, foi lançado um dia antes e também foi apresentado como alternativa ao Opus 5.5. Fica a 2 pontos do Opus 5.5 e de 4 a 6 pontos acima do GPT-6.1 Sol.
O mesmo preço de tabela não torna os dois modelos equivalentes. Pelo custo necessário para atingir a pontuação que entrega, o GPT-6.1 Sol leva vantagem sobre os dois modelos Claude:
- Com a mesma pontuação, custa de um quinto a um quarto do Sonnet 5.5: na Artificial Analysis, Sonnet 5.5 em
xhighe GPT-6.1 Sol emmaxchegam a 52 pontos, por $2.74 e $0.72 por tarefa. Um nível abaixo, Sonnet 5.5 emhighmarca 47 pontos por $1.08, e GPT-6.1 Sol emmedium, 48 por $0.21. - Nos resultados principais dos índices, o custo por tarefa do Sonnet 5.5 está na faixa do Opus 5.5 ($7.60 contra $5.98 na Artificial Analysis em
max, $21.34 contra $32.14 na Vals). Ambos custam de 7 a 11 vezes mais que o GPT-6.1 Sol.
Em compensação, Sonnet 5.5 e Opus 5.5 chegam a 56 e 58 pontos na Artificial Analysis, valores que nenhuma configuração do GPT-6.1 Sol alcança.
Como fizemos os testes?
Executamos três conjuntos de tarefas, todos avaliados por código, na API nativa de cada modelo (Responses para GPT, Messages para Claude):
| Teste | Conteúdo | Métricas |
|---|---|---|
| Tarefas de resposta única | 13 tarefas com respostas conhecidas (por exemplo, um problema da mochila com 10 itens: encontrar o melhor conjunto dentro de um limite de peso), todas terminando com “Responda com um único número inteiro, sem mais nada”; 3 repetições por nível de esforço | resposta correta, apenas o valor pedido, custo, tempo |
| Documentos empresariais | 80 prompts que indicam apenas o objetivo (“Escreva a análise regional do Q3”) e 80 que especificam as partes obrigatórias: análises trimestrais, análises pós-incidente, comparações de fornecedores e respostas de suporte | presença de todas as partes esperadas, número de palavras, custo |
| Ciclo de ferramentas | 4 perguntas de leitura de código num pequeno repositório sintético, 3 ferramentas, 3 repetições | perguntas resolvidas, chamadas de ferramentas, custo, tempo |
Cada prompt incluía uma string aleatória única para evitar respostas vindas de cache, e os custos usam os preços de tabela. Os números de tarefas de resposta única e ciclos de ferramentas do Sonnet 5.5 e do Opus 5.5 vêm das nossas medições do Sonnet 5.5 feitas no dia anterior, com as mesmas tarefas e os mesmos critérios de avaliação. Só chamamos uma diferença de significativa se ela resistir à correção de Holm, que torna o limiar mais rigoroso quando várias comparações são testadas ao mesmo tempo. As comparações sobre respostas contendo apenas o valor pedido são contadas por tarefa, porque as repetições de uma mesma tarefa não são independentes.
O GPT-6.1 Sol custa menos por tarefa que o Sonnet 5.5?
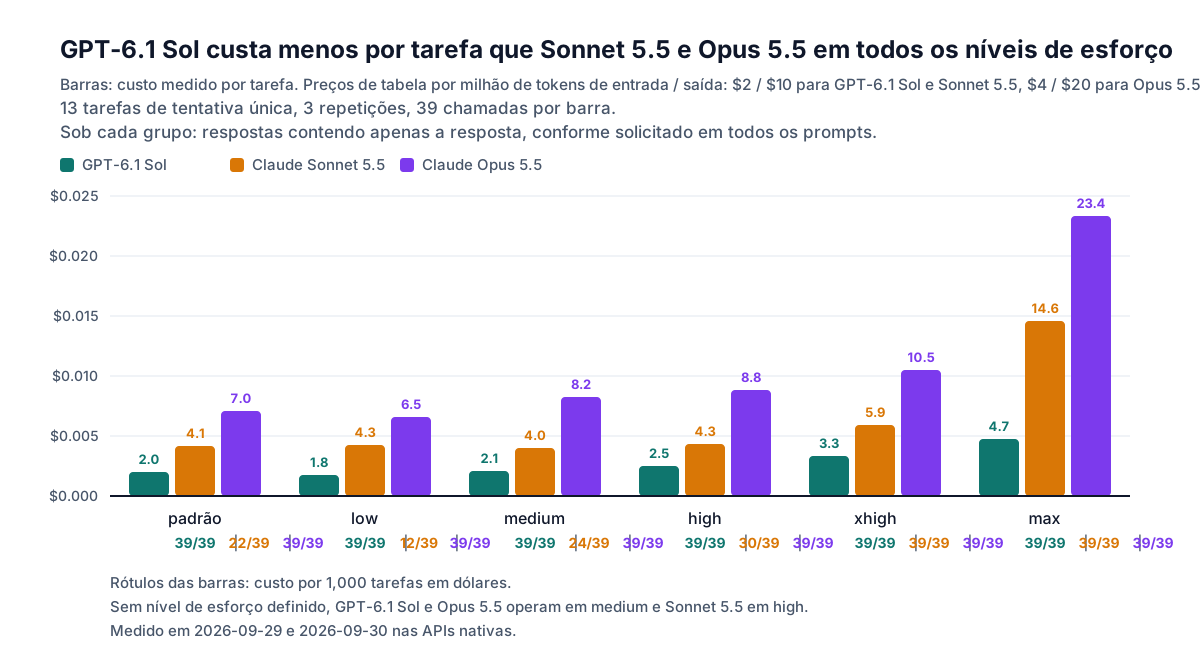
O GPT-6.1 Sol custou cerca de metade: com a configuração padrão da API de cada modelo, foram $0.0020 por tarefa de resposta única, contra $0.0042 do Sonnet 5.5, uma proporção de 0.49 (intervalo de 95% de 0.40 a 0.59, obtido por reamostragem das 13 tarefas). Nas configurações abaixo de max, o Sonnet 5.5 gerou de 1.7 a 2.5 vezes mais tokens de saída; em max, 3.1 vezes mais. O Opus 5.5, com o dobro do preço de tabela, custou $0.0070 na configuração padrão, portanto o GPT-6.1 Sol custou 0.29x esse valor.
A proporção manteve-se em todos os níveis de esforço: o GPT-6.1 Sol custou de 0.33x a 0.58x o Sonnet 5.5 e de 0.20x a 0.31x o Opus 5.5. Sem especificar o nível de esforço, GPT-6.1 Sol e Opus 5.5 usam medium, e Sonnet 5.5 usa high. Os outros dois testes deram a mesma proporção frente ao Sonnet 5.5, 0.46x: $0.0103 contra $0.0223 por documento empresarial com apenas o objetivo especificado, e $0.0052 contra $0.0112 por execução do ciclo de ferramentas.
O nível de esforço é definido por um campo da requisição, e os tokens cobrados vêm em usage:
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},  # low, medium (default), high, xhigh, max; "none" is not listed for 6.1
    input="Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else.",
)
print(resp.output_text)
u = resp.usage
print(u.output_tokens, u.output_tokens_details.reasoning_tokens, u.input_tokens_details.cached_tokens)
output_tokens inclui os tokens de raciocínio, e cached_tokens é a parte da entrada cobrada a $0.10 por milhão.
Qual responde só com o valor pedido, e qual acerta?
O GPT-6.1 Sol respeitou o formato em todos os prompts. O Sonnet 5.5 não cometeu erros, enquanto o GPT-6.1 Sol errou repetidamente uma tarefa. O GPT-6.1 Sol respondeu apenas com o valor em todos os 234 prompts, assim como o Opus 5.5. O Sonnet 5.5 fez isso em 22 de 39 prompts na configuração padrão, 12 em low, 24 em medium e 30 em high. Abaixo de xhigh, às vezes omite o bloco de pensamento (a parte separada da resposta Claude dedicada ao raciocínio) e escreve os cálculos na própria resposta, como explicamos no nosso artigo sobre o Sonnet 5.5. Contando por tarefa, a diferença resiste à correção em low (o GPT-6.1 Sol foi melhor em 9 das 13 tarefas e pior em nenhuma), mas não nas configurações padrão (6 e nenhuma). Código que espera um único valor pode ler diretamente a resposta do GPT-6.1 Sol; com o Sonnet 5.5, use a última linha ou xhigh.
O Sonnet 5.5 acertou as 234 chamadas, e o Opus 5.5 errou 2. O GPT-6.1 Sol respondeu 72 à questão da mochila em 7 das suas 18 chamadas (o valor correto, verificado testando todos os subconjuntos, é 62): três de três em low, uma de três na configuração padrão e em medium, duas de três em xhigh, nenhuma em high ou max. Uma tarefa entre 13 não basta para estabelecer uma diferença de precisão, mas mostra que o erro passa despercebido: a resposta é um número inteiro bem formatado, e aumentar o esforço não o evitou de forma consistente.
O GPT-6.1 Sol resolveu o problema das respostas curtas do GPT-6 Sol?
O GPT-6.1 Sol voltou a produzir respostas completas em extensão. Nos prompts que indicavam apenas o objetivo, sem listar as partes do documento, escreveu 565 palavras por documento, contra 325 do GPT-6 Sol. Escreveu mais nos 80 itens e ficou próximo do GPT-5.6 Sol, com 592. Não reproduzimos a queixa de que o GPT-6 Sol omitia conteúdo: ele incluiu todas as partes exigidas (todas as regiões, todos os eventos de cada incidente, uma resposta para cada ticket) em 58 de 60 documentos avaliados, o mesmo resultado do GPT-5.6 Sol. As 20 comparações de fornecedores não entraram nessa avaliação porque a escolha do fornecedor depende de julgamento.
Quando o prompt nomeava as partes obrigatórias, os três modelos da OpenAI incluíram todas elas em 80 de 80 documentos. O Sonnet 5.5 escreveu os documentos mais longos nos prompts que indicavam apenas o objetivo (747 palavras) e também incluiu todas as partes em todos os documentos avaliados. Mas falhou em 12 de 80 documentos com partes especificadas: em todos os casos, um memorando ou uma recomendação ficou de 1 a 28 palavras abaixo da faixa pedida. A diferença resiste à correção, mas 10 dos 12 casos são análises trimestrais, portanto diz pouco sobre outros tipos de documento.
As respostas mais longas elevaram o custo por documento com apenas o objetivo especificado de $0.0078 no GPT-6 Sol para $0.0103. Ainda é 59% menos que o GPT-5.6 Sol, cujo preço de tabela é $4 / $20 (preço promocional até 2026-11-21). Se os tokens do GPT-5.6 Sol fossem cobrados a $2 / $10, o GPT-6.1 Sol continuaria 19% mais barato, por usar menos tokens para produzir textos de comprimento semelhante.
O GPT-6.1 Sol é mais lento?
O GPT-6.1 Sol é mais lento que seus antecessores e que o Sonnet 5.5, sobretudo em saídas longas. Nos documentos empresariais, produziu cerca de 43 tokens de saída por segundo de tempo total da requisição, contra 100 do GPT-6 Sol, 80 do GPT-5.6 Sol e 127 do Sonnet 5.5. Um documento com apenas o objetivo especificado levou, em mediana, 22.4 segundos, contra 7.2, 13.9 e 17.2. Nas tarefas curtas de resposta única, a diferença é menor: 5.7 segundos nas configurações padrão, contra 3.9 do Sonnet 5.5 e 5.5 do Opus 5.5. As velocidades absolutas dependem da infraestrutura e do horário; a Artificial Analysis também o mede abaixo de metade da velocidade do Sonnet 5.5, com 64 tokens por segundo contra 139.
O que acontece num ciclo de ferramentas?
O GPT-6.1 Sol e o Sonnet 5.5 resolveram as 12 execuções em todas as configurações; o GPT-6.1 Sol custou menos de metade, mas levou quase o dobro do tempo. Num ciclo de ferramentas, o modelo solicita uma ferramenta, o código que fez a chamada executa-a e devolve o resultado. O processo repete-se até o modelo responder. O nosso teste usa três ferramentas (listar arquivos, ler um arquivo, pesquisar) num pequeno repositório sintético. Nas configurações padrão, uma execução custou $0.0052 no GPT-6.1 Sol, $0.0112 no Sonnet 5.5 e $0.0332 no Opus 5.5, com tempos medianos de 12.2, 6.7 e 25.3 segundos. Em max, o custo subiu para $0.0086 no GPT-6.1 Sol e $0.0422 no Sonnet 5.5, com 6.4 e 14.7 chamadas de ferramentas por execução.
Nossos resultados batem com outros testes publicados?
A tendência dos nossos resultados coincide com a dos testes publicados. A magnitude das diferenças muda porque as nossas tarefas são curtas e, em sua maioria, usam as configurações padrão da API, enquanto os índices públicos usam tarefas longas em max.
| Questão | Dados publicados | Nossa medição | Conclusão |
|---|---|---|---|
| Custo do GPT-6.1 Sol frente ao Sonnet 5.5 | Artificial Analysis: $0.72 contra $7.60 por tarefa do índice em max, cerca de 11x | 0.49x nas configurações padrão, 0.33x em max | Mesma tendência; em max, a diferença aumenta em tarefas mais longas: 0.33x nas tarefas de resposta única, 0.20x no nosso ciclo de ferramentas, 0.09x no índice |
| Velocidade | Artificial Analysis: 64 contra 139 tokens de saída por segundo; Vals AI: tarefas com agentes levam de 2 a 3 vezes mais tempo que no GPT-6 Sol | 43 contra 127 tokens por segundo; 22.4 s contra 7.2 s do GPT-6 Sol por documento | Confere |
| Qualidade frente ao Sonnet 5.5 | Artificial Analysis: 52 contra 56; Vals: 61.2% contra 67.0% | Sonnet 5.5 acertou 234 de 234; GPT-6.1 Sol errou uma tarefa 7 de 18 vezes | Mesma tendência; nosso resultado depende de uma única tarefa |
| Respostas do GPT-6 Sol curtas demais ou com conteúdo faltando | Reclamações de desenvolvedores, por exemplo na discussão do lançamento no Hacker News | 325 palavras por documento, contra 592 do GPT-5.6 Sol; todas as partes presentes em 58 de 60, igual ao GPT-5.6 Sol | Respostas curtas confirmadas; conteúdo faltando não se repetiu |
| Sonnet 5.5 ignora a instrução de responder apenas com o valor | Nenhum relato publicado encontrado | 22 de 39 respostas só com o valor na configuração padrão, 12 de 39 em low | Apenas nossos testes |
O que observamos e qual modelo usar?
O GPT-6.1 Sol entrega mais pelo custo que o Sonnet 5.5 e o Opus 5.5. O Sonnet 5.5 justifica o custo adicional quando a latência ou os últimos 4 a 6 pontos de qualidade importam. Quatro observações sustentam essa escolha:
- O GPT-6.1 Sol custa menos que os dois modelos Claude para a qualidade que entrega. Frente ao Sonnet 5.5, custa cerca de metade por tarefa curta, cerca de um quarto com a mesma pontuação num índice e de um sétimo a um décimo nos resultados principais dos índices. Frente ao Opus 5.5, custa 0.29x por tarefa curta e de um oitavo a um décimo nos índices.
- Segue melhor o formato de saída. Entregou exatamente o formato pedido em todos os prompts que exigiam apenas a resposta e em todos os documentos com partes especificadas.
- A correção das respostas curtas custou velocidade. As respostas voltaram a ter o comprimento das do GPT-5.6 Sol, mas cada documento leva três vezes mais tempo que no GPT-6 Sol.
- Seus erros são difíceis de detectar. As 7 respostas erradas ocorreram em
low,mediumexhigh, e todas eram números inteiros bem formatados.
| Tipo de trabalho | Escolha | Números |
|---|---|---|
| Saída processada por código: extração, classificação, valores únicos | GPT-6.1 Sol em medium ou high | apenas o valor pedido em 234 / 234; $0.0021 por tarefa em medium |
| Matemática ou lógica em várias etapas, quando um valor errado custa caro | Sonnet 5.5, ou GPT-6.1 Sol com verificação do resultado | Sonnet 5.5 acertou 234 / 234; GPT-6.1 Sol errou 7 de 18 chamadas numa tarefa |
| Chat e ferramentas interativas, quando a latência importa | Sonnet 5.5 na configuração padrão | 3.9 s contra 5.7 s por tarefa curta; 17.2 s contra 22.4 s por documento |
| Ciclos de agentes em que o custo por execução importa mais que a latência | GPT-6.1 Sol na configuração padrão | $0.0052 por execução contra $0.0112; 12.2 s contra 6.7 s |
| Documentos com seções obrigatórias | GPT-6.1 Sol, ou Sonnet 5.5 com uma faixa de comprimento mais folgada | todas as partes presentes em 80 / 80 contra 68 / 80; nos casos de falha, faltaram de 1 a 28 palavras |
| Trabalho difícil e aberto, quando a pontuação máxima importa | Sonnet 5.5 ou Opus 5.5 em max | pontuações de 56 e 58 nos índices públicos contra 52, por um custo por tarefa de 7 a 11 vezes maior |
Com qualquer um dos modelos, valide os valores que serão usados por um programa.
Perguntas frequentes
O GPT-6.1 Sol custa menos que o Claude Sonnet 5.5?
O GPT-6.1 Sol custa menos por tarefa que o Sonnet 5.5 apesar do mesmo preço de tabela de $2 / $10: nos nossos testes, 0.49x por tarefa de resposta única nas configurações padrão e 0.46x por execução do ciclo de ferramentas. Com a mesma pontuação de 52 na Artificial Analysis, foram $0.72 contra $2.74. O Sonnet 5.5 foi mais rápido e pontua melhor em max.
O GPT-6.1 Sol é tão bom quanto o Claude Opus 5.5? O GPT-6.1 Sol fica cerca de 6 pontos abaixo do Opus 5.5 no Intelligence Index da Artificial Analysis (52 contra 58) e no Vals Index (61.2% contra 67.0%), por um custo por tarefa de um oitavo a um décimo. Nos nossos testes, custou 0.29x por tarefa curta. Nos testes da própria OpenAI, ficou 2.2 pontos à frente no AutomationBench.
Ainda posso desativar o raciocínio no GPT-6.1 Sol?
O GPT-6.1 Sol tem low como nível mínimo de esforço; none, aceito pelo GPT-6 Sol, não está mais disponível. Use low, que custou $0.0018 por tarefa de resposta única nos nossos testes.
Medições relacionadas: Claude Sonnet 5.5 vs Sonnet 5, níveis de esforço do GPT-6 Astra e formas de reduzir o custo do GPT-5.6.
Medições feitas em 2026-09-30, um dia após o lançamento do GPT-6.1 Sol, por meio de um gateway para a OpenAI Responses API e a Anthropic Messages API: 234 chamadas de resposta única no GPT-6.1 Sol (13 tarefas, 3 repetições, 6 configurações), 800 chamadas de documentos empresariais (80 itens com apenas o objetivo em 6 combinações de modelo e nível de esforço, 80 itens com partes especificadas em 4) e 36 execuções de ciclos de ferramentas. Os números de tarefas de resposta única e ciclos de ferramentas do Sonnet 5.5 e do Opus 5.5 vêm de 2026-09-29, com as mesmas tarefas. Os resultados dos benchmarks públicos foram consultados nas páginas dos respectivos publicadores em 2026-10-01.