
Sonnet 5.5 vs Sonnet 5: 80% menos pelo mesmo preço
Conteúdo
- O que mudou no Claude Sonnet 5.5?
- O que dizem os benchmarks de lançamento?
- Como fizemos as medições?
- O Sonnet 5.5 custa menos por tarefa que o Sonnet 5?
- Quanto custa cada nível de esforço?
- Por que o Sonnet 5.5 inclui os cálculos na resposta?
- O que acontece em um loop de ferramentas?
- O Sonnet 5.5 é mais rápido?
- Os limites de tokens do Sonnet 5 continuam válidos?
- Qual modelo usar?
- Perguntas frequentes
O Claude Sonnet 5.5 tem os mesmos preços por token do Claude Sonnet 5: $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. Toda economia, portanto, vem do menor uso de tokens. Em 13 tarefas single-shot com as configurações padrão da API, ele custou $0.0041 por tarefa, contra $0.021 do Sonnet 5, uma redução de 80%. Os dois modelos acertaram todas as tarefas. O problema está no formato de saída: abaixo do nível de esforço xhigh, o Sonnet 5.5 às vezes ignora o raciocínio oculto e escreve os cálculos na própria resposta, mesmo quando o prompt pede somente o resultado.
TL;DR
- Na configuração padrão da API, o Sonnet 5.5 custou $0.0041 por tarefa, contra $0.021 do Sonnet 5. Ambos acertaram as 39 chamadas.
- O Sonnet 5.5 teve praticamente o mesmo custo com esforço
low,mediumehigh;maxcustou 3.5x o padrão. - Abaixo de
xhigh, o Sonnet 5.5 incluiu os cálculos em 68 de 156 prompts que pediam apenas o resultado; um system prompt não resolveu. - Em um loop de ferramentas com quatro perguntas, o Sonnet 5.5 em
maxcustou $0.042 por execução, mais que o Opus 5.5 na configuração padrão ($0.033).
A Anthropic lançou o Sonnet 5.5 em 2026-09-28, afirmando que ele é 30% mais rápido e custa “até 30% menos por tarefa” que o Sonnet 5. Fizemos as medições no dia seguinte.
O que mudou no Claude Sonnet 5.5?
O preço continuou igual, mas os controles de thinking e vários parâmetros das requisições mudaram. O Sonnet 5.5 usa adaptive thinking: o modelo decide quanto raciocínio oculto fará antes de responder, e esses tokens de raciocínio são cobrados como saída. O comportamento é controlado por effort (output_config.effort na Messages API), um parâmetro da requisição com cinco níveis, de low a max. O padrão da API é high.
| Sonnet 5.5 | Sonnet 5 | Opus 5.5 | |
|---|---|---|---|
| Lançamento | 2026-09-28 | 2026-06-30 | 2026-09-22 |
| Entrada / saída, por 1M de tokens | $2 / $10 | $2 / $10 | $4 / $20 |
| Leitura do cache, por 1M de tokens | $0.20 | $0.20 | $0.20 |
| Janela de contexto / saída máxima | 1M / 128K | 1M / 128K | 1M / 128K |
| Limite de conhecimento (somente o mês foi divulgado) | junho de 2026 | janeiro de 2026 | junho de 2026 |
| Esforço padrão na API | high | high | medium |
| Menor configuração de thinking | between_tools (em high ou abaixo) | disabled | sem opção de desligar; thinking fica sempre ativo |
| Prompt mínimo armazenável em cache | 512 tokens | 1,024 tokens | 512 tokens |
O preço de $2 / $10 do Sonnet 5 foi lançado como promocional, mas a página de preços da Anthropic agora o apresenta como padrão. O aumento previsto para $3 / $15 não aconteceu.
Segundo o guia de migração, as requisições abaixo funcionavam no Sonnet 5, mas retornam HTTP 400 no Sonnet 5.5:
thinking: {"type": "disabled"}. Usethinking: {"type": "between_tools"}, que desativa o raciocínio antes da primeira resposta e só é aceito com esforçohighou inferior.- Uso obrigatório de ferramenta (
tool_choicedefinido comoanyou como uma ferramenta específica). Mantenhaautoe informe no prompt quando a ferramenta deve ser usada. - Um limite manual de thinking (
budget_tokens), valores não padrão detemperature,top_poutop_ke um turno do assistant pré-preenchido (iniciar a resposta pelo modelo). - Reutilizar um bloco de thinking do Sonnet 5.5 depois de alterar o system prompt, as ferramentas ou uma mensagem anterior, em contas criadas a partir de 2026-08-31.
- A ferramenta de computer use antiga
computer_20251124na Claude API e no Google Cloud.
Uma mudança não gera erro: as notas curtas escritas pelo modelo entre chamadas de ferramentas agora chegam como blocos de thinking, vazios na configuração padrão de exibição. Com isso, uma interface que faz streaming dessas notas deixa de mostrar atividade.
O que dizem os benchmarks de lançamento?
Na tabela da própria Anthropic, o Sonnet 5.5 fica a poucos pontos do Opus 5.5, custando metade por token, e supera com folga o Sonnet 5.
| Benchmark (o que avalia) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programação agêntica em um terminal) | 70.6% | 10.3% | 66.4% (xhigh) | não divulgado |
| CursorBench 4.0 (programação em um editor) | 55.5% | 34.1% | 57.8% | não divulgado |
| GDPval-AA v2.1 (documentos de trabalho especializado, classificação Elo, quanto maior melhor) | 1844 | 1449 | 1846 | 1487 |
| OSWorld 2.1 (computer use, com pontuação parcial) | 80.1% | 57.0% | 81.8% | não divulgado |
| Humanity’s Last Exam, com ferramentas | 64.5% | 54.9% | 67.7% | não divulgado |
A Artificial Analysis acrescenta um alerta sobre custo: com esforço max, o Sonnet 5.5 marcou 56 no Intelligence Index, dois pontos abaixo do Opus 5.5 em max. Porém, usou cerca de 193K tokens de saída por tarefa, o maior volume já medido pela empresa e cerca de 60% a mais que o Opus 5.5 ou o Sonnet 5 em max, chegando a aproximadamente $7.60 por tarefa do índice.
Como fizemos as medições?
Enviamos aos três modelos 13 tarefas single-shot com respostas conhecidas, cada uma com um prompt, uma resposta e nenhuma ferramenta. O conjunto tinha oito tarefas curtas, como somar os números primos menores que 60 e contar o algarismo 7 de 1 a 500, além de cinco tarefas que exigem várias etapas de raciocínio, como uma mochila com 10 itens, caminhos em uma grade 8x8 com bloqueios e 13 elevado a 1,001 módulo 10,007. Todos os gabaritos foram calculados localmente por força bruta, e todos os prompts terminavam com “Responda com um único inteiro e nada mais”. Cada tarefa foi executada 3 vezes na configuração padrão da API e em cada um dos cinco níveis de esforço, totalizando 702 chamadas na Messages API nativa. Cada prompt continha uma string aleatória exclusiva para impedir respostas vindas do cache, e o custo foi calculado com base nos preços de tabela da Anthropic. Avaliamos se o resultado final estava correto e se a resposta continha somente o resultado.
A precisão não diferenciou os modelos. O Sonnet 5.5 acertou todas as 234 chamadas, e o Sonnet 5 acertou as 233 que retornaram (uma teve erro de servidor). O Opus 5.5 errou uma tarefa em low e outra na configuração padrão.
O Sonnet 5.5 custa menos por tarefa que o Sonnet 5?
O Sonnet 5.5 custou 80% menos que o Sonnet 5 na configuração padrão e de 77% a 78% menos em low, medium e high, pois produziu cerca de um quinto dos tokens de saída. Os preços de tabela são idênticos, então toda a economia vem da eficiência no uso de tokens. O Sonnet 5 produziu cerca de 1,800 a 2,100 tokens por tarefa em todos os níveis de esforço. O Sonnet 5.5 ficou perto de 400 até xhigh.
| Todas as 13 tarefas, por tarefa | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Padrão da API | $0.0041 (396 tokens) | $0.0212 (2,105) | $0.0070 (334) |
low | $0.0043 (409) | $0.0184 (1,817) | $0.0065 (309) |
medium | $0.0040 (383) | $0.0180 (1,780) | $0.0082 (393) |
high | $0.0043 (416) | $0.0188 (1,858) | $0.0088 (421) |
xhigh | $0.0059 (574) | $0.0202 (2,001) | $0.0105 (507) |
max | $0.0146 (1,438) | $0.0193 (1,909) | $0.0234 (1,149) |
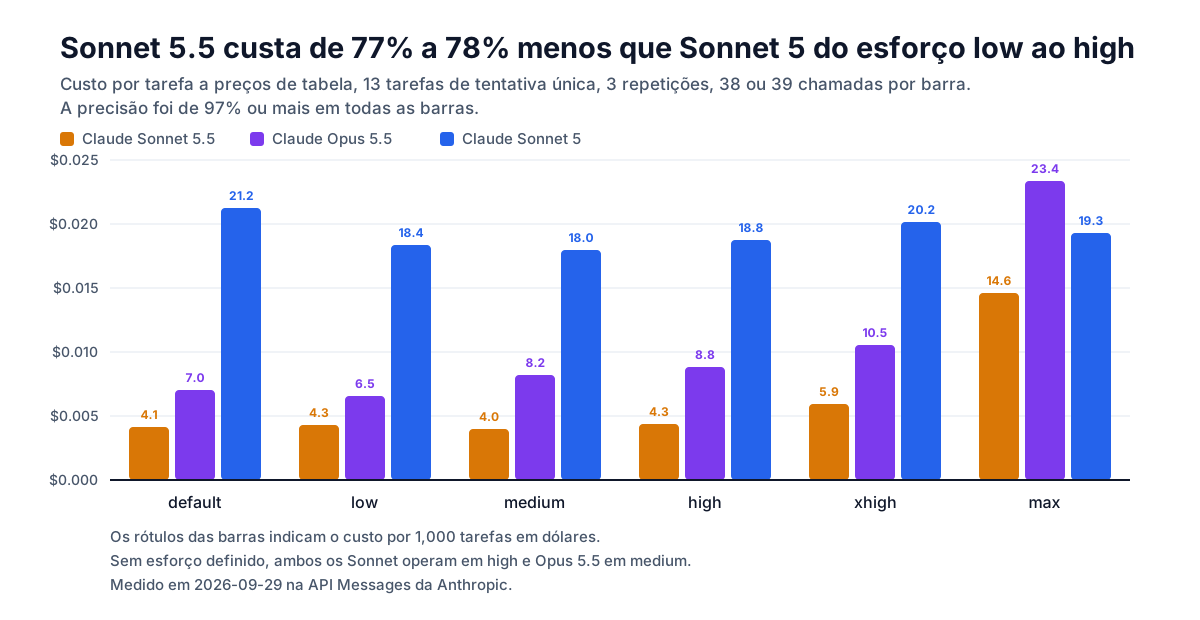
As contagens mostram a média de tokens de saída por chamada, incluindo o raciocínio. Nas cinco tarefas difíceis, a economia na configuração padrão foi de 84% ($0.0057 contra $0.0348). No nosso loop de ferramentas, em que todo o histórico é reenviado a cada turno e os tokens de entrada dominam o custo, a economia foi de 8%. A afirmação da Anthropic de “até 30%” é conservadora para prompts únicos como estes e otimista para um loop curto como o nosso.
Com apenas 13 tarefas, a economia de 80% na configuração padrão tem uma faixa ampla: reamostrar as tarefas dá um intervalo de 95% de 66% a 85% a menos, e o limite inferior fica acima de 50% em todos os níveis de low a xhigh.
Quanto custa cada nível de esforço?
No Sonnet 5.5, low, medium e high custaram cerca de $0.0042 por tarefa. Portanto, a configuração padrão high não teve custo adicional neste teste. xhigh custou cerca de 40% a mais, e max, 3.5x o padrão. Em max, o Sonnet 5.5 custou por tarefa o dobro do Opus 5.5 na configuração padrão ($0.0146 contra $0.0070), sem ganho de precisão.
O custo não ficará estável em todas as cargas. Em uma tarefa de DevOps mais longa, outro teste observou que high usou aproximadamente o dobro dos tokens de saída de medium. Cargas em que o nível de esforço faz diferença precisam de testes próprios em todas as configurações.
Por que o Sonnet 5.5 inclui os cálculos na resposta?
Abaixo de xhigh, o Sonnet 5.5 nem sempre usa um bloco de thinking. Quando não usa, faz o raciocínio na própria resposta. O bloco de thinking é a parte separada da resposta que contém o raciocínio do modelo. Seu texto vem vazio por padrão, seguido pela resposta em um bloco de text.
Das 234 respostas do Sonnet 5.5, todas as 166 que continham um bloco de thinking trouxeram apenas o resultado. As outras 68 mostraram primeiro os cálculos, por exemplo, “09:47 + 3:46 = 13:33 … + 1:39 = 15:40”, seguidos de “15:40”. O resultado final estava correto em todos os casos, mas a resposta não seguia o formato solicitado no prompt.
| Respostas contendo apenas o resultado | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Padrão da API | 22 / 39 | 38 / 39 | 38 / 39 |
low | 12 / 39 | 37 / 39 | 38 / 39 |
medium | 24 / 39 | 37 / 39 | 39 / 39 |
high | 30 / 39 | 38 / 39 | 39 / 39 |
xhigh | 39 / 39 | 35 / 38 | 39 / 39 |
max | 39 / 39 | 37 / 39 | 39 / 39 |
O comportamento depende da tarefa: onde aconteceu, o Sonnet 5.5 mostrou os cálculos nas três repetições, exceto em uma tarefa na configuração padrão, em que isso ocorreu duas vezes. Isso aconteceu em 9 das 13 tarefas em low, 6 na configuração padrão, 5 em medium e 3 em high (todas contas aritméticas curtas). Contadas por tarefa, com apenas 13 tarefas, nenhuma dessas diferenças passa por uma correção de Holm, então leia as contagens como o que observamos, não como uma taxa para planejamento. Os desvios do Sonnet 5 têm outro formato: o resultado correto aparece em negrito, seguido de uma explicação curta. A linha xhigh contém 38 chamadas porque uma retornou erro de servidor.
Um system prompt que pedia “apenas o resultado final” e instruía o modelo a fazer os cálculos sem mostrá-los não ajudou. O Sonnet 5.5 respondeu somente com o resultado em 8 de 24 tarefas curtas em low e 9 de 24 em medium, contra 6 e 9 sem essa instrução. xhigh resolveu o problema: todas as respostas incluíram um bloco de thinking e somente o resultado, com custo cerca de 40% maior que low a high. Para código que processa a saída do modelo:
- Use
xhighquando a resposta precisar ter uma única linha. - Ou leia o resultado na última linha não vazia, que estava correto nos 68 casos deste teste.
- Os structured outputs da Anthropic também podem restringir a resposta a um schema; não testamos essa opção.
import anthropic

client = anthropic.Anthropic()
prompt = "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else."
resp = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    output_config={"effort": "xhigh"},  # low, medium, high (API default), xhigh, max
    messages=[{"role": "user", "content": prompt}],
)
text = "".join(block.text for block in resp.content if block.type == "text")
lines = text.strip().splitlines()
answer = lines[-1] if lines else None  # below xhigh, working can precede the answer
print(answer, resp.usage.output_tokens)  # output_tokens includes the reasoning
O que acontece em um loop de ferramentas?
Na configuração padrão e em low e medium, o Sonnet 5.5 concluiu todas as execuções de um loop de leitura de código com quatro perguntas por cerca de $0.011, um terço do custo do Opus 5.5. Em max, fez três vezes mais chamadas de ferramentas e custou mais que o Opus 5.5. Cada modelo recebeu três ferramentas, para listar arquivos, ler um arquivo e pesquisar, sobre uma base de código sintética pequena. Cada resposta exigia de 3 a 6 consultas em diferentes arquivos.
| Loop de ferramentas, 12 execuções cada | Resolvidas | Mediana de turnos | Chamadas de ferramentas por execução | Custo por execução | Mediana do tempo total |
|---|---|---|---|---|---|
| Sonnet 5.5, padrão | 12 / 12 | 3 | 4.8 | $0.0112 | 6.7 s |
Sonnet 5.5, low | 12 / 12 | 3 | 4.9 | $0.0112 | 7.4 s |
Sonnet 5.5, medium | 12 / 12 | 3 | 5.1 | $0.0113 | 6.8 s |
Sonnet 5.5, max | 12 / 12 | 4 | 14.7 | $0.0422 | 20.1 s |
| Opus 5.5, padrão | 12 / 12 | 4 | 5.3 | $0.0332 | 25.3 s |
| Sonnet 5, padrão | 11 / 12 | 3.5 | 4.2 | $0.0122 | 15.8 s |
Depoimentos de clientes publicados pela VentureBeat relatam menos chamadas de ferramentas que o Sonnet 5, com um terço a menos na Lovable. Este loop é curto demais para mostrar essa diferença: o Sonnet 5.5 fez 4.8 chamadas por execução, contra 4.2 do Sonnet 5, mas custou 8% menos e levou menos da metade do tempo.
O Sonnet 5.5 é mais rápido?
Ele terminou antes principalmente porque escreveu menos. Na configuração padrão, a mediana do tempo total por tarefa single-shot, desde o envio da requisição até o recebimento da resposta completa, foi de 3.9 segundos para o Sonnet 5.5, 8.1 segundos para o Sonnet 5 e 5.5 segundos para o Opus 5.5. A quantidade de tokens de saída por segundo de tempo total foi praticamente igual nos dois Sonnets, 88 contra 91. A espera caiu pela metade porque o Sonnet 5.5 escreveu um quinto dos tokens, não porque os gerou mais rápido. Nas tarefas difíceis, a diferença foi de 5.8 segundos contra 21.0.
Os limites de tokens do Sonnet 5 continuam válidos?
Os orçamentos de contexto e os limites de max_tokens definidos para o Sonnet 5 devem continuar servindo. Segundo o guia de migração da Anthropic, o Sonnet 5.5 usa o mesmo tokenizer, e os quatro textos fixos que testamos (prosa em inglês, código Python, argumentos de ferramenta em JSON, prosa em chinês) deram a mesma contagem de tokens nos dois modelos e no Opus 5.5, por exemplo 1,270 tokens para o inglês e 493 para o chinês; o Sonnet 5.5 e o Opus 5.5 somam 2 tokens fixos por requisição. Requisições com ferramentas ficam um pouco mais baratas na entrada: a página de preços da Anthropic informa que o prompt de sistema oculto de uso de ferramentas tem 286 tokens no Sonnet 5.5 contra 354 no Sonnet 5.
Qual modelo usar?
Na maioria das cargas do Sonnet 5, vale migrar. Falta apenas escolher o nível de esforço.
| Carga | Ponto de atenção | Recomendação | Números |
|---|---|---|---|
| Saída processada por código: extração, classificação, valores únicos | Cálculos aparecem na resposta abaixo de xhigh | Sonnet 5.5 em xhigh, ou medium processando a última linha | somente o resultado em 39 / 39 com xhigh, 24 / 39 com medium; xhigh custa cerca de 40% a mais |
| Chat e texto voltado ao usuário | Latência e custo | Sonnet 5.5 em medium | $0.0040 por tarefa, mediana de 3.9 s |
| Loops de agentes com ferramentas | max multiplicando as chamadas de ferramentas | Sonnet 5.5 na configuração padrão ou em medium; prefira o Opus 5.5 antes de usar o Sonnet 5.5 em max | $0.011 por execução na configuração padrão, $0.042 em max, $0.033 no Opus 5.5 |
| Código do Sonnet 5 que desativa thinking ou força uma ferramenta | HTTP 400 após trocar o modelo | between_tools (em high ou abaixo) e tool_choice: auto | Guia de migração da Anthropic |
Independentemente do nível de esforço, mantenha duas verificações no código: se a resposta está no formato esperado pelo parser e um limite de tokens de saída por requisição. Em prompts únicos, max elevou o custo por tarefa em 3.5x; no loop, triplicou as chamadas de ferramentas.
Perguntas frequentes
O Sonnet 5.5 custa menos que o Opus 5.5?
Nas configurações padrão, o Sonnet 5.5 custou 41% menos que o Opus 5.5 por tarefa single-shot e um terço do valor por execução do loop de ferramentas. Em max, a ordem se inverte: o Sonnet 5.5 custou o dobro do Opus 5.5 padrão nas tarefas single-shot e 27% a mais por execução do loop.
Qual nível de esforço devo usar no Sonnet 5.5?
O Sonnet 5.5 teve praticamente o mesmo custo em low, medium e high nas nossas tarefas ($0.0040 a $0.0043). medium é um ponto de partida seguro para chat e loops de ferramentas. Use xhigh quando o código processar a resposta como um valor isolado; max custou 3.5x o padrão.
Ainda posso desativar o thinking no Sonnet 5.5?
O Sonnet 5.5 rejeita thinking: {"type": "disabled"} com HTTP 400. Envie thinking: {"type": "between_tools"}, aceito com esforço low, medium ou high.
Medições relacionadas: Claude Opus 5.5 vs Opus 5, o tokenizer do Claude Sonnet 5 e controles de thinking entre fornecedores.
Medições feitas em 2026-09-29, um dia após o lançamento, por meio de um gateway para a Anthropic Messages API. Foram 702 chamadas single-shot avaliadas (13 tarefas com gabaritos calculados por força bruta, 3 repetições, 6 níveis de esforço e 3 modelos), 48 chamadas para testar uma instrução de sistema sobre o formato da saída, 72 execuções do loop de ferramentas (4 perguntas com várias etapas, 3 repetições e 6 configurações) e contagens de tokens para quatro textos fixos por modelo. Prompts com salt; custos calculados com base nos preços de tabela da Anthropic.