
Agent LLM lent : 3 causes repérées dans une trace
Trois causes de lenteur reproduites et corrigées : appels en série (3.7 s à 1.8 s), outil lent dans votre code et raisonnement pour des réponses d’une phrase.
Nos choix
prix en direct| Modèle | Verdict | Prix |
|---|---|---|
| GPT-6 Luna Cinq réponses d’une phrase ont pris un temps médian de 25.6 s avec l’effort de raisonnement par défaut et de 10.2 s avec reasoning_effort défini sur none, le nombre de tokens de sortie passant de 1,150 à 190. | Agent principal de la démo | dès $0.1/M |
| DeepSeek V4.1 Flash Trois vérifications d’une phrase ont pris un temps médian de 3.7 s lorsqu’elles étaient envoyées l’une après l’autre et de 1.8 s lorsqu’elles étaient envoyées ensemble, pour les mêmes 127 tokens d’entrée. | Sous-agent de la démo | dès $0.3/M |
Sommaire
- Par où commencer quand l’exécution d’un agent est lente ?
- À quoi ressemblent des appels exécutés en série alors qu’ils pourraient être parallèles ?
- Comment savoir si la lenteur vient de votre propre code ?
- Et si la lenteur vient d’un seul appel au modèle ?
- Que ne couvre pas cette page ?
- FAQ
- Comment trouver l’étape la plus lente d’un agent LLM ?
- Les appels LLM parallèles coûtent-ils plus cher que les appels en série ?
- Pourquoi un appel au modèle est-il lent alors que la réponse est courte ?
- Comment mesurer si une correction a accéléré mon agent ?
- La passerelle peut-elle montrer ce que mon code a fait entre deux appels au modèle ?
- Pour aller plus loin
La lenteur d’un agent vient généralement de trois problèmes : ses appels au modèle s’attendent alors qu’ils pourraient s’exécuter en parallèle, son propre code prend trop de temps entre les appels, ou un appel au modèle fait plus de travail que l’étape ne l’exige. Une trace permet de trouver la cause en quelques secondes : elle place chaque appel sur un axe temporel et montre les intervalles entre les appels. Ce guide reproduit chaque problème dans un petit agent de support, le corrige, puis compare les exécutions avant et après correction dans la console Synthorai.
TL;DR
- L’envoi simultané de trois appels indépendants avec
asyncio.gathera fait passer la durée médiane de 3.7 s à 1.8 s, au même coût. - L’exécution simultanée de quatre recherches en base de données simulées de 1.1 s a réduit le temps passé dans le code de l’agent de 4.6 s à 1.3 s. Changer de modèle ne peut rien améliorer sur cette partie.
- Désactiver le raisonnement (
reasoning_effort="none") pour cinq réponses d’une phrase sur GPT-6 Luna a réduit la durée de 25.6 s à 10.2 s et le nombre de tokens de sortie de 1,150 à 190.
Ce guide s’appuie sur Tracer un agent LLM, qui présente les trois en-têtes de requête permettant de regrouper les appels au modèle dans une trace. Configurez la démo comme indiqué dans ce guide (Python 3.10 ou version ultérieure, virtualenv activé), puis lancez les trois cas depuis le même répertoire du dépôt github.com/synthorai-io/use-cases :
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
Chaque cas s’exécute deux fois, d’abord avec le problème, puis avec la correction. Le script affiche une ligne par exécution avec l’identifiant de sa trace :
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
La latence du modèle varie d’un appel à l’autre. Nous avons donc exécuté chaque cas cinq fois le 11 octobre 2026. Le tableau donne la médiane, avec les durées minimale et maximale entre parenthèses. Une exécution corrigée du troisième cas a échoué : sa médiane porte donc sur quatre exécutions. L’exemple de sortie ci-dessus et les paires visibles dans les captures correspondent à une exécution supplémentaire de chaque cas, hors des cinq mesures. Les durées sont des temps écoulés du début à la fin, mesurés par le script.
| Cas | Ce que montre la trace | Correction | Avant | Après |
|---|---|---|---|---|
serial-checks | des barres en escalier, sans chevauchement | envoyer les appels indépendants en parallèle | 3.7 s (3.5 à 4.5) | 1.8 s (1.7 à 2.0) |
slow-tool | une longue ligne your app | corriger votre propre code | 11.0 s (9.5 à 12.2) | 9.2 s (6.7 à 11.0) |
reasoning | beaucoup plus de tokens de sortie que dans la réponse visible | réduire l’effort de raisonnement | 25.6 s pour cinq réponses (19.0 à 31.8) | 10.2 s (7.9 à 12.1) |
Par où commencer quand l’exécution d’un agent est lente ?
Commencez par le résumé en haut de la trace. Il répartit le temps écoulé entre la passerelle et votre application. Le temps écoulé correspond à l’attente de l’utilisateur. « In the gateway » désigne les périodes pendant lesquelles au moins une requête au modèle était en cours. « In your app » couvre le reste : les intervalles entre les requêtes, où seul votre code s’exécutait. Cette mesure inclut aussi le temps réseau entre votre code et la passerelle, soit quelques dixièmes de seconde par appel dans les exécutions présentées ici.
Cette répartition indique où chercher :
- L’essentiel du temps dans la passerelle, avec des barres en escalier : les appels s’attendent les uns les autres. Voir le premier cas.
- Une grande part du temps dans votre application : le modèle n’est pas en cause. Voir le deuxième cas.
- L’essentiel du temps dans la passerelle, avec une longue barre : un appel concentre l’attente. Le résumé le désigne comme « slowest ». Voir le troisième cas.
Pour mesurer l’effet d’une modification, ouvrez la trace d’avant, sélectionnez Compare, puis choisissez celle d’après. La console affiche alors les deux exécutions sur une même page : chaque métrique avec A, B et l’écart, chaque appel associé à celui qui porte le même nom, et les deux diagrammes en cascade sur le même axe temporel. Toutes les captures de cette page utilisent cette vue.
À quoi ressemblent des appels exécutés en série alors qu’ils pourraient être parallèles ?
Le diagramme en cascade forme un escalier : chaque barre commence là où la précédente se termine. L’agent de la démo effectue trois vérifications sur un message client avec DeepSeek V4.1 Flash : sentiment, conformité à la politique et risque. Chacune produit une réponse d’une phrase. Aucune n’a besoin du résultat des autres, mais la version initiale les attend dans une boucle :
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
La correction tient en une ligne :
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))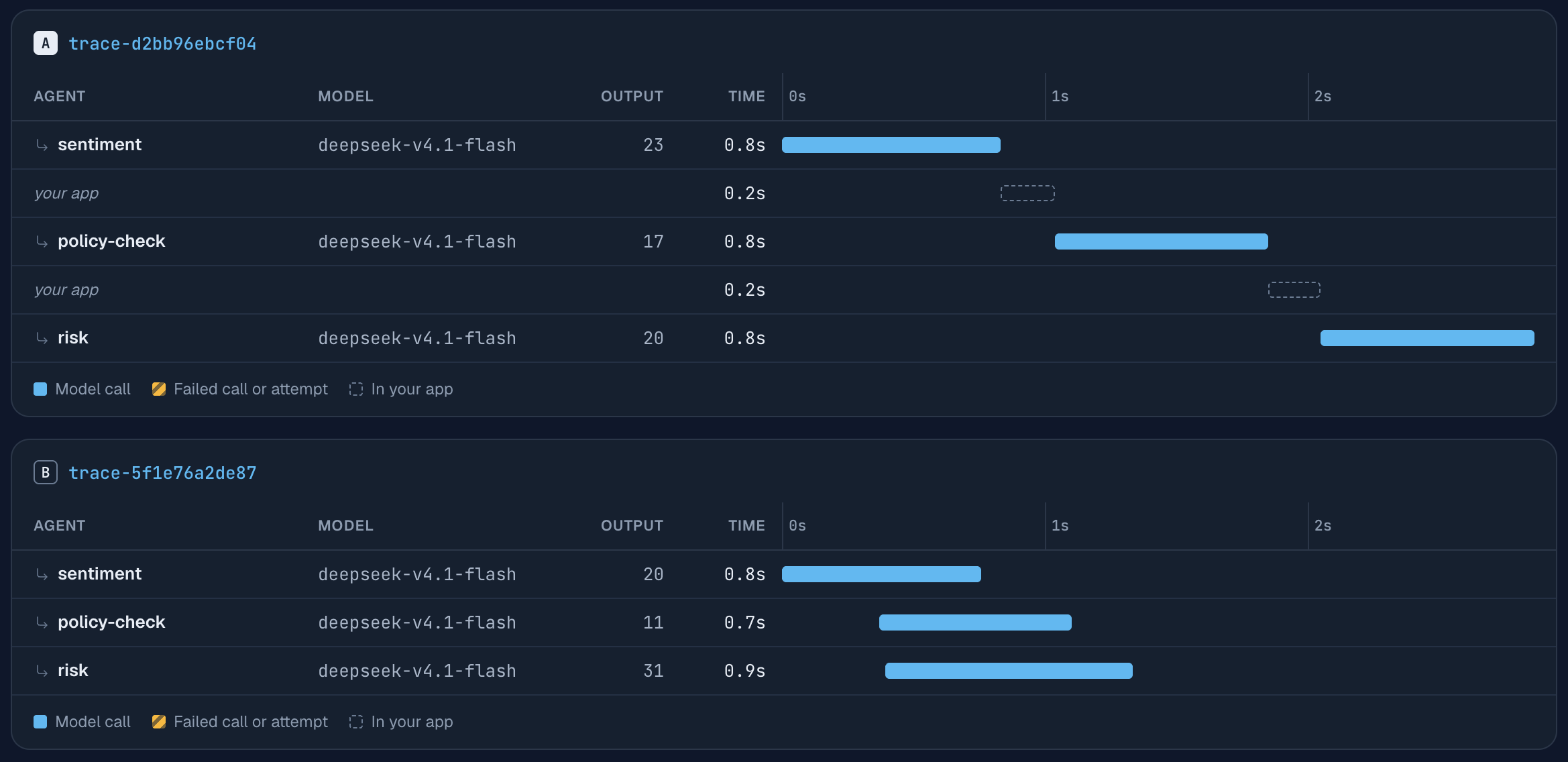
Dans la trace A, le temps écoulé est de 2.9 s : les trois appels prennent chacun 0.8 s, l’un après l’autre, avec un intervalle de 0.2 s entre eux. Dans la trace B, les barres se chevauchent et le temps écoulé est de 1.3 s. Le tableau de comparaison, situé sur la même page de la console au-dessus de la zone visible ici, indique un passage de 2.9 s à 1.3 s, soit une baisse de 53.4% (calculée sur les durées non arrondies). Le script a mesuré 3.5 s et 1.5 s pour cette même paire, car il compte aussi l’ouverture des connexions et le temps réseau de chaque appel.
Les deux exécutions utilisent les mêmes 127 tokens d’entrée. Le coût dépend de la sortie, dont la longueur varie légèrement d’une exécution à l’autre : cette paire a coûté $0.000110 et $0.000112. Sur cinq exécutions, le coût médian était de $0.000105 en série et de $0.000109 en parallèle. Les appels parallèles envoient et reçoivent les mêmes tokens : le parallélisme ne coûte donc pas plus cher.
Sur votre propre agent, examinez chaque paire de barres consécutives : le deuxième appel utilise-t-il la sortie du premier ? Si ce n’est pas le cas, ils peuvent se chevaucher. Les appels qui dépendent les uns des autres, par exemple un plan suivi de l’étape qu’il définit, doivent rester séquentiels.
Comment savoir si la lenteur vient de votre propre code ?
La ligne your app est longue. Dans la version initiale de ce cas, l’agent répond à une question après avoir recherché le client dans quatre tables, une requête à la fois. Chaque requête est simulée par un sleep de 1.1 s :
rows = [await lookup(t) for t in tables] # four queries, one at a timeL’exécution parallèle des quatre requêtes tient, là encore, en une ligne :
rows = await asyncio.gather(*(lookup(t) for t in tables))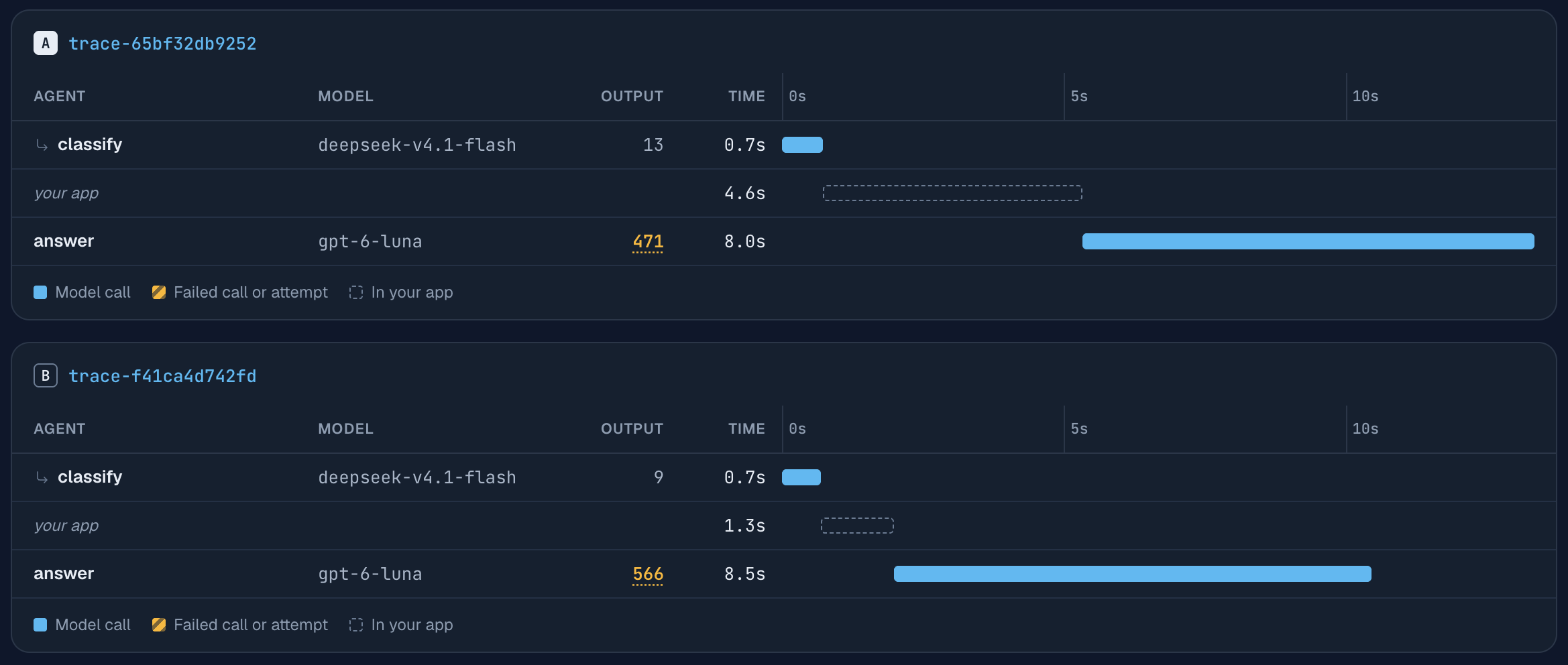
La ligne corrigée est passée de 4.6 s à 1.3 s. Le tableau de comparaison indique une baisse de 71.8% pour « In your app », calculée là aussi sur les durées non arrondies. Aucun changement de modèle ou de prompt n’aurait amélioré cette partie : aucune requête au modèle n’était en cours, et l’agent attendait ses propres recherches.
Le gain sur la durée totale est moins net. Pour cette paire, le temps écoulé est passé de 13.3 s à 10.5 s : une économie de 2.8 s pour une correction qui en fait gagner 3.3 s. La demi-seconde manquante vient de l’appel answer à GPT-6 Luna. Il a produit 471 tokens de sortie lors de la première exécution et 566 lors de la seconde, en 8.0 s et 8.5 s respectivement. Sur les cinq exécutions du tableau, les plages de durée se chevauchent : de 6.7 à 11.0 s après correction, contre 9.5 à 12.2 s avant. Une exécution corrigée peut donc être plus lente qu’une exécution non corrigée.
Comparez donc la ligne modifiée, pas la durée totale d’une seule exécution. Le tableau détaillé de la vue de comparaison le fait pour vous : il associe chaque appel à son équivalent et affiche la durée, la sortie et le coût pour A et B. Pour démontrer un gain de bout en bout, comparez la durée de nombreuses traces pour chaque variante. La latence p95 dans Logs, le temps dans lequel 95% des requêtes se terminent, ne montrera pas cette correction. Elle mesure les requêtes individuelles, alors que le temps économisé ici se situe entre les requêtes.
La passerelle ne voit pas ce que votre code fait pendant l’intervalle, seulement sa durée. Si cet intervalle est long sans raison connue, ajoutez des spans OpenTelemetry à vos propres fonctions.
Et si la lenteur vient d’un seul appel au modèle ?
Regardez le nombre de tokens produits par cet appel : c’est la génération de la sortie qui prend du temps. Un modèle de raisonnement réfléchit avant de répondre. Ce raisonnement est compté dans la durée et facturé comme tokens de sortie, même si la réponse visible tient en une phrase. Dans la version initiale de ce cas, GPT-6 Luna reçoit cinq courtes questions sur la politique à appliquer, avec la consigne « Réponds en une phrase ». L’effort de raisonnement reste à sa valeur par défaut. La version corrigée ajoute un paramètre :
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")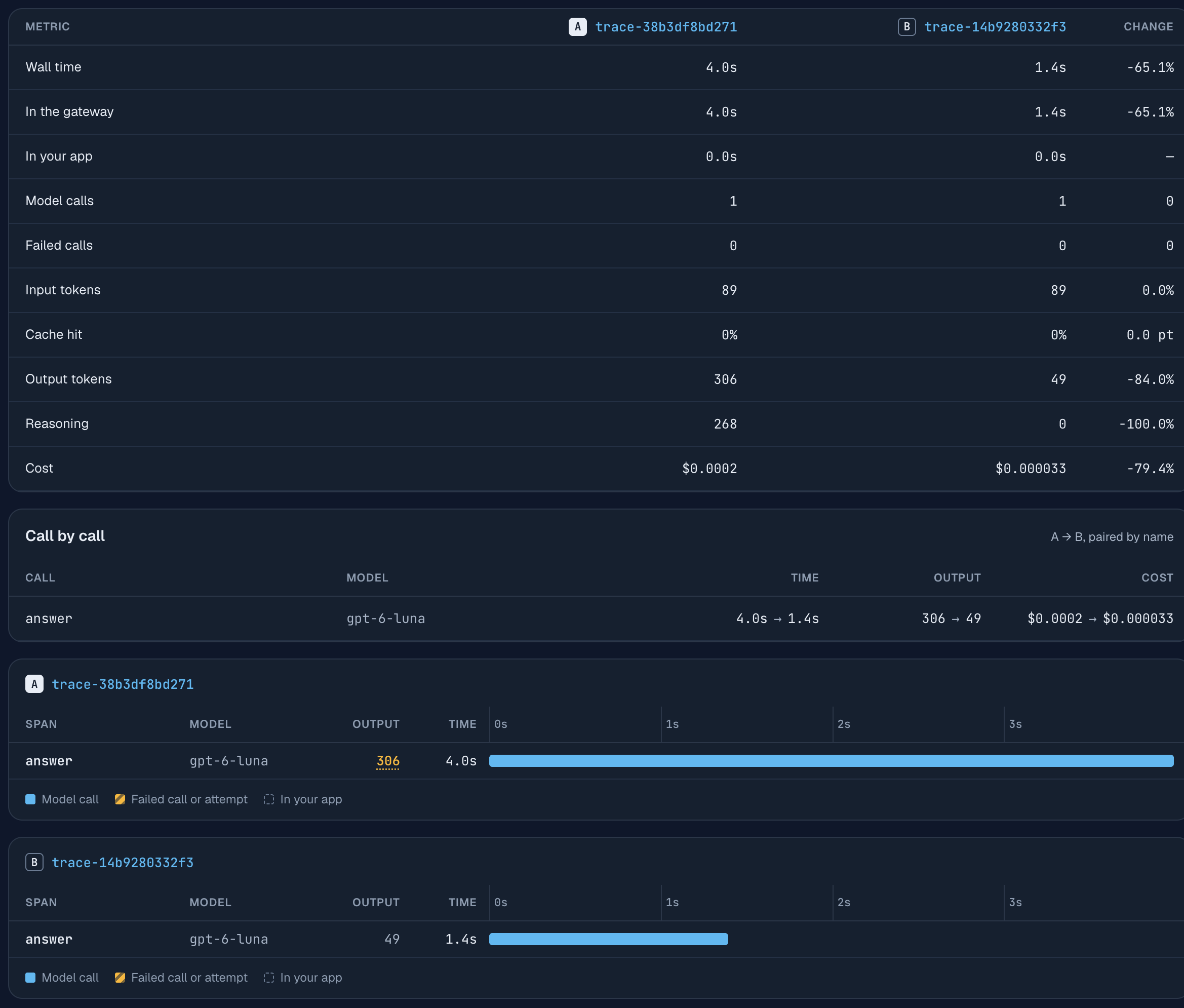
Cette capture montre la première des cinq questions, avant et après correction. Dans les deux cas, la réponse tient en une phrase. Avec l’effort par défaut, le modèle a produit 306 tokens de sortie, dont 268 de raisonnement, en 4.0 s. Sans raisonnement, il en a produit 49 en 1.4 s. Le coût de l’appel est passé de $0.00016, arrondi à $0.0002 dans la console, à $0.000033.
| Cinq réponses d’une phrase (médiane de cinq exécutions, quatre pour la deuxième ligne) | Durée | Tokens de sortie | Coût |
|---|---|---|---|
| effort de raisonnement par défaut | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
La comparaison n’est pas nécessaire pour repérer ce cas. Le diagramme en cascade possède une colonne Output. Quand une sortie volumineuse contient surtout du raisonnement, son nombre de tokens est souligné, comme les 306 ci-dessus. Sélectionnez l’appel : le panneau affiche les tokens de raisonnement sur une ligne distincte, sous les tokens de sortie.
Désactiver le raisonnement convient à ces étapes : recherche d’informations, classification, reformulation du résultat d’un outil. Ce n’est pas adapté aux tâches qui demandent un raisonnement en plusieurs étapes, que cette démo ne teste pas. Nos mesures sur GPT-6 Luna donnent le nombre de tokens de raisonnement et le coût par réponse pour chaque réglage. Le guide de l’effort de raisonnement indique les valeurs acceptées par chaque modèle. Ajustez ce paramètre par étape et vérifiez les réponses avant et après.
Que ne couvre pas cette page ?
Deux sujets ne sont pas couverts. Le premier est la vitesse perçue de la réponse. Le streaming ne raccourcit pas l’appel, mais l’utilisateur voit le texte plus tôt. Pour une réponse dans un chat, c’est souvent ce qui compte. Le panneau d’un appel comporte un champ First token pour cette mesure. Il est vide dans ces traces, car la démo n’utilise pas le streaming.
Le second concerne les causes externes à votre agent : un fournisseur lent à ce moment-là, ou une limite de débit qui oblige votre client à attendre puis à réessayer. Elles apparaissent sous la forme d’une longue barre, ou d’un appel échoué suivi d’une nouvelle tentative. Modifier la structure de votre code ne les résout pas.
FAQ
Comment trouver l’étape la plus lente d’un agent LLM ?
Ouvrez la trace de l’exécution et lisez le résumé : il indique l’appel le plus lent et répartit le temps écoulé entre la passerelle et votre application. Le diagramme en cascade situé dessous représente chaque appel par une barre. Examinez la barre la plus longue ou la ligne your app la plus longue.
Les appels LLM parallèles coûtent-ils plus cher que les appels en série ?
Non. Dans la démo, les trois vérifications ont coûté une médiane de $0.000105 en série et de $0.000109 en parallèle, avec les mêmes 127 tokens d’entrée. L’écart vient de la variation de longueur des sorties entre les exécutions. Le coût dépend des tokens, et les appels parallèles envoient et reçoivent les mêmes tokens. Surveillez en revanche votre limite de débit, puisque les appels arrivent en même temps.
Pourquoi un appel au modèle est-il lent alors que la réponse est courte ?
Le plus souvent, le modèle a d’abord raisonné. Ce raisonnement génère des tokens de sortie qui n’apparaissent pas dans la réponse. Cinq réponses d’une phrase sur GPT-6 Luna ont utilisé une médiane de 1,150 tokens de sortie avec l’effort de raisonnement par défaut, contre 190 avec reasoning_effort="none".
Comment mesurer si une correction a accéléré mon agent ?
Comparez la partie modifiée, pas une seule durée totale. Dans la démo, lancer quatre recherches en parallèle a réduit le temps passé dans le code de 4.6 s à 1.3 s. Après correction, la durée totale des exécutions variait pourtant de 6.7 s à 11.0 s, à cause des variations d’un appel au modèle. Comparez de nombreuses exécutions de chaque version à partir de la durée des traces.
La passerelle peut-elle montrer ce que mon code a fait entre deux appels au modèle ?
Elle montre la durée de l’intervalle sous la forme d’une ligne your app, mais pas ce qui s’y passe. Pour obtenir des spans dans votre propre code, utilisez un SDK OpenTelemetry et transmettez son en-tête traceparent, afin que les deux vues partagent le même identifiant de trace.
Pour aller plus loin
- Tracer un agent LLM : les en-têtes et le diagramme en cascade utilisés dans cette page.
- Pourquoi mon agent LLM coûte-t-il cher ? : la même méthode appliquée à la facture.
- Déboguer un agent LLM : partir d’un signalement utilisateur pour trouver l’appel en cause.
- Coût de Claude Code par sous-agent : les mêmes vues pour un agent de développement que vous n’avez pas écrit.
- Interroger Claude sur vos logs LLM : poser des questions sur le journal des requêtes via MCP.
- Donner à votre agent des outils d’accès aux logs : lire les mêmes logs avec votre propre programme et mesurer le coût des tokens du modèle.
- GPT-6 Luna vs GPT-5.6 Luna : tokens de raisonnement et coût par réponse pour chaque niveau d’effort.