
Tracer un agent LLM avec 3 en-têtes HTTP, sans SDK de traçage
Ajoutez trois en-têtes aux appels de votre agent pour visualiser chaque exécution : appels parallèles, temps dans votre code, erreurs et coût.
Nos choix
prix en direct| Modèle | Verdict | Prix |
|---|---|---|
| GPT-6 Luna Gère la boucle d’appels de fonctions de la démo. Ses deux appels par tour (planification et réponse) coûtent $0.0002 au total dans l’exécution présentée sur cette page. | Agent principal de la démo | dès $0.1/M |
| DeepSeek V4.1 Flash Exécute les trois vérifications parallèles en une phrase avec le raisonnement désactivé. Ses six appels dans la session présentée sur cette page coûtent $0.0004, et un septième appel au sous-agent a échoué pour un coût de $0. | Sous-agent de la démo | dès $0.3/M |
Sommaire
- Quels en-têtes envoyer pour obtenir une trace ?
- Que fait l’agent de démonstration ?
- Comment lire le diagramme en cascade ?
- Qu’apporte une session par rapport à une trace ?
- Comment répartir le coût par fonctionnalité ou par utilisateur ?
- Que se passe-t-il quand un appel échoue ?
- Comment récupérer le coût de chaque appel dans le code ?
- Et si votre agent envoie déjà des en-têtes de traçage ?
- Que faire d’une trace une fois obtenue ?
- Qu’est-ce qui n’est pas couvert ?
- FAQ
- Faut-il OpenTelemetry pour tracer un agent LLM ?
- Quelle est la différence entre une trace et une session ?
- Les en-têtes de traçage changent-ils le routage, la facturation ou ce que voit le modèle ?
- Combien de temps les traces sont-elles conservées ?
- Un appel en échec coûte-t-il quelque chose ?
- Pour aller plus loin
Quand un agent fait cinq appels de modèle pour répondre à un seul message, un simple journal de requêtes ne suffit pas pour le déboguer. Impossible de savoir quels appels appartiennent à la même exécution, lesquels ont tourné en parallèle ou quelle part de l’attente vient de votre code. Ce guide ajoute trois en-têtes de requête à un petit agent de support. Nous lisons ensuite le résultat dans la console Synthorai sous forme de trace (une exécution représentée sur une chronologie) et de session (une conversation avec son coût). Aucun SDK de traçage à installer, aucun collecteur (un service distinct qui reçoit les traces) à faire tourner. Le code se trouve sur github.com/synthorai-io/use-cases, dans agent-tracing/. Il faut Python 3.10 ou une version ultérieure et une clé API obtenue dans la console.
TL;DR
- Trois en-têtes de requête (
X-Trace-Id,X-Span-Id,X-Session-Id) sur chaque appel de modèle transforment le journal de requêtes en traces et en sessions dans la console Synthorai, sans SDK de traçage. - Dans la trace de démonstration, les 8.5 s de temps total se répartissent en environ 7.0 s d’appels de modèle et 1.6 s en dehors de ces appels, dans le code de l’agent et sur le réseau.
- Un appel en échec, une 404, reste dans la trace et coûte $0.
- L’exécution de démonstration, avec ses 21 appels de modèle, coûte $0.0017.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd agent-tracing
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --fail
Lors de notre test du 11 octobre 2026, l’exécution a effectué 21 appels de modèle en moins d’une minute pour $0.0017. Elle affiche deux identifiants de session et quatre identifiants de trace. Ouvrez la page Traces de la console : vous y retrouverez les mêmes identifiants. La console affiche les heures dans le fuseau du navigateur. Les captures de ces pages indiquent donc 19:24 pour 11:24 UTC.
Quels en-têtes envoyer pour obtenir une trace ?
Envoyez trois en-têtes sur chaque appel de modèle, avec les chaînes de caractères de votre choix. La passerelle journalise déjà toutes les requêtes. Les en-têtes servent uniquement à lui indiquer lesquelles vont ensemble.
| En-tête | Envoyer la même valeur pour | Résultat |
|---|---|---|
X-Trace-Id | tous les appels d’une exécution (le traitement complet d’un message utilisateur) | les appels réunis dans un diagramme en cascade |
X-Span-Id | un seul appel | le nom de la ligne de cet appel dans le diagramme |
X-Session-Id | tous les appels d’une conversation | les exécutions regroupées, avec les totaux de la conversation |
Un span est une étape d’une trace. Dans ce guide, chaque span correspond à un appel de modèle. Chaque identifiant peut contenir jusqu’à 128 caractères ASCII imprimables. La passerelle renvoie les identifiants dans la réponse sans les transmettre au fournisseur du modèle.
Trois autres en-têtes sont facultatifs. X-Agent-Id indique quel sous-agent a effectué l’appel, X-Parent-Agent-Id quel agent a lancé ce sous-agent, et X-Synthorai-Metadata contient des labels comme la fonctionnalité ou l’utilisateur final. Ils sont tous décrits dans la référence des en-têtes de requête. La démonstration envoie X-Agent-Id et des labels, mais pas X-Parent-Agent-Id : son unique sous-agent est lancé par l’agent principal, sans imbrication à décrire.
Dans la démonstration, une seule fonction construit les en-têtes de chaque appel. C’est toute la couche de traçage :
@dataclass
class Run:
    """One agent run, which the gateway shows as one trace."""
    session_id: str
    labels: dict = field(default_factory=dict)
    trace_id: str = field(default_factory=lambda: new_id("trace"))

    def headers(self, span: str, agent: str | None = None, parent: str | None = None) -> dict:
        h = {
            "X-Session-Id": self.session_id,
            "X-Trace-Id": self.trace_id,
            "X-Span-Id": span,
        }
        if agent:
            # Only sub-agents need an id. Calls without one belong to the main agent.
            h["X-Agent-Id"] = agent
        if parent:
            h["X-Parent-Agent-Id"] = parent
        if self.labels:
            h["X-Synthorai-Metadata"] = json.dumps(self.labels, separators=(",", ":"))
        return h
Tous les appels de modèle de l’agent passent par une fonction qui ajoute ces en-têtes. Avec le SDK Python OpenAI, les en-têtes propres à une requête se passent dans extra_headers :
raw = await client.chat.completions.with_raw_response.create(
    model=model, messages=messages,
    extra_headers=run.headers(span, agent, parent), **kwargs)
resp = raw.parse()
request_id = raw.headers.get("x-request-id")   # the gateway's id for this call
with_raw_response sert uniquement à lire les en-têtes de réponse. Si vous n’avez pas besoin de l’identifiant de requête, un simple create(..., extra_headers=...) suffit.
Que fait l’agent de démonstration ?
Il répond à un message client en quatre étapes et cinq appels de modèle, choisis pour rendre la trace intéressante à lire. L’agent principal utilise GPT-6 Luna et le sous-agent DeepSeek V4.1 Flash ; les deux modèles se configurent par variables d’environnement. Les appels du sous-agent définissent reasoning_effort="none", car une vérification en une phrase ne nécessite pas de raisonnement préalable. Si vous utilisez un modèle qui refuse cette valeur, modifiez ou supprimez ANALYST_REASONING.
| Span | Qui | Déroulement |
|---|---|---|
plan | agent principal | lit le message et demande des outils (function calling : le modèle renvoie un nom de fonction et les arguments à exécuter dans votre code) |
| aucun | votre code | exécute les deux outils localement et en parallèle : une recherche de commande (1.2 s) et une recherche dans les règles de support (0.6 s) |
sentiment, policy-check, risk | sous-agent analyst | trois vérifications en une phrase, envoyées en même temps |
answer | agent principal | rédige la réponse à partir des résultats des outils et des trois vérifications |
Les outils sont de simples fonctions Python contenant un sleep, qui simulent une base de données et un index de recherche. Avec --fail, un appel policy-check demande d’abord un modèle inexistant, reçoit une 404, puis est relancé avec le nom de span policy-check.retry.
run.py joue deux conversations de deux tours chacune. Chaque conversation reçoit un identifiant de session, et chaque tour un nouvel identifiant de trace :
session_id, history = new_id("support"), []
for text in turns:
    run = Run(session_id, labels={"feature": "support-agent", "release": "v2", "_user": user})
    reply = await handle(run, history, text)
Comment lire le diagramme en cascade ?
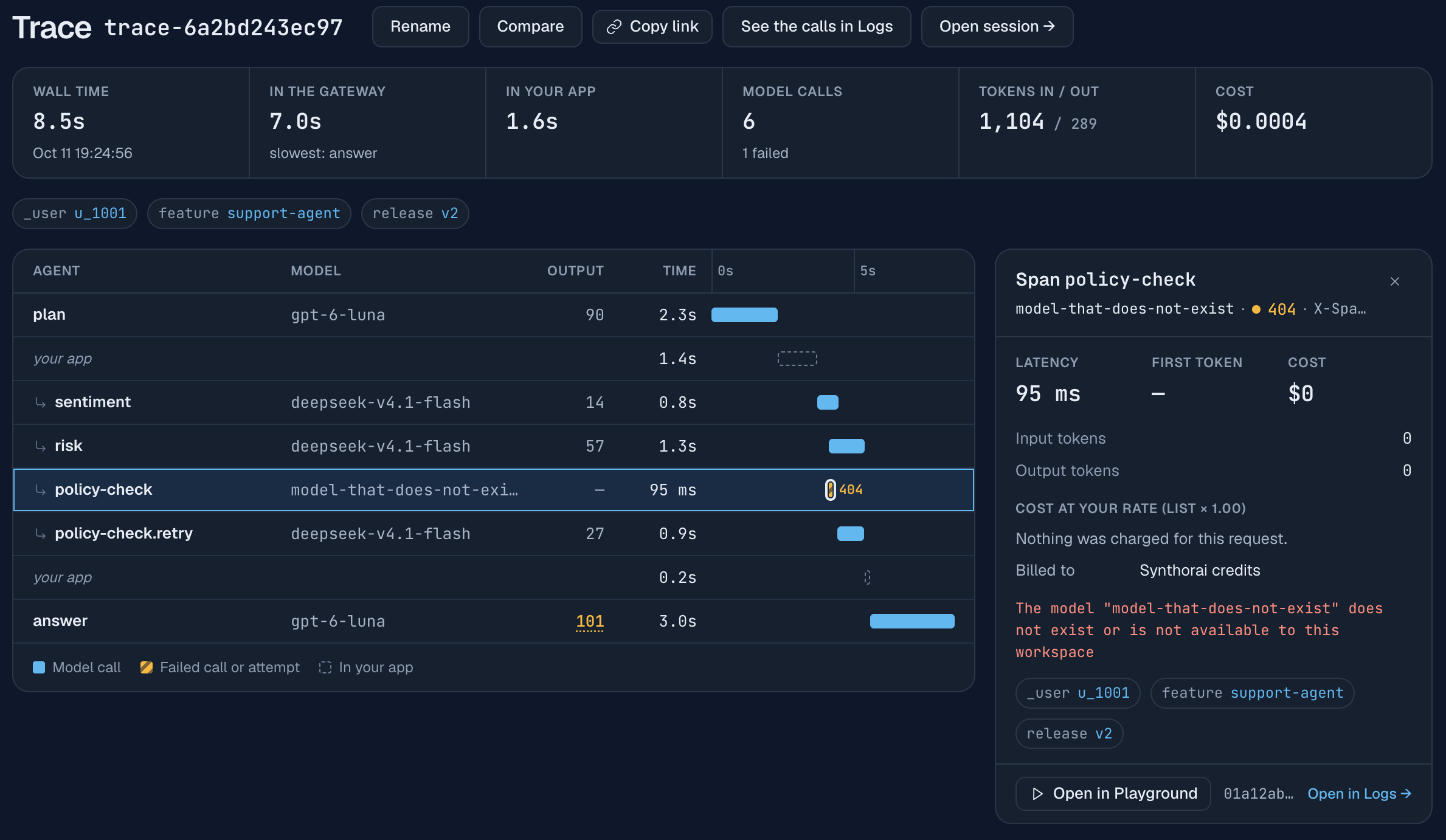
Chaque ligne représente un appel de modèle ou un intervalle passé dans votre code. L’axe temporel commence à l’arrivée du premier appel de l’exécution dans la passerelle. La capture ci-dessus correspond au deuxième tour de la première conversation. De haut en bas :
plana pris 2.3 s. Sa barre représente le temps passé par la passerelle sur cette requête, de sa réception à la fin de la réponse.your appa pris 1.4 s. Aucune requête n’était en cours pendant cet intervalle. Ce temps a donc été passé hors de la passerelle : dans votre code et sur le réseau entre votre code et la passerelle. Ici, il correspond aux deux outils locaux, dont le plus lent attend 1.2 s. Dans un agent réel, cette ligne fait ressortir une requête SQL ou une recherche vectorielle lente.sentiment,risketpolicy-check.retryse chevauchent. L’agent a envoyé les trois vérifications avecasyncio.gather. Le chevauchement des barres indique les appels parallèles. La flèche devant leur nom signale les appels d’un sous-agent.policy-checkapparaît sous forme de marque hachurée de 95 ms avec le code404. Un appel en échec reste dans la trace avec le code de statut reçu par votre code.answera pris 3.0 s et constitue l’appel le plus lent, ce que précise aussi le résumé au-dessus du diagramme.- La colonne Output indique les tokens de sortie de chaque appel. Un appel passe son temps à produire sa sortie. Cette colonne explique donc généralement la longueur de la barre voisine :
answera produit 101 tokens, et les trois vérifications entre 14 et 57 chacune. La console souligne le nombre lorsque le raisonnement représente la majeure partie d’une sortie plus longue, comme pour les 101 tokens ici.
Le résumé répartit les 8.5 s de temps total entre 7.0 s dans la passerelle et 1.6 s dans votre application. Cette répartition répond à la première question de la plupart des analyses de latence : faut-il examiner les appels de modèle ou votre code ? Dans cette exécution, 82% de l’attente vient des modèles. Les deux appels de l’agent principal, plan et answer, en représentent 5.3 s. Un modèle plus rapide pour l’agent principal aiderait donc davantage qu’une accélération des trois vérifications.
La passerelle ne voit pas l’intérieur de votre code. Elle déduit les lignes your app des intervalles entre les requêtes : un intervalle indique combien de temps votre code a tourné, pas ce qu’il a fait. Pour obtenir des spans sur vos propres fonctions, utilisez un SDK OpenTelemetry, le standard ouvert de traçage. Les deux peuvent partager leurs identifiants : en l’absence de X-Trace-Id, la passerelle lit traceparent, l’en-tête standard qui transporte un identifiant de trace.
Qu’apporte une session par rapport à une trace ?
Une session regroupe les exécutions d’une conversation et calcule leurs totaux. Ouvrez-en une depuis la liste Traces, ou utilisez « Open session » sur n’importe quelle trace.
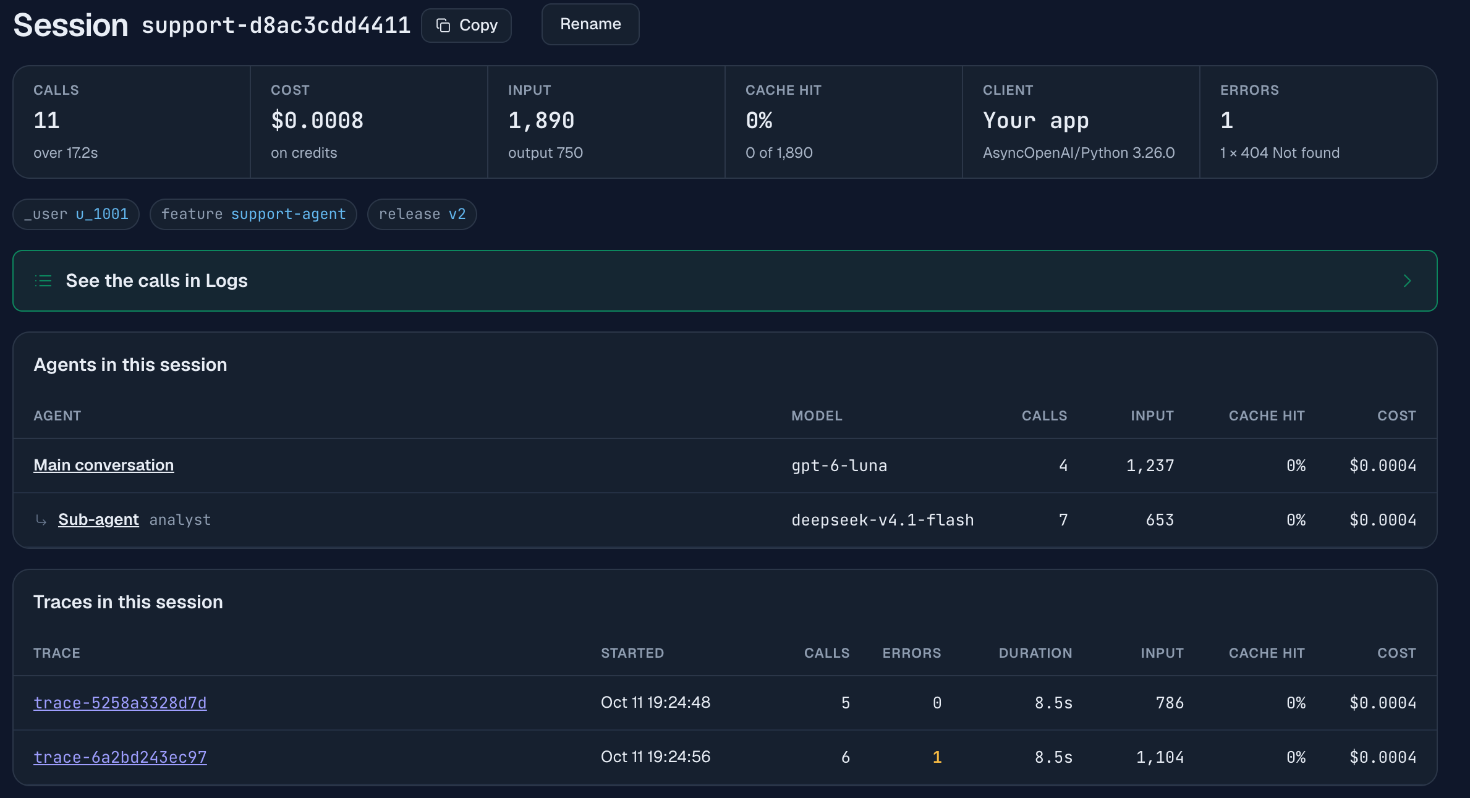
La session ci-dessus correspond à une conversation client de deux tours : 11 appels, 1,890 tokens d’entrée et 750 tokens de sortie, $0.0008, une erreur. La page comporte trois parties :
- Agents de cette session répartit les appels et le coût par agent. L’agent principal a effectué 4 appels sur GPT-6 Luna pour $0.0004. Le sous-agent
analysta effectué 7 appels pour $0.0004 : six sur DeepSeek V4.1 Flash et un en échec. Ce tableau apparaît parce que les appels du sous-agent portaientX-Agent-Id: analyst. Les appels sans cet en-tête sont comptés dans la conversation principale. - Traces de cette session liste chaque tour avec ses erreurs, sa durée, ses tokens d’entrée, son taux de cache et son coût. Vous pouvez ainsi repérer un tour lent, en échec ou coûteux dans une longue conversation sans parcourir un journal.
- Taux de cache indique la part des tokens d’entrée lus dans le cache de prompts du fournisseur. Il est de 0% ici, car les prompts ne font que quelques centaines de tokens. Les fournisseurs ne mettent en cache que les préfixes dépassant une longueur minimale (1,024 tokens pour la plupart ; voir la mise en cache des prompts).
L’identifiant de session a une seconde fonction, utile dès que vos prompts sont assez longs pour être mis en cache. Envoyez le même X-Session-Id sur tous les appels d’une conversation : la passerelle s’en sert pour maintenir la cohérence des accès au cache de prompts. Le deuxième tour lit ainsi le cache écrit au premier. Sur /v1/chat/completions et /v1/responses, vous pouvez placer cette valeur dans le corps de la requête sous session_id si votre framework rend l’ajout d’en-têtes peu pratique.
Comment répartir le coût par fonctionnalité ou par utilisateur ?
Envoyez X-Synthorai-Metadata avec un objet JSON plat dont les valeurs sont des chaînes, puis regroupez ou filtrez les résultats par ces métadonnées. La démonstration associe chaque appel à une fonctionnalité, une version et un utilisateur final :
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}Les labels apparaissent sous forme de petites étiquettes sur la trace et la session. Pour voir les totaux, ouvrez Analytics, sélectionnez l’onglet Breakdown et cherchez la carte Cost by metadata. Choisissez une clé : la carte liste toutes ses valeurs avec le nombre de requêtes, les erreurs, les tokens d’entrée et le coût :
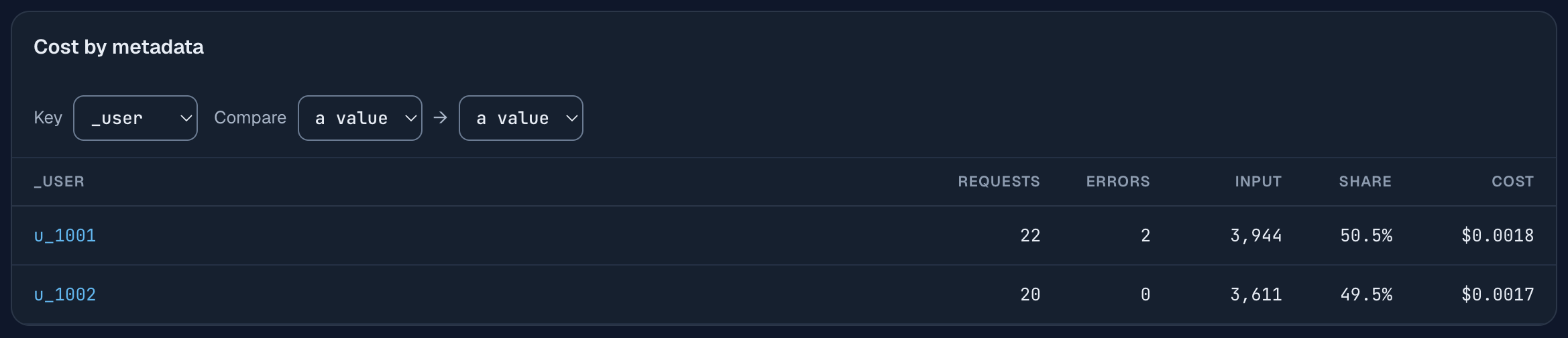
La carte ci-dessus couvre une heure pendant laquelle la démonstration a été exécutée deux fois : 22 requêtes et $0.0018 pour u_1001, dont les exécutions comprennent les deux appels en échec, et 20 requêtes et $0.0017 pour u_1002. Après une seule exécution, vous verrez 11 et 10. Choisissez la clé feature pour connaître la facture de chaque fonctionnalité, ou release pour mesurer l’effet d’un changement de prompt sur le coût. La carte permet aussi de comparer deux valeurs d’une clé côte à côte. Le même onglet contient une carte Cost by agent qui totalise chaque X-Agent-Id sur l’ensemble des sessions.
Les labels servent aussi à retrouver les exécutions derrière un chiffre. Saisissez metadata._user = u_1002 dans le champ de recherche de la liste Traces, puis appuyez sur Entrée : seules les sessions et traces de cet utilisateur restent affichées. Le champ de filtre de Logs accepte la même expression pour les requêtes individuelles.
Les règles des labels sont simples :
- Au plus 10 labels par requête. Une clé contient de 1 à 32 caractères parmi
a-z,0-9,_,.et-. Une valeur est une chaîne de 128 octets maximum. _userdésigne l’utilisateur final pour lequel la requête a été effectuée. Les autres clés commençant par un underscore sont réservées.- Un label non conforme est supprimé, mais la requête s’exécute quand même. L’en-tête de réponse
X-Synthorai-Metadata-Droppedindique les clés supprimées : journalisez-le pendant la mise en place. Pour vérifier, nous avons envoyé une clé nomméeBad?Key, et l’en-tête retourné contenait bienBad?Key. - Ne placez ni texte de prompt, ni données personnelles, ni secrets dans les labels. Pour
_user, utilisez votre identifiant utilisateur interne, pas une adresse e-mail.
Que se passe-t-il quand un appel échoue ?
Il reste dans la trace sous forme de marque hachurée avec son code de statut, et ne coûte rien. Dans la démonstration, l’appel policy-check en échec demandait un identifiant de modèle inexistant. Le sélectionner dans le diagramme ouvre le panneau à droite de la capture ci-dessus. Il affiche l’erreur reçue par le code : The model "model-that-does-not-exist" does not exist or is not available to this workspace, une latence de 95 ms, un coût de $0 et la mention qu’aucun montant n’a été facturé.
La démonstration donne un nom de span distinct à la nouvelle tentative :
try:
    await call(run, span, model=BROKEN_MODEL, messages=messages, agent="analyst")
except APIStatusError:
    span = f"{span}.retry"      # the retry is its own span, so both show in the waterfall
resp = await call(run, span, model=ANALYST_MODEL, messages=messages, agent="analyst", max_tokens=400,
                  **analyst_options())   # reasoning_effort="none" unless ANALYST_REASONING says otherwise
Conserver l’identifiant de trace et changer le nom du span permet d’afficher l’échec et la nouvelle tentative côte à côte dans le même diagramme. Si les retries sont gérés par une bibliothèque qui réutilise les mêmes en-têtes, les deux tentatives apparaissent quand même, sur deux lignes portant le même nom.
Les erreurs sont aussi agrégées. Le résumé de la trace indique « 6 appels de modèle, 1 en échec », la session liste ses erreurs par code de statut (1 × 404 Not found), et la liste Traces possède une colonne Errors triable pour retrouver les exécutions à examiner.
Comment récupérer le coût de chaque appel dans le code ?
Demandez à la passerelle l’enregistrement de facturation de la requête, à partir de l’identifiant renvoyé dans la réponse. GET /v1/generation?id=<request id> retourne le coût, les nombres de tokens, la latence et le statut d’une requête.
async def cost_of(http: httpx.AsyncClient, request_id: str) -> float | None:
    """The billing record of one request. It is written a moment after the call returns."""
    if not request_id:
        return None                                  # a call that got no response has no record
    for _ in range(6):
        try:
            r = await http.get(f"{BASE_URL}/generation", params={"id": request_id})
            if r.status_code == 200:
                return r.json()["data"]["total_cost"]
        except (httpx.HTTPError, KeyError, TypeError, ValueError):
            pass                                     # a dropped connection or a half-written record: try again
        await asyncio.sleep(2)
    return None
L’enregistrement est écrit peu après la fin de la réponse. La fonction réessaie donc jusqu’à obtenir un 200. Elle reçoit un httpx.AsyncClient que l’appelant crée une seule fois, avec l’en-tête Authorization, puis transmet à chaque consultation. Consulter vingt appels avec un seul client réutilise quelques connexions. Créer un client pour chaque consultation ouvre vingt connexions en même temps ; lors de nos tests, une ou deux ont été coupées. La démonstration affiche une ligne par appel à partir de ses propres mesures de temps et de ces enregistrements. Voici le premier tour de la session présentée dans les captures :
trace trace-5258a3328d7d  session support-d8ac3cdd4411
  plan                 main     gpt-6-luna                 200   1878 ms    153 in   22 out  $0.000026
  sentiment            analyst  deepseek-v4.1-flash        200   1431 ms     91 in   28 out  $0.000061
  risk                 analyst  deepseek-v4.1-flash        200   1877 ms     96 in   33 out  $0.000068
  policy-check         analyst  deepseek-v4.1-flash        200   1885 ms     96 in   39 out  $0.000076
  answer               main     gpt-6-luna                 200   4142 ms    350 in  339 out  $0.000205
Ces temps sont mesurés côté client et incluent le réseau. Ils sont donc supérieurs aux barres de la console, qui mesurent la requête à l’intérieur de la passerelle. Au deuxième tour, celui du diagramme ci-dessus, plan a pris 2,499 ms côté client et 2.3 s dans la passerelle ; answer, 3,161 ms et 3.0 s. L’écart peut être plus grand pour les appels envoyés en parallèle : l’appel en échec a pris 694 ms côté client et 95 ms dans la passerelle.
Copiez cette fonction si vous voulez inscrire le coût facturé de chaque appel dans vos journaux. Elle ne convient pas pour arrêter une exécution qui dépense trop : chaque enregistrement arrive après l’appel, et la fonction peut l’attendre plusieurs secondes. Pour suivre un budget en temps réel, calculez vous-même le coût à partir du usage de chaque réponse au fil de l’exécution. Utilisez ensuite ces enregistrements pour vérifier vos calculs.
Et si votre agent envoie déjà des en-têtes de traçage ?
Vous n’avez peut-être rien à ajouter. Pour chacun des trois identifiants absent de la requête, la passerelle lit l’en-tête équivalent déjà envoyé par les outils courants :
| Outil utilisé | En-tête envoyé | Interprétation |
|---|---|---|
| Instrumentation HTTP OpenTelemetry | traceparent | trace, avec son identifiant parent comme span |
| SDK LiteLLM | X-Litellm-Trace-Id, X-Litellm-Session-Id | trace, session |
| SDK Langfuse | baggage: langfuse_trace_id=…, langfuse_session_id=… | trace, session |
| Open WebUI | X-OpenWebUI-Chat-Id | session |
| Claude Code | X-Claude-Code-Session-Id | session |
| OpenAI Codex CLI | Session-Id | session |
Vos propres X-Trace-Id, X-Span-Id et X-Session-Id sont prioritaires lorsque les deux sont présents. La liste complète figure dans la référence des en-têtes de requête. Pour les frameworks d’agents qui n’envoient aucun de ces en-têtes, ajoutez-les via leur option de configuration des en-têtes personnalisés.
Que faire d’une trace une fois obtenue ?
L’usage le plus courant consiste à la comparer à une autre. Chaque page de trace possède un bouton Compare : choisissez une deuxième trace, et la console affiche les deux sur la même page. Chaque métrique présente A, B et la variation ; chaque appel est associé à celui de même nom ; les deux diagrammes partagent un axe temporel. Vous pouvez ainsi vérifier l’effet d’un changement de prompt, de modèle ou de code sur une exécution.
Trois guides complémentaires utilisent le même agent et les mêmes en-têtes. Chacun reproduit des problèmes, les corrige et compare les résultats de cette façon :
- Pourquoi mon agent LLM est-il lent ? Appels séquentiels, outil lent dans votre code et raisonnement pour des réponses d’une ligne.
- Pourquoi mon agent LLM coûte-t-il cher ? Horodatage qui invalide le cache, contexte qui grossit, boucle de retries et mauvais modèle.
- Déboguer un agent LLM D’une plainte utilisateur à l’appel qui a posé problème.
Trois autres abordent le même journal sous d’autres angles :
- Coût de Claude Code par sous-agent Un agent de développement que vous n’avez pas écrit, analysé avec les mêmes vues de session et d’agent.
- Interroger Claude sur vos journaux LLM Des questions sur ces sessions, avec des réponses dans une fenêtre de chat via une connexion MCP en lecture seule.
- Donner à votre agent des outils de consultation des journaux Les mêmes outils dans votre propre programme, et le coût des tokens du modèle.
Qu’est-ce qui n’est pas couvert ?
La démonstration couvre les appels de modèle. Une installation en production ajoute généralement quatre éléments :
- Des spans pour votre code. La passerelle montre les intervalles entre les appels de modèle, mais pas ce qui s’y passe. Instrumentez les outils, la récupération de données et les files d’attente avec OpenTelemetry, puis propagez
traceparentpour qu’un même identifiant de trace relie les deux vues. - Le contenu des prompts et des réponses. Ce guide utilise les enregistrements de durée, de tokens et de coût de chaque appel. Il ne traite pas de l’inspection du contenu envoyé au modèle.
- Des budgets.
cost_offournit le montant facturé après coup. Pour arrêter une exécution à une limite donnée, il faut calculer le coût duusagede chaque réponse dès son arrivée. Cela représente quelques lignes dans la boucle de l’agent, absentes de la démonstration. - L’échantillonnage. Tous les appels sont enregistrés, car la trace est construite à partir du journal de requêtes que la passerelle conserve déjà. Il n’y a rien à échantillonner, et le seul surcoût côté agent est l’ajout de quelques en-têtes.
FAQ
Faut-il OpenTelemetry pour tracer un agent LLM ?
Non. Trois en-têtes de requête (X-Trace-Id, X-Span-Id, X-Session-Id) sur chaque appel de modèle suffisent pour obtenir un diagramme en cascade des appels, avec le temps entre eux attribué à votre application. OpenTelemetry devient utile si vous voulez aussi des spans pour vos propres fonctions.
Quelle est la différence entre une trace et une session ?
Une trace correspond à une exécution de l’agent : tout ce qui est fait pour traiter un message utilisateur ou une tâche. Une session correspond à une conversation composée de plusieurs exécutions. Dans la démonstration, chaque conversation client est une session de deux traces, et chaque trace contient cinq ou six appels de modèle.
Les en-têtes de traçage changent-ils le routage, la facturation ou ce que voit le modèle ?
X-Trace-Id et X-Span-Id ne changent rien. X-Session-Id maintient la cohérence des accès au cache de prompts d’une conversation. Aucun de ces en-têtes n’est transmis au fournisseur du modèle, et la facturation repose sur l’identifiant de requête propre à la passerelle.
Combien de temps les traces sont-elles conservées ?
Les traces et les sessions sont construites à partir du journal de requêtes et couvrent les mêmes 90 jours. La liste Traces s’ouvre sur les 7 derniers jours.
Un appel en échec coûte-t-il quelque chose ?
L’appel en échec de la démonstration, une 404 pour un identifiant de modèle inconnu, a été enregistré avec un coût de $0 et la mention qu’aucun montant n’avait été facturé.
Pour aller plus loin
- Créer un chatbot LLM : le cas d’un agent unique, avec gestion du contexte, mémoire et mise en cache des prompts.
- Référence des en-têtes de requête : tous les en-têtes de cette page, ainsi que les alias lus depuis d’autres outils.
- Traces et sessions dans la console : la liste, le diagramme en cascade et la page de session.
- Comprendre l’utilisation des tokens LLM : la signification des nombres de tokens de chaque enregistrement, par fournisseur.