
Claude Code : où vont $0.17, sous-agent par sous-agent
Une exécution de Claude Code via une passerelle : les premiers appels des trois agents représentent 72% des $0.17 facturés. Deux variables suffisent.
Nos choix
prix en direct| Modèle | Verdict | Prix |
|---|---|---|
| Claude Sonnet 5.5 Une exécution de Claude Code de 11 appels avec deux sous-agents a coûté $0.1728 avec un cache froid, puis $0.0812 une demi-minute plus tard. Les écritures dans le cache représentaient 77% du coût de l’exécution à froid. | Modèle de la démo | dès $2/M |
Sommaire
- Comment faire passer Claude Code par une passerelle ?
- Que voit la passerelle sans configuration supplémentaire ?
- Où sont passés les $0.17 ?
- Combien coûte une deuxième exécution ?
- Le coût affiché par Claude Code correspond-il à la facture ?
- Comment répartir les dépenses par développeur ou par dépôt ?
- Comment voir le coût des agents sur plusieurs sessions ?
- Que manque-t-il à cette configuration ?
- FAQ
- Combien coûte une session Claude Code ?
- Comment suivre les coûts de Claude Code pour une équipe ?
- Les sous-agents de Claude Code coûtent-ils plus cher ?
- Le coût affiché par Claude Code est-il exact ?
- Que fait CLAUDE_CODE_GATEWAY_HINT_HEADERS ?
- Pour aller plus loin
Claude Code affiche le coût d’une session, mais pas sa répartition. Et dès qu’une équipe l’utilise, impossible de savoir à quel dépôt ou à quel développeur attribuer la facture. Faire passer Claude Code par une passerelle, un proxy entre Claude Code et le fournisseur du modèle, répond aux deux questions sans plugin ni wrapper. La passerelle voit déjà chaque requête, et Claude Code y joint déjà un identifiant de session et un identifiant d’agent. Dans cet article, nous exécutons une petite tâche via la passerelle Synthorai et examinons le résultat : $0.1728 pour 11 requêtes, dont 72% pour le premier appel de chacun des trois agents.
TL;DR
- Une exécution de Claude Code sur Claude Sonnet 5.5 avec deux sous-agents a coûté $0.1728 via une passerelle, puis $0.0812 en la relançant une demi-minute plus tard.
- Les écritures en cache représentaient 77% de la première exécution, et les premiers appels des trois agents, 72%.
- Les deux sous-agents représentaient 39% du coût de la session.
- Deux variables d’environnement font passer Claude Code par une passerelle. Une troisième indique le type de chaque sous-agent.
Le code est disponible sur github.com/synthorai-io/use-cases, dans coding-agent-spend/. Il faut Python 3.10 ou une version ultérieure, ainsi que la commande claude en version 2.1.280 ou ultérieure, requise par ce modèle.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd coding-agent-spend
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --hints --label repo=shipping --label _user=dev_1
Le script lance Claude Code sur une copie d’un petit dépôt d’exemple contenant un test en échec. Il définit l’adresse de la passerelle et la clé uniquement dans l’environnement de ce processus, avec un répertoire de configuration vide. Il ne lit donc pas votre configuration Claude Code et ne la modifie pas. Une exécution prend environ une demi-minute. Le script limite chaque exécution à $0.60 avec --max-budget-usd et refuse d’en lancer une qui pourrait porter son total au-delà de $2.
Les chiffres de cette page proviennent d’exécutions du 10 octobre 2026, avec Claude Code 2.1.296 sur Claude Sonnet 5.5.
Comment faire passer Claude Code par une passerelle ?
Il suffit de définir deux variables d’environnement. Claude Code utilise l’API Messages d’Anthropic, et la passerelle expose la même API à sa propre adresse :
export ANTHROPIC_BASE_URL="https://synthorai.io"   # no /v1: Claude Code adds /v1/messages itself
export ANTHROPIC_API_KEY="<your gateway key>"
Rien d’autre ne change. La page d’intégration de Claude Code détaille la configuration. Dès lors, chaque appel au modèle, dans chaque session, apparaît dans le journal des requêtes de la passerelle, et la console les regroupe.
Que voit la passerelle sans configuration supplémentaire ?
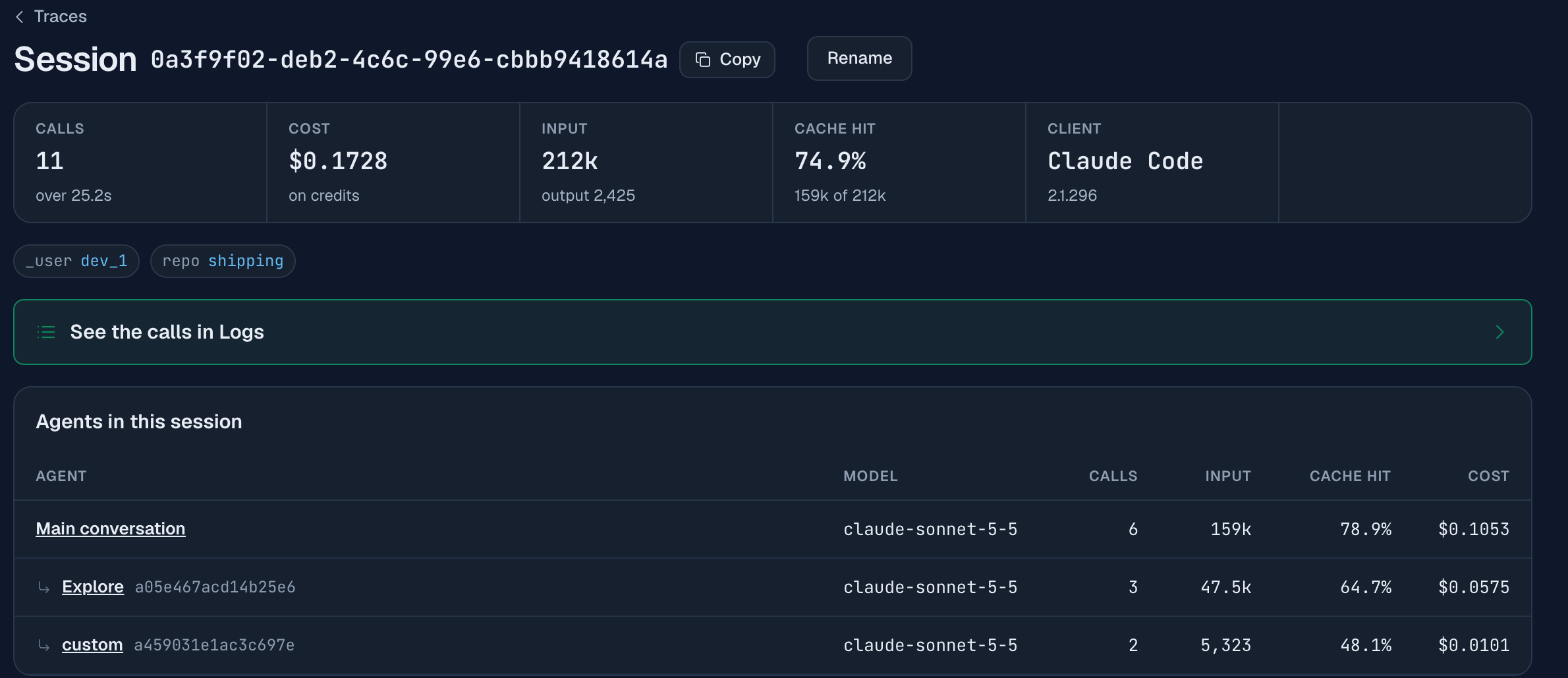
Elle voit la session, ses traces, le client et chaque sous-agent. Claude Code envoie son identifiant de session avec chaque requête : une exécution de claude correspond donc à une session dans la console, dont la page affiche le client « Claude Code 2.1.296 ». Les requêtes y affichent aussi un identifiant de trace. La session liste ainsi ses traces : deux pour cette exécution, avec 6 et 5 appels. Le tableau « Agents de cette session » sépare déjà les appels entre la conversation principale et une ligne par sous-agent.
Un sous-agent est un second agent que Claude Code lance pour une partie de la tâche, avec ses propres instructions et son propre contexte. La tâche de la démo en demande deux : le sous-agent intégré Explore pour trouver où se situe une règle, et un sous-agent personnalisé test-runner pour lancer les tests.
Par défaut, un sous-agent apparaît sous un identifiant tel que a05e467acd14b25e6. On voit qu’il y en a deux, mais pas lequel fait quoi. Une variable supplémentaire règle ce problème :
export CLAUDE_CODE_GATEWAY_HINT_HEADERS=1| Par défaut | Avec la variable d’indication | |
|---|---|---|
| Session, traces, client et coût | Oui | Oui |
| Sous-agents séparés, par identifiant | Oui | Oui |
Type du sous-agent (Explore, custom) | Non | Oui |
| Nature de chaque appel et outils exécutés avant lui | Non | Oui |
Avec cette variable, le tableau identifie chaque sous-agent par son type. Dans Logs, ouvrir un appel affiche sa nature (subagent:Explore) et une liste « Outils exécutés avant cet appel », avec le nom et la durée d’exécution de chaque outil, par exemple Read 7 ms. La passerelle conserve le type de l’agent, pas le nom que vous lui avez donné : test-runner apparaît donc comme custom. Les noms des outils et leurs durées sont conservés, mais pas ce qu’ils ont lu ou écrit.
Où sont passés les $0.17 ?
Ils se répartissent entre trois agents, surtout sur le premier appel de chacun.
| Agent | Appels | Tokens d’entrée | Taux de succès du cache | Coût |
|---|---|---|---|---|
| Conversation principale | 6 | 159k | 78.9% | $0.1053 |
| Sous-agent Explore | 3 | 47.5k | 64.7% | $0.0575 |
Sous-agent custom (test-runner) | 2 | 5,323 | 48.1% | $0.0101 |
| Session | 11 | 212k | 74.9% | $0.1728 |
Les deux sous-agents ont coûté $0.0676, soit 39% de la session, pour les deux opérations les plus simples de la tâche : trouver une règle dans une bibliothèque de trois fichiers source et exécuter cinq tests. La correction elle-même portait sur un seul caractère, de > à >=.
L’explication se trouve dans les compteurs de tokens que Claude Code affiche en fin d’exécution :
claude-sonnet-5-5 20 in 158612 cache read 53058 cache write 2425 out $0.1728Avec les tarifs du modèle ($2 par million de tokens d’entrée, $10 en sortie, $0.10 pour une lecture du cache et $2.50 pour une écriture), ces quatre compteurs donnent :
| Type de token | Tokens | Coût | Part |
|---|---|---|---|
| Écriture en cache | 53,058 | $0.1326 | 77% |
| Sortie | 2,425 | $0.0243 | 14% |
| Lecture du cache | 158,612 | $0.0159 | 9% |
| Entrée hors cache | 20 | $0.0000 | 0% |
Les écritures en cache représentent 77% de la facture. Une écriture correspond au premier envoi d’un préfixe de prompt : elle coûte 1.25 fois le tarif d’entrée. Sur ce modèle, les requêtes suivantes le lisent à un vingtième du tarif d’entrée. Le prompt d’un agent de programmation est déjà long avant que vous ne saisissiez quoi que ce soit : il contient le prompt système et la définition de tous les outils. Le premier appel d’un agent est donc le plus cher.
Chaque agent démarre avec son propre prompt et paie donc ce premier appel :
| Premier appel de | Tokens d’entrée | Taux de succès du cache | Coût |
|---|---|---|---|
| Conversation principale | 30.0k | 0% | $0.0772 |
| Sous-agent Explore | 14.9k | 0% | $0.0391 |
| Sous-agent custom | 2,562 | 0% | $0.0077 |
Ces trois appels coûtent $0.1240, soit 72% de l’exécution. La suite coûte peu : les deuxième et troisième appels du sous-agent Explore lisent 94% de leurs tokens d’entrée depuis le cache et coûtent $0.0052 et $0.0132.
Le démarrage à froid d’un sous-agent se justifie lorsqu’il évite de charger beaucoup de contenu dans le contexte de la conversation principale. C’est le rôle d’Explore dans une vraie base de code. Pour une tâche qui ne demande qu’un ou deux appels, la traiter dans la conversation principale évite une écriture en cache supplémentaire. Il s’agit ici d’un petit dépôt : vérifiez la répartition dans vos propres sessions avant de changer votre façon de travailler.
Combien coûte une deuxième exécution ?
Environ moitié moins si elle démarre alors que le cache est encore chaud. Nous avons relancé la même tâche une demi-minute plus tard. Elle a produit les mêmes 11 appels, lu 93.1% de ses tokens d’entrée depuis le cache contre 74.9% lors de la première exécution, et coûté $0.0812 contre $0.1728. Ses trois premiers appels ont lu 82%, 81% et 71% depuis le cache, car leurs prompts initiaux y figuraient déjà depuis l’exécution précédente.
Le cache d’Anthropic conserve une entrée pendant cinq minutes par défaut et renouvelle ce délai à chaque lecture. Un développeur qui travaille en continu dans un même dépôt paie surtout le tarif à chaud. Une tâche planifiée une fois par heure paie le tarif à froid à chaque exécution.
Le coût affiché par Claude Code correspond-il à la facture ?
Sur la version 2.1.296, oui, à la quatrième décimale : $0.1728 à froid et $0.0812 à chaud des deux côtés. Cela dépend de la version. Claude Code calcule le coût à partir de sa propre grille tarifaire. Sur la version 2.1.278, qui exécutait encore ce modèle le 8 octobre, il appliquait $5 et $25 par million de tokens d’entrée et de sortie, alors que les tarifs facturés étaient $2 et $10. Il affichait donc environ 2.7 fois le montant facturé. Les compteurs de tokens étaient identiques des deux côtés à chaque fois.
Cela a un effet sur un réglage : --max-budget-usd arrête l’exécution lorsque le montant calculé par Claude Code atteint la limite. Sur l’ancienne version, une exécution s’arrêtait à $0.60 selon Claude Code, alors que le montant facturé était d’environ un tiers de cette somme. Après une mise à jour, comparez une fois le montant avec la page de session. Placez la limite sur laquelle vous comptez là où les coûts sont facturés : dans une limite de dépenses sur la clé API.
Comment répartir les dépenses par développeur ou par dépôt ?
Ajoutez un label à chaque requête. Claude Code peut l’envoyer via une variable qu’il prend déjà en charge pour les en-têtes personnalisés :
export ANTHROPIC_CUSTOM_HEADERS='X-Synthorai-Metadata: {"repo":"shipping","_user":"dev_1"}'X-Synthorai-Metadata est l’en-tête de la passerelle destiné aux labels : un objet JSON plat contenant jusqu’à 10 chaînes courtes. La clé _user désigne la personne pour laquelle la requête a été faite. Les options --label de la démo définissent exactement cet en-tête, et la page de session ci-dessus affiche les deux labels sous forme de tags.
Définissez la variable pour chaque développeur dans son profil shell, et pour chaque dépôt dans le mécanisme qui charge les variables d’environnement du projet. Vous obtenez alors deux vues :
- Dans Traces, le champ de recherche accepte
metadata.repo = shippinget liste les sessions de ce dépôt. - Dans l’onglet Breakdown d’Analytics, la carte Cost by metadata totalise les requêtes et leur coût pour chaque valeur d’une clé.
repodonne donc la facture par dépôt, et_userla facture par développeur.
Cela fonctionne avec une seule clé partagée. Des clés distinctes par développeur permettent la même répartition des coûts et ajoutent des limites de dépenses individuelles, mais il faut gérer davantage de clés.
Comment voir le coût des agents sur plusieurs sessions ?
Utilisez la carte Cost by agent dans l’onglet Breakdown d’Analytics. La page de session détaille une seule session. Cette carte regroupe toutes les sessions de la période par type d’agent :
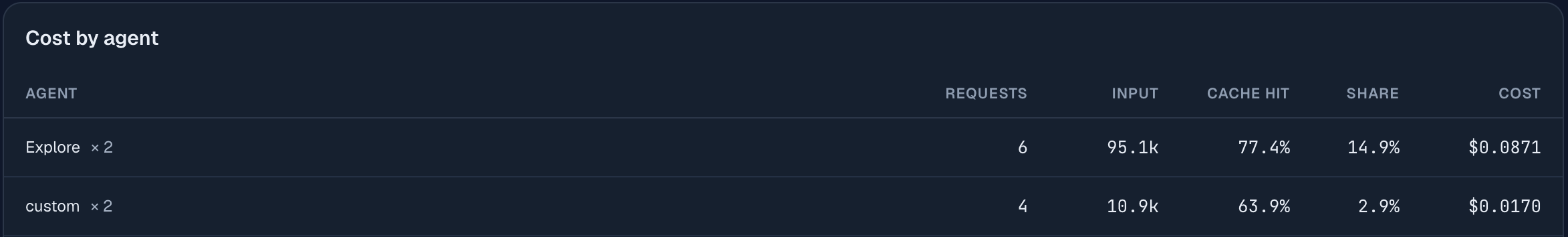
Explore × 2 et custom × 2 correspondent aux exécutions à froid et à chaud ci-dessus, avec un total par type d’agent sur les deux sessions. La colonne Share indique la part de chaque ligne dans l’ensemble des dépenses de la période, qui comprenait aussi d’autres sessions. Sans la variable d’indication, les sous-agents d’une exécution ne déclarent aucun type et sont regroupés dans une ligne « Sous-agent ». Un agent de votre propre programme qui définit lui-même X-Agent-Id, comme celui de Suivre les traces d’un agent LLM, obtient une ligne portant le nom qu’il a envoyé.
Sur une semaine de sessions d’équipe, cette vue permet de savoir si les sous-agents représentent une petite ou une grande part de la facture, et quels types sont concernés.
Que manque-t-il à cette configuration ?
Elle ne fournit ni identifiants de span, ni noms pour les agents personnalisés, ni raccourci pour isoler l’exécution, ni vue du travail effectué.
- Pas d’identifiants de span. Les requêtes de Claude Code 2.1.296 affichent un identifiant de session et un identifiant de trace, mais aucun identifiant de span. Le champ span d’un appel indique donc « non envoyé ». L’analyse se fait au niveau des sessions, de leurs traces et de leurs agents.
- Pas de noms pour les agents personnalisés. Tous les sous-agents personnalisés sont de type
custom. Si vous en utilisez plusieurs sortes et devez les distinguer, leur identifiant sur la page de session est le seul repère. - Pas de raccourci pour isoler l’exécution.
--baresemble permettre de lancer Claude Code sans vos plugins ni vos réglages. Mais cette option désactive aussi les sous-agents : la session n’a alors qu’un agent, sans répartition possible. La démo isole plutôt l’exécution avec unCLAUDE_CONFIG_DIRvide. - Pas de vue du travail effectué. La passerelle enregistre les appels au modèle, les noms des outils et leurs durées d’exécution. Elle n’enregistre ni le contenu des fichiers, ni les diffs, ni la sortie des commandes.
FAQ
Combien coûte une session Claude Code ?
Cela dépend du modèle, de la taille du dépôt, du nombre d’agents et de l’état du cache. L’exécution présentée ici, 11 requêtes sur Claude Sonnet 5.5 pour corriger un bug d’un caractère avec deux sous-agents, a coûté $0.1728 avec un cache froid et $0.0812 en la relançant une demi-minute plus tard.
Comment suivre les coûts de Claude Code pour une équipe ?
Configurez le Claude Code de chaque développeur pour utiliser une passerelle avec ANTHROPIC_BASE_URL, puis ajoutez un label pour le développeur et le dépôt via ANTHROPIC_CUSTOM_HEADERS. La passerelle totalise ensuite les coûts par session, par valeur de label et par type d’agent, sans rien installer dans Claude Code.
Les sous-agents de Claude Code coûtent-ils plus cher ?
Chaque sous-agent démarre avec son propre prompt et paie sa propre écriture en cache. Dans la démo sur Claude Sonnet 5.5, le premier appel du sous-agent Explore a coûté $0.0391, puis les deux suivants $0.0052 et $0.0132. Les deux sous-agents représentaient ensemble 39% de la session. Ce coût donne accès à un contexte séparé, utile pour les explorations importantes, mais pas pour les tâches d’un seul appel.
Le coût affiché par Claude Code est-il exact ?
Vérifiez-le une fois par version. Claude Code 2.1.296 affichait $0.1728, soit exactement le montant facturé. Claude Code 2.1.278 appliquait à Claude Sonnet 5.5 des tarifs de $5 et $25 par million de tokens, contre $2 et $10 sur la facture. Le montant affiché était environ 2.7 fois supérieur à la facture. Les compteurs de tokens concordaient dans les deux versions.
Que fait CLAUDE_CODE_GATEWAY_HINT_HEADERS ?
Cette variable fait envoyer trois informations supplémentaires par Claude Code avec chaque requête : le type de l’agent, la nature de l’appel, ainsi que les noms et les durées des outils exécutés avant cet appel. Sans elle, la passerelle voit toujours la session et chaque sous-agent, mais seulement par leur identifiant.
Pour aller plus loin
- Suivre les traces d’un agent LLM : les mêmes vues de la console pour un agent que vous développez vous-même.
- Pourquoi mon agent LLM coûte-t-il cher ? : défauts de cache, contexte qui grossit et boucles de relance, reproduits puis corrigés.
- Pourquoi mon agent LLM est-il lent ? et Déboguer un agent LLM : analyser les mêmes vues pour comprendre la latence et les échecs.
- Interroger Claude sur vos logs LLM : poser des questions sur ces sessions via le serveur MCP de la passerelle.
- Donner à votre agent des outils de lecture des logs : lire les mêmes logs depuis votre propre programme et mesurer le coût des tokens du modèle.
- Intégration de Claude Code : les deux variables et les noms des modèles.
- Référence des en-têtes de requête : les en-têtes de Claude Code et des autres agents que lit la passerelle.