
GPT-6 Luna vs GPT-5.6 Luna : moitié prix, moitié moins de mots
Sommaire
- GPT-6 Luna face à GPT-5.6 Luna sur les benchmarks
- Qu’est-ce qui change, à part le prix ?
- Comment avons-nous procédé ?
- GPT-6 Luna écrit-il moins que GPT-5.6 Luna ?
- GPT-6 Luna omet-il des éléments ?
- Comment retrouver la longueur et les détails manquants ?
- Combien économise-t-on avec GPT-6 Luna ?
- Nos résultats concordent-ils avec les autres tests publiés ?
- Que retenir, et quel modèle choisir ?
- FAQ
GPT-6 Luna fait jeu égal avec GPT-5.6 Luna sur les benchmarks publics (38 contre 37 sur l’Artificial Analysis Intelligence Index), pour un coût par tâche environ deux fois moindre. La différence se voit dans la longueur des réponses : quand le prompt se limite à un objectif (« rédige le bilan du T3 »), GPT-6 Luna écrit 0.55x autant de mots sur 80 documents professionnels. Il ne saute pas les éléments explicitement demandés. Quand le prompt les précise, les deux modèles produisent des documents aussi complets l’un que l’autre. Sur les prompts limités à l’objectif, le seul détail que GPT-6 Luna omet plus souvent est la durée d’un incident.
TL;DR
- Artificial Analysis attribue 38 à GPT-6 Luna et 37 à GPT-5.6 Luna avec l’effort
max, pour $0.07 contre $0.18 par tâche. - Sur les prompts limités à l’objectif, GPT-6 Luna écrit 384 mots par document contre 703 pour GPT-5.6 Luna.
- GPT-6 Luna omet la durée de l’incident dans 9 postmortems sur 20 avec un prompt limité à l’objectif, contre 2 pour GPT-5.6 Luna.
- Quand les éléments demandés sont précisés, GPT-6 Luna produit 74 documents complets sur 80 contre 69, pour $0.81 contre $1.61 les 1 000.
GPT-6 Luna face à GPT-5.6 Luna sur les benchmarks
GPT-6 Luna égale GPT-5.6 Luna sur les benchmarks généralistes, pour un coût par tâche inférieur de 48 % à 61 %. Les résultats divergent seulement pour les documents évalués selon une grille de critères. Les scores correspondent à un niveau de reasoning effort, le paramètre API qui règle l’effort de raisonnement du modèle avant sa réponse (de none à max, avec medium par défaut). Les chiffres proviennent des pages des organismes qui publient ces évaluations, consultées le 2026-10-02.
| GPT-6 Luna | GPT-5.6 Luna | |
|---|---|---|
| Date de sortie | 2026-09-22 | 2026-07-09 |
| Prix catalogue, entrée / sortie par million de tokens | $0.10 / $0.50 | $0.20 / $1.20 |
| Artificial Analysis Intelligence Index v4.3.2 avec l’effort max (10 évaluations : connaissances, raisonnement, code, tâches agentiques et documents professionnels) | 38 | 37 |
| Coût par tâche de l’index | $0.07 | $0.18 |
| Vals Index (code, droit, fiscalité, finance et autres tâches professionnelles) | 51.2% | 51.7% |
| Coût par test Vals | $0.43 | $0.82 |
| GDPval-AA v2.1, score Elo avec l’effort max (documents professionnels évalués selon une grille de critères non publiée ; le score Elo est établi à partir de comparaisons directes, et plus il est élevé, meilleur est le résultat) | 1438 | 1463 |
| Score Elo GDPval-AA v2.1 avec l’effort medium | 1262 | 1133 |
| Vitesse de sortie, tokens par seconde | 131 | 124 |
C’est sur GDPval-AA que les critiques envers GPT-6 Luna ont commencé. Dans son analyse de lancement, Artificial Analysis plaçait GPT-6 Luna environ 75 points Elo derrière GPT-5.6 Luna sur GDPval-AA et environ 45 points derrière sur AA-Briefcase v1.1, un autre benchmark de documents. L’organisme attribuait cet écart à une « qualité de présentation moindre et à des livrables qui omettent des éléments de la grille d’évaluation » ; les évaluateurs parlaient de « format tax ». Le classement affiche maintenant 25 points d’écart avec l’effort max, tandis qu’avec l’effort medium, GPT-6 Luna a 129 points d’avance.
Face aux autres fournisseurs, GPT-6 Luna se positionne sur le segment flash, celui des modèles rapides et peu coûteux. Sur le même index, DeepSeek V4.1 Flash obtient 39 avec l’effort max, à $0.27 par tâche, et Gemini 3.8 Flash obtient 41 avec l’effort high, à $1.24. GPT-6 Luna cède donc 1 à 3 points, mais coûte 4 à 18 fois moins par tâche. Les deux concurrents génèrent plus vite, à 209 et 249 tokens par seconde.
Qu’est-ce qui change, à part le prix ?
GPT-6 Luna conserve les limites et les paramètres de GPT-5.6 Luna ; seuls le prix du cache et la date limite des connaissances changent. Les deux disposent d’une fenêtre de contexte de 1,050,000 tokens et d’une limite de sortie de 128,000 tokens. Dès que le prompt dépasse 272K tokens, toute la requête est facturée à 2x le prix d’entrée et 1.5x le prix de sortie. Le prix des tokens d’entrée en cache passe de $0.02 à $0.01 par million de tokens, et la date limite des connaissances passe du 16 février au 18 mai 2026. Sur la Responses API, l’effort se règle avec reasoning.effort (none, low, medium, high, xhigh, max). Les tokens de raisonnement ne sont pas visibles et sont facturés comme des tokens de sortie.
Une semaine après le lancement, OpenAI a sorti GPT-6.1 Sol pour remplacer GPT-6 Sol dans la gamme supérieure. Nos mesures de GPT-6.1 Sol montrent que ses réponses ont retrouvé leur longueur précédente. Luna n’a pas été mis à jour. Nous avons donc mesuré où GPT-6 Luna raccourcit ses réponses, ce qu’il omet et comment retrouver des réponses plus complètes.
Comment avons-nous procédé ?
Nous avons conçu des tâches de rédaction dont les exigences sont vérifiables par du code, sans recourir à un modèle juge. Chaque tâche fournit au modèle un jeu de données synthétiques et lui demande de rédiger un document à partir de ces données :
| Document | Données | Ce que le lecteur s’attend à y trouver |
|---|---|---|
| Bilan trimestriel | chiffre d’affaires de 6 à 12 régions | toutes les régions couvertes et celle qui accuse la plus forte baisse |
| Postmortem d’incident | 7 à 10 événements horodatés | tous les événements et la durée de l’incident |
| Comparatif de fournisseurs | 5 à 8 devis d’hébergement | tous les fournisseurs couverts |
| Réponses aux clients | 6 à 14 tickets de support | une réponse par ticket, adressée au client par son nom |
Chaque tâche utilise les mêmes données avec deux types de prompts. Le prompt limité à l’objectif indique le document à produire, sans en détailler les éléments (« Rédige le bilan régional du T3 pour la direction »). Seuls les éléments du tableau servent alors à l’évaluation. Le prompt avec les éléments précisés liste les sections, les nombres attendus et les plages de mots ; tous ces critères entrent dans l’évaluation. Un document est complet si aucun élément requis ne manque, n’est trop court ou n’est présent en nombre insuffisant. Pour les comparatifs de fournisseurs avec un prompt limité à l’objectif, seule la longueur est prise en compte, car choisir le bon fournisseur relève d’une appréciation.
Le 2026-10-02, nous avons exécuté les 80 tâches limitées à l’objectif sur les deux modèles avec cinq niveaux d’effort, ainsi que sur GPT-6 Luna avec un réglage de verbosity. Nous avons aussi exécuté les 80 tâches avec éléments précisés sur les deux modèles avec l’effort par défaut : 1,040 appels à la Responses API au total. Chaque prompt contenait une chaîne aléatoire unique pour éviter qu’une réponse ne provienne d’un cache. Les coûts sont calculés aux prix catalogue d’OpenAI. Les deux modèles ayant traité les mêmes tâches, nous les comparons avec un test exact de McNemar (un test apparié portant sur les tâches où leurs résultats diffèrent) et une correction de Holm, qui rend le seuil plus strict lorsque plusieurs comparaisons sont testées en même temps. Nous ne qualifions de différences que les écarts qui restent significatifs après cette correction.
GPT-6 Luna écrit-il moins que GPT-5.6 Luna ?
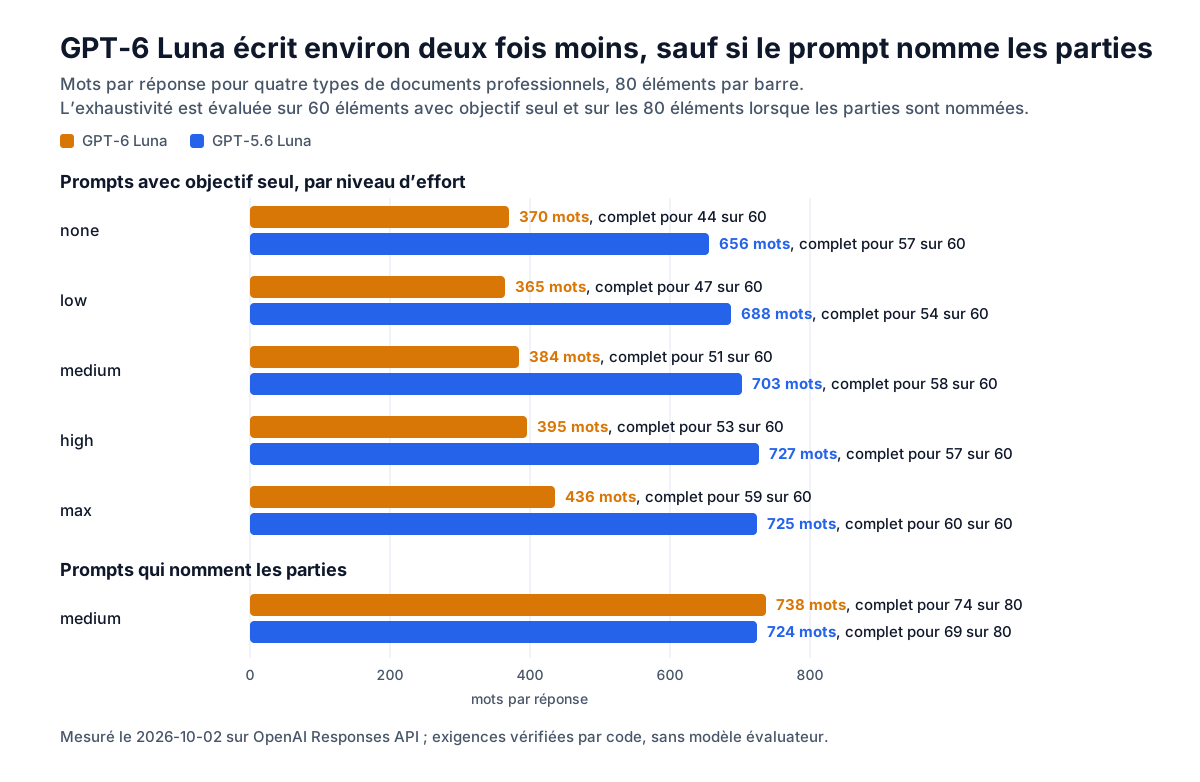
Avec l’effort par défaut et des prompts limités à l’objectif, GPT-6 Luna écrit 0.55x autant de mots que GPT-5.6 Luna : 384 mots par document contre 703. Ses réponses sont plus courtes sur les 80 tâches. L’écart existe pour chaque type de document. Il est le plus marqué pour les postmortems (441 contre 981 mots) et le moins marqué pour les réponses aux clients (576 contre 767).
Quand les éléments sont précisés, l’écart disparaît : 738 mots contre 724.
Cette tendance à raccourcir les réponses par défaut ne concerne pas que Luna. Sur les mêmes tâches, GPT-6 Sol écrit 325 mots contre 592 pour GPT-5.6 Sol, tandis que GPT-6.1 Sol remonte à 565.
GPT-6 Luna omet-il des éléments ?
Sur les prompts limités à l’objectif, GPT-6 Luna omet plus souvent que GPT-5.6 Luna un seul élément : la durée de l’incident dans un postmortem. Il donne généralement la plage horaire (« Période de l’incident : 18:00-18:39 UTC ») et laisse au lecteur le soin de calculer la durée. Tous les autres éléments sont présents à chaque niveau d’effort : chaque région et celle qui a le plus reculé, chaque événement et une réponse adressée nommément au client pour chaque ticket, à une exception près avec none.
| Prompts limités à l’objectif | Documents complets, GPT-6 Luna | Postmortems sans durée, GPT-6 Luna | Documents complets, GPT-5.6 Luna | Postmortems sans durée, GPT-5.6 Luna |
|---|---|---|---|---|
none | 44 / 60 | 15 / 20 | 57 / 60 | 3 / 20 |
low | 47 / 60 | 13 / 20 | 54 / 60 | 6 / 20 |
medium | 51 / 60 | 9 / 20 | 58 / 60 | 2 / 20 |
high | 53 / 60 | 7 / 20 | 57 / 60 | 3 / 20 |
max | 59 / 60 | 1 / 20 | 60 / 60 | 0 / 20 |
L’écart avec none (44 contre 57) reste significatif après correction. Avec medium (51 contre 58), il n’est significatif qu’avant correction : il indique donc une tendance. Avec max, les deux modèles sont à égalité. Tout l’écart vient d’un seul type de document. Il montre que GPT-6 Luna peut omettre une valeur à calculer dans un postmortem, pas qu’il omet généralement du contenu.
Quand les éléments sont précisés, GPT-6 Luna produit 74 documents complets sur 80 et GPT-5.6 Luna 69, soit des résultats équivalents. Pour les deux modèles, tous les échecs concernent un mémo ou un paragraphe sur l’impact en dessous de la plage de mots demandée : 6 pour GPT-6 Luna et 11 pour GPT-5.6 Luna.
Comment retrouver la longueur et les détails manquants ?
Il suffit de préciser les éléments attendus dans le prompt. Les deux paramètres de requête testés ne produisent pas le même résultat. À effort égal, GPT-6 Luna passe de 384 à 738 mots et indique la durée dans chaque postmortem dès que le prompt la demande. Une consigne comme celle-ci suffit :
Write the postmortem with these sections: Timeline (a table with every event),
Impact (120-200 words, state the total duration in minutes), Root Cause,
Action Items (5, each ending "Owner: <team>"), Lessons Learned (at least 3 bullets).
text.verbosity est un paramètre de la Responses API (low, medium, high) qui règle la longueur et le niveau de détail de la réponse visible. Réglé sur high, il allonge de 7 % les documents de GPT-6 Luna produits avec un prompt limité à l’objectif (410 mots), sans améliorer leur complétude : 52 sur 60 contre 51.
Augmenter reasoning.effort joue davantage sur la quantité de raisonnement que sur la longueur du texte. De none à max, les documents de GPT-6 Luna passent de 370 à 436 mots, tandis que les tokens de raisonnement passent de 0 à 4,192 par réponse. Avec max, la durée n’est plus omise que dans 1 postmortem sur 20, mais le coût est 4.5 fois celui de medium.
Les deux paramètres avec le SDK Python d’OpenAI :
from openai import OpenAI

client = OpenAI()
prompt = "Write the postmortem with these sections: ..."  # data and required parts
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "medium"},   # none, low, medium (default), high, xhigh, max
    text={"verbosity": "high"},       # 7% longer in our runs; did not change completeness
    input=prompt,
)
print(resp.output_text)
usage = resp.usage
print(usage.output_tokens, usage.output_tokens_details.reasoning_tokens)
output_tokens inclut les tokens de raisonnement. Le nombre de tokens de la réponse visible est donc la différence entre les deux valeurs.
Combien économise-t-on avec GPT-6 Luna ?
Pour un même document, GPT-6 Luna coûte 49 % de moins que GPT-5.6 Luna : $0.81 contre $1.61 pour 1 000 documents quand les éléments sont précisés. La seule baisse des prix aurait permis d’économiser davantage. Aux tarifs de GPT-6 Luna, les tokens consommés par GPT-5.6 Luna reviendraient à $0.68, soit 58 % de moins. Les réponses de GPT-6 Luna coûtent 20 % de plus que ce montant : il consomme deux fois plus de tokens de raisonnement (537 par réponse contre 271) et son volume total de tokens de sortie passe de 1,284 à 1,558.
Avec les prompts limités à l’objectif, la facture baisse davantage : $0.54 contre $1.66 pour 1 000 documents, soit 68 % de moins. Mais ce gain supplémentaire vient surtout de réponses deux fois plus courtes. Ce n’est une économie que si la moitié non écrite n’était pas nécessaire.
Les vitesses sont proches. Rapporté à la durée totale des requêtes, GPT-6 Luna génère 115 tokens de sortie par seconde contre 125. La durée médiane d’un document avec un prompt limité à l’objectif est de 8.1 secondes contre 11.1, car il y a moins de texte à produire.
Nos résultats concordent-ils avec les autres tests publiés ?
Nos résultats concordent avec les benchmarks publics sur les points comparables. Ils précisent aussi ce qui raccourcit, ce qui manque et comment y remédier.
| Question | Résultats publiés ailleurs | Nos mesures | Conclusion |
|---|---|---|---|
| Capacités générales, GPT-6 Luna face à GPT-5.6 Luna | Artificial Analysis : 38 contre 37 ; Vals : 51.2% contre 51.7% | 74 documents complets sur 80 contre 69 avec les éléments précisés, soit des résultats équivalents | Cohérent : même niveau |
| Qualité des documents | Score Elo GDPval-AA v2.1 : 25 points de moins avec l’effort max, 129 de plus avec l’effort medium | Avec l’effort medium, 0.55x autant de mots sur les prompts limités à l’objectif ; durée de l’incident absente de 9 postmortems sur 20 contre 2 | Nuancé : aucun des deux tests ne montre une dégradation nette avec l’effort par défaut ; le nôtre met en évidence des réponses plus courtes et l’élément que cela coûte |
| Tokens de sortie | 51K contre 41K par tâche de l’index avec l’effort max, soit 24 % de plus | 1,558 contre 1,284 par document avec medium, soit 21 % de plus | Cohérent |
| Coût | 61 % de moins par tâche de l’index ; 48 % de moins par test Vals | 49 % de moins avec les éléments précisés, 68 % de moins avec les prompts limités à l’objectif | Cohérent |
Que retenir, et quel modèle choisir ?
Choisissez GPT-6 Luna lorsque vous maîtrisez le prompt, en précisant les éléments attendus. Gardez GPT-5.6 Luna uniquement si vous ne pouvez pas modifier les prompts et que les lecteurs attendent des documents longs. Trois constats motivent ce choix :
- GPT-6 Luna s’adapte à la consigne. Un simple objectif produit un document court. Une liste d’éléments produit un document complet, de longueur comparable à celui de GPT-5.6 Luna.
- Ses omissions sont ciblées. Sur quatre types de documents, le seul élément attendu qu’il omet plus souvent est la durée de l’incident.
- L’économie vient de la baisse des tarifs. Pour un même document, il utilise 21 % de tokens de sortie en plus. L’économie de 49 % reste donc inférieure aux 58 % qu’impliquerait la seule différence de prix catalogue.
| Usage | Choix | Chiffres |
|---|---|---|
| Sortie lue par une machine : classification, extraction, routage | GPT-6 Luna avec le niveau d’effort le plus bas compatible avec la précision requise | prix catalogue inférieurs de 50 % en entrée et de 58 % en sortie ; la longueur de la réponse importe peu si elle est lue par un programme |
| Documents produits à partir d’un modèle ou d’un prompt que vous rédigez | GPT-6 Luna, avec les sections, les nombres attendus et les longueurs précisés dans le prompt | 74 documents complets sur 80 contre 69 ; $0.81 contre $1.61 pour 1 000 |
| Documents issus de prompts d’utilisateurs que vous ne pouvez pas modifier | GPT-6 Luna si vous pouvez ajouter les éléments attendus à la requête ; sinon GPT-5.6 Luna | prompts limités à l’objectif : 384 contre 703 mots ; durée absente de 9 postmortems sur 20 contre 2 |
| Livrables évalués selon une grille de critères | Mettez la grille dans le prompt ; ne comptez pas sur text.verbosity | verbosity high : 52 documents complets sur 60 contre 51, avec 7 % de mots en plus |
Pour les documents destinés aux clients, vérifiez les éléments requis par du code avant l’envoi, quel que soit le modèle utilisé.
FAQ
GPT-6 Luna est-il moins bon que GPT-5.6 Luna ? Quand le prompt précise les éléments requis, GPT-6 Luna produit des documents aussi complets que GPT-5.6 Luna (74 contre 69 sur 80, soit des résultats équivalents), pour un coût deux fois moindre. Quand le prompt se limite à un objectif, il écrit environ deux fois moins et omet plus souvent la durée de l’incident dans les postmortems.
text.verbosity: "high" permet-il à GPT-6 Luna d’écrire autant que GPT-5.6 Luna ?
Dans nos tests, text.verbosity: "high" ajoute 7 % de mots aux réponses de GPT-6 Luna. Elles restent ainsi à environ 58 % de la longueur de celles de GPT-5.6 Luna, sans amélioration de leur complétude. Préciser les éléments attendus dans le prompt permet de retrouver la même longueur.
GPT-6.1 a-t-il corrigé les réponses courtes de GPT-6 Luna ? La mise à jour 6.1 d’OpenAI ne concerne que la gamme Sol : GPT-6.1 Sol écrit de nouveau des réponses aussi longues que GPT-5.6 Sol. GPT-6 Luna n’a pas changé depuis sa sortie le 2026-09-22.
Autres mesures : GPT-6.1 Sol face à Claude Sonnet 5.5, comparatif des LLM du segment flash et leviers de réduction des coûts de GPT-5.6.