
Déboguer un agent LLM : 3 échecs, dont un avec le statut 200
Retrouvez l'exécution d'un agent par utilisateur, puis analysez trois échecs : un 404 suivi d'une nouvelle tentative, des réponses tronquées avec un statut 200 et un 400 au deuxième tour.
Nos choix
prix en direct| Modèle | Verdict | Prix |
|---|---|---|
| GPT-6 Luna A rejeté le deuxième tour d’une conversation avec un code 400 en 0.5 s, sans frais, alors qu’un appel d’outil avait disparu de l’historique enregistré. | Agent principal dans la démo | dès $0.1/M |
| DeepSeek V4.1 Flash Avec max_tokens à 40, trois appels consécutifs ont renvoyé un statut 200 et exactement 40 tokens de sortie, sans réponse exploitable. Avec la limite relevée et le raisonnement désactivé, un appel a fourni une réponse en 49 tokens. | Sous-agent dans la démo | dès $0.3/M |
Sommaire
- Comment retrouver l’exécution d’un utilisateur ?
- À quoi ressemble un appel en échec suivi d’une nouvelle tentative ?
- Pourquoi l’agent ne renvoie-t-il rien alors que tous les appels ont réussi ?
- Pourquoi le deuxième tour échoue-t-il alors que le premier a fonctionné ?
- Que doit journaliser chaque agent pour permettre ce diagnostic ?
- FAQ
- Comment déboguer un agent LLM en production ?
- Pourquoi mon LLM renvoie-t-il une réponse vide avec un statut 200 ?
- Quelle est la cause de l’erreur « No tool call found for function call output » ?
- Faut-il relancer un appel LLM en échec ?
- Pour aller plus loin
« L’assistant m’a donné une réponse inutile hier après-midi. » C’est ainsi que la plupart des bugs d’agent sont signalés : un utilisateur, une heure approximative, aucun identifiant de requête. Pour retrouver l’exécution, il faut un label sur les requêtes. Pour comprendre ce qui s’est passé, il faut une trace : l’échec concerne généralement un seul appel parmi plusieurs et ne ressemble souvent pas à une erreur. Ce guide part d’un signalement pour retrouver l’appel en cause, puis reproduit trois échecs dans un petit agent de support et montre comment chacun apparaît dans la console Synthorai.
TL;DR
- Un label
_usersur chaque requête permet de retrouver les exécutions d’un utilisateur avec une seule recherche dans la liste Traces. - Un appel en échec et sa nouvelle tentative apparaissent côte à côte si celle-ci conserve l’identifiant de trace. Le 404 de la démo a coûté 95 ms et $0.
- Avec
max_tokens=40sur un modèle de raisonnement, trois appels ont renvoyé un statut 200 avec 40 tokens de sortie et aucune réponse. - Un historique enregistré sans un appel d’outil a provoqué un 400 au deuxième tour, sans frais.
Ce guide s’appuie sur Tracer un agent LLM, qui présente les en-têtes de requête utilisés ici. Configurez la démo comme indiqué dans ce guide (Python 3.10 ou ultérieur, environnement virtuel activé), puis exécutez ces commandes depuis le même répertoire de github.com/synthorai-io/use-cases :
cd use-cases/agent-tracing
python run.py --fail                    # a failed call with a retry
python incidents.py cut-off bad-history
Les chiffres de cette page proviennent d’une exécution de chaque cas le 11 octobre 2026.
| Ce que montre la trace | Ce que cela signifie | Cas |
|---|---|---|
| un repère hachuré avec un code de statut, puis un appel similaire | un appel a échoué, puis a été relancé | run.py --fail |
| le même span plusieurs fois, tous en 200, avec une colonne Output égale au plafond | les réponses sont tronquées avant de devenir exploitables | cut-off |
| un 400 au deuxième tour d’une session, 0 token, $0 | la requête construite par votre code est invalide | bad-history |
Comment retrouver l’exécution d’un utilisateur ?
Vous la retrouvez grâce au label envoyé avec les requêtes. Si chacune contient un en-tête X-Synthorai-Metadata avec une clé _user, un seul filtre suffit :
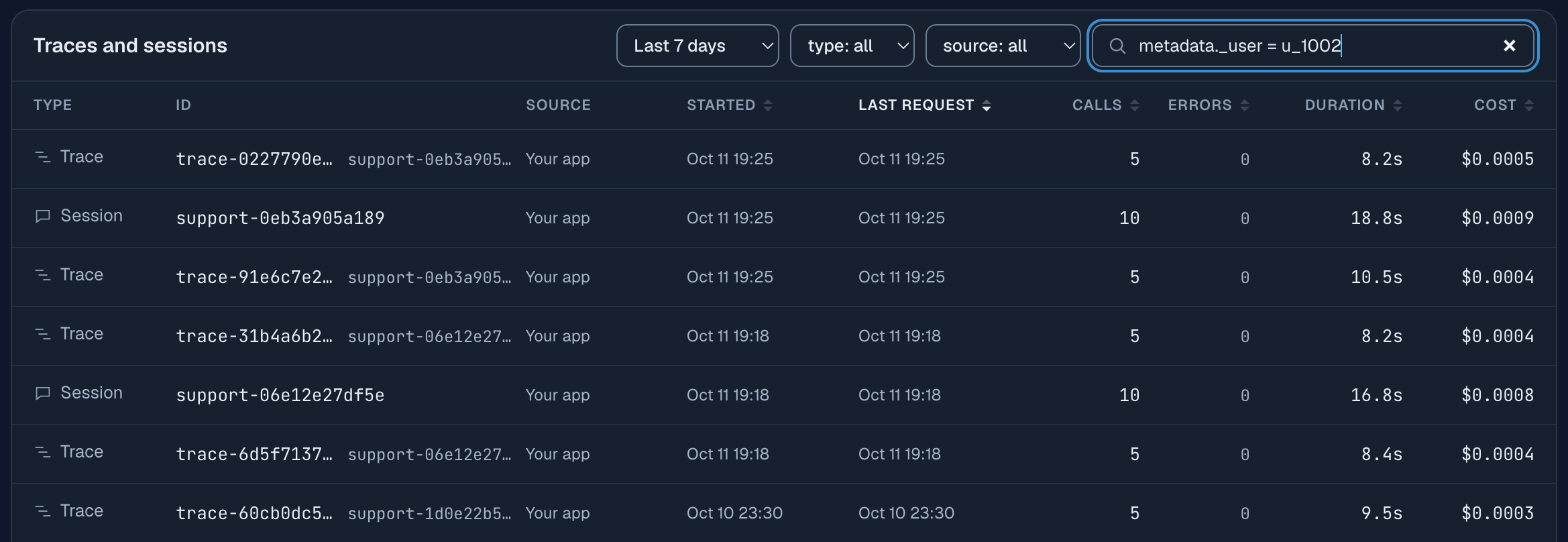
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}- Ouvrez Traces, saisissez
metadata._user = u_1002dans le champ de recherche et appuyez sur Entrée. Choisissez une plage horaire qui couvre le signalement. - Parcourez la liste. Elle ne contient plus que les sessions de cet utilisateur et leurs traces, avec le nombre d’appels, les erreurs, la durée et le coût. Les colonnes Calls, Errors, Duration et Cost sont triables. Commencez par les traces qui contiennent une erreur ou beaucoup plus d’appels que les traces voisines.
- Ouvrez la trace. Elle montre toute l’exécution. « Open session » affiche la conversation qui l’entoure, et « See the calls in Logs » liste les requêtes individuelles.
Pour rechercher des requêtes individuelles plutôt que des exécutions, le champ de filtre de Logs accepte le même label, ainsi que status (error, success, 4xx, 5xx ou un code), latency, cost, model, session et trace.
Sans labels, partez des informations dont vous disposez : un identifiant de trace issu de vos logs se saisit dans le champ de recherche de Traces ; un identifiant de requête récupéré dans un en-tête de réponse se saisit dans le filtre de Logs sous request_id. C’est pour cela qu’il faut journaliser l’en-tête de réponse x-request-id avec vos propres identifiants d’utilisateur et de conversation.
Utilisez un identifiant utilisateur interne pour _user, pas une adresse e-mail ni un nom. Les labels sont stockés avec la requête.
À quoi ressemble un appel en échec suivi d’une nouvelle tentative ?
Il apparaît sous forme d’un repère hachuré portant le code de statut, à côté de l’appel qui l’a remplacé. Dans le guide sur les traces, l’une des trois vérifications parallèles demande un identifiant de modèle inexistant. La trace affiche policy-check sous forme d’un repère de 95 ms marqué 404, et policy-check.retry sous forme d’une barre normale à côté. Le résumé de la trace indique « 6 model calls, 1 failed », et la page de session affiche « 1 × 404 Not found ». L’appel en échec a coûté $0.
Deux choix dans votre code rendent cette trace lisible. La nouvelle tentative conserve l’identifiant de trace : l’échec et la relance figurent donc dans la même vue. Elle possède aussi son propre nom de span, ce qui permet de distinguer les tentatives. Si elle démarre une nouvelle trace, vous voyez deux exécutions sans lien apparent, dont l’une a échoué sans raison visible.
Un échec dans une trace n’est pas toujours un problème. Cette exécution a récupéré après l’erreur, et le client a reçu une réponse. La trace montre le coût de l’échec : ici, 95 ms et aucun frais. C’est ce qui permet de décider si la relance suffit ou s’il faut corriger la cause.
Pourquoi l’agent ne renvoie-t-il rien alors que tous les appels ont réussi ?
L’agent n’a rien renvoyé parce qu’un statut 200 signifie seulement que la requête s’est terminée. Ici, le sous-agent qui utilise DeepSeek V4.1 Flash doit déterminer quels sujets liés aux politiques sont abordés dans un message. Son paramètre max_tokens=40 date d’un ancien prompt plus simple. Contrairement aux autres appels de sous-agents de la démo, la version défectueuse de cette vérification garde le réglage de raisonnement par défaut du modèle (think dans l’extrait). Le modèle raisonne avant de répondre, consomme les 40 tokens pendant le raisonnement, puis renvoie une réponse vide avec finish_reason défini à length. Le code constate que la réponse est vide et réessaie, pour un total de trois tentatives :
for attempt in range(1, 4):
    resp = await check(run, f"policy-check-{attempt}", prompt, think=variant == "before", max_tokens=limit)
    choice = resp.choices[0]
    if choice.finish_reason != "length" and (choice.message.content or "").strip():
        break                                    # a usable reply; otherwise try again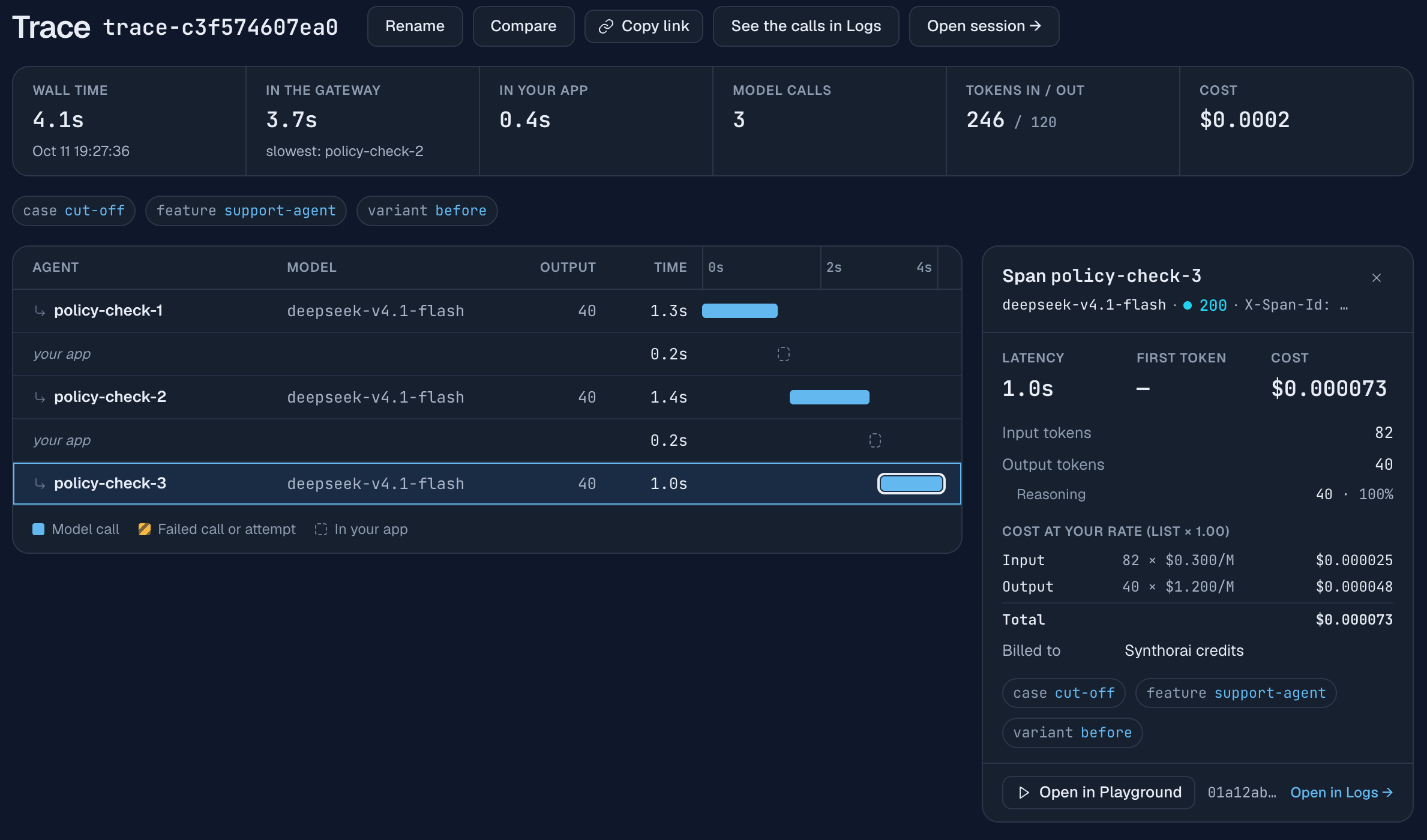
Aucun appel n’est marqué en échec dans le diagramme en cascade. Les indices sont la répétition du span et la colonne Output : 40, 40 et 40, exactement le plafond. Sélectionnez un appel pour ouvrir le panneau de droite. Il confirme le diagnostic : statut 200, 40 tokens de sortie et, juste en dessous, « Reasoning 40 · 100% ».
Un nombre de tokens de sortie égal au plafond configuré est le signe d’une réponse tronquée. La version corrigée relève le plafond à 2,000 et désactive le raisonnement pour cette vérification, qui n’en a pas besoin. Un seul appel suffit alors à répondre en 49 tokens de sortie, et la trace n’affiche plus qu’une barre au lieu de trois. Relever uniquement le plafond a également supprimé les relances, mais cet appel a consommé 1,876 tokens de sortie en raisonnement et a duré 22 s.
Pour votre propre agent :
- Vérifiez
finish_reasonà chaque appel.lengthindique que la réponse a été tronquée. Traitez ce cas comme un échec dans vos logs, même si le statut est 200. - Dimensionnez
max_tokenspour le raisonnement et la réponse. Sur un modèle de raisonnement, le plafond couvre les deux. Un plafond prévu uniquement pour la réponse visible peut ne lui laisser aucune place. - Ne relancez pas une réponse tronquée avec le même plafond. La deuxième tentative atteindra la même limite. Relevez le plafond, réduisez l’effort de raisonnement, ou faites les deux.
Pourquoi le deuxième tour échoue-t-il alors que le premier a fonctionné ?
La cause se trouve généralement dans ce que votre code a enregistré entre les deux tours. Une requête au modèle contient toute la conversation : un bug de stockage ou de reconstruction de l’historique n’apparaît donc qu’à partir du deuxième tour. Ici, le premier tour utilise les messages conservés en mémoire : GPT-6 Luna appelle un outil, reçoit son résultat et répond sans problème. Le code enregistre ensuite le tour. Il ne garde que le texte du message de l’assistant, perd l’appel d’outil et stocke le résultat de l’outil à côté :
# What the app stores for the next turn.
saved = msg.model_dump(exclude_none=True)
if variant == "before":
    saved.pop("tool_calls", None)                # the bug: the assistant message is saved as text only
    saved["content"] = saved.get("content") or ""
history = [saved, *results, {"role": "assistant", "content": answer.choices[0].message.content or ""}]
Quand le client écrit de nouveau, le deuxième tour est construit à partir de cet historique. La requête contient un résultat d’outil dont l’appel correspondant a disparu de l’historique. Elle est rejetée avec cette erreur (« function call output » est le terme utilisé par le fournisseur pour désigner un résultat d’outil) :
400 No tool call found for function call output with call_id call_Nqc1zUFvwLLuF5oGMEE9WheQ.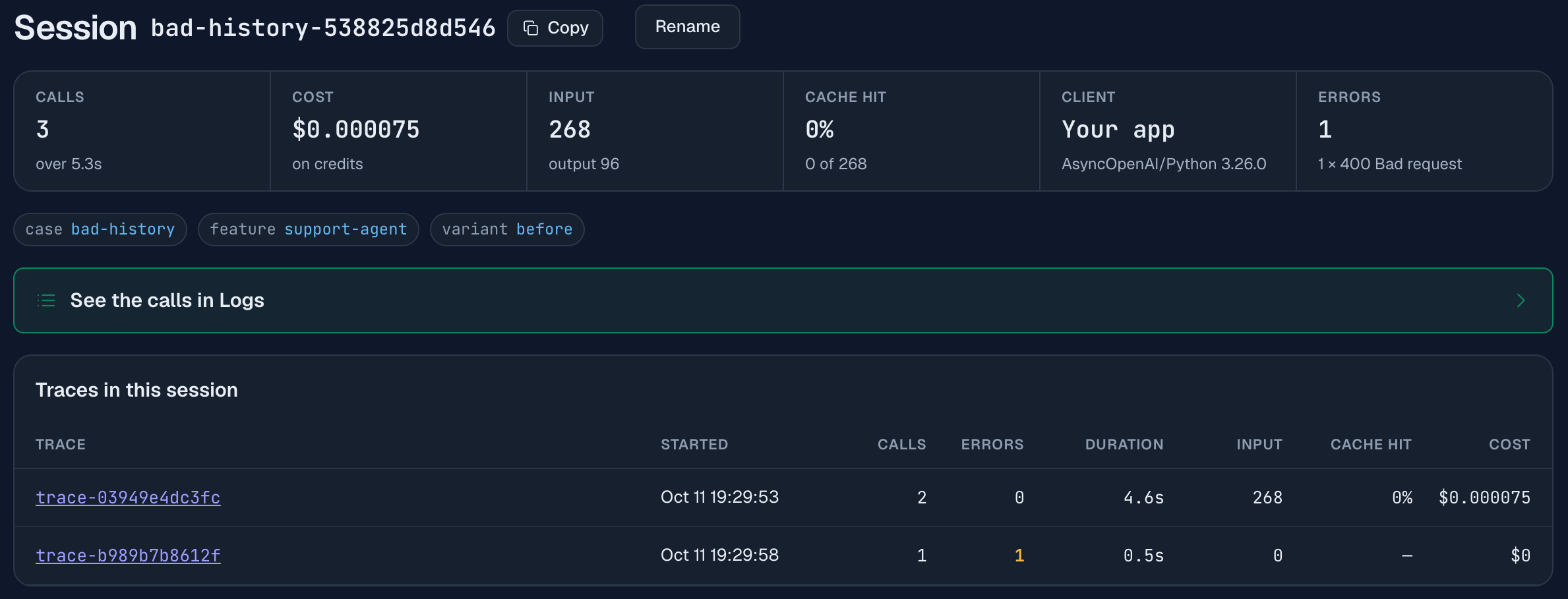
La page de session montre le scénario : deux traces, la première avec 2 appels et aucune erreur, la seconde avec 1 appel et 1 erreur, et « 1 × 400 Bad request » dans la carte des erreurs. La trace en échec affiche 0 token d’entrée, une durée de 0.5 s et un coût de $0. Ces trois valeurs indiquent qu’aucun modèle n’a été exécuté : la requête a été refusée car elle était invalide. Cela distingue cet échec d’un problème de modèle ou de fournisseur, qui se traduirait par des tokens consommés, une durée plus longue ou un statut 5xx.
Un 400 vient d’un bug dans la requête : la relancer ne sert à rien, et le message d’erreur indique ce qu’il faut corriger. Si le message de l’assistant est enregistré en entier, le deuxième tour réussit.
D’autres bugs d’historique produisent le même scénario, un premier tour réussi puis un tour ultérieur rejeté : un résultat d’outil enregistré sans son identifiant d’appel, des messages stockés dans le mauvais ordre, ou un historique tronqué au milieu d’un échange avec un outil, conservant le résultat mais supprimant l’appel. Si vous réduisez l’historique pour maîtriser les coûts, coupez entre les tours, jamais à l’intérieur d’un tour.
Que doit journaliser chaque agent pour permettre ce diagnostic ?
Journalisez cinq éléments :
- Un identifiant de trace par exécution et un identifiant de session par conversation, envoyés dans
X-Trace-IdetX-Session-Id, et également inscrits dans vos propres logs. - Un nom de span par appel qui indique l’étape et la tentative, par exemple
plan-2oupolicy-check.retry. - Des labels pour l’utilisateur, la fonctionnalité et la version, envoyés dans
X-Synthorai-Metadata. - L’en-tête de réponse
x-request-idde chaque appel, avec vos propres identifiants. finish_reasonet le nombre de tokens de sortie de chaque appel, en traitantlengthcomme un échec.
Définissez aussi un délai d’expiration côté client et une valeur max_tokens pour chaque appel, avec des marges suffisantes. Sans ces deux limites, un appel peut durer aussi longtemps que le modèle continue à produire du texte, et votre code attend pendant tout ce temps. Mais un plafond dimensionné uniquement pour la réponse visible provoque le bug du deuxième cas. Un délai d’expiration trop court interrompt des appels qui fonctionnaient : sur un modèle de raisonnement, un appel peut prendre plusieurs minutes. La démo attend 300 s et limite chaque appel à 2,000 tokens de sortie, sauf si l’appel définit son propre plafond.
FAQ
Comment déboguer un agent LLM en production ?
Retrouvez d’abord l’exécution : filtrez les logs de requêtes par label d’utilisateur ou de conversation, puis ouvrez la trace d’une requête correspondante. La trace présente tous les appels au modèle dans l’ordre et signale ceux qui ont échoué. Vous pouvez ainsi repérer l’étape en cause avant de lire le code.
Pourquoi mon LLM renvoie-t-il une réponse vide avec un statut 200 ?
Le plus souvent, le plafond de sortie a été atteint avant que le modèle ait rédigé sa réponse. Sur un modèle de raisonnement, max_tokens couvre le raisonnement et la réponse. Vérifiez finish_reason : s’il vaut length et que le nombre de tokens de sortie correspond au plafond, la réponse a été tronquée. Dans la démo, trois appels consécutifs ont renvoyé 200 avec exactement 40 tokens de sortie et aucune réponse exploitable.
Quelle est la cause de l’erreur « No tool call found for function call output » ?
L’historique de conversation contient un résultat d’outil sans l’appel correspondant. Cela arrive quand le message de l’assistant à l’origine de l’appel est enregistré sans ses tool_calls, ou quand l’historique est tronqué entre l’appel et son résultat. Enregistrez le message de l’assistant en entier et ne coupez qu’entre les tours.
Faut-il relancer un appel LLM en échec ?
Cela dépend du statut. Un 429 (limite de requêtes atteinte) ou un 5xx (erreur serveur) peut réussir après une relance. Un 400 signale un problème dans la requête et échouera de la même manière. Une réponse tronquée par max_tokens le sera de nouveau si le plafond ne change pas. Lors d’une relance, conservez l’identifiant de trace pour que les deux tentatives apparaissent dans la même trace.
Pour aller plus loin
- Tracer un agent LLM : les en-têtes, le diagramme en cascade et l’exemple d’appel en échec.
- Pourquoi mon agent LLM est-il lent ? : analyser la latence à partir de la même trace.
- Pourquoi mon agent LLM coûte-t-il cher ? : analyser les coûts à partir des sessions.
- Coût de Claude Code par sous-agent : les mêmes vues pour un agent de programmation que vous n’avez pas écrit.
- Interroger Claude sur vos logs LLM : répondre via MCP à la question « une requête de cet utilisateur a-t-elle échoué ? ».
- Donner à votre agent des outils de lecture des logs : lire les mêmes logs avec votre propre programme et mesurer le coût des tokens du modèle.
- Référence des en-têtes de requête : identifiants, labels et limites.